计算单位
1.频率计算:
容量用1024是因为地址是二进制的,多一根地址线容量翻倍。秒不是二进制的,所以频率没这回事。 时钟周期 - 运行频率换算: 1ns↔1GHz。10ns就是1GHz÷10 = 100MHz 1/10ns = 100Mhz
宏
`ifndef … define守卫宏
 防止被include两次。package重复定义是编译错误,一旦别的文件也include这个就会报错
- 比如经常有代码文件被”送进编译器”了两次:一次靠filelist,一次靠include,这样就需要靠宏来放防守
笔记结构对照当前所学课程目录(第一~八章)整理。课程未覆盖到的旧笔记内容归入文末「附录」,不打乱主线。
目录
- 第一章 SV简介:1.1 SV 简介 ✅
- 第二章 数据类型:2.1 SV数据类型 ✅ / 2.2 数组 ✅ / 2.3 数组的操作 ✅ / 2.4 结构体、联合体与枚举 ✅
- 第三章 过程语句与子程序:3.1 过程语句 ✅ / 3.2 SV子程序 ✅
- 第四章 激励时序与接口:4.1 SV的激励时序 ✅ / 4.2 SV的接口 ✅ / 4.3 SV接口的驱动和采样 ✅
- 第五章 面向对象编程:5.1 SV类 ✅ / 5.2 SV类的成员操作 ✅ / 5.3 SV类的封装和继承 ✅ / 5.4 SV的多态 ✅ / 5.5 类型转换 ✅ / 5.6 虚接口 ✅ / 5.7 包的使用 ✅ / 5.8 多线程间通信 ✅
- 第六章 随机化:6.1 SV随机化基础 ✅ / 6.2 随机化约束的种类(实操) / 6.3 随机约束控制 ✅ / 6.4 随机约束控制(实操) / 6.5 随机化约束的概率 ✅ / 6.6 数组约束 ✅
- 第七章 断言:7.1 断言基础语法 ✅
- 第八章 覆盖率:8.1 SV覆盖率类型 ✅ / 8.2 覆盖策略及覆盖组 ✅ / 8.3 覆盖率数据采样 ✅ / 8.4 交叉覆盖率及覆盖选项 ✅
- 第九章 DPI:9.1 DPI基础用法 ✅
- 附录:复位 / 运算符与移位 / 编译指令
- HDLBits练习
第一章 SV简介
1.1 SV 简介
SV语言的一些feature:
- OOP
- Assertions
- Coverage
- New data types
- interfaces
- Random Gneration
- DPI
- Synchro IPC
第二章 数据类型
2.1 SV数据类型
1. Verilog 默认类型(wire / reg)
在 Verilog 中,如果你在端口列表(module 的括号内)声明了一个 output、input 或 inout,但没有显式指定它是 reg,也没有指定它是 logic(SystemVerilog),那么它默认就是 wire 类型。
module top_module (
    input  a,    // 隐式默认为 wire
    output b     // 隐式默认为 wire

	input logic [31:0] a, // 推荐
	input [31:0] b, // 不推荐:虽然合法,但隐式默认为 wire
);
    // wire 类型必须使用 assign 语句进行连续赋值
    assign b = a;

endmodule
补充知识 : assign: b ──────→ a 单向,写反了就不通 tran: a ══════ b 双向,等价于焊在一起
wire 类型的变量代表物理连线。在仿真开始的瞬间(Time 0),在任何驱动源(如 assign 语句或门级输出)生效之前,或者如果没有驱动源连接它,wire 的默认值是 z(High Impedance / 高阻态)。
wire 对比 reg 类型: 如果 zero 被声明为 reg 类型(例如在 testbench 中),reg 的默认初始值通常是 x(未知态),直到被赋值。
不定态 x,高阻态 z。
2. SV 数据类型总览
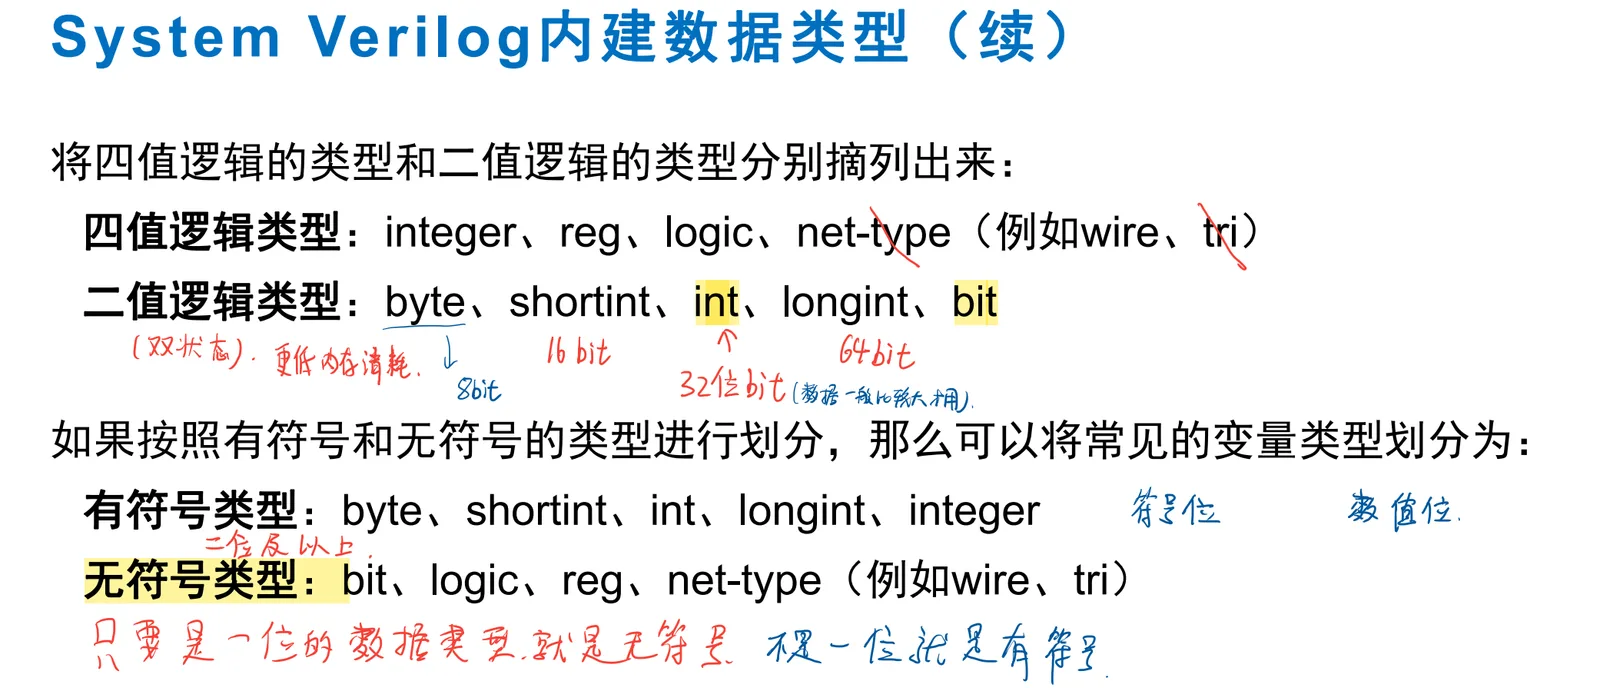 默写:
- 常见二值逻辑类型有int byte和bit
- 常见有符号数据类型有bit reg和logic
- 四值逻辑转换成二值逻辑,x和z会转换成0
default value:
- logic - x(没人赋值就永远停在default value x。)
- bit - 0
| Type | 2-4 states | Signed / Unsigned | Size (bits)基础位宽 | SV / V |
|---|---|---|---|---|
| shortint | 2 | Signed | 16 | SV |
| int | 2 | Signed | 32 | SV |
| longint | 2 | Signed | 64 | SV |
| byte | 2 | Signed | 8 | SV |
| bit | 2 | Unsigned | 1 | SV |
| logic | 4 | Unsigned | 1 | SV |
| reg | 4 | Unsigned | 1 | V |
| net (wire) | 4 | Unsigned | 1 | V |
| integer | 4 | Signed | 32 | V |
| real | 2 | Signed | 64 | V |
| shortreal | 2 | Signed | 32 | SV |
| realtime | 2 | Signed | 64 | V |
| time | 4 | Unsigned | 64 | V |
| SystemVerilog 完全向下兼容 Verilog |
2.2 数组
1. 定宽数组
int lo_hi[0:15]; 或 int lo_hi[16]; //16个整数2. 多维数组
int array[0:1][0:2] 或 int array[2] [3] //2行3列

> 注意:int array[0:1][0:2] = int [0:1][0:2] array(只是写法不同)初始化前,访问数组成员,则返回值取决于数据类型
- logic 返回x
- int或bit返回0 或访问数组范围之外的spot,则返回如上一样
3. packed
bit [3:0][7:0] bytes; //四个元素,每个8bit宽(属于合并数组)

logic [3:0][7:0] a; //总位宽4*8=32bit,四个元素,每个8bit宽

多维合并数组:
logic [1:0][2:0][7:0] data;
- 第一层 `[1:0]`:有 2 个大单位。
- 第二层 `[2:0]`:每个大单位里有 3 个小单位。
- 第三层 `[7:0]`:每个小单位是 8 bit。
  总位宽:2*3*8 = 48 bit

虽然写成了三维,但在硬件和仿真器眼中,它依然是一个 连续的、扁平的 48-bit 向量。
比如可以将 32 个 32 位寄存器(每个 32 位)合并成一个 1024 位宽的数组。
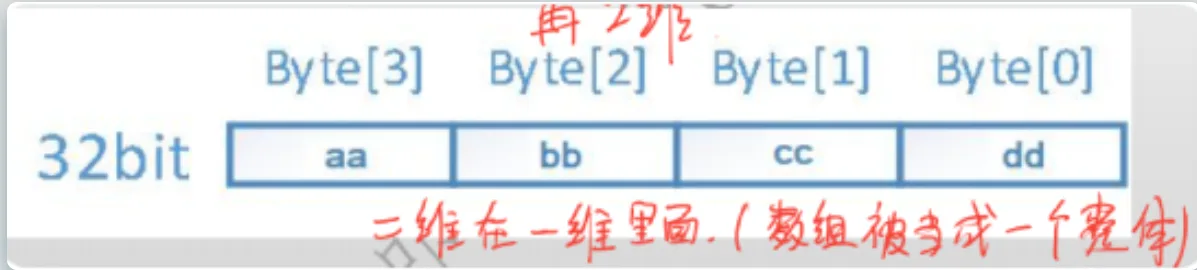
- 合并数组将所有位压缩成一个连续的位向量
- 合并数组通常用于需要大量连续位数据的场景,如信号传输、总线操作等。
4. unpacked
bit [7:0] b_unpack[3] //3个8bit元素
bit [27:0] exp_aperture_addr[4][64]; //unpacked array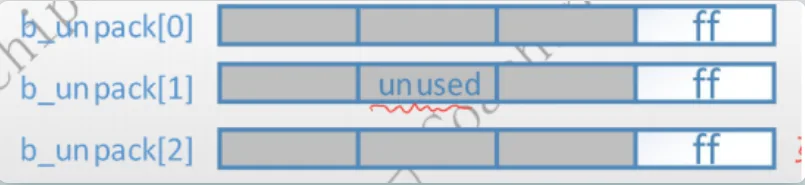
在设计一个寄存器文件时,每个寄存器通常作为一个独立的存储单元,独立操作,因此非合并数组更符合这一要求。
packed/unpacked的定义标准: 是否被当单一位向量寻址运算。
一句话总结: packed 是一整根位向量,能当大数字整体运算/跨元素切位;unpacked 是若干独立存储单元,只能整体赋值(dst=src)或逐元素 foreach,不能跨元素切位/当数字运算——区别不在”内存连不连续”,在”能不能当一个数字整体操作”。
| 类型 | 声明方式 | 硬件实现 | 整体操作 |
|---|---|---|---|
| 合并数组 (Packed) | bit [3:0][7:0] arr; | 连续的一坨电线 (Vector) | 支持 (当做大数处理)- 当一个大数字整体运算(arr+1) |
| 非合并数组 (Unpacked) | bit [7:0] arr [3:0]; | 独立的寄存器/内存块 | 不支持 (必须用循环或 foreach) |
2.3 数组的操作
1. 动态数组
在程序执行之前不知道数组宽度,可以使用 [ ] 留空来定义动态数组。 此时数组最开始是空的,但在调用之前,必须使用new [ ] 来指定宽度。
int  dyn[], d2[];           //声明动态数组
initial begin
  dyn=new[5];               // 分配5个元素
  foreach(dyn[j]) dyn[j]=j; // 对元素进行初始化
  d2=dyn;                   //复制一个动态数组
  d2[0]=5;                  //更改元素的值
  dyn=new[20](dyn);         //分配20个整数值并进行复制,把新的数组的开始5个数用旧的元素覆盖
  dyn=new[100];             //分配100个新的元素,旧值不复存在
  dyn.delete();             //(清空数组)删除所有元素,删除之后,数组大小为0
end
2. 队列 queue
队列(queue)是一种动态数组类型
data_type queue_name[$];
//data_type 是元素类型,比如 int, bit [7:0] 等。
[$] 表示这是一个队列。
特点: 队列 不像静态数组需要提前定义长度,队列可以在 运行时 自动扩展或收缩
使用:
push_front() / push_back():从队首或队尾插入元素。
pop_front() / pop_back():从队首或队尾取出元素。
可以通过索引访问,例如 q[0]。
可以用 size() 获取队列长度。
例子:
int q[$];
q.push_back(10);   // 队尾插入 10
q.push_back(20);   // 队尾插入 20
q.push_front(5);   // 队首插入 5   => 队列内容: {5,10,20}
$display("%0d", q.pop_back());  // 输出 20, 队列变成 {5,10}

---
int j=1,
    q2[$]={3,4},
    q[$]={0,2,5};       //声明队列,并初始化一些元素
initial begin
    q.insert(1, j);     // 在q队列的第二个元素(排列位置从0开始数)之前插入j,
                        // 队列q变成{0,1,2,5}
    q.insert(3,q2[0]);  //在q队列的第四个元素(排列位置从0开始数)之前
    q.insert(4,q2[1]);  // 插入队列q2的元素,队列q变成{0,1,2,3,4,5}
    $display(q);
    q.delete(1);        //删除第1个元素(排列位置从0开始数), 队列变成{0,2,3,4,5}
    q.push_front(6);    //在队列前插入6, q队列变成{6,0,2,3,4,5}
    j = q.pop_back;     //把最后一个元素pop出来,赋值给j, j=5, q队列变成{6,0,2,3,4}
    q.push_back(8);     //在队列尾部插入8, q队列变成{6,0,2,3,4,8}
    j = q.pop_front;    //把第一个元素pop出来,赋值给j, j=6, q队列变成{0,2,3,4,8}
    foreach (q[i])
        $display(q[i]); //打印整个队列
    q.delete();         //删除整个队列
end
数组 vs 队列:
- 数组:适合存储固定数量的数据,例如寄存器文件、查找表。
- 队列:适合存储动态数据流,比如 FIFO 模拟、事务列表、数据包缓冲。
3. 动态数组 vs 队列
两者都能运行时改大小,区别在怎么改:动态数组要手动 new[] 整体重开+复制;队列直接 push_back/push_front 单个增删,无需重开。
int dyn[];
dyn = new[2];        dyn[0]=a; dyn[1]=b;
dyn = new[3](dyn);   dyn[2]=c;   // 每加一个都要重新 new+复制,O(n)

int q[$];
q.push_back(a);
q.push_back(b);
q.push_back(c);                  // 直接追加,O(1),无需重开
选队列的典型场景(如 scoreboard):需要频繁单个增删/FIFO 消费(push_back 塞入 expected,pop_front 取出比对)。动态数组没有 push/pop 原语,只能手动整体重开搬运。
4. 数组的操作
// for和 foreach循环

initial begin
    bit [31:0] src[5], dst[5];
	    for (int i=0; i<$size(src); i++) //for循环不方便
        src[i] = i;

	//方法2,SV提供了foreach关键字,更加方便
    foreach (dst[j])
        dst[j] = src[j] * 2; // dst doubles src values
end

// 对于多维数组:
int md[2][3]='{'{0,1,2},'{3,4,5}};
initial begin
    $display("Initial value:");
    foreach(md[i,j])
        $display("md[%0d][%0d]=%0d",i,j,md[i][j]);
end
数组复制
bit [31:0] src[5] = '{0,1,2,3,4},
           dst[5];

dst = src;       // 数组复制
src[0] = 5;      // 只改变一个元素的值

$display(dst);   // 打印dst,看其是否得到了src的值,元素[0]是旧的值还是新值;(旧值)
$display(src);   // 打印src,看是否改变了src[0]的值
数组比较
可以使用数组名比较,也可以使用片段比较
// 在不使用循环的情况下,也可以利用“==”或者“!=”来比较数组的内容,
// 不过结果仅限于内容相同或者不相同。

bit [31:0] src[5] = '{0,1,2,3,4},
           dst[5] = '{5,4,3,2,1};

if (src==dst) $display("src == dst"); // 比较数组
else $display("src != dst");

dst = src;   // 数组复制
src[0] = 5;  // 只改变一个元素的值

//所有元素是否相等
$display("src %s dst", (src==dst)? "==":"!=");

//使用数组片段对第1-4个元素进行比较
$display("src[1:4] %s dst[1:4] ", (src[1:4]==dst[1:4])? "==":"!=");
bit [31:0] src[5] = '{0,1,2,3,4},
dst[5] = '{5,4,3,2,1};
dst = src; // 数组复制
src[0] = 5; // 只改变一个元素的值
foreach (dst[i]) begin
if (dst[i]==src[i])
$display("src[%d] == dst[%d]",i,i);
else
$display("src[%d] != dst[%d]",i,i);
end2.4 数据结构
Verilog的最大缺陷之一是没有数据结构,SV中可以使用struct语句创建结构,跟C语言类似。
- 不过struct的功能少,他只是一个数据大集合,其通常的使用方式是将若干相关的变量组合到一个struct结构定义中。
- 伴随typedef可以用来创建新的类型,并利用新的类型来声明更多变量
1. struct(不加 typedef):一次性变量
- 语法:
struct {bit [7:0] r, g, b;} pixel; - 本质:直接在内存中创建了一个名为
pixel的实体变量。 - 缺点:无法复用。想再建一个同类变量,必须原样重写一遍
struct {...} pixel2;。 - 比喻:纯手工捏泥人,捏一个是一个。
2. typedef struct(加 typedef):自定义新类型(推荐做法)
- 语法:
typedef struct {bit [7:0] r, g, b;} pixel_s; - 本质:注册了一个新数据类型
pixel_s(和int地位一样,本身不占内存)。 - 优点:高度复用。后续可直接用它批量声明变量:
pixel_s p1, p2;。 - 比喻:画了一张图纸,以后可以按图纸无限批量生产。
1. packed
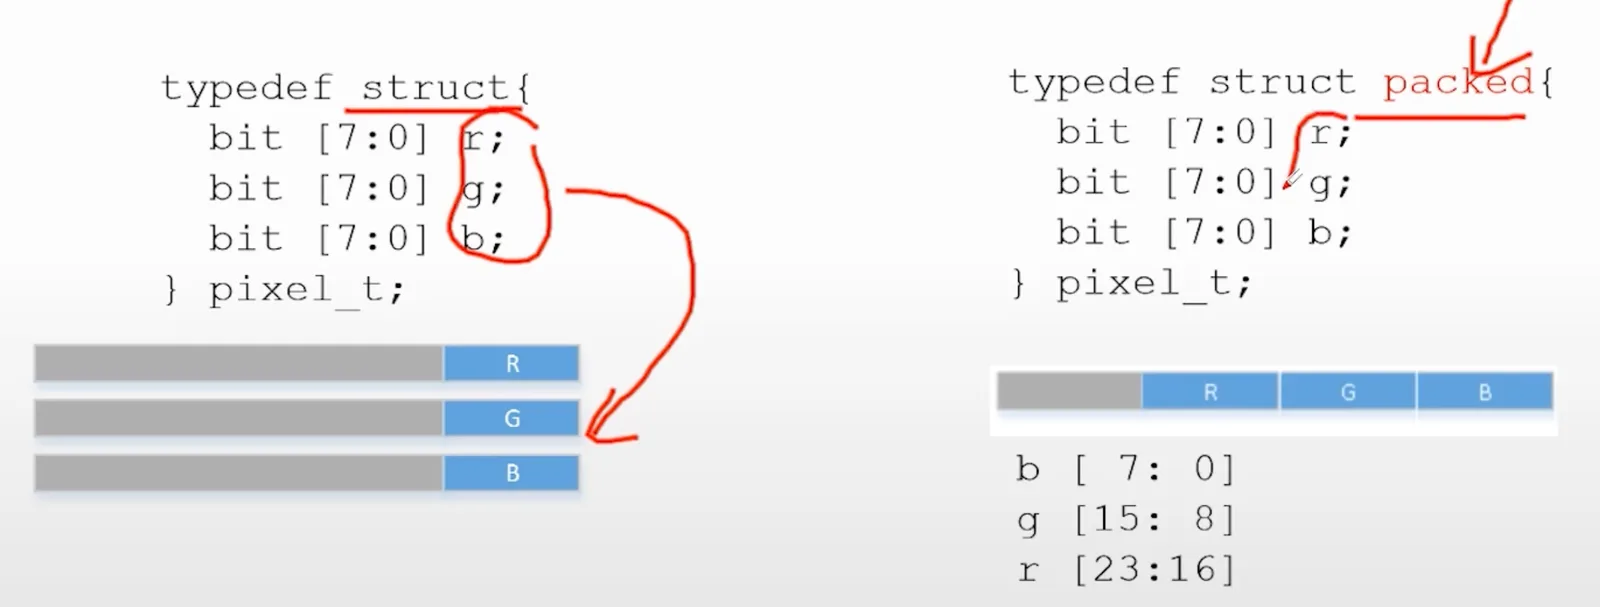
左边是unpacked struct:r、g、b各占一个独立的存储单元,灰色是空着的位。右边加了packed:三个成员按声明顺序连成一个24 bit的向量,先声明的r在最高位[23:16],g在[15:8],b在[7:0]。(图中类型名写作pixel_t,与正文的pixel_s是同一个结构体。)
//1. 非压缩结构体(Unpacked Struct)- 默认状态
typedef struct {
    bit [7:0] r;
    bit [7:0] g;
    bit [7:0] b;
} pixel_s;

pixel_s my_pixel; // 声明变量(struct初始化)
my_pixel = '{'h10, 'h10, 'h10}; // 赋值必须带单引号 ' //按结构体成员逐个赋值

//2.压缩结构体(Packed Struct)- 硬件友好型
typedef struct packed {
    bit [7:0] r;
    bit [7:0] g;
    bit [7:0] b;
} pixel_s;

pixel_s my_pixel;

// 赋值方式的区别:
my_pixel =  {8'h10, 8'h10, 8'h10}; // 【不带'】作为整体向量拼接赋值(带'也不会报错)
- “非压缩”占地随意,赋值必加单引号;
- “压缩”连成一根线,加不加引号都能算(但底层逻辑不同,一个是按成员,一个是按位拼接)。
2. union packed
packed
- 它告诉编译器(或综合工具),这个联合体中的数据是以连续的比特位(Bits)形式存储的,中间没有空隙。
union(联合体):联合体内的所有成员共享同一个存储空间。
- packed union 所有成员共享同一段存储且必须等宽;这里
raw_data与fields都是 32 bit,访问同一位置——改fields.enable会同时改变raw_data。
// 32 位联合体:raw_data 视图 + 字段视图,二者同址、等宽
typedef union packed {
    logic [31:0] raw_data;     // 视图1: 看作 32 位原始数据

    struct packed {            // 视图2: 看作控制字段(合计 32 bit,与 raw_data 同址)
        logic [15:0] reserved; // 高 16 位保留
        logic [7:0]  data;     // 中间 8 位数据
        logic        enable;   // 1 位使能
        logic        start;    // 1 位开始
        logic        error;    // 1 位错误
        logic [4:0]  mode;     // 5 位模式
    } fields;
} control_reg_u;

control_reg_u my_reg;

initial begin
    my_reg.raw_data      = 32'h0;  // 用法A: 整体清零
    my_reg.fields.enable = 1'b1;   // 用法B: 单独设 enable(同时改变 raw_data)
    // logic [31:0] bus_data = my_reg; // 用法C: 合法,被视为 packed
end
在 SystemVerilog 中,packed struct 的默认存储顺序是从高位到低位(First member is MSB)。
typedef union packed {
        logic [31:0] word;
        struct packed {
            logic [11:0] i_imm;
            logic [4:0]  rs1;
            logic [2:0]  funct3;
            logic [4:0]  rd;
            rv32i_opcode opcode;
        } i_type;
} instr_t;| 结构体成员定义 | 位宽 | 对应的 word 位段 (Absolute Position) | 对应 RISC-V I-Type 定义 |
|---|---|---|---|
logic [11:0] i_imm | 12 bits | word[31:20] | Immediate[11:0] |
logic [4:0] rs1 | 5 bits | word[19:15] | Source Register 1 |
logic [2:0] funct3 | 3 bits | word[14:12] | Function 3 |
logic [4:0] rd | 5 bits | word[11:7] | Destination Register |
rv32i_opcode opcode | 7 bits | word[6:0] | Opcode |
| 总计 | 32 bits | word[31:0] |
为什么要写成 [11:0] 而不是 [31:20]?
答:取值方便性。当你使用 inst.i_type.i_imm 时,你希望得到的是一个数值(例如立即数 12)。
- 如果是
logic [11:0],你读出来的就是一个 12 位的数,可以直接参与运算。只不过编译器自动把它安排在了[31:20]。 - 如果是”绝对位置”的概念,你读出来的数据可能需要右移 20 位才能得到真实的数值。SV 的写法让你取出来就是”对齐”到低位的值,非常方便。
3. struct vs union
类型不是硬件
上面说typedef是「图纸」,本身不占内存。放到硬件里也一样:typedef struct、typedef union只定义形状,不生成任何电路。用它声明的变量综合成什么,跟Verilog的reg一样,看在哪赋值:
- 在
always_ff @(posedge clk)里赋值:触发器 - 用
assign、always_comb赋值,或者直接接端口:组合逻辑、连线
以5级流水CPU为例,同一个类型声明两个变量,只是赋值的地方不同:
typedef struct packed {
    logic [31:0] pc;
    logic [63:0] order;          // 指令序号(验证用)
    logic        valid;
} id_reg_t;                      // 只是形状,不生成电路

id_reg_t id_next;                // 同一个类型
id_reg_t id_reg;                 // 同一个类型

always_comb begin                // 在组合块里赋值 → 97根线
    id_next.pc    = pc_if;
    id_next.order = order_if;
    id_next.valid = !flush;
end

always_ff @(posedge clk)         // 在时序块里赋值 → 97个触发器,就是IF/ID流水寄存器
id_reg <= id_next;id_next是这一拍算出来的值,id_reg在时钟沿把它存住,下一拍给ID级用。
packed struct:一根宽向量
id_reg是一个97位的寄存器,不是三个独立的寄存器。字段名只是给其中几段起的名字(先声明的字段放高位):
id_reg_t = pc(32) + order(64) + valid(1) = 97位
id_reg.pc    就是 id_reg[96:65]
id_reg.order 就是 id_reg[64:1]
id_reg.valid 就是 id_reg[0]- 写一个字段只动那几位:
id_reg.valid <= !flush只改1个触发器 - 也能整体操作:
id_reg <= '0一次清掉97位 - 级间要传的信号打成一包,一个端口
input id_reg_t id_reg就传完;以后加字段只改typedef,端口不用动
对比
| struct packed | union packed | |
|---|---|---|
| 成员关系 | 首尾拼接,各占各的位 | 全部重叠在同一组位上 |
| 总位宽 | 各成员相加(id_reg_t是97位) | 等于一个成员(instr_t是32位,所以每个成员必须一样宽) |
| 改一个成员 | 其他成员不受影响 | 其他成员读出来跟着变 |
| 典型用途 | 流水线级间要传的一包信息 | 一条指令按不同格式换着读 |
打个比方:struct是一排格子,各放各的;union是同一张纸,套不同的模板看。是不是寄存器,两者都看在哪赋值。
4. enum
枚举:人话与数字的对应关系
不使用enum:

// 极其难读的代码
if (light_signal == 2'd0) begin
    // 停车
end else if (light_signal == 2'd2) begin
    // 通行
end

---------------

// 定义枚举:==人话与数字的对应关系==
typedef enum logic [1:0] {
    RED    = 2'd0,
    YELLOW = 2'd1,
    GREEN  = 2'd2
} traffic_light_t;

// 使用枚举的代码
traffic_light_t current_light; // 声明变量

if (current_light == RED) begin
    // 停车
end else if (current_light == GREEN) begin
    // 通行
end
5. 类型转换(静态转换操作符 ’)
目标类型'(被转换的表达式)
//type文件:
typedef enum logic [6:0] {
        base           = 7'b0000000,
        variant        = 7'b0100000
    } funct7_t;

//instr_cg.svh文件
all_funct7 : coverpoint funct7_t'(instr.r_type.funct7);
为什么要转换?(这对 Verification 很重要)
一句话:符号 ’ 就是为了把冷冰冰的数字变成有意义的枚举名字。如果不加这个转换,覆盖率报告会很难看。
不转换:
- 直接写
coverpoint instr.r_type.funct7;- 覆盖率工具只知道这是一个 7 位的信号。
- 它会自动生成 128 个 bin(从
0到127)。 - 报告里全是数字:
auto[0],auto[32]… 你根本看不出这是什么指令。
加上转换后:
- 过滤与重命名:工具会参照
funct7_t的定义表。- 它只关注
base和variant这两个值。
- 它只关注
- 报告里会清晰地显示:
bin base:(显示覆盖次数) —— 代表你测过 ADD/SRL/OR 等指令了。bin variant:(显示覆盖次数) —— 代表你测过 SUB/SRA 等指令了。
第三章 过程语句与子程序
需要清楚哪些语句应该被放于硬件世界,哪些程序应该被放置于软件世界
- module/endmodule,interface/endinterface可以被视为硬件世界。
- program/endprogram, class/ endclass可以被视为软件世界。
3.1 过程语句
过程赋值(写在 always/initial 块内)既可建模组合逻辑也可建模时序逻辑——阻塞赋值 = 多用于组合、非阻塞赋值 <= 多用于时序;连续赋值(assign)驱动 wire/net,用于组合逻辑。
- begin_end 语句——标识顺序执行的语句
- fork_join 语句——标识并行执行的语句
always和initial都是从0时刻开始运行的
条件语句分为两种:if-else 语句和 case 语句;它们都是顺序语句,应放在 “always” 块内!
对于 case 条件语句,若控制表达式的所有情况都列出,则无需写 default。
避免生成锁存器的原则:
- 如果用到 if 语句,最好写上 else 项;
- 如果用到 case 语句,最好写上 default 项。
1. Inferred Latch
在 always_comb 块中,如果输出信号在某些条件下没有被赋值,综合器会认为你希望它”记住上一次的值”,于是自动生成锁存器(latch)。
- 注意:Inferred Latch只会存在于
always_comb块中,因为在 always_ff(时序块)里,if/case 没写全是正常现象(没写的分支=寄存器保持原值,这就是寄存器该有的行为,不是bug)
2. fork … join_any / join_none
fork join里面所有都执行完才跳出
fork … join_any:父进程只等到任意一个子进程完成,就会继续往下执行,其他子进程仍然在后台执行。
fork … join_none:父进程不等待任何子进程,立即继续执行。子进程在后台独立运行。常用于启动一些”后台任务/守护线程”,不需要等待它们结束。
- 也就是开启并行执行之后立即跳出fork join向下执行
如何强制杀死线程?
disable 不是优雅退出,而是直接 强制终止,相当于杀线程。
initial begin
  fork : my_fork
    begin : taskA
      #5  $display("Task A done");
    end
    begin : taskB
      #10 $display("Task B done");
    end
  join_any
  disable taskB;  // 只杀掉 taskB,不影响 taskA (即使它还没到 10ns)
end
3. 并行处理语句 automatic
task core_class::do_sth_on_all_cores();
  for(int i = 0; i < `PROJ_CORE_N; i++) begin
    fork
      automatic k = i; //每个fork启动的线程 都有自己独立的k, 和static相对立
      do_sth_on_core(k);
    join_none //使主线程不等待任何子线程,确保所有 core 的任务可以立即并行启动
  end
end
4. wait 和 @ 的区别
核心知识点速记:@ (等变化) vs wait (等状态)
这段代码完美展示了这两个控制符的最本质区别:
-
@是“边沿敏感” (Edge-sensitive):-
逻辑:它在等信号发生变化(0变1,或者1变0)。
-
结果:在这个代码里,
clk初始化为 1 后就再也没变过。因为没有变化,所以@(clk)会永远卡在这里死等,它下面的打印语句永远不会执行。
-
-
wait是“电平敏感” (Level-sensitive):- 逻辑:它不管你变没变,它只看当前的状态是不是为真 (1)。
- 结果:在这个代码里,
clk是 1。wait(clk)一看条件满足,直接放行!所以仿真会立刻打印出"i have reached clk"。 - 注意:wait不是”等触发”,是”看当下状态”——如果调用 wait 那一刻条件已经为真,不需要任何变化发生,直接0延迟通过,根本不”等”。
program automatic test_event();
    logic clk,a,b,c;

    // 线程组1:控制时钟翻转
    initial begin
        clk = 1'b0;
        #3 clk = 1'b1;  // 在第3个时间单位,clk从0变1
    end

    // 线程组2:fork...join 内部的两个begin...end块会【同时】启动
    initial fork
        // 子线程 A (测试 wait)
        begin
            #5 ;        // 先硬等5个时间单位
            wait(clk)   // 此时再去检查clk的状态
            $display("i have reached clk"); //仿真:第二个打印
        end

        // 子线程 B (测试 @)
        begin
            @(clk)      // 从0时刻开始死盯clk的跳变边沿
            $display("reached posedge of clk"); //仿真:第一个打印
        end
    join
endprogram
3.2 SV子程序
function 在模块内部定义,通常在本模块中调用,也能根据按/模块层次分级命名的函数名从其他模块调用。而 task 只能在同一模块内定义与调用!
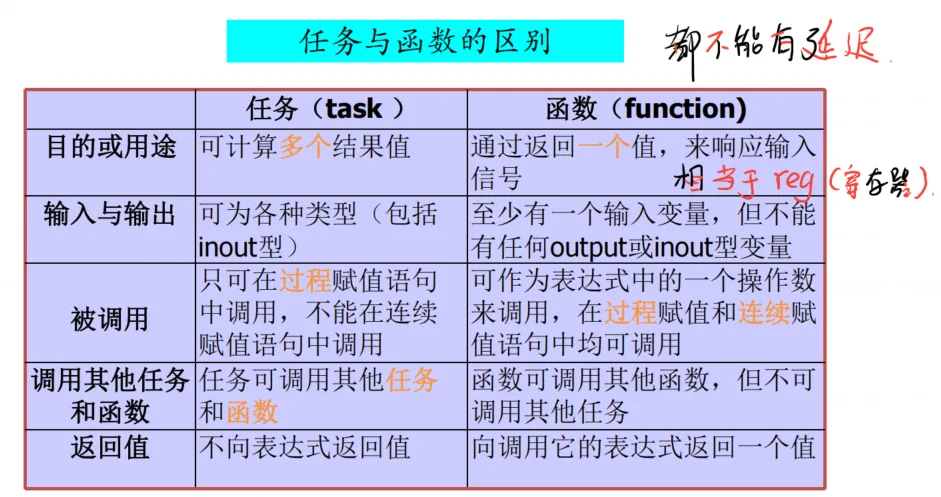
1. function
模仿数学函数(如 y = f(x))。它的目的是经过计算返回唯一的一个值。
function 需要通过赋值的方式来调用其返回值,因为 function 是有返回值的。
- 定义函数时至少要有一个输入参量!且
- Verilog: 只能”单向输入”:数据只能从外面传进函数里(
input)。 - SystemVerilog: 函数(function)是允许有
output、inout甚至ref(引用)参数的!
- Verilog: 只能”单向输入”:数据只能从外面传进函数里(
- 在函数的定义中必须有一条赋值语句,给函数中的一个内部寄存器赋以函数的结果值,该内部寄存器与函数同名。
- 只能”通过函数名”返回结果:函数想要输出结果,必须通过函数本身的返回值(即
return或赋值给函数名),而不能通过参数列表把数据”带”出去。
- 只能”通过函数名”返回结果:函数想要输出结果,必须通过函数本身的返回值(即
 function [7:0] add_numbers;
        input [7:0] a, b;  // 输入参数 a 和 b
        reg [7:0] result;   // 用于存储计算结果的内部寄存器

        begin
            result = a + b;  // 给 result 赋值,计算 a 和 b 的和
            add_numbers = result; // 将 result 赋给函数名,作为返回值
        end
    endfunction

assign sum = add_numbers(x, y);

// SV 允许 void 函数(不返回值),并通过 output 参数把结果带出去 —— 就相当于task了
function void get_results(input int a, input int b, output int sum, output int sub);
    sum = a + b; // 通过 output 参数输出
    sub = a - b; // 通过 output 参数输出
endfunction

initial begin
    int x, y;
    get_results(10, 5, x, y); // 调用后,x变成15,y变成5
end
2. ref 关键字(引用传递)
ref 让形参直接引用实参本身,不拷贝——子程序内部改形参,实参跟着变。
task no_ref(int arr[]);                 // 默认 input:传拷贝
    foreach (arr[i]) arr[i] = arr[i] * 2;
endtask

task automatic with_ref(ref int arr[]); // ref:传本体
    foreach (arr[i]) arr[i] = arr[i] * 2;
endtask

initial begin
    int a[3] = '{1, 2, 3};
    no_ref(a);
    $display(a);   // {1, 2, 3}  没变——改的是拷贝

    int b[3] = '{1, 2, 3};
    with_ref(b);
    $display(b);   // {2, 4, 6}  变了——改的是本体
end
不加 ref 时,改的值改在哪、后来去哪了? —— 改在子程序自己临时开的局部变量里(形参是独立拷贝,存在这次调用的栈帧上),跟调用者的变量是两块不同内存。endtask/endfunction 一结束,栈帧连同这份拷贝一起被销毁,改动随之消失,调用者的原变量从头到尾没被碰过:
- 不加 ref(默认 input):拷贝一份传进去,数组越大拷贝开销越大,子程序内部怎么改都不影响外面,改动随栈帧一起被销毁(如上图)。
- 加 output:不拷贝进,但结束时把子程序局部的值整体拷贝给调用者的实参——笔记前面
get_results例子(3.2 SV子程序 → function)已经示范过,这里再放一个最小例子对比:
task with_output(output int result);
    result = 99;   // 子程序内部先改自己局部的 result
endtask            // 结束时才把这份值拷贝给调用者的实参

initial begin
    int x;
    with_output(x);
    $display(x);   // 99 —— 结束时才拷贝出来,不是全程同步
end- 加 ref:不拷贝,全程共享同一份存储,省开销,中途改的值外面立刻可见(不用等子程序结束)。
不加 ref 不是没用——只读场景就该用默认 input,防止手滑改坏调用者变量:
task show_sum(int a, int b);  // 没写方向关键字 = 隐式默认 input(同 input int a, input int b)
    $display("sum=%0d", a + b);  // 只读,不用带值出去
endtask
function 也能用 ref,不只 task,且能和 task 不一样——ref 改本体的同时,还能有真正的返回值(task 没有返回值通道):
function automatic int sum_and_double(ref int arr[]);
    foreach (arr[i]) arr[i] *= 2;             // ref:直接改本体
    foreach (arr[i]) sum_and_double += arr[i]; // 返回值:赋给函数名
endfunction

initial begin
    int a[3] = '{1, 2, 3};
    int total = sum_and_double(a);
    $display(a);      // {2, 4, 6}  —— ref 生效,本体被改
    $display(total);  // 12          —— 同时还带回一个返回值
end
ref 必须配 automatic(LRM 强制,否则编译报错):automatic = 每次调用独立开一份局部变量(类似栈帧);默认 static = 所有调用共享同一份存储。ref 要绑定”这一次调用”的实参,static 局部变量却全局唯一一份,并发/递归调用会互相踩——所以 LRM 强制 ref 子程序必须 automatic。
3. task
模仿过程或操作。它可以没有返回值,也可以通过端口返回多个值。
task 不返回值,它会直接对传入的参数或模块内部的变量进行修改(即通过传参或内部变量的改变来实现功能)。
如果task语句中存在return,则只能返回空值用作中断task跳出,不能返回数值。
task my_task(input [7:0] a, input [7:0] b);
    // 在 task 内部进行一些操作
    $display("The sum is: %d", a + b);
endtask

// 调用 task
initial begin
    my_task(8'd10, 8'd20);
end
注意:对于 function,和 task 一样,传入的参数需要对应其内部定义的 input 变量。
4. automatic / static
模块内 task/function 默认 static:所有调用共享同一份局部变量存储;声明 automatic 后,每次调用各开一份独立副本。
task static_cnt();           // 默认 static
    int cnt = 0;              // 只在仿真最开始初始化一次!
    cnt++;
    $display("static cnt=%0d", cnt);
endtask

task automatic auto_cnt();   // 显式 automatic
    int cnt = 0;              // 每次调用都重新初始化
    cnt++;
    $display("auto cnt=%0d", cnt);
endtask

initial begin
    static_cnt();  // static cnt=1
    static_cnt();  // static cnt=2   ← 沿用上次的存储,不是新变量
    auto_cnt();     // auto cnt=1
    auto_cnt();     // auto cnt=1   ← 每次都是新的一份,互不影响
end
static 的坑:递归或并发调用(fork 出多个分支同时调这个 task)会共享同一份局部变量、互相踩——这种场景必须用 automatic。
5. $timeformat
// 常用于指定%t显示的时间格式,例如$display, $monitor等
$timeformat [ ( units_number , precision_number ,
                suffix_string , minimum_field_width ) ] ;
// units_number : -9 表示ns;-12表示ps;-15表示fs;
// precision_number: 数据精度,小数点后的多少位;
// suffix_string: 时间值之后的字符串;
// minimum_field_width: 时间字符串字段的最小宽度;

module timing;
    timeunit 1ns;       // 时间单位
    timeprecision 1ps;  // 时间精度
    initial begin
        $timeformat(-9,3,"ns",8);
        #1      $display("%t",$realtime); // 1.000ns
        #2ns    $display("%t",$realtime); // 3.000ns
        #0.1    $display("%t",$realtime); // 3.100ns
        #41ps   $display("%t",$realtime); // 3.141ns
    end
endmodule
第四章 激励时序与接口
4.1 SV的激励时序
1. Race / Hazard
组合逻辑里,同一信号走多条延迟不同的路径汇合到同一个门,到达时间有先后,输出瞬间蹦出不该有的尖峰——这就是竞争冒险,尖峰叫毛刺(glitch)。
assign b = a & ~a; // 逻辑上恒为0~a 比 a 多经过一级非门的延迟。a 翻转的瞬间,直接进 AND 门的 a 立刻更新到新值,但 ~a 要多等一级非门延迟才更新、还停在旧值——这段延迟窗口里两者短暂同为1,AND门就蹦出一个毛刺,而不是稳稳的0。
2. TB 和 RTL 之间的竞争
组合逻辑毛刺只是铺垫。同一个仿真时刻,testbench 在初始化某个信号,RTL 同时在读这个信号——谁先谁后,语言标准不保证,换个仿真器/换种写法结果可能就变了:
// DUT
always @(posedge start)
	if (write)
	mem[addr] = data;

// TB,下面几行在同一个仿真时刻执行(对DUT来说无先后保证)
initial begin
    start = 0;
    write = 0;
    #10;
    addr = 8'h42;
    data = 8'h5a;
    start = 1;
    write = 1;   // DUT 读到的是这次赋值前还是后的值?不确定
end
早期靠 #0、#1 硬插队都不靠谱(#0 语句一多,谁先谁后又说不清;#1 在不同 timescale 的 module 之间根本不等价)。SV 用 program block + clocking block 从根上解决这个问题——这才是本章要学的东西。
3. program block
SV 规定了一套调度顺序(分层事件队列),每个仿真时刻分成几个区域执行;RTL(module) 固定跑在 Active 区,testbench 代码如果放进 program 块,会被排到 Active 之后的 Reactive 区——保证 TB 读到的永远是这一拍 RTL 算完、稳定之后的值,从根上消除第2点的竞争。
program 语法长得像 module,但内部不能再嵌套 module/interface/program。
program block是SV语言层面解决TB/RTL竞争的”教科书式”机制,这个知识点值得弄懂。但实际UVM环境很少真的用program块:
- UVM的TB基本是
class堆出来的(driver/monitor/scoreboard…),顶层就一个module里initial调run_test() - UVM自己有一套phase/objection机制管”什么时候干什么事”,不靠program block的区调度保证顺序
- program块对class的virtual方法、动态多态在部分仿真器上兼容性差,业界基本绕开不用
所以:懂”为什么需要program block”就够了,别纠结”以后写UVM代码是不是也要套一层program”——大概率不会。
补充(课程老师确认):program block不是解决TB/RTL竞争的唯一办法,非阻塞赋值(<=)、clocking block都能从各自角度缓解这个问题——program管的是”整个TB代码块的执行顺序”,clocking block管的是”单个信号读写不racy”,两者管的范围不同,不是缺一不可的绑定关系。所以这个知识点要懂,但实际写法不唯一。
4. clocking block
program block 只解决”TB 整体排在 RTL 后面”,没解决”具体哪个时钟沿采样/驱动”。clocking block 把接口里信号的采样和驱动都跟指定时钟沿绑定:
interface arb_if(input bit clk);
    logic [1:0] grant, request;
    clocking cb @(posedge clk);
        output request;   // TB 通过 cb 驱动
        input  grant;      // TB 通过 cb 采样
    endclocking
    modport TEST (clocking cb);
endinterface
采样/驱动的具体时序规则(重点)放在 4.3 讲。
结论:TB永远读到RTL这一拍算稳定后的值;clocking block采样拿到的是前一拍的值
4.2 SV的接口
1. 为什么需要 interface
设计越来越复杂,模块间要连的信号一多,DUT 和 testbench 之间就是几百根线。interface 把这些信号打包成一捆”智能连线”,既管连接、也管同步,一根接口就能代表 DUT↔TB 之间的一整套信号。
interface arb_if(input bit clk);
    logic [1:0] grant, request;
    logic       grant_valid;
    logic       rst;
endinterface
2. interface vs 端口连接
不用 interface 的话,DUT、TB、顶层 3 处都要各写一遍完整的信号列表:
// 端口方式:grant/request/rst/clk... 每个模块都要重复声明一遍
module arb_port(output logic [1:0] grant, output logic grant_valid,
                 input  logic [1:0] request, input logic rst, input logic clk);
    // ...内部实现省略...
endmodule

module test(input logic [1:0] grant, /*...*/ output logic [1:0] request /*...*/);
    // ...内部实现省略...
endmodule

module top;
    logic [1:0] grant, request;
    logic       grant_valid;
    bit         clk, rst;
    arb_port a1(grant, grant_valid, request, rst, clk);
    test     t1(grant, grant_valid, request, rst, clk);
endmodule
DUT 端口一改,3 处都要跟着改。用 interface,信号只在 interface 里声明一次,模块间直接传”接口”这一个东西:
module arb (arb_if arbif);
    // ...内部实现省略...
endmodule

module test(arb_if arbif);
    // ...内部实现省略...
endmodule

module top;
    bit clk;
    arb_if arbif(clk);      // 例化接口
	arb    a1(arbif);       // 连接DUT
    test   t1(arbif);       // 连接TB
endmodule
新增一个信号,只改 interface 定义,top/arb/test 都不用动。(这里 arb/test 直接拿整个 arb_if,还没分方向——分方向是下一节 modport 的事)
注意:若DUT本身定义的时候没有使用interface,则顶层连接的时候需使用引用,如arbif.grant。
3. modport
interface 里的信号默认没有方向。modport 负责按”谁在用”把信号分组,并在每组里指定方向,指定的方向与实际模块内的信号方向一致
interface arb_if(input bit clk);
    logic [1:0] grant, request;
    logic       rst;
    modport TEST   (output request, rst, input  grant, clk);
    modport DUT    (input  request, rst, clk,   output grant);
    modport MONITOR(input  request, grant, rst, clk);          // 纯旁观,全input
endinterface
用的时候在端口声明里指定走哪个 modport: module arb(arb_if.DUT arbif); module test(arb_if.TEST arbif);
4. interface 的优缺点
优点:改动只在 interface 里做一次、少犯连线错误;modport 把方向和分组都锁死;接口本身可以整体复用到别的项目。
缺点:纯点对点连接时反而比直接列端口更啰嗦;调用信号必须写全”接口名.信号名”,代码变长;两个用不通用协议的模块之间硬套 interface,工作量不降反升。
- 如果使用interface的模块不多,则考虑是否使用interface
- 若原来DUT模块就没有使用interface,则考虑是否使用
4.3 SV接口的驱动和采样
1. 核心规则
clocking block 采样(input)拿到的是上一拍的值;驱动(output)在当前拍立刻生效。(背结论就够,机制不用深究)
想让TB代码稳定排在后面,就把它塞进program块里,这就是program block存在的全部意义。
TB通常要读DUT算出来的结果(比如grant信号),如果两者没有先后顺序、同时跑,TB可能读到DUT还没算完的中间值、不稳定的值——这就是最开始讲的竞争问题。让TB严格排在RTL后面执行,TB读到的永远是这一拍RTL算稳定之后的最终结果,不会读错。
2. 接口里的双向信号 (inout)
clocking block 里可以放 inout,用于总线这类三态信号:
interface master_if(input bit clk);
    wire [7:0] data;
    clocking cb @(posedge clk);
        inout data;
    endclocking
    modport TEST(clocking cb);   // 简写:直接沿用cb里定义的方向,不用像4.2.3那样把信号逐个列出来
endinterface

initial begin
    mif.cb.data <= 'z;               // 释放总线(高阻)
    @mif.cb; $display(mif.cb.data);  // 读
    @mif.cb; mif.cb.data <= 7'h5a;   // 驱动
    @mif.cb; mif.cb.data <= 'z;      // 用完再释放
end
SV 标准没规定这种异步双向信号该怎么驱动,实践上常见两种做法:连续赋值语句,或者用虚接口 virtual interface。
3. program 里为什么不能用 always
program块靠”最后一个initial跑完=仿真自动结束”来判断该收尾(等于隐式执行了
$finish),而always天生不会结束,两者矛盾,所以语言直接禁止。
initial forever #5 heartbeat = ~heartbeat; // program 里合法,效果类似 alwaysclk 更是特例——时钟发生器不该写在 program 里,因为时钟翻转和其他信号变化谁先谁后可能产生新的竞争,应该放进普通 module,用阻塞赋值:
module clock_generator(output bit clk = 1);
    always #5 clk = ~clk;
endmodule
第五章 面向对象编程
5.1 SV类
1. OOP术语速记
| 术语 | 含义 | 对比 Verilog/module |
|---|---|---|
| Class 类 | 变量+子程序的构建块,“软件盒子”(class一般用来构建软件设计,比如TB) | module 是”硬件盒子” |
| Object 对象 | 类的一个实例 | module 例化=“硬件例化”,class 例化=“软件例化” |
| Handle 句柄 | 指向对象的指针 | Verilog 靠层次化路径A.B.sigX索引;SV class必须靠句柄索引 |
| Property 属性 | 存数据的变量 | 相当于 module 里的 wire/reg |
| Method 方法 | class 里用 task/function 定义的操作 | 相当于 module 里的 task/function |
- 封装:数据+操作数据的方法打包在一起,藏起内部实现细节
- 继承:子类直接拿到父类的属性和方法,不用抄一遍
- 多态:同一个方法调用,因为对象实际类型不同,跑出不同实现
- 父类的方法在在子类中可以表现出不同的行为
Testbench里,激励生成器(generator)、驱动器(driver)、监测器(monitor)、比较器(checker)——每个组件功能和处理的数据都不一样,但同一类型组件换个项目/换个环境,功能和数据结构又高度相似。角色明确、职责分立,正好是OOP的强项——这也是UVM整个框架用class堆出来的原因。
2. 类 vs struct
struct只是单纯数据集合;class除了数据(property),还能定义方法(method)处理这些数据,是”数据+方法的自洽体”。
- 此外struct在仿真开始的时候内存空间已经分配,而class是在仿真过程中分配的内存空间
3. 一个简单的类
class Transaction;
    logic [31:0] addr;      // Property
    logic        kind;
    logic [63:0] data;

    function new(logic [31:0] addr);    // Constructor
        this.addr = addr;
        this.kind = 'x;
        this.data = 'x;
    endfunction

    function void display();            // Method
        $display("addr=%h, kind=%b, data=%h", addr, kind, data);
    endfunction
endclass
使用:
Transaction tr_gen;        // 声明句柄(Handle),此时指向 null
tr_gen = new(32'h7788);    // 创建对象(Object)
tr_gen.kind = 1'h1;        // 句柄.属性
tr_gen.display();          // 句柄.方法
5.2 SV 类的成员操作
1. 访问权限:local / protected / public
默认不写=public(子类、外部都能访问);protected=只有该类 和 子类能访问,外部不行;local=只有该类自己能访问,子类和外部都不行。
class clock;
    local bit is_summer = 0;
    local int nclock = 6;
    function int get_clock();
        if (!is_summer) r
	        eturn this.nclock;
        else return this.nclock + 1;
    endfunction
endclass

clock ck;
initial begin
    ck = new();
    $display(ck.get_clock());  // OK,走方法访问
    $display(ck.nclock);        // ✗ 报错:Illegal access to local member nclock
endck.nclock那行的真实报错** Error (suppressible): (vlog-8688) : Illegal access to local member nclock.
local成员只有类自己碰得到,外部(哪怕是同一个句柄的宿主代码)直接点出来就是这个错。
初学/验证环境范围小,直接用默认public图方便也行,商业软件包才需要严格封装。
2. 创建对象
new()开辟一块新内存,存放这个对象自己的成员变量和方法。Verilog的例化是静态的(编译链接时就定死);SV class的例化是动态的(仿真任何时刻都能new,更灵活省空间)。
Transaction tr;   // 只声明句柄,此时是 null,没指向任何对象
tr = new();        // 真正创建对象,成员变量初始化为默认值(二值变量0,四值变量x)
3. 构造函数定制
new()不用(也不能)像普通function那样在前面写返回类型——它的返回类型语言已经定死了,永远是”指向本类对象的句柄”,不用用户手动声明,也改不成别的类型。可以给new()加参数、加默认值,让创建对象更灵活:
class Transaction;
    logic [31:0] addr, crc, data[8];
    function new(logic [31:0] a=3, d=5);
        addr = a;
        foreach(data[i]) data[i] = d;
    endfunction
endclass

Transaction tr;
tr = new(10);         // a=10, d用默认值5
tr = new(.a(10));     // 按名字传参,效果同上
4. 句柄的传递
不是复制对象,是复制指针——赋值只是让两个句柄指向同一个对象:
Transaction t1, t2;
t1 = new();
t2 = new();
t1 = t2;     // 把t2的指针赋给t1,t1和t2现在指向同一个对象
             // t1原来指向的对象没有句柄再指它,等着被回收
t2 = null;   // t2不指向任何对象了,但t1还指着(因为它们本来就是同一个对象)危险操作,初学谨慎使用
t1 = t2; 执行完之后的内存状态:
graph LR
    t1(("t1")) --> ObjB["对象B<br/>(t2一开始new的)"]
    t2(("t2")) --> ObjB
    ObjA["对象A<br/>(t1一开始new的)<br/>已无句柄指向<br/>等待被回收"]
    classDef orphan stroke-dasharray: 5 5,opacity:0.6
    class ObjA orphan
t2 = null之后,t2不再指向任何对象——再去t2.addr这样访问会直接报运行时错误(空句柄不能解引用),跟C里对着空指针操作一样危险,用之前记得判断。- 经典陷阱:
t1 = t2;之后t1.addr = 6;,t2.addr也会跟着变成6——因为t1和t2此刻是同一个对象,改哪个句柄都一样。
5. 浅拷贝 vs 深拷贝
浅拷贝(tr2 = new tr1)开新内存复制属性值,跟纯句柄别名(t1 = t2)不同——类里只有bit/int时,两个对象已互不影响。
但属性若是嵌套类的handle(如transaction内嵌packet),浅拷贝只复制指针,内层对象仍被两者共享。翻车例子:scoreboard拷贝transaction做”预期快照”,之后改原对象——packet没深拷贝的话,快照被连带改掉,比对直接失效。
先看简单情况(无嵌套handle)——浅拷贝就够:
class transaction;
    bit [7:0] addr, data;
endclass

transaction tr1, tr2;
tr1 = new();
tr1.addr = 1; tr1.data = 2;

tr2 = new tr1;          // 浅拷贝:属性值原样复制一份
tr2.addr = 3; tr2.data = 4;
// tr1.addr仍是1, tr1.data仍是2 —— 两份内存完全独立
存疑:
-
tr2 = new tr1 这一步做了什么? ① 开一块全新内存(不是tr1那块); ② 把tr1格子里的值(addr=1, data=2)抄一份进这块新格子。 现在存在两块独立内存(tr1的那块和tr2的那块),tr2指向的是自己那块新的, 不是tr1那块。“浅拷贝”这个”浅”字,指的就是这种”抄值、开新格子”的动作。
-
tr2.addr = 3修改的究竟是谁?
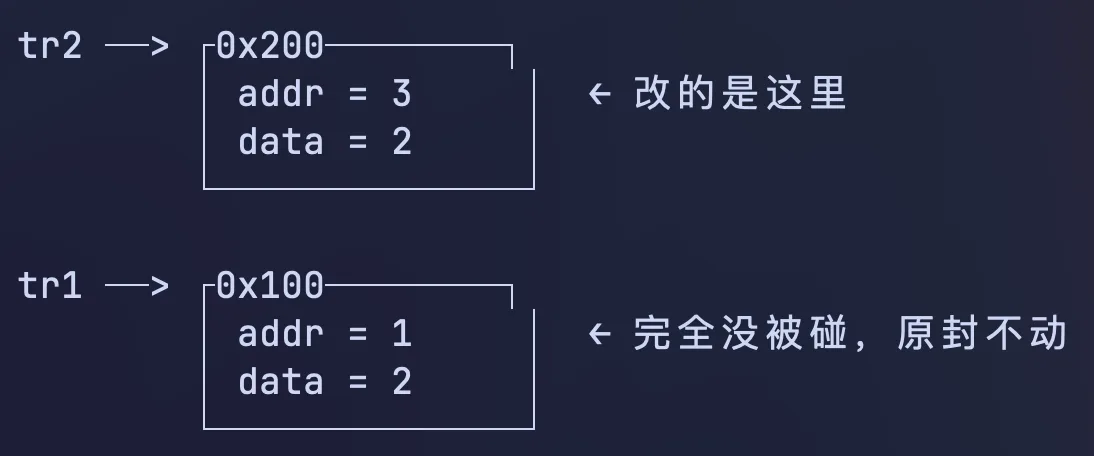
浅拷贝确实”开新格子、抄值、互不影响”。但是”浅拷贝=永远不影响原对象”——笔记1173行”嵌套handle的坑”马上会让这条经验碰到例外。
目的:要一个”独立”的新对象,改新对象不连累原对象——所以不用纯别名(t1 = t2),改用new tr1浅拷贝。但这个”独立”只在没有嵌套handle时成立;下面这种嵌套场景,浅拷贝依然让内层对象共享,达不到这个目的,得靠深拷贝。
嵌套handle时的坑:
class packet;
    bit [7:0] payload;
endclass

class transaction;
    bit [7:0] addr, data;
    packet pkt;
    function new();
        pkt = new();         // transaction一创建就自带一个新packet
    endfunction
endclass

transaction tr1, tr2;
tr1 = new();
tr2 = new tr1;           // 浅拷贝:addr/data各自独立,但pkt只复制"指针"

tr2.pkt.payload = 99;
// tr1.pkt.payload 也变成99!tr1.pkt和tr2.pkt是同一个packet对象
存疑: tr2 = new tr1; 这一步做了什么?
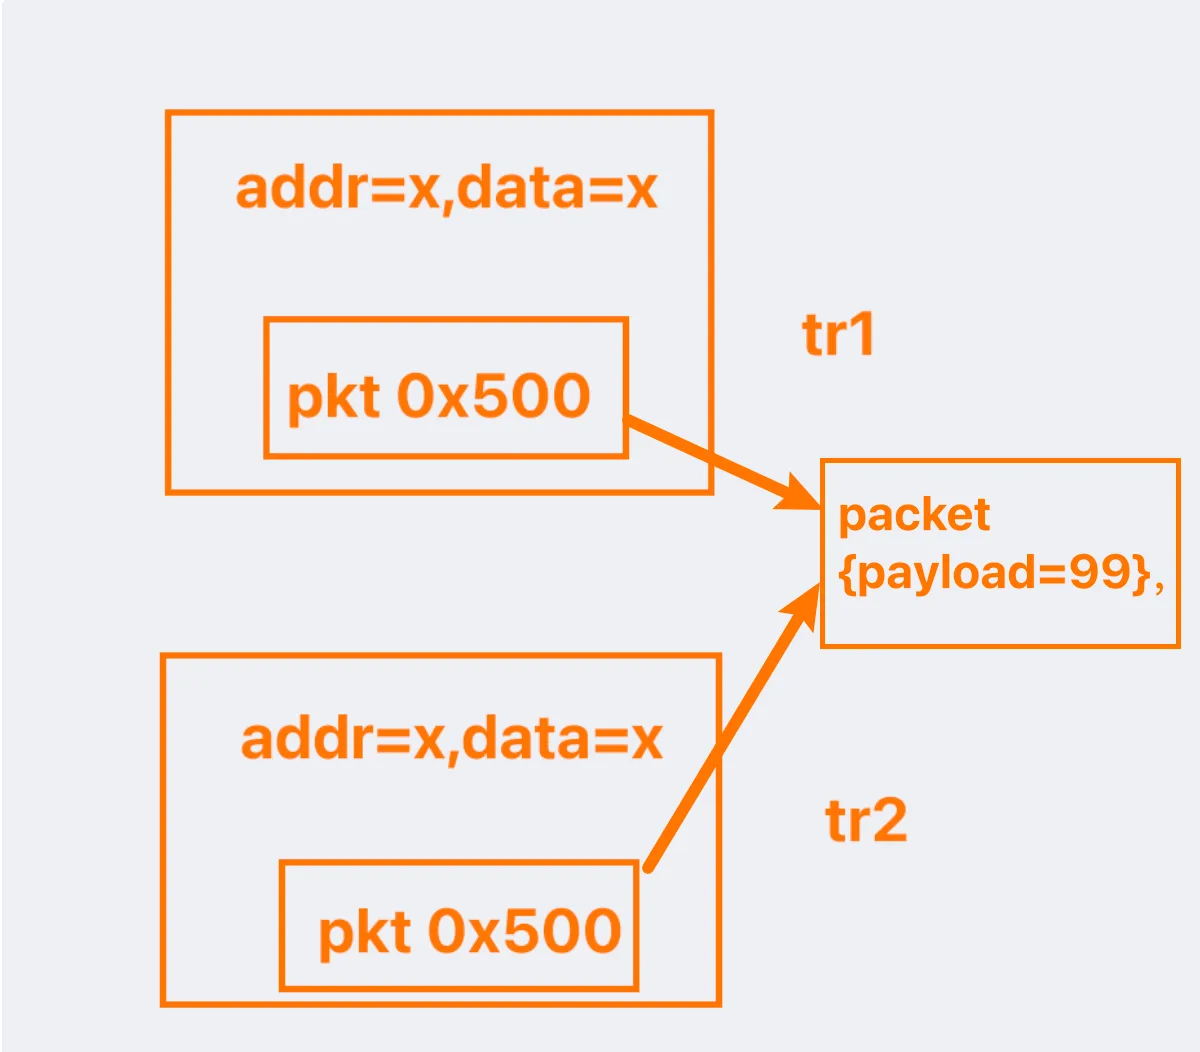 tr1和tr2是两个独立的外框,对应两块完全分开的内存(addr/data各自独立,改一个不影响另一个);
- 但每个框里的pkt字段存的不是数据本身,是一个地址值”0x500”——tr2 = new tr1这次浅拷贝把这个地址值原样抄给了tr2,所以两个框里的pkt都写着同样的”0x500”。
- 图右边那个packet{payload=99}只画了一个,两条箭头从tr1和tr2各自的pkt字段一起指向它——这就是”共享”的意思:tr1.pkt和tr2.pkt虽然是两个不同的字段(活在两个不同的框里),但它们存的地址值相同,指向的是同一块内存。
- 所以代码里tr2.pkt.payload=99改的正是这个被两边共享的框,tr1.pkt.payload读出来也会是99——不是tr1被”连累”了,是它们从浅拷贝那一刻起,pkt这个字段就注定指向同一个地方。
解决浅拷贝句柄嵌套问题——深拷贝
深拷贝:语言没有内置语法,得自己写一个copy()方法,把每个属性(包括嵌套对象)都手动new一份再复制:
- 深拷贝 = 嵌套链上每一层各自负责自己的copy(),外层显式调用内层的copy(),一层都不能漏。
class packet;
    bit [7:0] payload;
    function packet copy();
		copy = new();      //copy = 函数名,也是返回类型packet的隐式变量
        copy.payload = this.payload;
        return copy;       // 显式return它——写不写这行效果一样,copy已经被赋值了
    endfunction
endclass

class transaction;
    bit [7:0] addr, data;
    packet pkt;
    function transaction copy();
        copy = new();
        copy.addr = this.addr;
        copy.data = this.data;
        copy.pkt  = this.pkt.copy();   // 关键:嵌套对象也要手动copy
        return copy;
    endfunction
endclass深拷贝出来的是完全独立的两份内存——新对象改了,不会影响原对象;浅拷贝则会牵连内层共享的对象。类里没嵌套handle时两者等价,一旦嵌套,scoreboard/快照类场景必须用深拷贝。
UVM里提供了现成的copy()函数,不用再自己手写深拷贝逻辑。
6. 对象的销毁
一个对象只要还有句柄指向它,就不会被回收;一旦没有任何句柄指向它了,SV自动把它销毁、回收内存——不像C需要手动管理内存。
5.3 SV类的封装和继承
1. 封装的意义
把对象的属性和行为打包封装在类里,对外隐藏实现细节,外部只能通过类开放的接口操作。好处:外部不能瞎改内部数据结构,可维护性更高。
2. class VS struct VS module
| struct | class | module | |
|---|---|---|---|
| 声明即开辟内存? | 是 | 否,要new()才构造 | 是(静态,编译时定) |
| 能定义方法(function/task)? | 不能 | 能 | 能 |
| 继承性 | 不能 | 能 | 不能(要复用只能拷贝改) |
| 访问权限控制? | 没有 | 有(public/protected/local) | 没有(全public) |
| 例化时机 | — | 仿真任意时刻,动态灵活 | 仿真开始前定死,静态 |
一句话记忆:struct是纯数据集合;module是定死的硬件盒子;class是数据+方法+能继承的软件抽象模板。
3. 继承(extends)
typedef enum {WHITE, BLACK} color_t;

class cat;
    protected color_t color;
    local bit is_good;
    function set_good(bit s);
        this.is_good = s;
    endfunction
endclass

class black_cat extends cat;
  function new();
	super.new(BLACK); // 显式传递必填参数,编译通过
  endfunction
endclassblack_cat自动拿到cat的color(protected,子类能访问)和set_good()方法,不用重写。
- 子类
new()里先调用父类super.new()- 父类
new()能零参数调用(无参数/参数都带默认值)时可省略,编译器自动补super.new();;
- 父类
- 父类
new()有必填参数时子类必须显式写super.new(参数),省略编译报错(见5.5father::new(string name)例子)。
- 对象创建顺序:
- 先跑父类构造函数 →
- 再把子类自己的成员变量按声明时的默认值初始化 →
- 最后才执行子类
new()里剩下的代码。 local成员子类拿不到(只有定义它的那个类自己能碰),protected成员子类能拿到。
5.4 SV的多态
1. 多态的前提:继承
子类派生出来后,父类里的某些方法可能需要被重写;多态就是”运行时才决定到底调用哪个类的实现”,是个动态过程。
2. virtual
虚方法(多态的开关):方法定义时加virtual关键字,才具备多态能力:
- 重写(override)时参数和返回值必须跟原型一致
- 虚方法会被子类的实现”整体接管”;普通方法被子类重写后,只在子类自己(及其子类)范围内生效,父类句柄拿不到子类的重写版本
- 一条继承链上,只认最后一个派生类里的那份重写实现
3. 虚方法机制
全章最重要的例子:
class packet;
    int a=1, b=2;
    function void display_a; $display("packet::a is %d",a); endfunction
    virtual function void display_b; $display("packet::b is %d",b); endfunction
endclass

class my_packet extends packet;
    int a=3, b=4;
    function void display_a; $display("my_packet::a is %d",a); endfunction
    virtual function void display_b; $display("my_packet::b is %d",b); endfunction
endclass

packet p1;
my_packet p2;
p1 = new(); p2 = new();
p1 = p2;              // 父类句柄p1,指向子类对象p2 —— (p1声明类型(packet)"和"实际类型(my_packet)"这俩现在不一样了)

p1.display_a;   // (静态绑定)输出 packet::a is 1    ← 普通方法,看句柄的"声明类型"(packet)(普通方法选中了父类那份代码)
p1.display_b; // (动态绑定)输出 my_packet::b is 4 ← 虚方法,看句柄"实际指向的对象类型"(my_packet)父类方法一旦声明virtual,子类override时可以不用再写一遍virtual,语言自动继承virtual属性——而且这个”virtual性”会沿整条继承链一直往下传,哪怕中间某一层override没写virtual,再往下的子类override它照样是virtual、照样能正确动态绑定。 实际写代码还是建议每层override都显式写上virtual,纯粹是可读性考虑:不用跳回父类去确认这个方法到底是不是virtual。
4. 静态绑定 / 动态绑定
1.静态绑定: 编译器一看p1声明类型是packet,packet类型下的display_a方法又不是virtual,编译阶段就直接把这行焼死成”调用packet::display_a()”
2.动态绑定: display_b两边都写了virtual。编译器看到virtual,不会在编译期烧死目标——只能生成一段”运行时再去问”的逻辑。
- 运行期:仿真跑到这行,去看p1这一刻实际指向的对象——是那个my_packet对象(p1=p2赋值来的)。读到my_packet,于是调用my_packet::display_b()
- 输出my_packet::b is 4——跟p1的声明类型(packet)无关,只认对象自己的标签
普通方法=编译期静态绑定(认句柄声明的类型);虚方法=运行期动态绑定(认句柄实际指向的对象类型)——这就是多态的本质机制。带虚方法的类叫”多态类”。
前提是子类真的重写(override)了这个虚方法。子类若只是单纯继承、没有override,虚方法调用照样执行父类那份代码,用的还是父类自己的字段。
5.5 类型转换
1. 向上类型转换 upcast
class father;
    string m_name;
    function new(string name); m_name = name; endfunction
    function void print(); $display("Hello %s", m_name); endfunction
endclass

class child0 extends father;
    string car = "car";
    function new(string name); super.new(name); endfunction
endclass

father f;
child0 c0;
f = new("father");  f.print();          // Hello father
c0 = new("child0");
f = c0;     // 向上类型转换; 把子类对象塞进父类句柄,
f.print(); // Hello child0子类对象天生”是一种”父类(is-a关系),塞进父类句柄不需要任何转换语法,永远安全——但通过父类句柄只能调用父类声明过的方法/属性,子类独有的东西(比如child0的car)访问不到。
这里print()没有被子类重写,两次输出不同(Hello father / Hello child0)纯粹是因为m_name在各自构造时被设成了不同的值,跟虚方法/多态无关——真正”方法被子类重写、运行时动态决定调哪个版本”的例子看5.4第3点的display_b。
2. 向下类型转换 downcast
父类句柄想转回子类类型,得用$cast(不能隐式转换):
class child1 extends father;
    string plane;
    function new(string name); super.new(name); endfunction
endclass

child1 c1, c2;
father f;
c1 = new("child1");
f = c1;         // f(父类句柄)指向一个child1对象(先向上类型转换)
c1.plane = "big_plane";
$cast(c2, f);                        // 尝试把f转换成child1类型给c2(向下类型转换)
$display(c2.plane); // 转换成功后c2就能访问child1独有的plane属性了固定顺序:$cast(目标句柄, 源句柄)——把源句柄实际指向的对象,尝试让目标句柄也指过去,前提是目标句柄的 声明类型 对得上 【判断c2和f是不是都属于child1,若是则可转】。成功时效果等同于c2=f;失败时c2不受影响,$cast返回0(下面warning细讲)。
例:$cast(c2, f) → 目标=c2,源=f——检查f实际指向的对象是不是c2声明的类型(child1),是就让c2也指向那个对象。
“child1”没写在调用里,不代表没用到——c2在child1 c1, c2;那行已经声明成child1了,$cast直接读目标句柄自己的声明类型去检查,不用调用时再报一遍类型名。
$cast(目标句柄, 源句柄)只有在源句柄(父类句柄)实际指向的对象类型和目标句柄类型一致时才会转换成功——类型对不上转换会失败(运行时判断,不是编译报错),所以向下转换不安全,向上转换才安全。
真实UVM代码这样写,用返回值判断转换成不成功,不成功就报fatal:
if (!\$cast(c2, f)) `uvm_fatal("CAST", "cast failed")5.6 虚接口
1. 为什么需要virtual interface
interface把module的端口、方向(modport)、时序(clocking block)、task/function都封装在一起,简化了硬件模块之间的连接。
但class是纯软件构造,没法直接例化/引用一个interface的硬件层次路径——program、class里都不能直接new一个interface。
为解决这个问题,SV引入virtual interface:目的是消除TB代码里对硬件绝对路径的依赖,顶层例化结构变了,class内部代码不用跟着大改。
这里的virtual是SV复用的同一个关键字,含义完全不同——5.4的virtual管”方法运行时该跑谁的代码”(动态绑定);这里的virtual是说”这是一个能在class里当数据类型声明、指向真实interface的句柄”,跟多态/动态绑定没关系。
2. 本质:指向interface的指针
virtual interface本质是指向interface实例的指针——可以像int/class句柄一样,在class里声明、赋值、当函数参数传递。TB的class代码通过它间接摸到DUT的信号,不用写死层次路径引用。
- DUT本身没有”定义接口”:
interface是验证侧写的东西,例化在tb_top这一层,再用普通端口连接方式接到DUT的普通端口上——DUT压根不需要知道interface这个概念。 - virtual interface不是”图方便”才用,是”没它就用不了”:class天生不能
new一个interface,virtual interface是唯一能让class摸到interface信号的办法,这是能不能用的问题。消除绝对路径依赖、少改代码,只是它的第二层好处。
3. 使用要求(3条)
- 实例化的interface必须连到DUT——顶层
module里new一个interface实例,接到DUT的端口上 - class里必须声明
virtual interface句柄,靠构造函数传进来,并且有相应的驱动 - 必须把这个句柄指向那个已经连好DUT的interface实例——通常在顶层
newclass对象时,把interface实例传进去
三条对应下面代码里的①②③:
// interface —— 封装DUT的端口
interface counter_if(input logic clk);
    logic       load_valid;
    logic [3:0] load_value;
endinterface

// DUT
module counter(input logic clk, resetn, load_valid,
                input logic [3:0] load_value, output logic [3:0] q);
    always_ff @(posedge clk or negedge resetn)
        if (!resetn)         q <= 0;
        else if (load_valid) q <= load_value;
        else                 q <= q + 1;
endmodule

class driver;
    virtual counter_if vif;                    // ② class里声明virtual interface句柄,并有驱动 (不是"把interface例化进class",是在class里声明一个指向interface的指针/句柄。)
    function new(virtual counter_if vif);
        this.vif = vif;
    endfunction
    task drive(logic valid, logic [3:0] value);
        @(posedge vif.clk);
        vif.load_valid <= valid;    // ②
        vif.load_value <= value;    // ②
    endtask
endclass

module tb_top;
    logic clk, resetn;
    logic [3:0] out;
    counter_if dutif(clk);                      // ① interface实例化,连到DUT
    counter u_counter(.resetn(resetn), .clk(clk),
                       .load_valid(dutif.load_valid), // ①
                       .load_value(dutif.load_value), .q(out)); // ①

    driver my_driver;
    initial begin
        my_driver = new(dutif);                 // ③ virtual interface指向实例化的interface
        my_driver.drive(1, 4'd5);
    end
endmodule真实UVM环境不会手动new(dutif)传参,而是顶层uvm_config_db#(virtual counter_if)::set(...)存进去,driver/monitor里用get(...)取出来——机制跟这里一样,都是”class内部句柄指向顶层实例化好的interface”,只是传递方式换成了config_db。
5.7 包的使用
1. package解决什么问题
SV允许在多个module/interface/program之间共享parameter、类型定义、task/function、class——用package实现。
真正的核心是命名空间隔离:把一整个验证环境的组件类(stimulator/monitor/checker/env…)归到同一个namespace下,解决”这个类到底属于哪个模块的验证环境”的归属问题。
两个verifier各自在自己的package里,都定义了名字完全相同的4个类,内容和实现完全不一样:
package regs_pkg;
    `include "stimulator.sv"
    `include "monitor.sv"
    `include "checker.sv"
    `include "env.sv"
endpackage

package arb_pkg;
    `include "stimulator.sv"
    `include "monitor.sv"
    `include "checker.sv"
    `include "env.sv"
endpackage编译不冲突——package自带独立命名空间,同名类分属不同package互不干扰。
如果不用package、直接把这些class文件include进同一个编译单元,monitor就会重复定义,直接报错。这就是”为什么不能只靠include”的原因
- package不能嵌套定义(package里不能再写package)
- package里的内容本质都是静态的,因为package本身不会被例化,天生只有一份
2. 往package里装:include
裸class文件(没被package包着的.sv)没有名字可以引用,只能靠include文本插入。
关键约束:必须include在package体内部。
package regs_pkg;
    `include "monitor.sv"    // ← 在package体内,monitor成为regs_pkg的成员
endpackage
放在package外面,那些class会落进compilation unit scope,别的地方没法import它们。
路径问题:创建package时,包名隐含指定了默认路径——即包文件所在的目录。要include的文件不在这个目录下,编译时得加+incdir+PATH告诉编译器去哪搜。
3. 从package里取::: 和 import
方式一:::作用域解析符,每次显式指定来自哪个package。
regs_pkg::monitor mon1 = new();
arb_pkg::monitor mon2 = new();方式二:import通配导入,一次把package里所有内容引进当前作用域,之后直接写类名。
import regs_pkg::*;
monitor mon1 = new(); // 编译器去regs_pkg里找monitor两个包有同名类时,import *会出事:
import regs_pkg::*;
import arb_pkg::*;
monitor mon; // ✗ 编译错误:regs_pkg::monitor 和 arb_pkg::monitor 都能匹配,编译器无法决定注意这个错误发生在引用的那一刻,不是import的那一刻——只import不用,不报错。
所以选择判据很简单:有重名风险用::,确定不重名才用import *。import通常写在文件开头。不import、也不用::,类就躲在包这个盒子里,外部代码识别不到。
上面故意让两个package装同名类,只是为了演示”package能隔离命名空间”这件事本身。实际项目里更规范的做法是package名、类名都唯一(比如加前缀regs_stm/arb_stm),可读性更好,也让import *不会撞车。
4. include和import的本质区别
同一个对象,两个完全不同的阶段。
include是预处理器指令,发生在编译之前。它不认识package、不认识class,只认识文本——把文件内容原地复制粘贴。import是语言级声明,发生在编译期。它作用于已经建好的符号表,不复制任何代码,只让那些名字在当前作用域可见。
include | import | |
|---|---|---|
| 阶段 | 预处理(编译前) | 编译期(语义分析) |
| 作用对象 | 文件(纯文本) | package(符号表) |
| 效果 | 代码物理复制到此处 | 名字可见,代码不复制 |
| 重复执行 | 重复定义→报错,靠守卫宏挡 | 无害,可以import多次 |
| 能放哪 | 任意位置 | package/module/interface内,或文件顶层 |
比喻:include是把整本书复印一份夹进来;import是在桌上贴张便条——“以后说’张三’就指那本书里的张三”。
选哪个的判据不看文件类型,看目标是不是一个package:
| 目标 | 用什么 | 为什么 |
|---|---|---|
| package | import | 它已经是编译单元里的一个命名空间,有名字可以引用 |
| 裸class文件(没被package包着) | include | 它不是package,没有名字可import,只能文本插入 |
不用先include,在import( include和import不是一个两步流程,它们之间没有配对关系。) 而是「这个package必须已经被编译过」。让它被编译有两条路:
- 把文件列进filelist
- 在别的文件里
include
同一个package文件可能被送进编译器两次。NPU项目里image_package.sv既列在tb.f,又被testtop.sv重复include了一次——没炸是因为文件头有`ifndef __IMAGE_PACKAGE_SV守卫,第二次展开成空。package重复定义是编译错误。
5. 常见问题
- 为什么不直接
include各个类文件,非要用package?include只是文本粘贴,没有命名空间隔离——两个验证环境如果都写了同名的monitor类,直接include进同一个编译单元会命名冲突报错。package把每组类装进独立命名空间,同名也不冲突。 pkg::class和import pkg::*怎么选? 精确调用、怕命名冲突时用::;确定包内命名不跟当前scope冲突、图省事时用import *。这也是为什么实际工作要求”包名、类名都唯一”——降低import *撞车的风险。include和import能互相替代吗? 不能,两个阶段的东西。include是编译前的文本复制,import是编译期的符号可见性。裸class只能include,package只能import。
5.8 多线程间通信
1. 为什么需要——信号握手不够用了
硬件模块里各个always块可以看成多个从0时刻就开始跑、永不退出的并发”线程”,它们之间的同步靠信号变化完成(req/ack、valid/ready握手)。但软件风格的多线程(fork出来的多个task、多个class对象各自的线程)之间没有物理信号可用,需要专门的机制——这就是event/semaphore/mailbox要解决的问题。
fork...join/join_any/join_none的语法3.1已经讲过,这里不重复;这节讲线程之间怎么打招呼(event)、怎么排队抢资源(semaphore)、怎么传数据(mailbox)。
2. event(事件)——通知”发生了”
本质是一个静态的同步对象句柄,可以像参数一样在task/function间传递。
触发:-> event_handle; 等待:@event_handle;(阻塞)或wait(event_handle.triggered)(查询”是否已经触发过”)
@和wait(.triggered)不等价——这是常见的坑@只能捕获未来发生的触发,触发是瞬时的,一旦”过这一拍”就永远错过。同一时刻内SV按源码从上到下调度多个initial块,下面这段代码里,两个块不是都卡死,是其中一个卡死:
event e1, e2;
initial begin                      // 先执行
    -> e1;                         // 触发e1(瞬时,触发完立刻消失)
    @e2;                           // 此刻e2还没被触发,在这里阻塞等
    \$display("1:after trigger");   // e2稍后被下面那个块触发时,正好捕捉到——这行会执行
end
initial begin                      // 后执行
    -> e2;                         // 触发e2——上面那个块正好在@e2等着,被唤醒
    @e1;                           // 但e1早在上一个块里就触发过了,这里错过,永远等不到
    \$display("2:after trigger");   // 这行永远不会执行——本线程卡死在@e1
end关键:谁先到达@、谁就能等到”还没发生”的那次触发;谁后到达,面对的就是已经”过去”的触发,永远等不到——不是双方互相卡死的”死锁”,是单向错过、其中一个线程永久卡住。
换成wait(e2.triggered)/wait(e1.triggered)两边都没事——.triggered是”这个时间片内是否已经触发过”的状态查询,不会因为”来晚了”而错过。结论:线程间靠event同步,等待端优先用wait(.triggered),别用@,除非确定触发一定发生在等待语句之后。
wait_order(a,b,c) 语句 else 语句:阻塞等待多个event按指定顺序触发,顺序对执行前面语句,不对执行else。
特征:event变量能互相赋值(e2 = e1;),两个handle会指向同一个底层事件对象,触发任意一个都算触发;也能当参数传给task/function/queue。
3. semaphore(旗语)——控制”同时几个能用”
解决同一资源被多方请求、但物理上只能单一驱动的问题(比如一条总线只能有一个driver在驱动,测试平台却有多个请求方)。
本质是一个装着N把”钥匙”的桶:new(N)创建时发N把钥匙;get()拿钥匙(拿不到就阻塞排队,FIFO顺序);put()还钥匙;try_get()非阻塞尝试拿。
class bridge;
    semaphore key;
    function new();
        key = new(1);              // 只发1把钥匙 = 互斥锁(mutex)
    endfunction
    task go_on(string name);
        key.get();                 // 拿不到钥匙就一直等
        $display("%s go through the bridge", name);
    endtask
    task go_off(string name);
        key.put();                 // 用完还钥匙,给下一个排队的人
    endtask
endclass4个人(Alex/Bob/Calvin/Denise)fork出去同时抢着”过桥”,桥上只有1把钥匙,永远只有1人在桥上,其他人排队——semaphore(1)当互斥锁用。
new(1)的semaphore = 互斥锁(mutex);new(N)(N>1) = 资源池,控制”同时最多N个线程能占用某资源”——比如限制验证环境里同时in-flight的outstanding transaction数量。
4. mailbox(信箱)——传”数据”,不只是通知
event只能说”发生了”,不带数据;mailbox负责在线程间传递真正的消息,什么SV类型都能装,包括class对象。
常用方法:new()创建;put()放消息(阻塞)/try_put()(非阻塞);get()取消息(阻塞,取走)/peek()(只读不取走)——两者也都有try_get()/try_peek()非阻塞版本;num()查看邮箱里有几条消息。mailbox #(transaction)——参数化类型,限定这个邮箱只能装transaction。
class transaction;
    rand bit       valid;
    rand bit [7:0] data;
endclass

class generator;
    mailbox #(transaction) gen2drv;
    function new(mailbox #(transaction) gen2drv);
        this.gen2drv = gen2drv;
    endfunction
    task gen(int num);
        transaction tr;
        repeat (num) begin
            tr = new(); assert(tr.randomize());
            gen2drv.put(tr);           // 生产:塞进邮箱
        end
    endtask
endclass

class driver;
    mailbox #(transaction) gen2drv;
    function new(mailbox #(transaction) gen2drv);
        this.gen2drv = gen2drv;
    endfunction
    task run();
        transaction tr;
        forever gen2drv.get(tr);       // 消费:从邮箱取
    endtask
endclass

program test;
    mailbox #(transaction) gen2drv;
    generator gen; driver drv;
    initial begin
        gen2drv = new();
        gen = new(gen2drv); drv = new(gen2drv);   // 同一个邮箱给两边
        fork
            gen.gen(5);
            drv.run;
        join_any               // drv.run里是forever,永远不会自己结束——用join_any,gen.gen(5)一跑完就往下走,不等drv
    end
endprogramgenerator线程put()产生transaction、driver线程get()消费——这个”生产者/消费者”模式就是UVM里sequencer把sequence_item喂给driver的原型,UVM的TLM FIFO本质是mailbox的封装升级版。吃透这个例子,UVM驱动机制会好懂很多。
5. 三者怎么选(总结表)
| 解决什么问题 | 核心方法 | 典型场景 | |
|---|---|---|---|
| event | 通知”某个时间点发生了”,不带数据 | ->触发 / @或wait(.triggered)等待 | 两个线程互相通知”这一步做完了” |
| semaphore | 控制”同一资源同时能被几个线程占用” | get() / put() | 互斥锁(N=1)、资源池(N>1)、限制outstanding数 |
| mailbox | 线程间传递真实数据/消息 | put() / get() | generator→driver传transaction,UVM sequencer/driver前身 |
第六章 随机化
6.1 SV随机化基础
1. 为什么需要随机化
芯片规模变大、场景组合爆炸,定向测试(把每个场景一条条写死)写不过来,而且只能覆盖”你想到”的场景。随机测试能测到你根本没想到的边界组合,实际工作中常搭配功能覆盖率收敛”测没测全”(DV通用做法,非这份PPT内容)。随机测试代码量比定向测试少得多,产生的激励也更多样。
代价:环境要配套激励生成器、参考模型、自动比对(scoreboard)——不再靠人盯着看结果,让仿真自动跑上百次去收敛。
状态空间太大穷举不完,而且定向测试的盲区恰恰是”你没想到的场景”——这正是bug最容易藏的地方。随机+覆盖率驱动,比人工穷举效率高、覆盖面广。
2. 随机化的对象
随机化不是只随机数据,常见5类:
- 器件配置:寄存器、系统信号
- 环境配置:时钟、外部反馈信号
- 原始输入数据:数据包长度、带宽、顺序
- 延时:握手信号的时序关系,比如
valid/ready、req/ack之间隔几拍 - 协议异常:故意给出异常反馈,看设计后续处理是否还稳定
3. rand / randc / randomize()
class成员变量声明成rand,才能被randomize()随机赋值:
class Packet;
    rand  bit [31:0] src, dst, data[8];
    randc bit [7:0]  kind;              // 见下方randc说明
    constraint c { src > 10; src < 15; }
endclass

program testgen;
    Packet p;
    initial begin
        p = new();
        assert(p.randomize())    //随机pakcet里的四个变量
        else $fatal(0, "Packet::randomize failed");
        $display("data = %p",p.data);  //这里使用%p可以打印数组,当然也可以使用foreach遍历,%p更加简洁
    end
endprogram
rand vs randc:
rand每次独立随机,可能连续抽到重复值;randc(random-cyclic周期性随机)不重复——取值域内所有值打乱抽一轮,一轮抽完才重新洗牌重抽,轮内绝不重复。
rand只能修饰class成员变量不能修饰task/function里的局部变量——局部变量要随机化得用下面的std::randomize()。
两种调用方式:
object.randomize() | std::randomize() | |
|---|---|---|
| 位置 | 类内方法 | 全局函数(std命名空间) |
| 作用对象 | 类里声明的rand/randc成员 | 任意普通局部变量 |
| 依赖constraint | 可用类内constraint块 | 只能现场with {}内联写 |
| 典型场景 | 面向对象的transaction随机化 | task/function里零散变量随机化 |
int delay;
std::randomize(delay) with { delay inside {[0:3]}; }; // delay = 0~3,不依赖任何classrand和randc区别?rand允许连续重复;randc保证一轮(取值域大小那么多次)内不重复,抽完一轮才重新洗牌。
4. constraint基础写法
constraint语法固定:关键字后必须紧跟一个约束名,再用{}包裹表达式——名字和花括号都不能省,不能把位选/类型直接塞在constraint后面当参数:
// ❌ 错语法
rand bit [15:0] a;
constraint [15:8] a inside {0:64};

// ✅ 对:具名block,位选写在block内部
class C;
    rand bit [15:0] a;
    constraint high_bits { a[15:8] inside {[0:64]}; }
    constraint low_bits  { a[7:0]  inside {[128:255]}; }
endclass一个类可以有多个constraint块,randomize()时全部同时生效(后面”双向约束”细讲)。
5. 六类约束表达式
SV约束表达式常见6类:布尔表达式、权重分配、范围表达式、条件表达式、外部约束、双向约束。
1. 布尔表达式
最基础的比较表达式,但SV不支持链式比较:
constraint bad   { lo < med < hi; }    // ❌ 错:lo<med先算出0/1,再拿这个0/1去跟hi比,不是想要的传递比较
constraint right { lo < med; med < hi; } // ✅ 对:拆成两条独立表达式a < b < c在SV里从左到右求值:先算a<b得到1-bit的0/1结果,再拿这个结果去跟c比较——完全不是数学课那种”传递性”比较。多条件比较必须拆成多条语句。
2. 权重分配(dist)
dist给随机值指定非均匀概率,两种权重语法:
constraint c_dist {
    src dist {0 := 40, [1:3] := 60};
    // src=0 权重40;src=1/2/3 各权重60(:=是每个值单独给权重)——共220,src=0概率40/220

    dst dist {0 :/ 40, [1:3] :/ 60};
    // dst=0 权重40;[1:3]区间总权重60,均分给3个值各20(:/是区间整体权重再平均)——共100,dst=0概率40/100
}权重还能用变量代替常数(read_cmd dist {READ8 := read8_wt, ...}),运行时改变量就能动态调概率分布。
权重分配满不一定是100%
dist和inside区别?inside只划定取值范围,范围内每个值等概率;dist能指定每个值/每个区间的相对权重,做非均匀随机。
3. 范围表达式(inside)
rand int c;
int lo, hi;                                        // 非random变量,先赋值当边界
constraint c_range1 { c inside {[lo:hi]}; }         // lo <= c <= hi
constraint c_range2 { !(c inside {[lo:hi]}); }      // 取反:c < lo 或 c > hi

rand bit [6:0] b;                                   // 声明宽度决定$的上下限:0~127
constraint c_dollar { b inside {[$:4], [20:$]}; }   // $ = b自身类型的上下限,不是真无穷——等价于 0<=b<=4 || 20<=b<=127

int fib[5] = '{1, 5, 3, 9, 2};
constraint c_arr { b inside fib; } // fib是数组,b等于数组里任意一个元素constraint c_dollar { b inside {[$:4], [20:$]}; } 这一条的逗号 ,(逻辑或 / OR) —— 0<=b<=4 || 20<=b<=127
同时要求”c在[lo:hi]内”又”c不在[lo:hi]内”,自相矛盾、无解,randomize()会直接失败。这是两种独立写法,二选一用。
4. 条件表达式
两种写法等价,SV里更常用->(蕴含/implication),风格上更贴近约束块”声明式”的味道:
// 写法一:if-else
constraint c_stim {
    if (flag) { dst inside {[40:80]}; }
    else        dst inside {[2:10], [50:67]};
}

// 写法二:-> 蕴含(等价,更常用) //条件触发。箭头左侧是“前提条件”,右侧是“结果约束”
constraint c_stim {
    flag  -> dst inside {[40:80]};
    !flag -> dst inside {[2:10], [50:67]};
}
5. 外部约束
类内只声明空的constraint(占位,没内容),具体内容留到类外补:
class Packet;
    rand bit [7:0] length;
    rand bit [7:0] payload[];
    constraint c_valid { length > 0; payload.size() == length; }
    constraint c_external;                            // 只声明,不给内容(不一定非要实现,想实现的时候去实现或修改即可)
endclass

constraint Packet::c_external { length == 1; } // 类外补内容constraint c_valid { length > 0; payload.size() == length; } 这一条的分号 ,(逻辑与 / &) —— 两个条件需同时满足
同一个transaction类,不同测试场景要不同约束(比如error-injection测试想强行让某字段非法),不用改类定义本身,类外单独override这个占位约束即可,方便分层复用。
6. 双向约束
constraint块不是从上到下顺序执行的过程式代码,是声明式、并行生效的——SV求解器同时满足块里所有表达式,取它们的交集,有多组解时随机选一组:
rand logic [15:0] r, s, t;
constraint c_bitir {
    r < t;
    s == r;
    t < 30;
    s > 25;
}
数学表达式:25<r(s)<t<30
| 解 | r | s | t |
|---|---|---|---|
| A | 26 | 26 | 27 |
| B | 26 | 26 | 28 |
| C | 26 | 26 | 29 |
| D | 27 | 27 | 28 |
| E | 27 | 27 | 29 |
| F | 28 | 28 | 29 |
“双向”体现在:s依赖r(s==r),t的范围又同时受r<t和t<30两头夹逼——各表达式互相牵制,不是谁先算谁后算的固定顺序,SV求解器在满足全部约束的多组解里随机选一组。
因为它描述”最终要满足什么关系”,不描述”怎么一步步算出来”——跟procedural代码(always/function里从上到下按顺序执行)是两种完全不同的编程范式。
6.3 SV的随机约束控制
1. constraint_mode()
对象.约束名.constraint_mode(0/1)单独开关一个约束块;对象.constraint_mode(0/1)(不带约束名)一次性开关该对象所有约束块。0=禁用,1=启用(默认启用)。
class Packet;
    rand int length;
    constraint c_short { length inside {[1:32]}; }
    constraint c_long  { length inside {[1000:1023]}; }
endclass

Packet p;
initial begin
    p = new();
    p.c_short.constraint_mode(0);       // 只关c_short
    assert(p.randomize());              // 此时只剩c_long生效,length落在[1000:1023]

    p.constraint_mode(0);               // 关掉p身上全部约束块
    p.c_short.constraint_mode(1);       // 单独重新打开c_short
    assert(p.randomize());              // 此时只有c_short生效,length落在[1:32]
end若把c_short和c_long同时打开,[1:32]和[1000:1023]两个区间没有交集——randomize()会直接失败(无解)。多个约束块默认同时生效取交集,开关前先想清楚交不交集得上。
2. rand_mode()
变量.rand_mode(0/1)控制这个rand变量本身要不要参与随机化——关掉后可以手动赋固定值当常量用。开关的是变量,不是约束块,跟constraint_mode()是两个独立正交的开关。
class Packet;
    rand bit [7:0] length, payload[];
    constraint c_valid { length > 0; payload.size() == length; }
endclass

Packet p;
initial begin
    p = new();
    p.length.rand_mode(0);    // length不再参与随机化
    p.length = 42;             // 手动定值
    assert(p.randomize());     // payload仍会被随机化——但constraint读到的length是42,payload.size()被强制等于42
    p.length.rand_mode(1);     // 恢复length参与随机化
    assert(p.randomize());     // 这次length和payload都重新随机
endrand_mode(0)只是让这个变量自己不再被随机赋值,但它当前的值(这里是42)照样会被其它约束块当常量读取参与求解——不是把这个变量从约束系统里挖走。这条原理第4点还会再用到。
3. randomize() with {}
obj.randomize() with { 额外约束 }——这次随机化临时加约束,和类内原有constraint一起生效、取交集,不是替换关系。
class Transaction;
    rand bit [31:0] addr, data;
    constraint c1 { addr inside {[0:100], [1000:2000]}; }
endclass

Transaction t;
initial begin
    t = new();
    assert(t.randomize() with { addr >= 50; addr <= 1500; data < 10; });
    // c1的[0:100]∪[1000:2000],交上with的[50:1500],结果addr落在[50:100]或[1000:1500],data<10

    assert(t.randomize() with { addr == 2000; data > 10; });
    // addr==2000本身也满足c1(2000在[1000:2000]区间内),没冲突,能成功
endwith{}里的约束和类内约束什么关系?叠加取交集,不是覆盖。
with{}加的条件必须能和类内原有constraint必须同时满足,否则randomize()失败(不可和原有约束冲突)——比如第二次调用改成addr==500就会失败,因为500不在c1允许的范围内。
4. randomize(变量名)
obj.randomize(变量名)只随机化括号里指定的这个变量,其它变量(哪怕是rand的)保持原值不变;甚至能对着非rand变量用,临时越权随机化它一次。
class Rising;
    byte low;                  // 非random
    rand byte med, hi;
    constraint c_up { low < med; med < hi; }
endclass

Rising r;
initial begin
    r = new();
    r.randomize();           // med、hi都随机;low不变
    r.randomize(med);        // 只随机med;hi保持上次的值不变
    r.randomize(low);        // 只随机low(尽管它不是rand变量)
endhi都一样?没被指定的rand变量不参与这次随机化,直接保留原值——这就是hi一直不变的原因。(顺带一提:med被单独随机化时,c_up约束依然会读hi当前的值当上界夹逼,跟第2点”关掉的变量依然活在约束里”是同一条原理)
5. pre_randomize() / post_randomize()
两个都是function,不消耗仿真时间,SV自动在randomize()前后调用(类里定义了就会被自动触发,不用手动调):
pre_randomize():randomize()之前调用,常用来动态设定/开关跟这次随机化相关的变量或约束post_randomize():randomize()成功后调用,常用来做后续处理(根据随机出来的值算别的字段、校验合法性)
randomize()失败时,post_randomize()不会执行;但pre_randomize()不管成功失败都会执行——它俩不是对称的”前后钩子”。
class wr_tran;
    int constraint_en;
    int broadcast;
    rand int wr_addr, wr_data;
    rand bit valid;
    constraint generic_c { valid == 1; wr_addr < 100; }

    function void pre_randomize();
        if (!constraint_en) generic_c.constraint_mode(0);   // 旗标决定要不要保留默认约束
    endfunction

    function void post_randomize();
        if (wr_addr == 1) broadcast = 1;
        else broadcast = 0;
    endfunction
endclass

wr_tran m_tr;
initial begin
    m_tr = new();
    m_tr.constraint_en = 0;                                   // 关掉默认约束
    m_tr.randomize() with { wr_addr == 200; wr_data == 3; valid == 0; };
    // valid==0、wr_addr==200都跟generic_c矛盾(generic_c要求valid==1、wr_addr<100)——但pre_randomize已经把generic_c关了,两条都不冲突,能成功
    // 跑完:wr_addr=200, wr_data=3, valid=0, broadcast=0(因为wr_addr!=1)
endconstraint_en是个普通旗标变量,pre_randomize()借它决定”这次要不要用默认约束”——UVM里常见模式:base class给一份默认约束,具体测试想覆盖默认值时用旗标临时关掉它,再配合with{}塞自己要的值。
- 正因为有pre_randomize存在,所以以上例子不会报错。
6. 约束的重载
两种”重载”约束的路子,效果完全不同,值得对比着看:
方式一:constraint_mode(0)关掉 + randomize() with{}补
class constrainend;
    rand bit x;
    rand bit [1:0] y;
    constraint c_xy { (x==0) -> y==0; }  //条件触发。箭头左侧是“前提条件”,右侧是“结果约束”
endclass

constrainend p;
initial begin
    p = new();
    p.c_xy.constraint_mode(0);                    // 先关掉c_xy——不关的话x==0;y==1;会跟c_xy的(x==0)->y==0直接矛盾
    assert(p.randomize() with { x==0; y==1; });   // 故意选一组违反原c_xy的值,证明disable确实起了作用(不disable这行会randomize失败)
end方式二:子类extends父类,定义同名约束
class overwrite extends constrainend;
    constraint c_xy { x==0; y==0; }    // 同名c_xy,完全替换父类的定义
endclass

overwrite p;
initial begin
    p = new();
    assert(p.randomize());   // 生效的是子类这份c_xy,父类原来的(x==0)->y==0已经不存在了
end覆盖(override),跟第3点randomize() with{}的”叠加取交集”正相反——子类重新声明同名constraint,父类那份直接被替换掉,不会两份一起生效。同名约束在继承语境下是覆盖,在with{}语境下是叠加,两个场景别搞混。
| 手段 | 和原约束的关系 |
|---|---|
| 外部约束(6.1第5点,占位+类外补内容) | 补内容,本身不是开关 |
randomize() with{}(本节第3点) | 临时叠加,取交集 |
子类同名constraint(本节第6点) | 覆盖,替换父类那份 |
6.5 SV随机化约束的概率
1. 约束怎么分配概率
没有约束时,rand变量互相独立、每个取值等概率——rand bit x(0或1)配rand bit[1:0] y(0~3),2×4=8种组合,每种1/8。
一旦引入约束,求解器的默认规则是:在所有满足约束的组合里均匀分配概率,不是对每个变量分别做均匀随机再挑合法的。
class impact1;
    rand bit x;
    rand bit [1:0] y;
    constraint c_xy { (x==0) -> y==0; }
endclassx==0时y被逼成0(1种组合);x==1时y自由取0~3(4种组合)。总共5种合法组合,每种1/5:
| x | y | 概率 |
|---|---|---|
| 0 | 0 | 1/5 |
| 1 | 0 | 1/5 |
| 1 | 1 | 1/5 |
| 1 | 2 | 1/5 |
| 1 | 3 | 1/5 |
求解器按”组合数”均匀分配,不是按变量本身均匀分配。x==1这条分支底下有4种y的选择,比x==0分支(只有1种)多,就把x=1的概率”拉”高了——x=0概率1/5,x=1概率4/5(=1/5×4)。约束的结构本身,悄悄改变了一个”没有单独取值范围限制”的变量的分布。
2. randc如何重塑分布
把上面例子里x或y其中一个换成randc,边缘分布会被强制拉回均匀——randc保证自己声明范围内所有值轮询到、必然各占一份,不受约束结构里”谁的分支组合多”影响。
x换成randc(y仍是rand):X变量会先于Y变量进行解析
randc bit x;
rand  bit [1:0] y;
constraint c_xy { (x==0) -> y==0; }| x | y | 概率 |
|---|---|---|
| 0 | 0 | 1/2 |
| 1 | 0(此时Y可取0123) | 1/8 |
| 1 | 1 | 1/8 |
| 1 | 2 | 1/8 |
| 1 | 3 | 1/8 |
(其余3种x=0,y≠0的组合概率为0)x被randc强制成50/50;x=0这条分支从1/5暴涨到1/2,x=1分支下的4个y值则从各1/5被压缩成各1/8。
y换成randc(x仍是rand):Y变量会先于X变量进行解析
rand  bit x;
randc bit [1:0] y;
constraint c_xy { (x==0) -> y==0; }| Y | X | 概率 |
|---|---|---|
| 0 | 0 | 1 | 1/8 (1/4 * 1/2) |
| 1 | 0 (不存在)| 1 | 1/4 (1/4 * 1) |
| 2 | 0 (不存在)| 1 | 1/4 (1/4 * 1) |
| 3 | 0 (不存在)| 1 | 1/4 (1/4 * 1) |
谁被声明成randc,谁的边缘分布就被强制拉成对自己声明范围完全均匀,代价是把”不均匀”转嫁给另一个变量的条件分布。这是randc除了”轮询不重复”之外另一个常被忽略的效果——会实打实改变整条约束的联合概率分布,不只是”减少重复”这么简单。
- 其实就是先解析randc,会改变变量概率分布结果。一般不建议这样使用
3. 约束耦合消分支
多条约束取交集时,一条约束可能让另一个变量的某个取值彻底没有出路,即使那个变量本身看起来毫无约束:
class impact2;
    rand bit x;
    rand bit [1:0] y;
    constraint c_xy {
        y > 0;
        (x==0) -> y==0;
    }
endclassy>0和(x==0)->y==0两条一起看:x0要求y0,但y>0又不许y0——x0这个分支无解,被两条约束联立间接判了死刑。合法组合只剩x==1那一支的y∈{1,2,3},各1/3:
| x | y | 概率 |
|---|---|---|
| 1 | 1 | 1/3 |
| 1 | 2 | 1/3 |
| 1 | 3 | 1/3 |
(其余5种组合——x=0的全部4种、以及x=1,y=0——概率都是0)
x没有任何一条约束直接限定它的取值,但两条约束耦合的结果是x永远只能是1——查bug时如果只看”哪条约束直接提到了x”,会漏掉这种间接消支的情况,得看全部约束联立求解后的结果。解决这样问题的方法就是加入solve before语句
4. solve…before
显式告诉求解器”先满足谁的取值范围,再算别的”,概率分布效果跟第2点把某个变量声明成randc完全等价——都是把被指定变量的边缘分布拉成对自己声明范围均匀。但两者不是同一回事:solve...before不改变变量本身”是否轮询不重复”这个属性(变量仍是rand,允许重复取值),纯粹只管求解顺序/分布优先级。
constraint c_xy {
    (x==0) -> y==0;
    solve x before y;   // x的边缘分布被拉平——概率表跟"x是randc"那版完全一样(1/2、1/8×4)
}
constraint c_xy {
(x==0) -> y==0;
solve y before x; // y的边缘分布被拉平——概率表跟"y是randc"那版完全一样(1/8×2、1/4×3)
}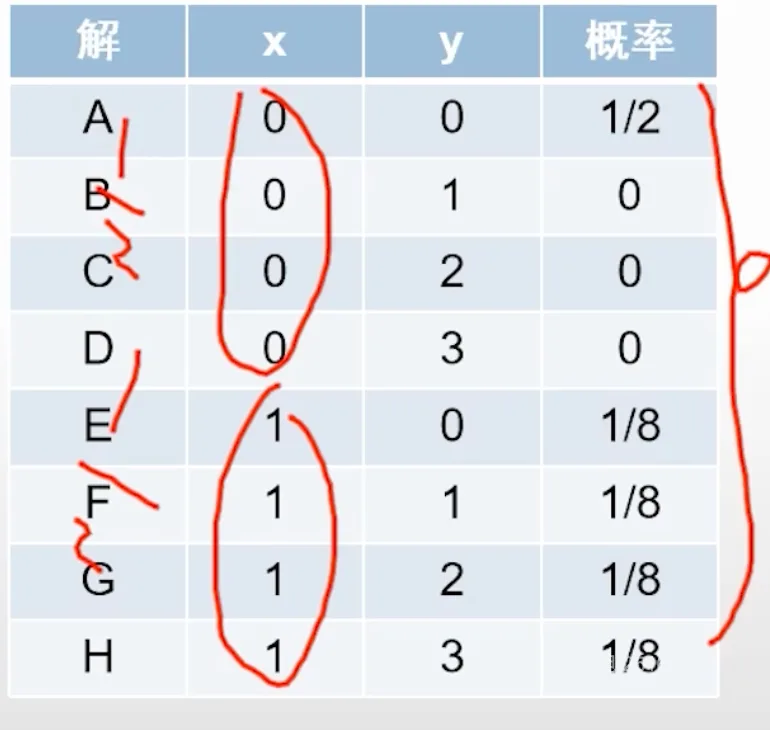
solve...before和randc是什么关系?两者都能把”谁的边缘分布均匀”这件事显式钉死,效果殊途同归——但randc是变量自身的属性(附带”轮询不重复”),solve...before是约束块里的求解顺序声明(不影响变量是否重复)。两条不同的路,能走到同一个概率分布。
- 但是注意不要过度使用
solve...before,会降低计算速度,也会让约束变得难以理解。 - solve before和randc不可以混用,声明solve before的变量必须为rand
5. 多个randc耦合
如果参与同一条约束的多个变量都声明成randc,联合概率分布会比第2点更复杂:
randc bit x;
randc bit [1:0] y;
constraint c_xy { (x==0) -> y==0; }多个randc耦合的精确分布,基本用不着手推——真正要会的是”能不能凭直觉预判结果”(答案:不好预判,多个randc互相约束时行为会变复杂),不是背概率表。记住”多个randc叠一起容易出反直觉结果,实际项目里尽量避免让它们强耦合”就够。
6.6 SV的数组约束
1. size()
.size()统计动态数组/队列的元素个数,能直接放进约束里限定数组长度:
class dyn_size;
    rand logic [31:0] d[];
    constraint d_size { d.size() inside {[1:10]}; }
endclass
2. sum()
.sum()计算动态数组/队列所有元素的和:
class dyn_sum;
    rand logic [7:0] d[];
    constraint d_sum { d.sum() == 9'd100; }
endclass9'd100不是普通的100- 因为加法操作存在进位的可能性
3. sum()的坑
三个bad example,需求都一样:1~8个无符号元素,每个元素落在[0:255],元素之和小于1024。
bad_sum1——元素类型选错(有符号):
class bad_sum1;
    rand byte len[];                    // byte是有符号8位(-128~127),不是无符号!
    constraint c_len {
        len.sum() < 1024;
        len.size() inside {[1:8]};
    }
endclass没有任何一条约束限定每个元素自己的范围,byte又是有符号类型——随机出来的元素可以是负数,比如-58 -85 -115 112 -101 -62,真实和是-309。.sum()的结果位宽跟着byte(8位有符号)走,-309按8位有符号截断(-309+256=-53)后会显示成sum=-53——完全不满足”元素非负、和小于1024”这条需求,只是数字上凑巧”小于1024”这一半条件蒙对了。
bad_sum2——类型改成无符号,但还是没治根:
class bad_sum2;
    rand bit [7:0] len[];               // 改成无符号了
    constraint c_len {
        len.sum() < 1024;   //结果会被截断,相当于无效约束
        len.size() inside {[1:8]};
    }
endclass- 核心原因:.sum的位宽和数组中的元素位宽一致,在以上例子中也就是定义的 “[7:0] ” 为8位,若数组里都取最大值255相加,则会超过8位位宽出现截断
- .sum()是把数组里所有元素加成一个总数,只有这一个总数拿去跟1024比。
.sum()不会因为你拿它去跟一个大数(1024)比较,就自动把自己的结果位宽跟着变宽——它的位宽由数组元素的类型决定,跟比较对象无关。元素类型选窄了,sum()可能在约束求解阶段就已经被截断,比较关系被悄悄破坏,不是等到仿真跑起来才溢出。
4. 宽类型也会溢出
class bad_sum3;
    rand int len[];                     // int默认32位,位宽足够大了……,且int是有符号数
    constraint c_len {
        len.sum() < 1024;
        len.size() inside {[1:8]};
    }
endclass高位进位截断之后会出现看起来较小的数,看起来满足要求了,实际是因为截断
5. 正确写法
class good_sum;
    rand int len[];
    constraint c_len {
        foreach (len[i]) len[i] inside {[1:255]};   // 补上:每个元素自己的范围(干掉了负数)
        len.sum() < 1024;
        len.size() inside {[1:8]};
    }
endclass跑出来的一组合法解:sum=976, val=233 187 44 157 201 81 73(7个元素,加起来正好976,<1024)。
三条约束都要有,缺哪条都可能翻车:
foreach约束每个元素范围——这是前面3个bad example唯一都漏掉的一条,也是根本原因len.sum() < 1024——限定和len.size() inside {[1:8]}——限定长度
元素范围定死在[1:255]后,最多8个元素、每个最多255,真实和最大也就8×255=2040,int(32位)装这个上限绰绰有余,不会像bad_sum1/2那样发生截断/溢出——len.sum() < 1024这条约束才真正管用。
三个bad example表面上”类型不一样”(有符号byte / 无符号8位 / 32位int),但根子是同一个:都没有约束数组里每个元素自己的取值范围,只约束了整体的sum()和size()。sum()的结果位宽跟着元素类型走,元素本身不设界,位宽选得再宽也挡不住溢出/截断——先把每个元素的范围钉死,sum()和size()才有意义。
第七章 断言
7.1 断言基础语法
1. Assertion是什么
嵌在代码里的实时检查器:条件/事件序列不符合预期就报警。数字电路设计里断言代码量一般要求不少于整体设计的30%。两种:Immediate Assertions、Concurrent Assertions。
两种放置方式:
- 写进RTL模块里:直接跟设计代码混在一起。经典例子——互斥检查(两个信号不能同时为1):
property p_mutex;
    @(posedge clk) not (a && b);
endproperty
a_mutex: assert property (p_mutex);- 放进单独的仿真环境:断言写在独立module里,通过端口接
clk/rst跟DUT解耦,外面套`ifdef SIM_ASSERTION_ON/`endif按需编译进去,不用就完全不占地方。
独立的module用bind挂进DUT。bind是SV关键字,把一个module例化进目标module里面,不用改RTL代码;目标module有几个instance,就各插一份。例如给同步FIFO挂一条cover property:
module fifo_cov (input logic clk, input logic rst_n, input logic full);
    c_fifo_full : cover property (@(posedge clk) disable iff (!rst_n) full);
endmodule

bind sync_fifo fifo_cov u_fifo_cov (.clk(clk), .rst_n(rst_n), .full(full));仿真报告里这条cover property的路径是…u_fifo.u_fifo_cov.c_fifo_full,u_fifo_cov出现在FIFO的instance u_fifo下面,说明fifo_cov确实被插进了FIFO里,端口连的是FIFO内部的clk、rst_n、full。
激活关键字不止assert:
assert property——失败会报错/挂仿真cover property——只统计”这个场景出现过几次”喂给功能覆盖率,不影响仿真跑assume property——主要用于formal验证,把这条当成对输入的既定约束,不是拿来检查的东西
assert property:不满足就报错上面的a_mutex在每个周期都检查一次a、b:
| 周期 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| a | 1 | 0 | 1 | 0 |
| b | 0 | 1 | 1 | 0 |
第1、2、4个周期通过;第3个周期a、b同时为1,仿真当场报错。
cover property:出现一次记一次统计FIFO有没有被写满过:
c_full: cover property (@(posedge clk) full);| 周期 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| full | 0 | 0 | 1 | 0 |
第3个周期full为1,c_full的命中次数加1,仿真照常往下跑。如果整个仿真full一直是0,也不报错,只是覆盖率报告里这一条命中0次,说明测试没把FIFO写满过。
2. Immediate Assertions
检查当下这一刻的条件,等价于if-else,必须写在过程块(initial/always/task/function)里,不能跨时钟周期。
语法:
label: assert(expression) action_block;- action_block在断言表达式求值后立即执行,分成功/失败两条分支各自指定要做的操作
- 写法:
pass_statement; else fail_statement;
- 写法:
- action_block可以整个省略——
check_a_and_b: assert(a && b);合法,失败时直接用默认严重度$error报错
always @(posedge clk) begin
    check_a_and_b: assert (a && b) $display("a&&b is true");
        else $error("a&&b is false");
end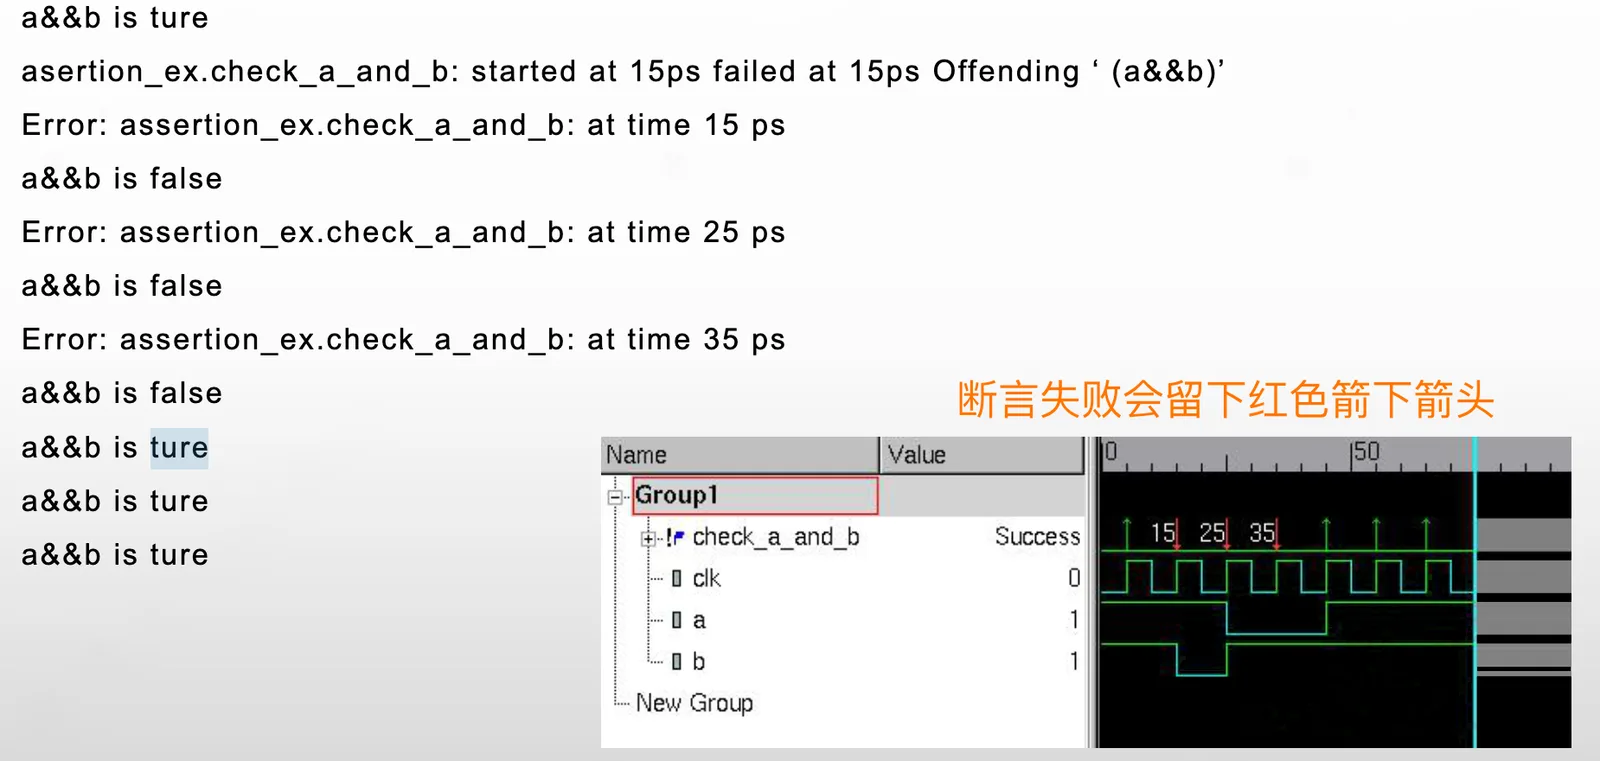
补充信息:失败时的严重程度(依次递减):$fatal(终止仿真)> $error(默认)> $warning > $info。
3. Concurrent Assertions
比Immediate Assertions多一个property关键字和一个采样时钟,能检查跨多个时钟周期的事件序列,不局限于当下这一拍。可以写在过程块/module/interface/program里,但不能写在class内部(class没有独立的时钟采样上下文)。UVM里Assertion常单独放进interface、再bind进DUT。
通用格式:断言名: assert property (判断条件);
Immediate写法(靠外层always提供时钟):
always @(posedge clk) begin
    if (enable) begin
        // 【立即断言】只有当 enable 为 1 时,代码才会走到这里进行检查
        check_imm: assert (a && b);
    end
endConcurrent写法(时钟采样焊死在assert property内部,不用套always):(相当于自身有电源驱动)
check_a_and_b: assert property (@(posedge clk) (a && b)) $display("a&&b is true");
    else $error("a&&b is false");
两段逻辑等价,但触发机制不同:
- Immediate版本的
assert本身不认时钟——能不能查全靠外层always @(posedge clk),改成always @*就变成信号一变就查;assert只是在过程流程走到这一行时看一眼当下的值。 - Concurrent版本的
@(posedge clk)焊死在assert property(...)内部,不需要外层过程块”喂”时钟——语句一旦elaborate,从仿真开始就自己每个posedge clk检查一次。
Immediate Assertions=瞬时检查(相当于if,只认当下这一拍);Concurrent Assertions=时序检查,靠property+时钟采样,能表达”a发生后N拍b必须发生”这种跨周期逻辑——SVA(SV Assertions)真正的威力都在Concurrent Assertions。
- 深层原因:Immediate assertion读的是执行流程走到那一行那一刻的值,跟别的always块的非阻塞赋值可能有竞争;
- Concurrent assertion的采样点在所有非阻塞赋值结算之后,结果始终确定,时序检查几乎只用Concurrent。
实际项目里Concurrent Assertions几乎都要配disable iff(条件)——条件为真时这条Assertion完全不检查。最常见的用法是盖住复位:复位期间信号不稳定,不加这条会在复位阶段疯狂误报:
assert property (@(posedge clk) disable iff(!rst_n) a |=> b);4. sequence
比布尔表达式高一层的单元,把”一串跨周期的事件”包装成可复用、可传参的名字。
- 使用sequence可以极大提升布尔表达式的复用。
sequence seq_ab;
    @(posedge clk) a ##2 b;   // a成立后,隔2拍b成立
endsequence
check_ab: assert property(seq_ab); //调用sequence##n=延时n拍;sequence可以带参数、可以嵌套调用其它sequence、可以声明局部变量,但不能嵌套property。
sequence seq2;
	@(posedge clk) a ##2 b;  //在a为高之后,两个采样周期延迟后 b为高
endsequence带参数写法:
sequence seq1(signal1, signal2);
    @(posedge clk) signal1 && signal2;
endsequence
check_ab: assert property(seq1(a, b));
sequence 序列
sequence seq2;
	@(posedge clk) a ##2 b;
endsequence
sequence seq3;
	seq2
endsequence
5. property
比sequence再高一层,能用蕴含操作符|->(同拍)/|=>(下一拍)表达”若前提成立,则后续必须怎样”(property独有,sequence没有)。
语法:
property name_of_property(参数列表);
    测试表达式或复杂的sequence;
endproperty
property p_ab;
@(posedge clk) a |=> b; // a成立,下一拍b必须成立
endproperty
check_ab: assert property(p_ab);sequence负责描述事件序列本身;property在sequence基础上加蕴含逻辑,是真正拿去assert的对象。区别:
- sequence能嵌套sequence,不能嵌套property;
- property可以调用sequence,也可以调用其它property;
- property要用
assert/cover/assume实例化才生效,sequence不需要,直接调用即可。
创建一个断言的完整步骤:Create Boolean Expressions → Create Sequence Expressions → Create Property → Assert Property。Boolean表达式不是只能写在第一步,后面三步任一步都能嵌,顺序灵活。
6. 常用内置函数/操作符速查
| 类别 | 写法 | 含义 |
|---|---|---|
| 边沿 | $rose(a) / $fell(a) / $stable(a) / $changed(a) | 上升 / 下降 / 连续两个采样周期不变 / 变化 |
| 延时 | a ##n b / a ##[m:n] b / a ##[+] b / a ##[*] b | n拍后成立 / m~n拍内成立 / 下一拍起早晚成立 / 当拍起早晚成立 |
| 重复 | a[*n] / a[->n] / a[=n] | 连续n拍都成立 / 非连续出现n次+紧接下一拍匹配后续 / 非连续出现n次+后续不必紧接着来 |
| 蕴含 | a |-> b / a |=> b | 同拍成立 / 下一拍成立 |
| 序列组合 | intersect(a,b) / a within b / c throughout(seq) | a、b同起同止 / b的时间段整个包住a / c在seq整个过程中”一直”成立 |
| 历史值 | $past(a, n) | n拍前a的值 |
| 总线 | $onehot(bus) / $onehot0(bus) / $isunknown(bus) / $countones(bus)==n | 仅1位为1 / 至多1位为1(含全0) / 含x或z / 恰好n位为1 |
a[*n]、a[->n]、a[=n]三个重复操作符的区别?a[*n]——a必须连续n拍都成立;a[->n]——a非连续累计出现n次即可,抓到第n次后紧接着下一拍就要匹配后面的事件;a[=n]——同样非连续累计n次,但抓到第n次后不要求后面事件紧跟,隔多久都行。三者常放一起考”到底哪个要求连续”。
$rose(a)和@(posedge a)是一回事吗?不是。
@(posedge a)是阻塞等待——真等到那个跳变事件发生才往下走;$rose(a)是采样比较函数,问”这次采样值和上次采样值相比,是不是从非1变成了1”,至少要有两次采样值才能给答案。常被当成同一个东西,是经典的坑。
第八章 覆盖率
8.1 SV覆盖率类型
1. 覆盖率是什么
衡量设计验证的完备性:测试逐步覆盖各种合理组合,覆盖率就衡量测试进行到什么程度了。流程:覆盖率工具在仿真中收集信息→处理生成覆盖率报告→对着报告找盲区(hole)→改现有test或建新test去补→反复迭代,直到覆盖率达到KPI要求。
- 随机测试(换seed多轮跑)+ 定向用例 → 一起喂出
- Functional Coverage 数据 → 从里面挑出
- Identify holes(没测到的盲区)→ 针对盲区做
- Minimal code modifications(最小化的代码/环境改动),常见做法是
- Add constraints(加约束收紧随机方向)→ 回到第1步,下一轮随机测试更精准地打盲区
不断迭代直到覆盖率达标。纯随机测试大概率打不到所有corner case,必须靠这个环路反过来指导”该往哪打”。
2. 代码覆盖率
工具自动统计,对象是RTL代码,目的是衡量设计意图,4种:
| 类型 | 检查什么 |
|---|---|
| line | 所有行是否都执行过 |
| path | 所有路径是否都覆盖到 |
| toggle | 所有变量是否都0→1、1→0翻转过 |
| FSM | 状态机所有状态是否都跑到过 |
PPT的”path coverage”是理论概念——覆盖控制流图里每一条可能路径,N个连续分支就有2^N条路径,组合爆炸,实际商业工具(VCS/Questa等)基本不会真的实现/报告这个指标。
真正落地、最常用的是branch coverage(分支覆盖):每个if/else、case分支,两个方向是不是都走到过——是path coverage的可行子集,工具真的会报这个数字。更细的还有condition coverage(条件覆盖):if(a && b)这种复合表达式里a、b各自单独取0/1是否都覆盖到,比branch更细粒度。
说到”代码覆盖率有哪几种”,常用的是 line / branch / toggle / FSM(可以加condition)——比PPT这页的”path”更对口。
关注点是设计代码本身(不是测试平台代码),衡量的是”实现”层面,不针对验证计划本身。代码覆盖率100%不等于验证完成,但是验证完备性的必要条件——代码没跑到的地方可能藏着硬件漏洞,也可能只是冗余代码。
3. 功能覆盖率
功能覆盖率证明“测试过哪些场景”,scoreboard/assertion证明“这些场景下 DUT 是否正确”。
在验证计划中,需要明确要覆盖哪些功能点、场景、边界条件和功能组合。因为功能覆盖率关注的不是信号本身,而是信号代表的功能场景。
例如,不建议只写:
收集 data0、data1 和 data_out 的功能覆盖率。
更建议写:
覆盖输入的零值、普通值、最高位为1、最大值,以及两个输入类型的交叉组合; 覆盖输出的零值、有进位、无进位和最大结果。
验证的目的是确保设计在实际环境中的行为正确。功能描述文档写清楚设计该怎么运行,验证计划则列出这些功能该怎么激励、验证、测量——功能覆盖率跟功能设计绑定,需要验证工程师手动定义要测什么场景。
- 代码覆盖率只看RTL代码本身跑没跑到,自动统计、跟着”实现”走;
- 功能覆盖率看的是验证计划里该测的场景是否都测过,得手动定义。若某个功能在设计里被完全遗漏(RTL根本没写这段逻辑),代码覆盖率无从发现——压根没代码可统计;但功能覆盖率能发现,因为它测的是”该发生的场景发生了没有”,跟RTL怎么写无关。
4. 断言覆盖率
断言(assert语法见7.1第1点)本身是声明性代码,一次性或持续核对两个设计信号之间的关系,最常用于查错——比如两信号该不该互斥、请求与许可信号之间的时序,一旦检测到问题仿真可以立即停止。断言可以跟设计和测试平台一起仿真,也可以被形式验证工具证实;用SV的程序性代码也能写等效检查,但SVA表达起来容易得多,尤其是时序关系。
反过来,断言也能当覆盖率用——用cover property(不是assert property)测量统计某一段时序有没有发生过,可以跨好多拍,不会让仿真挂。仿真结束后工具自动生成断言覆盖率数据,跟代码覆盖率、功能覆盖率一起汇入同一个覆盖率数据库统一分析。
covergroup和cover property怎么选,常见的分法是看这个场景从哪里看得到:
- 能从接口事务算出来的,用
covergroup:比如outstanding数,等于地址握手的累计次数减去响应握手的累计次数。covergroup放在coverage组件里,从monitor拿事务采样(见8.2第6点) - 只在RTL内部才看得到的,用
cover property:比如某张表有没有被写满。用bind把断言模块挂上去(见7.1第1点),直接看内部的满信号
5. 漏洞率
不是严格意义的”覆盖率”,是项目周期内每周新发现漏洞数这个趋势指标,跟覆盖率一起看项目健康度:
- 项目早期写测试程序时,靠观察就能发现很多漏洞
- 设计逐渐稳定后,得靠自动化检查方式协助发现
- 临近流片时漏洞率该下降甚至趋近于0
典型曲线:设计review阶段爬升→集成/新代码合入/新验证工程加入各造成一次小反弹→后仿阶段开始收敛→流片前趋近于0。
每次漏洞率下降,都该主动找新的corner case去测,而不是停手;漏洞率如果出现意外波动(跟项目阶段对不上),往往预示有潜在问题,要留意。
8.2 覆盖策略及覆盖组
1. 覆盖策略
不是穷举所有可能组合,而是找有代表性的状态转换。经典例子:1K深度FIFO,穷举读写index组合有几百万种,但让FIFO从空到满、再从满到空跑一遍,就已经覆盖了几乎所有情形。收集的是信息,不是具体数据。
2. 只测量需要的内容
功能覆盖率收集开销很大,会拖慢仿真性能——只测你真的会拿去分析、改进测试的那部分数据;采样事件也要设合理,提升采样效率、降低开销。
3. 验证完备性
完备的覆盖率测量结果和漏洞增长曲线一起帮助确认设计是否被完整验证过。单看一个覆盖率会误判——
- 功能覆盖率高、代码覆盖率低,说明验证计划不完整(测试没跑到所有代码);
- 代码覆盖率高、功能覆盖率低,说明代码都跑到了,但没有把设计逼到所有感兴趣的状态上。目标是同时驱动两者都高。
| Code Coverage 低 | Code Coverage 高 | |
|---|---|---|
| Functional Coverage 高 | 需要补更多FC点(含corner case) | 覆盖率良好,接着看漏洞率(8.1第5点) |
| Functional Coverage 低 | 项目刚起步 | 代码都跑到但没测到该测的场景,考虑上formal |
4. covergroup是什么
跟class类似,定义一次可多次实例化。核心事实:
- 内部含一个或多个
coverpoint,全部同一时刻采集 - 可以定义在class、interface、module里
- 能采任何可见变量——程序变量、接口信号、设计端口都行
- 一个class里可以包含多个covergroup,各自独立使能/禁止,各自定义单独的触发采样事件,允许从多个源头收集数据
- 必须先
new()例化才能采数据
5. 类外定义covergroup
必须有标志符(比如以下ck)
class Transaction;
    rand bit [31:0] data;
    rand bit [2:0]  port;
endclass

program automatic test(busifc.TB ifc);
    covergroup CovPort;
        coverpoint ifc.port;   // Measure coverage
    endgroup

    initial begin
        Transaction tr;
        CovPort ck;
        ck = new();    // Instantiate group——不例化不会采集
        tr = new();
        repeat (32) begin
            assert(tr.randomize);
            ifc.port <= tr.port;
            ifc.data <= tr.data;
            ck.sample();   // Gather coverage
            @ifc.clk;
        end
    end
endprogram
6. 在类里定义covergroup
真实项目里更常见的写法是封装进一个类里(UVM里常做成独立的coverage collector/subscriber类),在function new()里例化、在业务逻辑跑到的地方调sample():
class Transactor;
    Transaction tr;
    mailbox mbx_in;
    virtual busifc ifc;

    covergroup CovPort;
        coverpoint tr.port;
    endgroup

    function new(mailbox mbx_in, virtual busifc ifc);
        CovPort = new();   //这里直接使用cvg的名字new了,而不是使用对象new
        this.mbx_in = mbx_in;
        this.ifc = ifc;
    endfunction

    task main;
        mbx_in.get(tr);
        ifc.port <= tr.port;
        ifc.data <= tr.data;
        CovPort.sample();  //同理,直接使用cvg的名字.sample
    endtask
endclass调用方(testbench顶层)只需要new()这个类,每次循环调一次它的main():
program automatic test(busifc ifc);
    initial begin
        Transaction tr;
        mailbox mbx_in;
        Transactor tr_c;

        tr = new();
        mbx_in = new();
        tr_c = new(mbx_in, ifc);

        repeat (32) begin
            assert(tr.randomize);
            mbx_in.put(tr);
            tr_c.main();   // send driver and gather coverage
            @ifc.clk;
        end
    end
endprogram
7. 采样触发的两种方式
covergroup由采样的数据和数据被采样的事件两部分构成,两个条件都准备好后测试平台才会触发采样:
sample():手动显式调用,适合没有天然采样时刻信号、或者一个covergroup被实例化了多份需要单独触发的场景。- 事件/信号触发:在covergroup声明处直接跟一个
@(event),不用每次手动调sample():
event trans_ready; covergroup CovPort @(trans_ready); coverpoint ifc.cb.port; endgroup
8.3 覆盖率数据采样
1. bin是数据采样的基本单位
coverpoint采样一个变量/表达式时,SV会创建若干个”bin”,每个bin记录某个数值(或某类数值)被采样命中的次数。bin是功能覆盖率的最小计量单位。
覆盖率算法:coverpoint的覆盖率 = 被命中过的bin数 / 总bin数。例如一个3-bit变量域是0~7,默认分成8个bin,仿真中若有7个值被采样到,这个coverpoint的覆盖率就是7/8。
层级:所有coverpoint的覆盖率构成一个covergroup的覆盖率;所有covergroup的覆盖率构成整体功能覆盖率。
2. bin的创建:自动 vs 手动
SV自动分配bin时,若域范围过大,默认分成64个bin(平均分配值域);可以用option.auto_bin_max改这个数目,能设在covergroup级(管所有coverpoint),也能在某个coverpoint内部单独覆盖:
covergroup covport;
    option.auto_bin_max = 8;        // 全局:所有coverpoint的auto_bin数量=8
    coverpoint tr.port
        {option.auto_bin_max = 2;}  // 局部覆盖:这一个coverpoint改成2
endgroup自动分bin把值域粗暴平均切块,命中信息很粗——建议自己手动定义bin,或者至少把auto_bin_max调小。
3. 手动定义bin:4种写法
- 单值:
bins zero = {0};—— 1个值,1个bin - 范围+离散值合并:
bins lo = {[1:3], 5};—— 多个值合并算1个bin,任一命中即算命中 - 范围拆分(加
[]):bins hi[] = {[8:$]};—— 范围里每个值单独拆成1个bin(这里变成8个:hi_8~hi_f) - 兜底:
bins misc = default;—— 剩余没被前面覆盖的值都算这1个bin
covergroup CovKind;
    coverpoint tr.kind {
        bins zero = {0};
        bins lo   = {[1:3], 5};
        bins hi[] = {[8:$]};
        bins misc = default;
    }
endgroup语法坑:coverpoint的约束体用{},不是begin...end;}结尾不加分号。
bins name={...}和bins name[]={...}的区别不加[]——列出的所有值算同一个bin,任一个命中就算这个bin覆盖了;加[]——范围里的每个值拆成独立的bin,要每个值都单独命中一次才能让对应的bin覆盖。判定标准都是”至少命中1次”(at least 1),不看命中频率——命中0次和命中100次,只要不是0,覆盖率上都算”覆盖”。
4. iff / start / stop
iff(条件)加在coverpoint后面,条件为假时这个coverpoint不采样——常用于复位期间屏蔽不合理的触发(跟7.1第3点disable iff是同一个思路)。start()/stop()则是覆盖组整个实例级别的开关。
covergroup CoverPort;
    coverpoint port iff (!bus_if.reset);
endgroupstart()/stop()用法——复位期间先关、复位结束再开:
initial begin
    CoverPort ck = new();
    #1ns;
    ck.stop();               // 关:避开reset期间的采样
    bus_if.reset = 1;
    #100ns bus_if.reset = 0;
    ck.start();               // 开:reset结束后恢复采样
    ...
end
5. 翻转覆盖率
coverpoint可以记录变量从A值到B值的跳转(transition bin),语法(A => B):
coverpoint port {
    bins t1 = {(0=>1), (0=>2), (0=>3)};   // 从0跳到1或2或3,任一发生都算命中t1
}代码覆盖率里的toggle coverage是自动统计信号本身0/1翻转过没有;这里的transition bin是手动定义、带业务含义的值跳变(比如”从idle跳到busy”)。
6. wildcard bins
?(还有x/z)在bin定义里当通配符用,一个bin代表一整类值:
bit [2:0] port;
coverpoint port {
    wildcard bins even = {3'b??0};   // 最低位是0:0,2,4,6
    wildcard bins odd  = {3'b??1};   // 最低位是1:1,3,5,7
}
7. ignore_bins vs illegal_bins
两者都会把命中的值从覆盖率分母里排除,区别是要不要报错:
| 行为 | |
|---|---|
ignore_bins | 静默排除——这个值本来就不关心/不会出现,出现了也不报错 |
illegal_bins | 排除 + 一旦真出现就报错——这个值理论上不该发生,发生说明设计有问题 |
coverpoint low_ports_0_5 {
    ignore_bins hi = {[6,7]};      // 静默排除
    // illegal_bins hi = {[6,7]};  // 换成这个:出现6或7直接报错
}
8.4 交叉覆盖率及覆盖选项
1. 交叉覆盖率(cross)
coverpoint只记录单个变量;要记录多个变量同一时刻的值组合,得用cross:
covergroup CovPort;
    kind: coverpoint tr.kind;
    port: coverpoint tr.port;
    cross kind, port;      // 记录kind和port"组合"出现过的情况
endgroupcross只能带coverpoint或简单变量名。默认按两个coverpoint的bin数做笛卡尔积,自动生成所有组合的bin。
2. 排除不关心的cross bin
组合数往往远超实际有意义的情况,用ignore_bins+binsof+intersect把不关心的组合排除掉:
cross kind, port {
    ignore_bins hi = binsof(port) intersect {7};                           // 排除port==7的所有组合
    ignore_bins md = binsof(port) intersect {0} && binsof(kind) intersect {[9:11]};   // 排除port==0且kind在9~11的组合
    ignore_bins lo = binsof(kind.lo);                                      // 排除kind落在lo这个bin里的所有组合
} //cross是存在于covergroup里的binsof(coverpoint)引用某个coverpoint的取值;binsof(coverpoint.bin名)直接引用某个具名bin。
- binsof后接小括号( ) —— 指定cvp或bin的名字
- intersect后接{ }大括号 —— 指定范围
3. 精细化交叉覆盖率
自动笛卡尔积组合太多、大部分没意义时,不用自动生成的cross bin,自己手动声明感兴趣的组合:
covergroup CrossBinNames;
    a: coverpoint tr.a { bins a0={0}; bins a1={1}; type_option.weight=0; }  // 不计入整体覆盖率
    b: coverpoint tr.b { bins b0={0}; bins b1={1}; type_option.weight=0; }
    ab: cross a, b {
        bins a0b0 = binsof(a.a0) && binsof(b.b0);   // 只关心a==0,b==0
        bins a1b0 = binsof(a.a1) && binsof(b.b0);   // 只关心a==1,b==0
        bins b1   = binsof(b.b1);                   // 只关心b==1(不管a是几)
    }
endgrouptype_option.weight=0是干什么的真正关心的是a和b的组合,不是a、b各自单独的覆盖率——把单个coverpoint的权重设成0,让它们不计入整体覆盖率统计,只有cross的结果算数。
另一种等价写法:不给a、b的bin命名,直接在cross bin里用intersect{值}圈定,效果一样:
ab: cross a, b {
    bins a0b0 = binsof(a) intersect {0} && binsof(b) intersect {0};
    bins a1b0 = binsof(a) intersect {1} && binsof(b) intersect {0};
    bins b1   = binsof(b) intersect {1};
}
4. 覆盖option速查表
option.xxx系列,加在covergroup或coverpoint里:
| 选项 | 作用 |
|---|---|
per_instance = 1 | 每个实例覆盖率单独统计(默认所有实例覆盖率会被合并成一份) |
comment = "..." | 给这个实例加注释,显示在覆盖率报告里 |
at_least = n | 一个bin至少要命中n次才算覆盖(默认1次)——可以设在covergroup级(管所有coverpoint),也可以设在某个coverpoint级(只管这一个) |
goal = n | 达标线设成n%(默认100%),只影响报告怎么判”达标”,不改实际统计数字 |
covergroup可以像function一样带参数列表,每个实例new()时传不同参数(常用来给per_instance分开的实例各自打标签):
covergroup CoverPort(int lo, hi, string comment);
    option.comment = comment;
    option.per_instance = 1;
    coverpoint port { bins range = {[lo:hi]}; }
endgroup
...
CoverPort cp_lo = new(0, 3, "Low port numbers");
CoverPort cp_hi = new(4, 7, "High port numbers");
5. covergroup方法速查表
| 方法 | 作用 |
|---|---|
sample() | 手动触发一次采样 |
get_coverage() | 取这个covergroup类型的整体覆盖率(所有实例合并),返回0~100的real值 |
get_inst_coverage() | 只取当前这一个实例自己的覆盖率 |
set_inst_name(string) | 设置这个covergroup实例的名字 |
start() / stop() | 使能/关闭这个实例的覆盖率收集 |
6. 覆盖率分析
运行时用$get_coverage()(全局系统函数,测整个仿真的总覆盖率)或covergroup_inst.get_inst_coverage()(测单个实例监测覆盖率变化曲线——一段时间不涨了就该停,换个随机种子或调整测试策略。
- 更进阶的做法是让测试基于覆盖率结果反过来调整随机约束(呼应8.1第1点的反馈环),例如重新限定随机约束,但这种测试不好写。
第九章 DPI
9.1 DPI基础用法
1. DPI是什么
DPI = Direct Programming Interface——SystemVerilog和C/C++之间的接口,让SV能像调用自己的native function/task一样直接调用C函数,变量在SV和C之间直接传递。
- 双向:
import把C函数/任务引入SV调用;export把SV的task/function开放给C调用 - 两种子程序都支持:可以是function也可以是task(对应3.2第1、3点)
- 为什么要用:SV用户手头常有现成的C/C++参考模型或测试代码,DPI是复用这些代码最简单的路,不用重写成SV
DPI比SVA/coverage/OOP testbench架构这些冷门,但要”把C写的reference model接进testbench”时,它就是标准做法。抓住import/export方向+为什么用它就够,不用死磕语法细节。
2. import “DPI-C”:让SV调用C
C函数要被SV调用:SV端import "DPI-C"声明这个C函数/任务的原型,C端#include <svdpi.h>。
// SystemVerilog code
program automatic test;
    import "DPI-C" context task c_test(input int addr);
    initial c_test(1000);
endprogram
// C code
#include <svdpi.h>
void c_test(int addr) {
...
}编译:vcs -R -sverilog top.sv c_test.c
context是什么告诉编译器这个C函数可能回调SV(比如调用export出去的task/function)。下面例1的C端会回调SV的apb_write,import时带context;例2的call_perl只调C库函数system(),不回调SV,import时就没加context。
3. export “DPI-C”:让C调用SV
反过来,SV的task/function想让C调用,要在SV端显式export:
program automatic test;
    import "DPI-C" context task c_test(input int addr);
    initial c_test(1000);

    export "DPI-C" task apb_write;
    task apb_write(input int addr, data);
        ... @(posedge ready); ...
    endtask
endprogram
#include <svdpi.h>
extern void apb_write(int, int); // 要调用的SV task,先extern声明
void c_test(int addr) {
...
apb_write(addr, data); // C反过来调SV
...
}编译:vcs -sverilog top.sv c_test.c
4. 例1:DPI批量访问register
C端并发调用SV的apb_write task批量写寄存器,SV端用semaphore把总线访问串行化(跟5.8第3点semaphore是同一个东西,这里防止两个并发的c_test同时踩同一条总线)。下面代码写的是"DPI"不带-C——两种写法都合法,但实际代码/前面例子更常见"DPI-C":
import "DPI" context task c_test(input int base_addr);

program automatic top;
    semaphore bus_sem = new(1);
    export "DPI" task apb_write;

    task apb_write(input int addr, data);
        bus_sem.get(1);
        #10 $display("VLOG : APB Write : Addr = %x, Data = %x  ", addr, data);
        bus_sem.put(1);
    endtask

    initial begin
        fork
            c_test(32'h1000);
            c_test(32'h2000);
        join
    end
endprogram
#include <svdpi.h>
extern void apb_write(int, int);
void c_test(int base) {
int addr, data;
for (addr = base; addr < base+5; addr++) {
data = addr*100;
apb_write(addr, data);
printf("C_TEST: APB_Write: addr = 0x%8x, data = 0x%8x\n", addr, data);
}
}Makefile要改:不能再用vlogan分步编译(以前COMP/ELAB两步走的流程行不通了),必须用单步vcs -sverilog把C和SV文件一起喂进去:
TOP = top
DFILES = test.c test.sv

SEED = 1
VCOM  = vcs -full64 -R -sverilog -debug_access+all -l elab.log -sim_res=1ps -Mupdate
RUN   = $(TOP).simv -l run.log +ntb_random_seed=$(SEED) &

comp:
	$(VCOM) $(DFILES) -top $(TOP) -o $(TOP).simv
run:
	./$(RUN)
5. 例2:DPI间接调用外部脚本
DPI另一个常见用法:C端调用system()执行外部命令/脚本(perl/tcl/python都行),把返回值传回SV:
import "DPI-C" function int call_perl(string s);

program automatic top;
    int ret_val;
    string script;

    initial begin
        if (!$test$plusargs("script")) begin
            $display("NO +script switch found");
            $finish;
        end else begin
            $value$plusargs("script=%s", script);
            ret_val = call_perl(script);
            $display("SV: Perl script return %0d", ret_val);
        end
    end
endprogram : top
#include <svdpi.h>
#include <stdlib.h>
#include <wait.h>
int call_perl(const char* command) {
int result = system(command);
return WEXITSTATUS(result); // 取外部命令的返回值,需要#include <wait.h>
}跑的时候通过+script=传脚本路径,Makefile的RUN行加一段:
RUN = $(TOP).simv -l run.log +ntb_random_seed=$(SEED) +script="perl hello.pl" &要调tcl/python,把+script=后面换成对应命令即可。
附录:其他补充内容
复位 (Reset)
复位(Reset)的本质是让电路进入一个可控的初始状态。
1. 同步复位 (Synchronous Reset)
复位信号仅在时钟上升沿(posedge clk)被采样。如果复位信号在时钟边沿之外发生变化,电路不会有任何反应。
always_ff @(posedge clk) begin
    if (!rst_n) begin  // 只有在时钟上升沿 且 rst_n 为低时才生效
        q <= 1'b0;
    end else begin
        q <= d;
    end
end| 优点 | 缺点 |
|---|---|
| 百分百同步:时序分析非常简单。 | 依赖时钟:如果时钟没起振,复位无法生效。 |
| 毛刺过滤:非时钟沿的信号抖动(毛刺)会被滤除。 | 资源消耗:可能需要额外的组合逻辑门,增加面积。 |
2. 异步复位 (Asynchronous Reset)
复位信号独立于时钟,只要复位信号一有效(通常是下降沿),电路立即强制进入初始态。
- “rst_n 一拉低 → 立刻进复位” = “negedge rst_n 触发 → 立刻进复位”,完全等价
// 复位信号必须放入敏感列表
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin//异步 assert/复位or生效 (立即) 【rst_n自己的下降沿触发】
        q <= 1'b0;
    end else begin
        q <= d; //同步deassert/释放 (等 clk)
    end
end
写 negedge rst_n 不是因为它只在下降沿那一瞬间复位,而是为了给 always 块加一个”一旦复位信号变动就立刻强制检查”的触发开关,从而在行为上模拟出硬件的异步复位特性。
| 优点 | 缺点 |
|---|---|
| 速度快:无需等待时钟。 | 释放风险:复位释放(Release)若靠近时钟边沿,会导致亚稳态。 |
| 资源省:大多数 FPGA/ASIC 寄存器原生支持异步复位端口。 | 时序挑战:必须严格检查 Recovery Time 和 Removal Time。 |
对比同步复位的差别:
always_ff @(posedge clk) if (!rst_n) q<=0; 这里敏感列表没有 negedge rst_n,所以 rst_n 拉低的瞬间不触发 always 块。要等下一个 posedge clk 来了,块才执行,才判 if (!rst_n)。这就是”同步复位有延迟”的来源。
3. 异步复位,同步释放 (ARSR)
Async Reset, Sync Release
- Release = de-assert = “撤复位”动作
- 对低有效信号 rst_n:release 就是 rst_n 从 0→1,复位状态结束,电路开始正常工作。
- 复位时:利用异步复位的快速响应,不依赖时钟。
- 释放时:通过同步器(两级寄存器打拍),将复位信号的撤销动作与时钟沿对齐。
- 所以”同步释放” = 让 rst_n_async 这个 0→1 上升沿不直接传给下游,先在 else 分支里被 clk 采样 2 次,才以 rst_n_sync 的形式放出去。
module reset_bridge (
    input  logic clk,
    input  logic rst_n_async, // 外部乱跳的异步复位
    output logic rst_n_sync   // 喂给后续所有逻辑的同步"安全复位"
);

    logic rst_n_d1;

    // 两级同步器:异步复位生效,同步逻辑释放
    always_ff @(posedge clk or negedge rst_n_async) begin
        if (!rst_n_async) begin  //input
            rst_n_d1   <= 1'b0;
            rst_n_sync <= 1'b0;
        end else begin
            // 正常运行时,通过时钟把 1 传下去
            rst_n_d1   <= 1'b1;
            rst_n_sync <= rst_n_d1; // 第二级output:实现同步释放
        end
    end

endmodule
⚠️ 使用规范:在主逻辑模块中,必须使用 rst_n_sync 作为异步复位:
always_ff @(posedge clk or negedge rst_n_sync) begin
    if (!rst_n_sync)
        q <= '0;
    else
        q <= d;
end
4. 为什么不用纯异步复位?
想象复位释放(从 0 变 1)刚好发生在时钟上升沿。此时 D 触发器不知道该听复位信号的(保持 0)还是听时钟的(采样 D),输出就会陷入 0 和 1 之间的震荡,即亚稳态。
运算符与移位
1. 逻辑 / 算术移位
| 操作 | 符号 | 行为 |
|---|---|---|
<< | 逻辑左移 LLS | 左移右边补 0;左移时总是右边补 0,和正负号无关。 |
<<< | 算术左移 ALS | IEEE 1800 标准定义:和 << 完全一样(保持语法对称) |
>> | 逻辑右移 LRS | 右移,左边补 0 |
>>> | 算术右移 ARS | 右移,左边补符号位(最高位 bit 保持原符号,正数补 0,负数补 1) |
负数计算需取反 +1 得补码,然后再进行位移计算。
2. i++ 和 ++i
int a = 5; int b = a++; // ① 先把 a 的旧值 5 赋给 b,然后 a + 1,此时 b=5,a=6
int c = ++a; // ② 先 a + 1(变成7),再把新值赋给 c
3. 位运算符 与 逻辑运算符
1、~和!
核心区别:~ 针对每一位,! 针对整体真假。
1. ~ 按位取反 (Bitwise NOT)
- 作用: 把数据里的每一个 bit 都单独翻转(0变1,1变0)。
- 结果位宽: 和原数据一样宽。
- 例子:
~4'b1010➔ 结果是4'b0101。
2. ! 逻辑非 (Logical NOT)
- 作用: 把整个数据当成一个整体看:非0就是”真”,全0就是”假”。然后只翻转真假。
- 结果位宽: 永远只有 1 bit (
1'b1或1'b0)。 - 例子:
!4'b1010➔ 结果是1'b0。(因为 1010 不是全0,代表”真”,取非后变成”假”)!4'b0000➔ 结果是1'b1。(因为 0000 代表”假”,取非后变成”真”)
一句话速记应用场景: 处理信号数据/连线用 ~,写 if 条件判断用 !。
2、& 和 && 及 |和||
这个区别和 ~ 与 ! 完全一致。单符号算”每一位”,双符号算”整体真假”
编译指令
1. timescale
`timescale 1ns/1ns —— Time Unit / Time Precision。
2. 反引号
在 SystemVerilog 中,符号 `(反引号)表示 编译时宏定义 或 参数化常量,也就是在编译时被替换为实际的数值。它通常用于引用常量、宏或者预定义参数。
bit [`AP_ADDR_WIDTH-1:0] ap_addr[`APERTURE_NUM];3. import 与 include 的主要区别
| 特性 | import | include |
|---|---|---|
| 功能 | 引入包中的内容(类、方法、数据类型等) | 将文件内容直接插入到当前文件中 |
| 用途 | 用于引入 SV 语法的包(package) | 用于包含外部文件(代码片段、宏、定义等) |
| 作用范围 | 只对包中的类、函数、变量等生效 | 将整个文件的内容嵌入到源代码中 |
| 使用时机 | 在模块、类、接口中引用外部的代码 | 在文件之间共享代码片段、宏定义等 |
| 代码复用 | 通过包的方式实现模块化复用 | 通过代码插入方式实现文件共享和复用 |
| 文件关系 | 必须先编译包(包中的内容已经被定义) | 可以直接包含未编译的代码文件,文件不会被编译 |
HDLBits练习
HDLBits 主要是用来练习 Verilog 语法
1.replication
Given five 1-bit signals (a, b, c, d, and e), compute all 25 pairwise one-bit comparisons in the 25-bit output vector.
答案:assign out = ~{ {5{a}}, {5{b}}, {5{c}}, {5{d}}, {5{e}} } ^ { 5{a,b,c,d,e} };
思考:写出展开式:
左边 25 bit:aaaaa_bbbbb_ccccc_ddddd_eeeee 右边 25 bit:abcde_abcde_abcde_abcde_abcde
这 25 个 bit 上下完全对齐后,每个位置上的符号只和它正下方的符号进行运算。而且在实际的硬件电路中,这 25 次运算是同时(并行)发生的,瞬间全部出结果。
注:右边也写 5 是为了把 5 bit 的短线手动拉长到 25 bit,防止系统瞎补 0。
2. module_pos
连接子模块端口的两种写法:
- 1.按位置(position)——跟端口声明顺序对应,简洁但子模块端口列表一变就全炸,得挨个找出来改:
mod_a instance1 ( wa, wb, wc ); // wa→in1, wb→in2, wc→out- 2.按名字(name)——
.端口名(信号名),点后面是子模块里的端口名,括号里 是外面(父模块[当前模块])的信号名,顺序无所谓,端口列表以后怎么变都不用改这行,更啰嗦但更稳:
mod_a instance2 ( .out(wc), .in1(wa), .in2(wb) );
// ↑子模块端口名 ↑外面的信号名注:模块间是层次化例化关系,不同模块的代码不能互相嵌套写在一起——只能例化,A模块的body不能写进B模块body里面。
语法区别记录
===和==的区别
- ==(逻辑相等 Logical Equality):只关心
0和1。如果比较的任何一方包含了x或z,运算符无法确定这两个信号在真实物理电路上是否相等,因此会返回x(未知) - ===(全等/大小写相等 Case Equality):进行严格的字面量匹配。它将
x和z视为普通的状态进行比较。结果永远是确定的1(真) 或0(假),永远不会返回x
sv和verilog区别
assign as = signed’(a); // SystemVerilog 风格 assign as = $signed(a); // 老 Verilog 风格,完全等价
Discussion
Loading comments…
Checking sign-in…