微架构
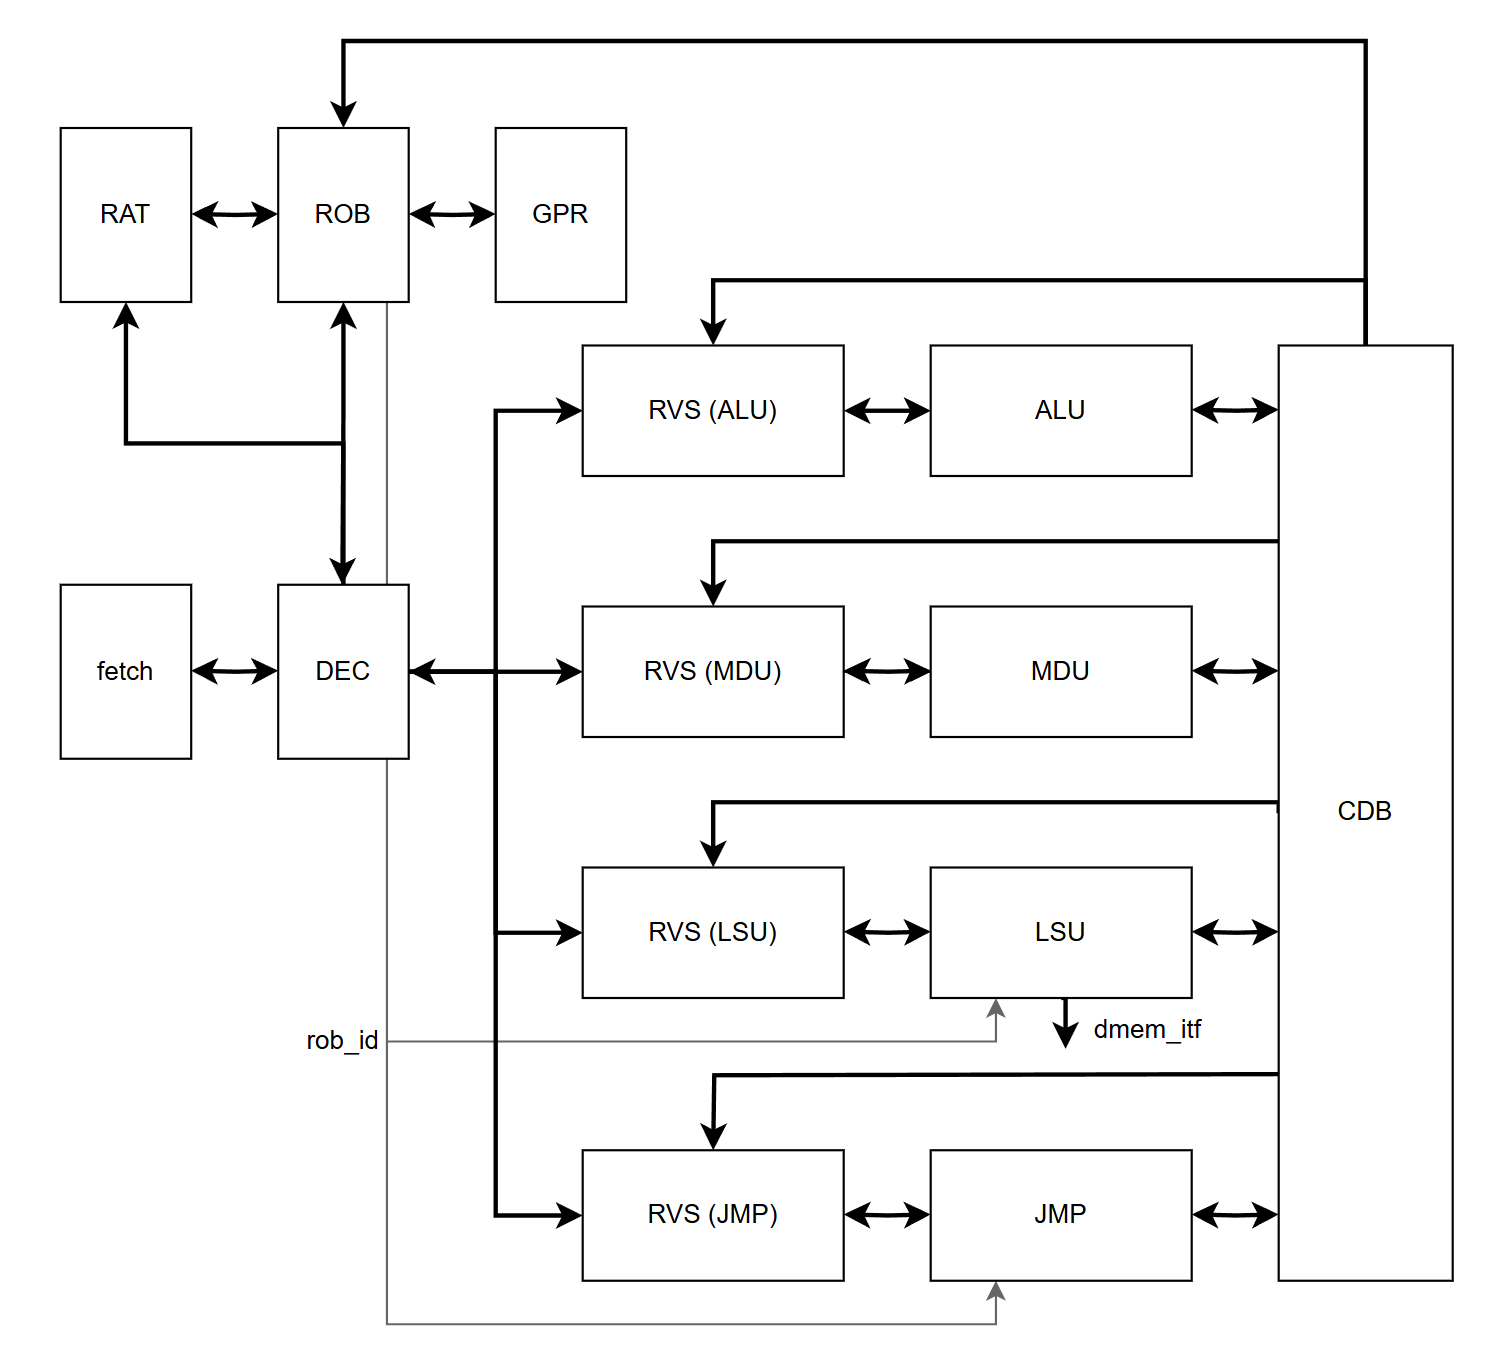
- 前端。Fetch 每次访问取回一条指令,放进 16 项的 instruction queue。分支被预测为 taken 时,分支预测器重定向 fetch。
- Rename 与 dispatch。32 项的 RAT 把每个架构寄存器映射到将要产生它的 ROB 项。操作数来自 register file、已完成的 ROB 项,或之后的 CDB 广播。
- 执行。四个 reservation station(ALU、MDU、LSU、JMP),每个 4 项。每个 station 从队头按序 issue。乱序执行来自四个单元彼此独立运行。MDU 使用 DesignWare 的多周期(sequential)乘法器和除法器。
- Commit。16 项的 reorder buffer 每周期 commit 一条指令。分支在 commit 时检查,预测错误时 flush 整个核。
- 分支预测。64 个 2-bit 计数器和 16 项的 BTB,都在 commit 时更新。
- 存储。指令和数据 cache 分离,各 2 KB:4 路、16 组、32 B cache line、write-back、tree-PLRU。16 项的 store buffer 按序写入 D-cache。Load 和 store 只有到达 ROB 队头时才访问 cache。
验证与工具
- ROB 通过 RVFI 上报每条 commit 的指令,脚本把这份 commit log 与运行同一程序的 Spike 逐条比对。
- Performance monitor 按指令类别打印 IPC,以及 cache 命中率、reservation station 等待周期和 flush 次数。
- 随机化的单元 testbench 覆盖 instruction queue 和 cacheline adapter。
- 一个小型 HTML 流水线查看器,用仿真 dump 回放 instruction queue、ROB 和 reservation station 的状态。
结果(2024 年 12 月)
| 指标 | 数值 |
|---|---|
| 时钟 | 100 MHz,slack 0.78 ns |
| 面积 | 172,397 µm²(核心约占 40%,两个 cache 各约 30%) |
| IPC | CoreMark 0.53 · AES-SHA 0.47 · FFT 0.57 |
工作范围
课程提供了 testbench 基础设施、memory model、RVFI monitor 和 benchmark 程序。RTL、performance monitor、单元 testbench 和流水线查看器由团队完成。
Discussion
Loading comments…
Checking sign-in…