2026年7月和8月,Anthropic在招聘页上先后挂出两个芯片岗位:Silicon Engineer和Research Engineer, Chip Design RL。前者做芯片,后者用芯片设计经验训练AI模型。本文先解释RL,再读这两份JD,然后看美国芯片设计、验证、架构岗位的JD怎么写AI能力,最后整理对设计和验证工程师的启发。岗位信息截至2026年10月14日。
一、强化学习
强化学习(Reinforcement Learning,RL)是一种训练模型的方法:模型在一个环境里反复做任务,环境给每次的结果打分,模型往高分的方向调整自己。几个关键词:
- 环境(environment):模型做任务的地方,包括任务描述、能调用的工具和判分规则
- 奖励(reward):环境给的分数,比如通过记1分、失败记0分
- 策略(policy):模型面对任务时的做法,训练改变的就是它
它和常见的监督学习不同:监督学习给出标准答案,让模型模仿;RL不给答案,只告诉模型结果好不好,模型自己摸索出能拿高分的做法。
放到芯片设计上,一轮RL训练大致是这样:
环境给出任务:按spec写一个同步FIFO的RTL
模型写出RTL
环境跑仿真和formal:testbench全部通过、断言没有反例,奖励为1;否则为0
训练让模型以后更可能写出拿1分的RTL
对验证工程师来说,这个环境很像一套验证平台:testbench给激励,scoreboard判对错。区别在于被测的不是一段RTL,而是写RTL的模型。
二、Anthropic的两份JD
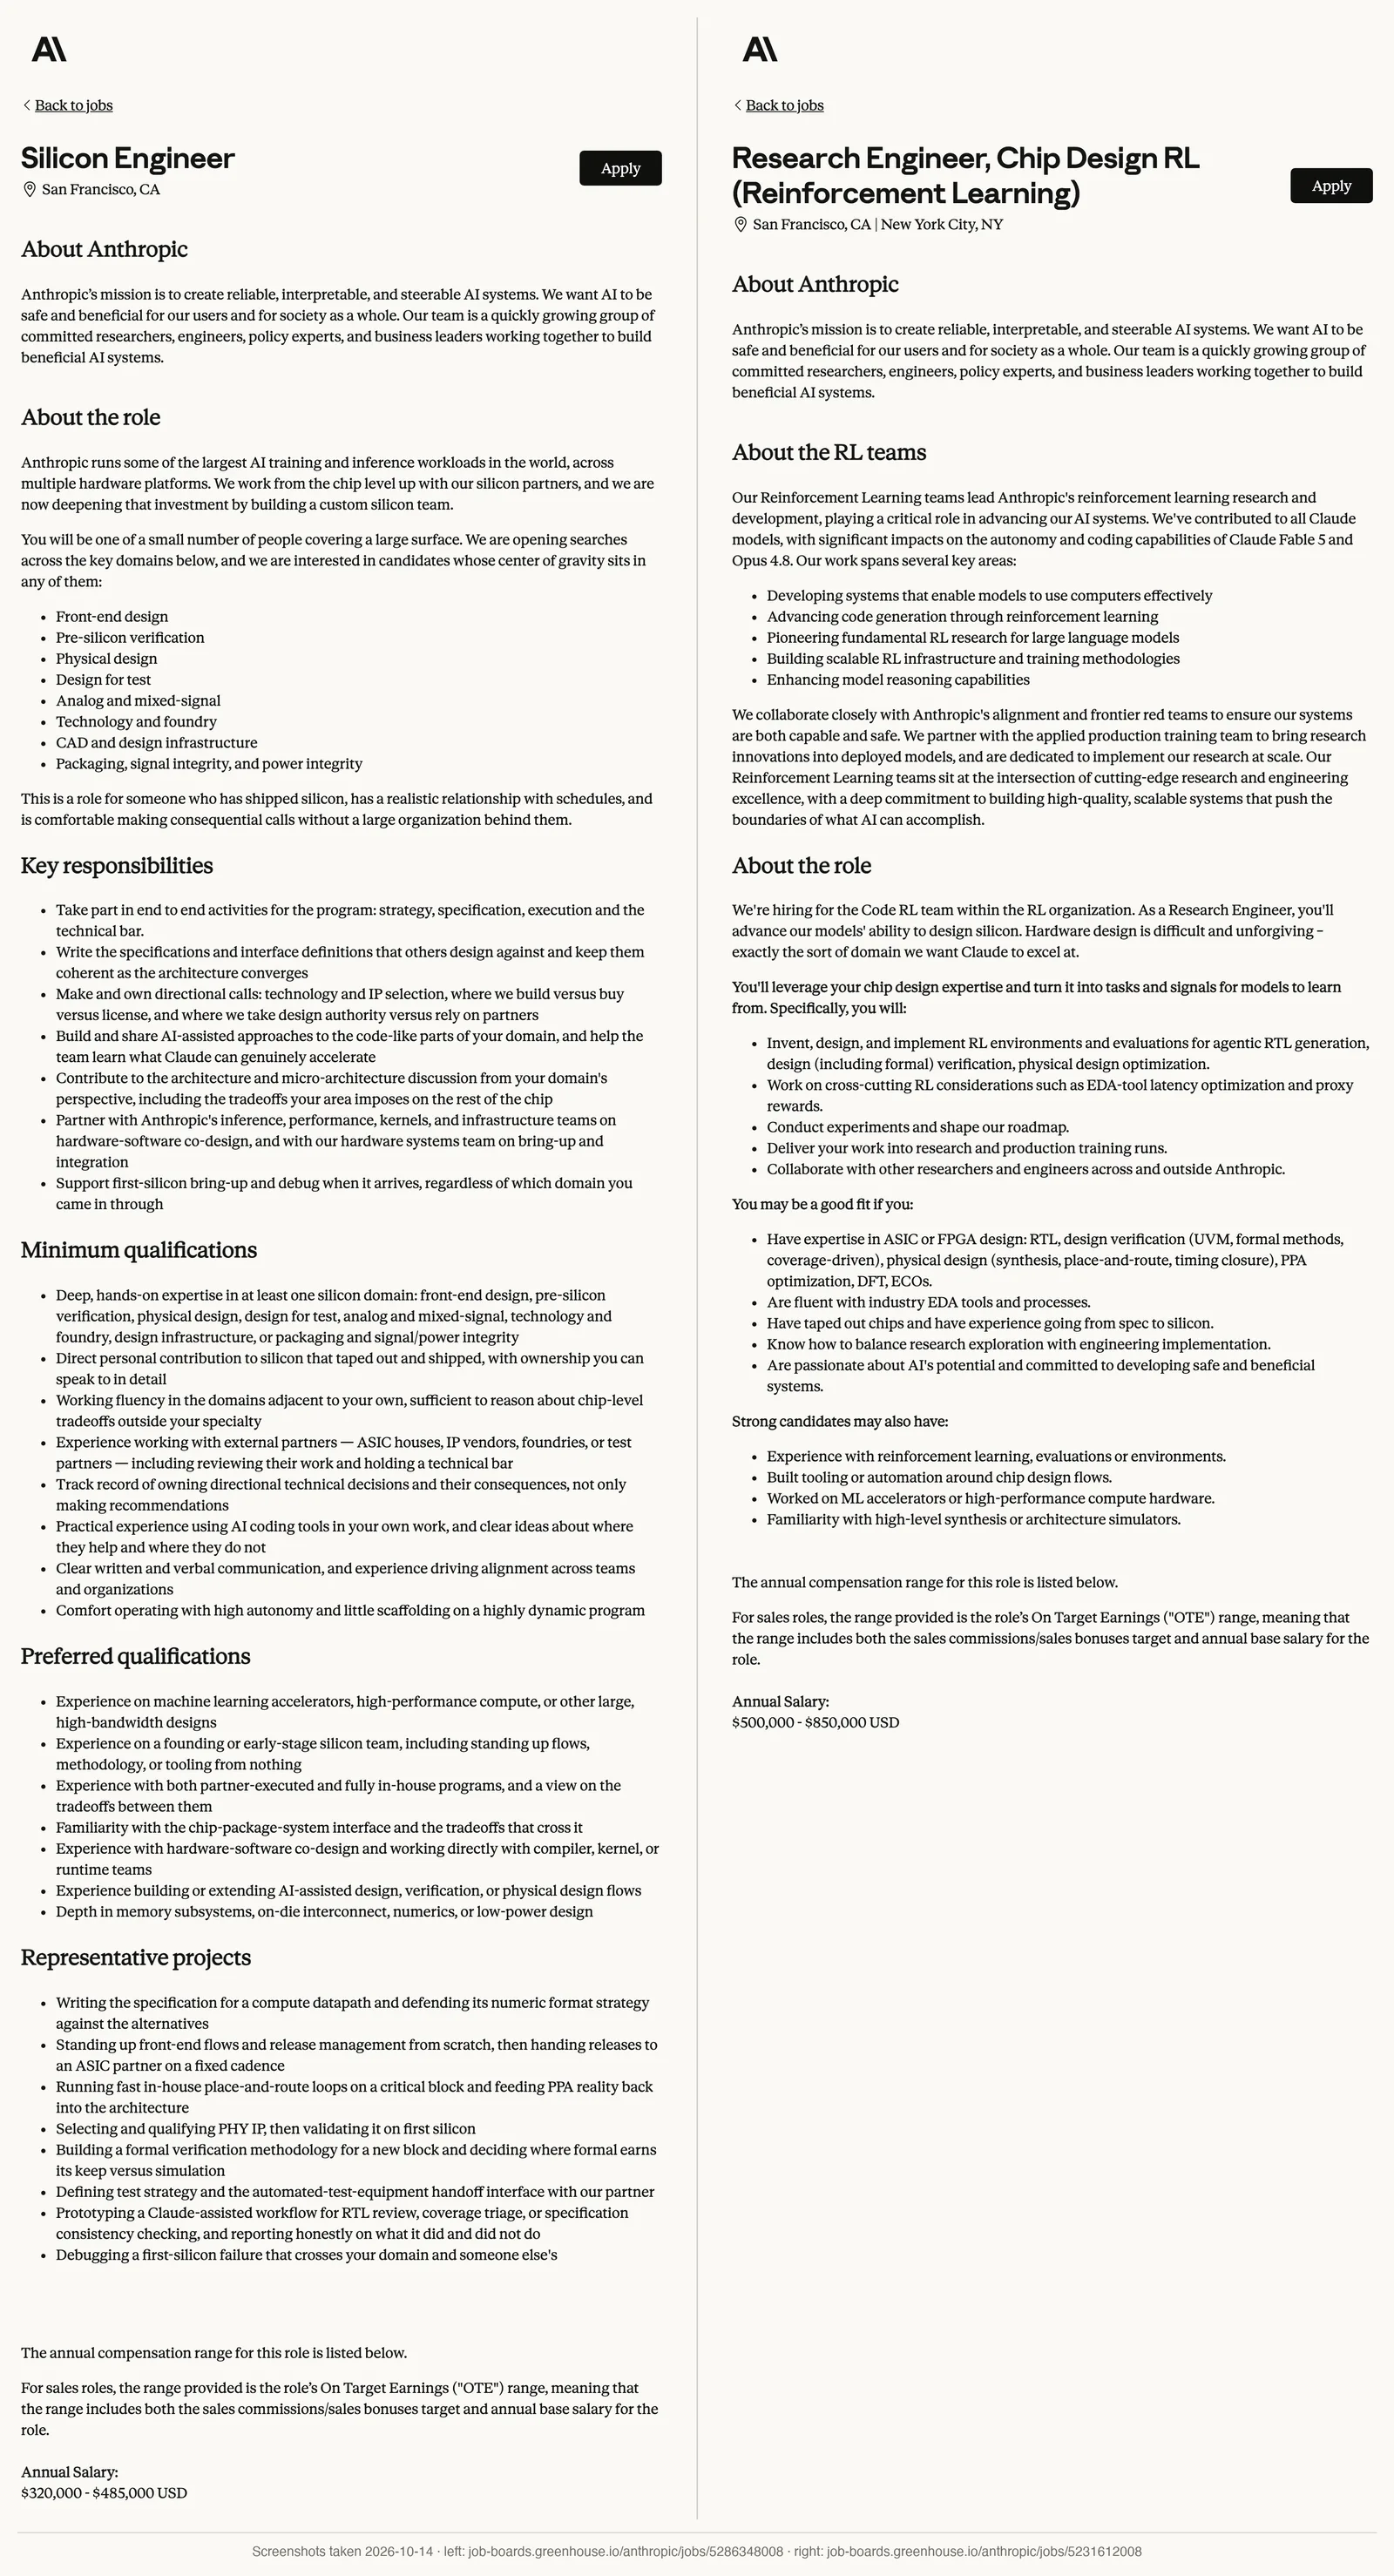
本节对比两个岗位:在哪个团队、做什么、要求什么。下图是两份JD的截图,左边是Silicon Engineer,右边是Chip Design RL;岗位下线后链接会失效,以截图为准。
| Silicon Engineer | Chip Design RL | |
|---|---|---|
| 团队 | 新建的自研芯片团队 | RL组织的Code RL团队 |
| 首次发布 | 2026-08-04 | 2026-07-13 |
| 年薪(JD标注) | 32万–48.5万美元 | 50万–85万美元 |
| 产出 | 芯片 | RL环境、evaluation、训练信号 |
| 流片经验 | 必须 | 必须 |
| 和AI的关系 | 用AI做芯片 | 让AI学会做芯片 |
1. Silicon Engineer:自研芯片团队的早期成员
JD开头交代了背景:Anthropic的训练和推理跑在多种硬件平台上,一直和芯片合作方从芯片层往上协作,现在开始组建自研芯片(custom silicon)团队。同一时期还挂出了Technical Program Manager, Silicon、Hardware Systems Architect等岗位,团队是成体系在搭。这个岗位的特点:
- 人少面广:少数几个人覆盖整颗芯片。按领域招人,前端设计、pre-silicon verification、physical design、DFT、模拟混合信号、工艺与foundry、CAD、封装与SI/PI都在列
- 做决定,不只是提建议:写spec和接口定义;决定技术和IP选型,自研、外购还是授权,哪些部分自己掌握设计权、哪些交给合作方;审查ASIC公司、IP供应商、foundry的工作,守住技术标准
- 跨领域:本领域要深,相邻领域也要熟,能从自己领域的角度参与架构和微架构的取舍,和推理、kernel团队做软硬件协同设计;芯片回来以后,不管出身哪个领域都要参与bring-up和debug
- 用AI是硬性要求:要在自己的工作里实际用过AI编程工具,并且清楚它在哪里有用、在哪里没用
JD列出的代表性项目里,有两条和验证直接相关:
- 为一个新模块建立形式验证(formal)方法学,并判断formal在哪里比仿真更划算
- 搭一个用Claude做RTL review、coverage triage(分析哪些覆盖点没打到、为什么)或spec一致性检查的原型流程,并如实报告它做到了什么、没做到什么
2. Chip Design RL:把芯片经验变成训练信号
这个岗位属于RL组织里的Code RL团队,目标是提高模型设计芯片的能力。JD解释为什么选芯片时说:“Hardware design is difficult and unforgiving”——难,而且对错分明,正是希望模型擅长的领域。具体工作:
- 为agentic RTL生成、设计验证(包括formal)、physical design优化设计并实现RL环境和evaluation(衡量模型能力的评测)
- 处理跨领域的RL问题,比如EDA工具的延迟(训练要反复调用工具,工具慢就是瓶颈)和proxy reward(拿不到最终答案时用来代替的近似奖励)
- 做实验、定路线,把成果交付到研究和生产训练中
任职要求几乎就是一份资深芯片工程师的清单:RTL、验证(UVM、formal、coverage-driven)、physical design(综合、布局布线、timing closure)、PPA、DFT、ECO,熟悉业界EDA工具,流片过,走过从spec到silicon的全程。RL、evaluation的经验只放在加分项里。
三、JD透露的信息
本节从两份JD和Anthropic同期的其他岗位,看岗位的定位、门槛和AI在工作里的实际位置。
1. Chip Design RL是RL岗位,芯片是它的领域
Chip Design RL挂在RL组织的Code RL团队下。同一个组织还在招Code RL、网络安全RL等方向的研究工程师,工作方法都是搭环境、设计判分、跑训练,区别只在领域。所以它和Silicon Engineer不是同一类工作:一个属于模型训练,产出是更会设计芯片的模型;一个属于硬件工程,产出是芯片本身。
2. 两个岗位都要求流片经验
Chip Design RL看上去是一条不用亲手做芯片的路,但在它的硬性要求里,流片过、从spec走到silicon和Silicon Engineer一样是必须项,芯片领域的要求列得比RL还细,RL经验只是加分。能做这个岗位的人,首先是一个合格的资深芯片工程师:芯片经验是入场券,RL能力叠在它上面,没有绕过真实项目的捷径。
3. 用AI做芯片,和让AI学会做芯片
Silicon Engineer也不是和AI无关的传统岗位:用AI工具是硬性要求,代表项目里就有用Claude做RTL review和coverage triage。两个岗位的分别不在用不用AI,而在用AI做芯片还是让AI学会做芯片。
团队人少,还有一个JD里写明的原因:ASIC公司、IP供应商、foundry承担了大量执行工作,内部团队负责定义、决策和守标准,也就是写spec、做选型、守住签核标准这类工作。
4. AI能加速什么,还在测
Silicon Engineer的JD要求候选人清楚AI工具在哪里有用、在哪里没用,代表项目要如实报告Claude辅助流程做到和没做到的部分,招人的目的之一就是让团队弄清Claude真正能加速什么。也就是说,在一家做大模型的公司里,AI已经进入芯片团队的日常流程,但哪里可靠、哪里不可靠,还要一项项去测。
把工程师的经验做成模型,也不只是AI公司在做。NVIDIA的ChipNeMo就是芯片公司自己做的:用内部的领域数据适配大模型,做工程问答、EDA脚本生成和bug总结,经验留在公司自己的平台里。
四、美国芯片岗位JD里的AI能力
本节看美国芯片设计、验证、架构岗位的JD怎么写AI能力。2026年10月14日抓取了各公司招聘页上在美国的岗位,按职位名筛出设计、验证、架构三类,共807份,来自NVIDIA、AMD、Intel、Apple、Qualcomm、Microsoft、Google、Amazon、Micron、Broadcom、Arm等公司和一批AI芯片创业公司。只统计把AI用在工程工作里的要求,比如用AI写代码、做debug、搭AI流程;只把AI当成产品(设计AI芯片、懂大模型负载)的不算。
| 类别 | 岗位数 | 提到AI技能 | 写进必备要求 |
|---|---|---|---|
| 设计 | 272 | 42(15%) | 10 |
| 验证 | 322 | 66(20%) | 13 |
| 架构 | 213 | 22(10%) | 5 |
| 合计 | 807 | 130(16%) | 28 |
从这些JD里能看出几点:
- 大多还是加分项:提到AI技能的130份里,写进必备要求的只有28份,占全部样本的3.5%;更多写在加分项和工作职责里
- 要的主要是会用AI工具:130份里有113份要求在日常工作里用AI工具,点名的有Claude Code、Copilot、Cursor、ChatGPT、Gemini;要求自己搭AI流程的21份,用机器学习分析工程数据(比如功耗模型、coverage收敛)的13份
- 验证提得最多:验证20%、设计15%、架构10%。验证JD写的任务也最具体:生成测试和testbench、生成SVA、debug和失败分类、coverage分析。架构JD里的AI多半是负载(要懂大模型的推理和训练),技能要求很少
- 把AI当产品的远多于当技能的:349份(43%)只在「做AI芯片」的意义上提AI,AI芯片创业公司尤其如此
- 没有一份点名EDA厂商的AI产品:要的是通用的AI工具能力,不是某个EDA工具的AI功能
- 要求能判断AI的输出:常见的说法是清楚它在哪里有用、哪里没用,用工程判断核对它的结果,和Silicon Engineer的那条要求一致
几份有代表性的JD:
- 应届岗位也开始写进必备要求:Intel的Design Verification Engineer面向本科或硕士加实习经历的新人,必备要求里有一条:在课程或项目里把AI编程助手当成日常的生产力工具,而不是偶尔试用;Micron的应届ASIC数字设计岗位要求熟悉Copilot、Claude这类大模型工具
- 验证任务写得很细:Amazon的高级formal验证岗位要求会用AI加速formal流程,包括生成SVA、debug属性、探索证明和调整约束;Tenstorrent的CPU验证岗位要求用AI辅助debug、生成激励和分析coverage,同时用工程判断核对结果
- 设计岗位要求理解AI的边界:Apple的RTL设计岗位要求会用AI写和优化SystemVerilog,也要理解AI在硬件设计里能做什么、不能做什么
- 职责里直接写agent:NVIDIA的验证岗位要用agentic AI自动化重复工作、加速debug;Qualcomm的验证岗位要用LLM框架搭agent工作流;Apple的GPU验证岗位要搭ML辅助的coverage closure流程
另外,「用AI做芯片设计」正在变成一类单独的岗位。样本里有18份这样的JD,比如NVIDIA的Applied Research Engineer, Chip Design和Senior ASIC Design Engineer - Agentic AI、Apple的Formal Verification - AI/ML Engineer、AMD的AI/ML Silicon Verification Solutions Engineer、OpenAI的Research Engineer, AI for Chip Design,以及Anthropic的Chip Design RL。它们要求搭agent、做RAG和微调、设计evaluation,同时都要芯片背景。
按职位名筛选,不含实习、管理、后端、DFT、模拟和CAD岗位;在JD正文里找AI相关的词,再逐条复核是「用AI做工程」还是「做AI芯片」,公司统一的招聘说明(比如招聘流程里用不用AI)不算。Meta和Tesla的招聘页抓不到;Apple的样本较多(190份,不少是相近的岗位)。数据只代表这一天的快照。
五、验证在RL里的位置
本节说明芯片设计为什么适合拿来训练模型,以及验证工程师的工作和RL环境之间的对应关系。
第一节说过,RL的效果取决于奖励可不可靠。芯片设计自带大量自动判对错的工具:仿真加testbench、formal证明、综合和STA报告、等价性检查。JD说的「对错分明」就是这个意思。业界已经在这样用:
- VerilogEval从HDLBits取了156道题,用仿真对比参考设计,自动判定大模型写的Verilog对不对
- Google的AlphaChip用强化学习做floorplanning(决定各模块在芯片上的位置),已经用在最近三代TPU上
把验证工程师手里的东西和RL环境的组成对上:
| 验证 | RL环境 |
|---|---|
| spec、testplan | 任务描述 |
| testbench、scoreboard、SVA | 判分(reward) |
| functional coverage | proxy reward |
| regression | evaluation集 |
| 能复现的bug | 难例 |
每个checker都是一个判分函数。写scoreboard和assertion,本质上是把「什么叫对」写成机器能执行的规则,这正是搭RL环境时最费功夫的部分。formal又是其中最可靠的一种:证明成立就是对,有反例就是错,没有刷分的余地。两份JD都点名formal,原因在此。
Coverage刷数与reward hacking
proxy reward在验证里有现成的例子:coverage。Coverage只是「验证充分」的近似,刷到100%不等于没有bug。模型训练里有同样的现象,叫reward hacking:模型钻判分规则的空子,分数很高,任务却没完成。两者都是古德哈特定律的例子:指标一旦成了目标,就不再是好指标。
判断coverage做到多少才是真收敛、而不是为了数字好看,正是设计proxy reward需要的能力:哪些coverage点反映真实的验证质量,怎样组合多个信号让模型刷不了分。这类判断靠项目经验积累,很难写进流程文档,属于隐性知识。能判断「指标什么时候在骗人」的验证工程师,正好能做RL环境里最关键的那部分。
EDA延迟一条也落在工程上:训练要成千上万次调用仿真和综合,工具快不快决定了训练能跑多少轮。会搭flow、写脚本、管regression的人,在这里同样有用。
六、对设计和验证工程师的启发
本节把前面的分析落到入行阶段能做的事。
- 先积累真实项目经验:两份JD都把流片列为必须项。芯片经验是这两类岗位共同的前提,先进入真实项目,把一颗芯片从spec跟到silicon
- 把判断写成规则:testplan写清每个功能点为什么测、测到什么程度算完;scoreboard和SVA把「对」写成可执行的检查;修完bug写复盘,记下根因和复现方法。判断对错的标准、可复现的失败案例、不能绕过的检查,正是搭RL环境和evaluation需要的素材
- 往「定义正确」上走:生成RTL和testbench样板、整理coverage报告这类重复工作,最容易交给AI。验证的价值上移到testplan、checker、coverage模型和收敛判断
- 学formal:两份JD都点名formal。它是最可靠的判分方式,也是判断「formal和仿真各用在哪」的基础
- 用AI,并记下它的边界:美国JD里最常见的AI要求就是会用AI工具、能判断它的输出,面向新人的岗位里也已经写进必备要求。平时用AI生成测试和SVA、做debug、分析coverage,记录它漏了什么、错在哪里
- 懂相邻领域:验证要懂设计意图、综合和timing的约束、DFT的影响,才能参与芯片级的取舍。JD要的就是本领域深、相邻领域熟
- 分清知识的归属:公司的设计数据、内部方法和bug记录属于公司,不能带出去训练模型或换取报酬;能积累在个人身上的是公开知识、方法和能力
- Chip Design RL是RL研究岗位,芯片是它训练模型的领域之一;进入这类岗位的前提仍然是完整的芯片经验
- 芯片设计适合训练模型,是因为验证工具能自动判对错。写checker、设计coverage、判断收敛,就是在做RL环境里的判分和proxy reward
- 美国芯片岗位的JD里,16%提到AI技能,主要是会用AI工具并能判断它的输出;多数还是加分项,验证岗位提得最多,面向新人的岗位也开始写进必备要求
- AI先接手重复性工作,价值留在定义「什么是对」、守住标准、做出判断的人手里
参考
- Anthropic, Silicon Engineer,2026-08-04首次发布
- Anthropic, Research Engineer, Chip Design RL,2026-07-13首次发布
- Anthropic, Research Engineer, Code RL
- Anthropic, Research Engineer, Cybersecurity RL
- Anthropic, Hardware Systems Architect
- Anthropic, Technical Program Manager, Silicon
- Intel, Design Verification Engineer
- Micron, New College Grad - Engineer, ASIC Digital Design
- Amazon, Sr. Formal Verification Engineer, Amazon Leo
- Tenstorrent, CPU Core Design Verification Testbench Lead
- Apple, RTL Design Engineer、GPU Design Verification Engineer、Formal Verification - AI/ML Engineer
- NVIDIA, Senior Verification Engineer、Applied Research Engineer, Chip Design、Senior ASIC Design Engineer - Agentic AI
- Qualcomm, GSoC Design Verification Engineer
- AMD, AI/ML Silicon Verification Solutions Engineer – Tools
- OpenAI, Research Engineer, AI for Chip Design
- M. Liu et al., VerilogEval: Evaluating Large Language Models for Verilog Code Generation, 2023
- M. Liu et al., ChipNeMo: Domain-Adapted LLMs for Chip Design, 2023
- A. Mirhoseini et al., A graph placement methodology for fast chip design, Nature, 2021
- Google DeepMind, How AlphaChip transformed computer chip design, 2024
- Wikipedia: Reinforcement learning、Tacit knowledge、Reward hacking、Goodhart’s law
Discussion
Loading comments…
Checking sign-in…