Cache的结构、寻址和读写替换见上篇、下篇。这一篇讲怎么让cache更快,衡量的标准是AMAT(多级cache的算法见上篇一、2):
AMAT = hit time + miss rate × miss penalty
每种优化都是压低其中一项,但常常会抬高另一项,值不值要看AMAT整体。
一、Cache参数的取舍
1. Block size的取舍
block size就是一条cacheline的大小。容量不变,把块做大:
- 好处:利用spatial locality,一次多搬一些相邻的数据,compulsory miss变少
- 坏处:
- miss penalty变大:一次要搬的数据更多
- 块的数量变少:程序同时在用的数据放不下、互相踢掉,miss rate降到一定程度后又会回升
- hit time也会变长一点:要从更大的块里选出要的那几个字节
所以AMAT随block size先降后升,最优点一般在64字节左右,常见的cacheline就是64B。
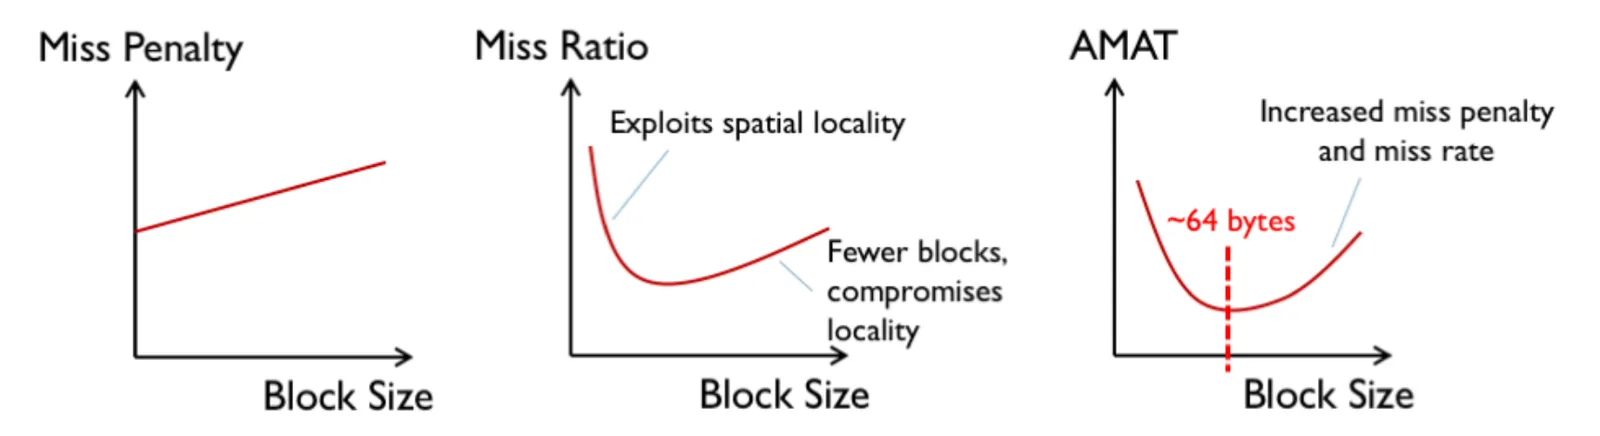
三张图从左到右:miss penalty随block size线性变大;miss rate先降(spatial locality)后升(块太少);两者合起来,AMAT是U形。
不同容量的cache,miss rate随block size的变化(实测):1KB的cache,块从64B加到256B,miss rate从约18%涨回约27%;256KB的cache几乎不回升。
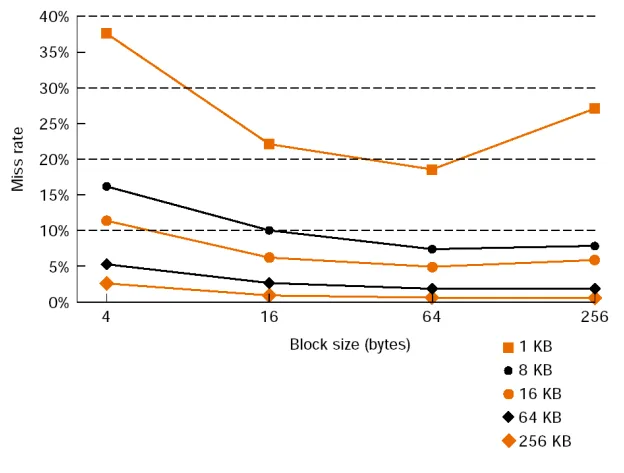
说明Cache size越大,Block size变大所带来的miss rate回升越低
2. Associativity的取舍
way越多,conflict miss越少,miss rate越低;但每次要比较的tag越多,hit time越长(见上篇)。一头省、一头费,合起来是快是慢,要用AMAT算。
way数对miss rate的影响,有两条经验:
- 收益递减:超过4~8路,miss rate几乎不再下降
- 经验法则:大小为N的direct mapped,miss rate和大小为N/2的2-way差不多(2路抵一倍容量)
hit time折算成cycle时要向上取整:数据只能在时钟沿被取走,差一点也要多等一个cycle。
32KB的cache,CPU 1GHz(1 cycle = 1ns),比较三种结构:
| hit time | 折成cycle | miss rate | AMAT(miss penalty = 100) | AMAT(miss penalty = 5) | |
|---|---|---|---|---|---|
| Direct mapped | 1.0ns | 1 | 0.2 | 1 + 0.2 × 100 = 21 | 1 + 0.2 × 5 = 2 |
| 2-way | 1.2ns | 2 | 0.1 | 2 + 0.1 × 100 = 12 | 2 + 0.1 × 5 = 2.5 |
| 4-way | 1.8ns | 2 | 0.05 | 2 + 0.05 × 100 = 7 | 2 + 0.05 × 5 = 2.25 |
miss penalty = 100时4-way最快;miss penalty = 5时反过来,direct mapped最快。
miss penalty大的时候值得加way,小的时候不值得。这也是为什么L1更看重hit time,L2、L3更看重miss rate:L1 miss了只要去L2取,miss penalty小;L2、L3 miss了要去更下一级甚至DDR,miss penalty大。
小结:三个参数变大时:
| 参数 | hit time | miss rate | miss penalty |
|---|---|---|---|
| 容量 | ↑ 阵列大,读得慢 | ↓ capacity miss少 | 不变 |
| way数 | ↑ 比较器、mux变多 | ↓ conflict miss少 | 不变 |
| block size | ↑ 选字节的mux变大 | 先↓后↑ | ↑ 一次搬得多 |
二、Tag和data怎么读
tag array和data array分开放(结构见上篇二、4),tag array小、读得快,hit / miss能先算出来。两块怎么配合着读,有两种做法。
1. 并行读
Index同时送进tag array和data array:
- tag读出来和地址里的Tag比较,得到hit / miss,同时作为way mux的选择信号
- data array把这个set所有way的数据都读出来,way mux选出hit的那一路,aligner再按Offset取出要的字节
data要等hit / miss出来才用得上,两块同时读,读data的时间就和比较tag重叠起来,hit time短。代价是每次都读出所有way的data、最后只用一路,费电(8-way每次读8路、只用1路)。
tag和data放在SRAM里时,读出来要等1拍:想让hit在请求后1拍内返回,请求一来就得把Index同时送给所有way的tag和data,只能并行读;串行读还要再多1拍。
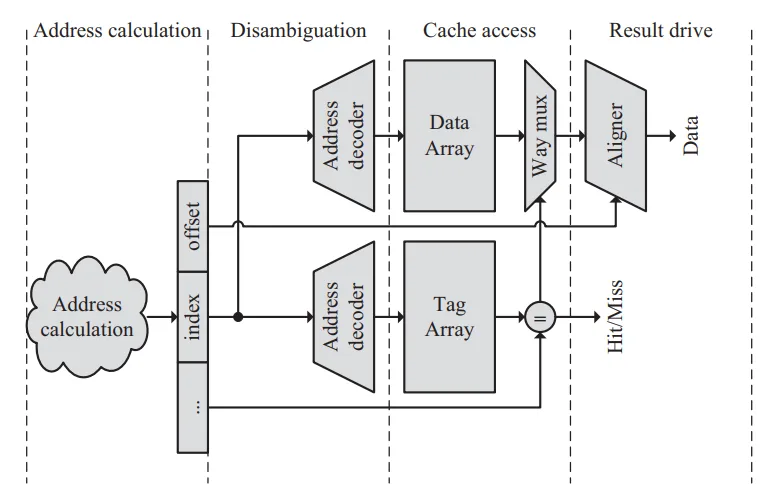
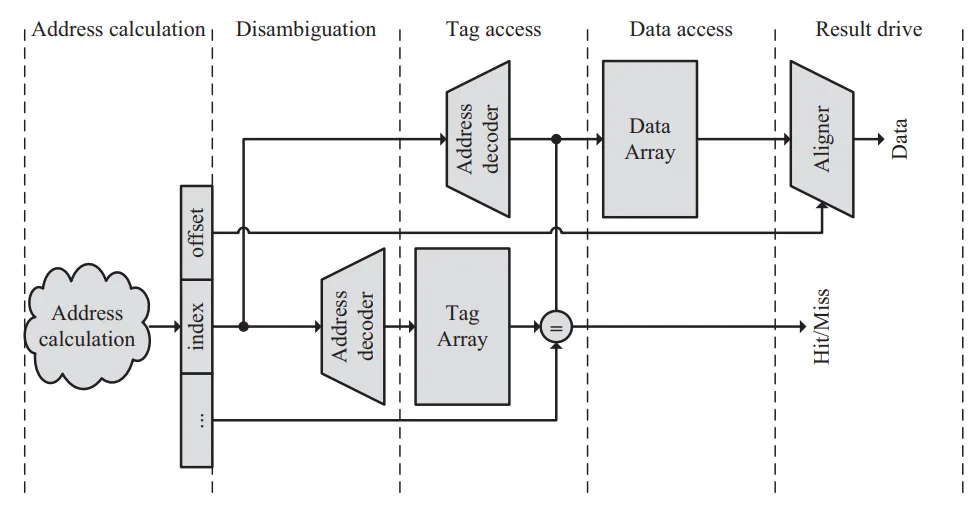
图上方一栏是一条load指令依次经过的阶段(Disambiguation是乱序处理器检查load和前面的store有没有地址冲突,这里不用管)。
cache访问往往是处理器的关键路径之一,并行读时有两条路:
- 一条路走tag array → 比较 → way mux的选择端
- 另一条从data array到way mux
两条里慢的那条决定hit time。频率高的设计会把cache访问拆成流水线。
2. 串行读
先只读tag array、做比较;知道hit在哪一路之后,下一拍只读那一路的data(比较结果直接当data array的way enable)。
- 省电:只读一路data;miss时,查找这一步根本不用读data array
- 每一拍做的事少,关键路径短,频率能做得更高
- 缺点:hit time多1拍
| 并行读 | 串行读 | |
|---|---|---|
| data读几路 | 所有way | 只读hit的那一路 |
| hit time | 短 | 多1拍 |
| 功耗 | 高 | 低 |
| 常见用在 | L1 | L2、L3 |
L1和L2、L3选法不同,道理和一、2的结论一样:L1更看重hit time,L2、L3的data array大,更看重功耗。
参考
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed.
- Wikipedia, CPU cache
Discussion
Loading comments…
Checking sign-in…