一、基本概念
1. Memory hierarchy
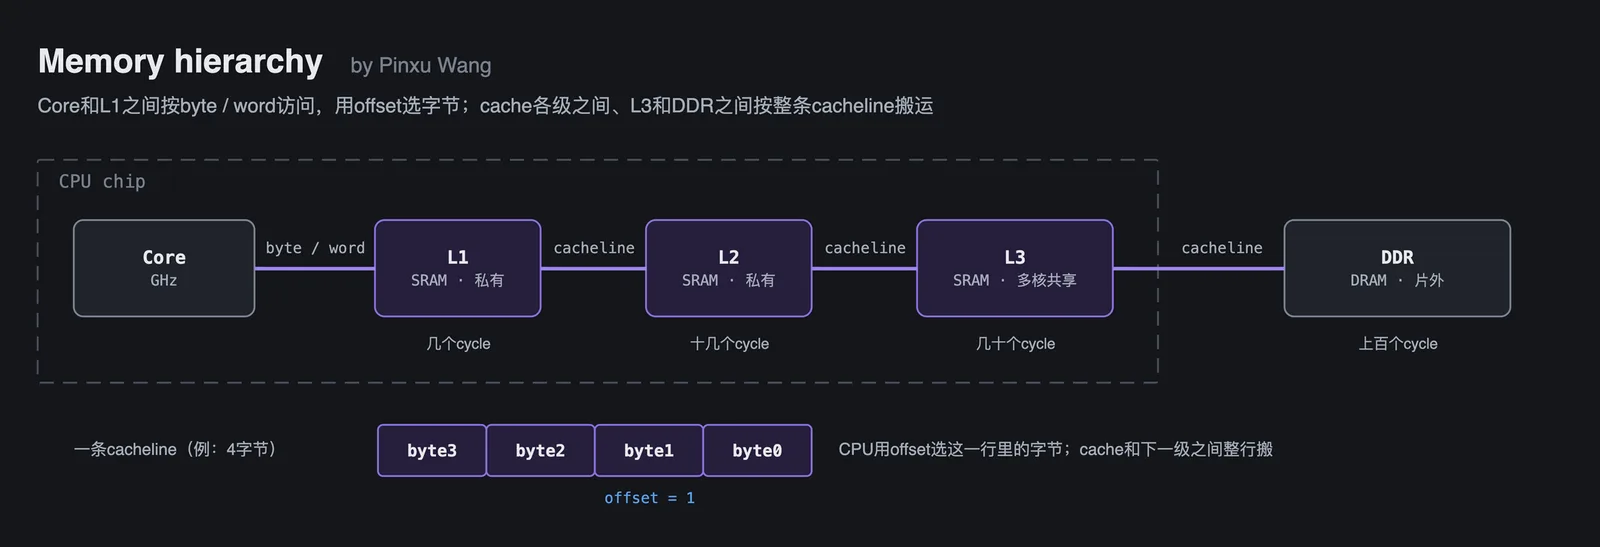
CPU跑在GHz级别,DDR(DRAM)访问一次要几十到上百ns,中间差了上百个cycle。Cache用SRAM做在CPU片内(on-chip),存放最常访问的数据,CPU访存时先查cache。
| 层级 | 位置 | 实现 | Latency(量级) |
|---|---|---|---|
| L1 | on-chip,每个core private | SRAM | 几个cycle |
| L2 | on-chip,常见为每个core private | SRAM | 十几个cycle |
| L3 | on-chip,所有core shared | SRAM | 几十个cycle |
| DDR | off-chip | DRAM | 上百个cycle |
越靠近CPU越快、越小、每字节越贵。
2. Hit与Miss
- hit:要的数据在cache里,直接从cache取
- miss:不在cache里,要去下一级DDR取。下文为了简单,下一级统一写成DDR
衡量cache好坏常用AMAT(average memory access time):
AMAT = hit time + miss rate × miss penalty
- miss penalty:从下一级取回一整条cacheline的时间 = access time(等第一个数据回来,看latency)+ transfer time(把整条搬过来,看两级之间的bandwidth)
多级cache:某一级的miss penalty,就是去它下一级取数据的平均时间,而这个时间本身又是一个AMAT,所以一层套一层:
AMAT = Thit(L1) + miss%(L1) × [ Thit(L2) + miss%(L2) × ( Thit(L3) + miss%(L3) × T(memory) ) ]
- Thit(Lx):Lx的hit time;T(memory):访问DDR的时间
- miss%(Lx):到达Lx的那些访问里有多少miss(local miss rate),不是占全部访问的比例
假设
- L1的miss rate 10%、hit time 1 cycle;
- L2 5%、10 cycle;
- L3 1%、20 cycle;DDR 300 cycle。
从最里层往外算:
| 结构 | 计算 | AMAT |
|---|---|---|
| 只有L1 | 1 + 0.1 × 300 | 31 |
| L1 + L2 | L2:10 + 0.05 × 300 = 25 → L1:1 + 0.1 × 25 | 3.5 |
| L1 + L2 + L3 | L3:20 + 0.01 × 300 = 23 → L2:10 + 0.05 × 23 = 11.15 → L1:1 + 0.1 × 11.15 | 2.115 |
加L2的收益最大:L1 miss的那10%访问,不用每次都等DDR的300拍。
3. Cacheline与Offset
-
cacheline:cache和DDR(下一级)之间搬数据的最小单位,也就是两者之间的访问粒度。
- CPU的访存请求先交给cache(不可缓存的区域除外);miss时是cache去DDR搬一整行cacheline回来,不是只搬要的那个字节
-
offset:CPU和cache之间的访问粒度是byte或word(由load / store指令决定),用offset指出要的是这一行cacheline里从哪个字节开始
-
offset位数 = log2(cacheline字节数),一行里有2^offset位数个字节。例:64字节的行要6位offset
4. Locality与Prefetch
怎么知道哪些数据「常访问」?靠程序的locality:
- temporal locality:某一时刻访问了地址A,不久之后很可能再访问A。例:循环里反复用到的变量
- spatial locality:访问了地址A,很可能接着访问A附近的地址。例:顺序遍历数组
一次搬一整条cacheline,本身就在利用spatial locality。
- prefetch更进一步:取地址A时,顺便把A附近的数据(比如下一条cacheline)也取进cache。
5. Cache里放的是什么
内存按cacheline的大小切成一块一块(block)。cache只有很少几条cacheline,每条一次只能放一块。放哪一块,不是CPU挑的,而是由块地址里的Index位决定,所以很多块要共用同一条cacheline(详见第二节)。
内存有16块,块号0~F;cache有4条cacheline,用块号的低2位决定放哪条(direct mapped):
| cacheline | 能放的块 |
|---|---|
| 0 | 块0、块4、块8、块C |
| 1 | 块1、块5、块9、块D |
| 2 | 块2、块6、块A、块E |
| 3 | 块3、块7、块B、块F |
- cacheline 0同一时刻只能放这4块里的一块,其余3块都不在cache里
🟠所以每条cacheline除了数据,还要存tag,记录「现在放的是哪一块」;再存valid bit,记录「这条里有没有数据」
CPU读或写,给出的都是内存地址。cache用地址里的Index找到对应的那条cacheline,再比较tag(并看valid):这个地址所在的块,现在是不是放在这条cacheline里。
- 在:hit。读就取数据,写就直接写进这条cacheline
- 不在:miss。要先把这一块放进cache(或者像write no-allocate那样,绕过cache直接写DDR)
所以写操作也一样:对应的块在cache里才算hit。
二、Cache的寻址与组织方式
1. Set和Way
- set:地址先决定放进哪一个set
- way:一个set里有几条cacheline
- X-way set associative = 每个set有X条cacheline
下图一共8条cacheline,分成2个set、每个set有4条,是4-way set associative(2 sets),不是2-way:
set0:way0、way1、way2、way3
set1:way0、way1、way2、way3
三种cache组织结构:
- Direct mapped:1-way。每个地址只能放进唯一的一条cacheline
- X-way set associative:地址决定放进哪个set,set内X条随便放
- Fully associative:只有1个set,way数等于cacheline总数(way数最大)。任何地址都能放进任何一条
用同一个小例子对比这三种结构:内存32字节,地址ADDR[4:0]共5位,每个地址存1字节DATA[7:0];cache共4条cacheline,每条1字节,所以没有offset。Index和Tag是地址的两部分,下一小节讲。
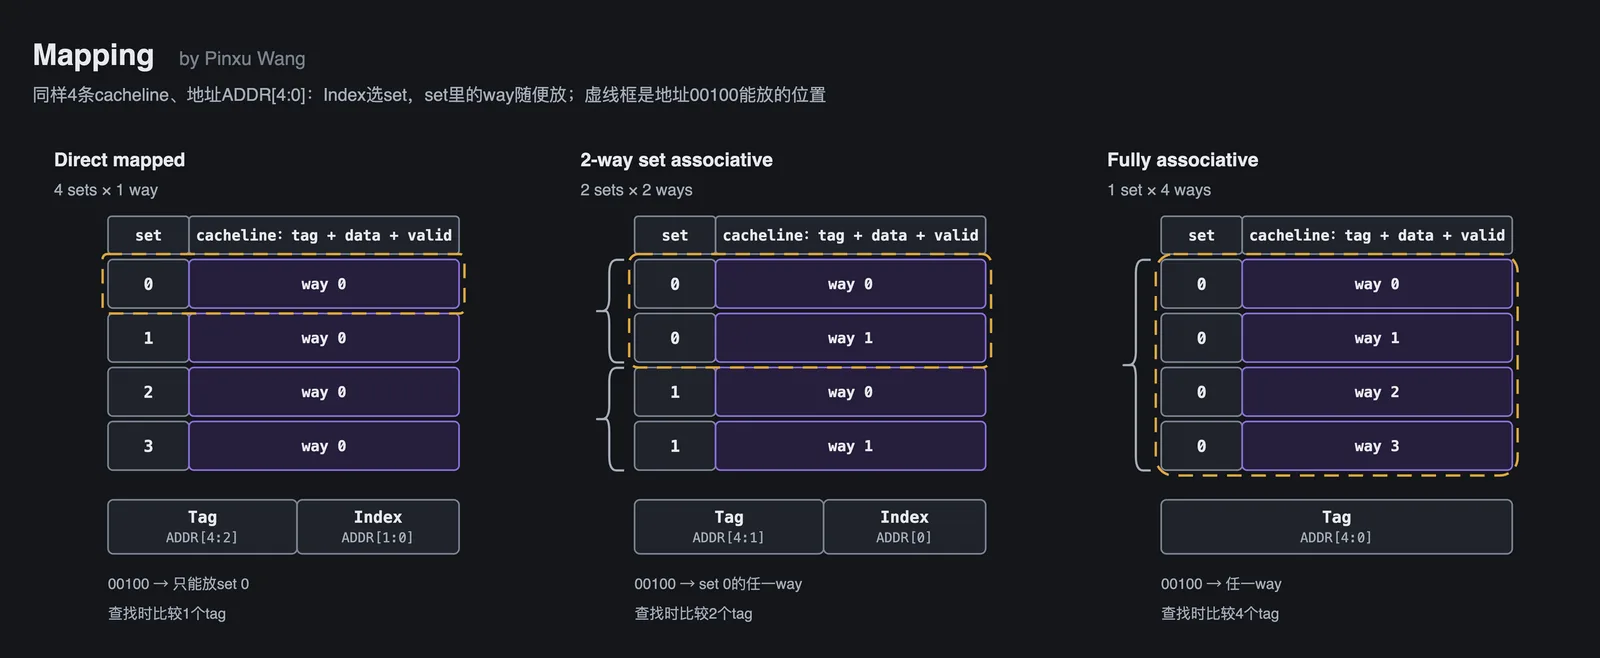
Index分别为2bit、1bit、0bit(fully associative没有Index)。
| Mapping | set × way | Index | Tag |
|---|---|---|---|
| Direct mapped | 4 × 1 | ADDR[1:0] | ADDR[4:2] |
| 2-way set associative | 2 × 2 | ADDR[0] | ADDR[4:1] |
| Fully associative | 1 × 4 | 无 | ADDR[4:0] |
set associative让一个地址在cache里有多个可放的位置(X-way就有X个),两个常用地址落到同一个set时可以同时留在cache里,conflict miss变少、命中率提高;代价是每次访问要并行比较X个tag,再用X选1的mux选出命中那一路,面积和hit time都比direct mapped大。
2. 地址划分
地址 = Tag | Index | Offset(从高位到低位)
- Offset:log2(cacheline字节数)位,选行里的哪个字节
- Index:log2(set数)位,选哪一个set(大多数情况下Index就是set号)
- Tag:剩下的高位。每条cacheline旁边存一份tag,查找时和地址里的Tag比较,相同才可能hit
1KB的direct mapped cache,cacheline 32字节,地址32位:
- Offset:log2(32) = 5位,ADDR[4:0]
- Index:1KB ÷ 32字节 = 32条cacheline,direct mapped每个set只有1条,所以有32个set,log2(32) = 5位,ADDR[9:5]
- Tag:剩下的ADDR[31:10],22位
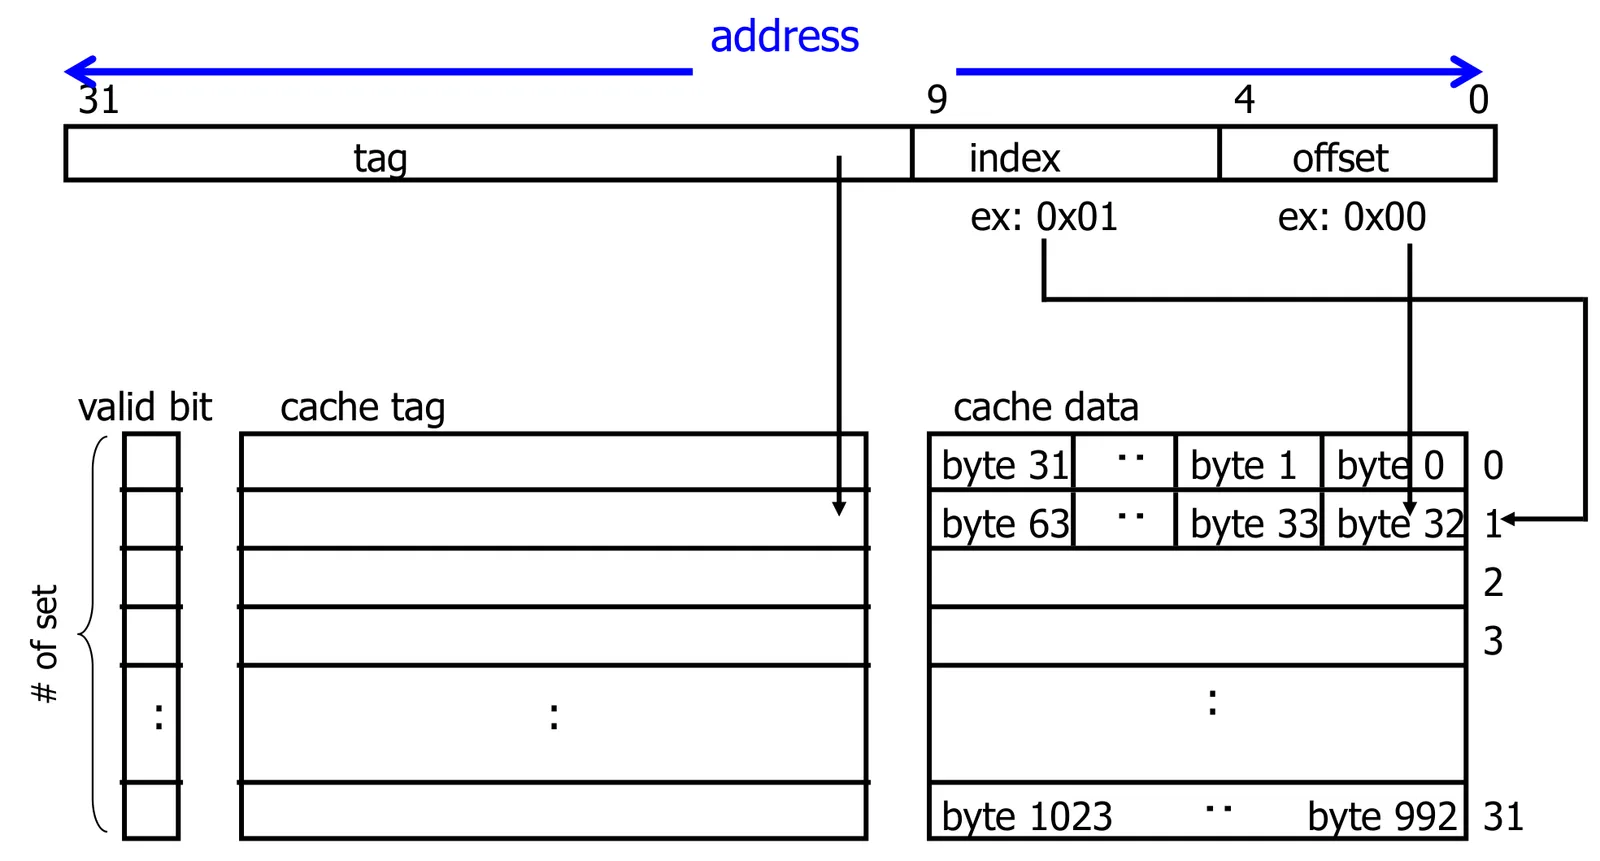
访问地址0x44:先把0x44转成二进制,看第[4:0]位决定是cacheline里哪个offset,也就是第几个字节。然后看地址的[9:5]决定是哪个set。
0x44 = 0…0_00010_00100(Tag_Index_Offset)
Index = 00010 —— set 2
Offset = 00100 —— 这条cacheline的第4个字节(从0数)
Tag = 0…0 —— 拿去和set 2里存的tag比较
way数变化时:总容量和cacheline大小不变,way翻倍 → set数减半 → Index少1位、Tag多1位(Index让1位给Tag);Offset不变。
32KB的cache,cacheline 32字节,地址32位:一共1024条cacheline,Offset都是5位。
| Direct mapped | 2-way | 4-way | |
|---|---|---|---|
| set数 | 1024 | 512 | 256 |
| Index | 10位 | 9位 | 8位 |
| Tag | 17位 | 18位 | 19位 |
每条cacheline除了数据,还存tag和valid bit(见第一章第5小节),write-back cache还要存dirty bit(见下篇)。valid上电时全为0,所以tag相同且valid = 1才算hit。
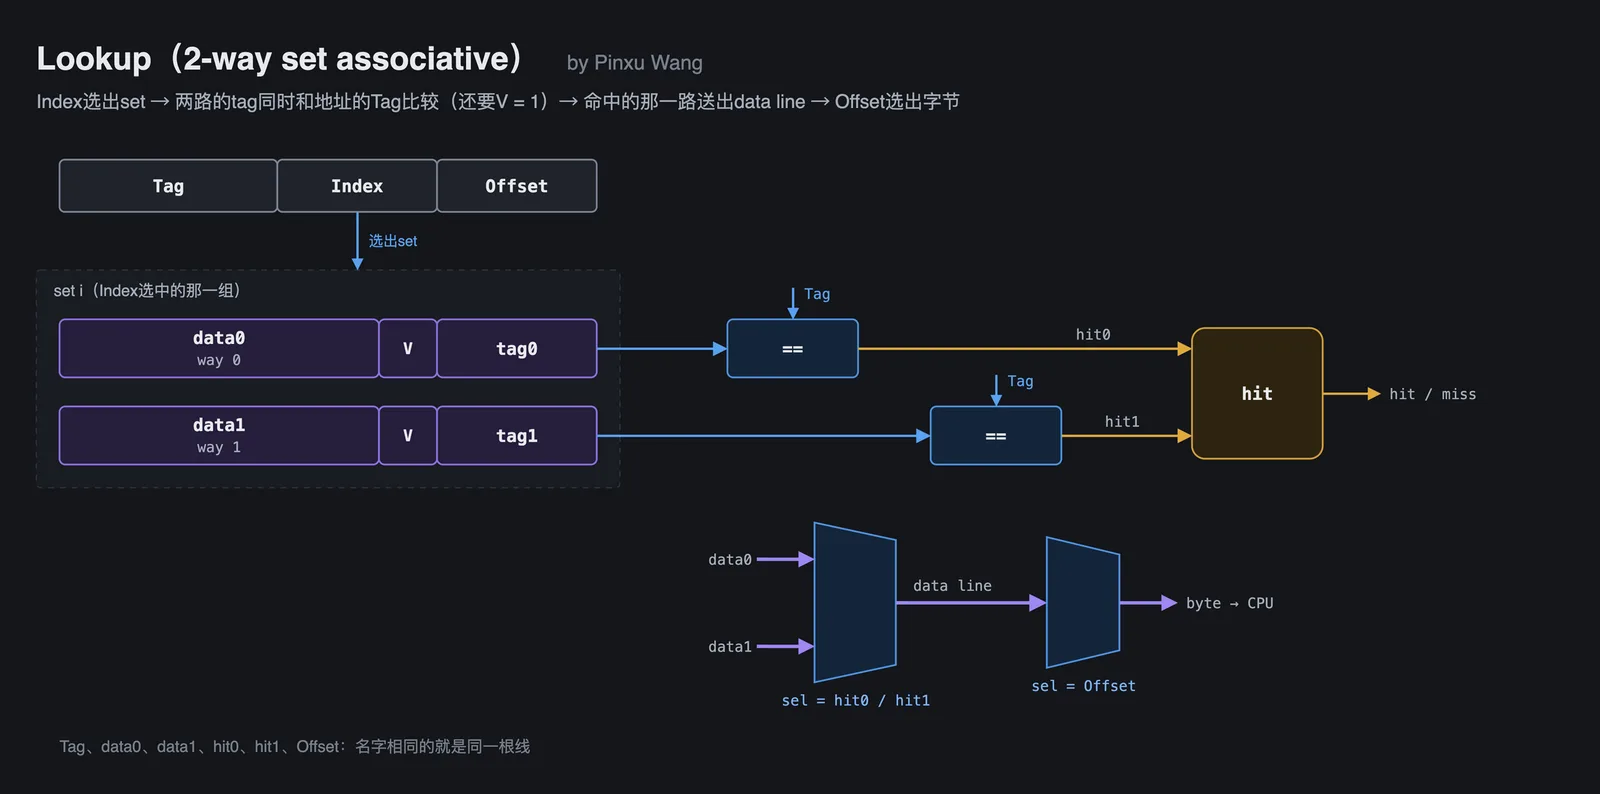
一次查找的过程(以2-way为例):
CPU访问的是内存地址,cache用Index找到cacheline,再比较tag和valid,这叫cache lookup
3. 三种Mapping对比
| Direct mapped | X-way set associative | Fully associative | |
|---|---|---|---|
| 一个地址能放的位置 | 1处 | set内X处 | 任意一处 |
| 每次查找比较几个tag | 1 | X | 全部(CAM) |
| conflict miss | 多 | 少 | 没有 |
| 硬件开销、hit time | 最小 | 中等 | 最大 |
| 需要replacement policy | 不需要 | 需要 | 需要 |
- CAM(content-addressable memory):给它一个内容(tag),它直接告诉你存在哪一项。做法是每一项配一个比较器,所有项同时比较,所以fully associative硬件开销最大,只用在很小的结构上(如TLB)
Miss的分类(3C)
| miss | 原因 | 对策 |
|---|---|---|
| compulsory miss | 第一次访问,cache里本来就没有 | 增大block size、prefetch |
| capacity miss | cache总容量装不下程序正在用的数据 | 增大cache |
| conflict miss | 总容量够,但几块挤进同一个set,互相踢掉 | 增加associativity,或增大cache |
- 分辨capacity和conflict:换成同样大小的fully associative再跑一遍,还miss就是capacity,不miss就是conflict(fully associative没有「挤在同一个set」的问题)
- 对策有代价:cache越大、way越多,hit time越长;block size太大,miss penalty和miss rate反而上升。怎么取舍见Cache性能优化
4条cacheline的direct mapped,依次访问块0 → 块4 → 块0 → 块4。块0和块4都只能放cacheline 0,cacheline 1~3一直空着(容量够):
- 第1、2次访问:compulsory miss,两块都是第一次来
- 第3、4次访问:conflict miss,块0、块4互相把对方踢掉;换成4条的fully associative,两块能同时放下,这两次都会hit
4. Tag array和data array
第2小节的cache lookup,硬件上由两块独立的存储完成,都按set组织、每个way一列:
- tag array:存tag。读出来和地址里的Tag比较,得到每个way的hit
- data array:存数据。读出来经过mux,由hit和Offset选出要的那几个字节
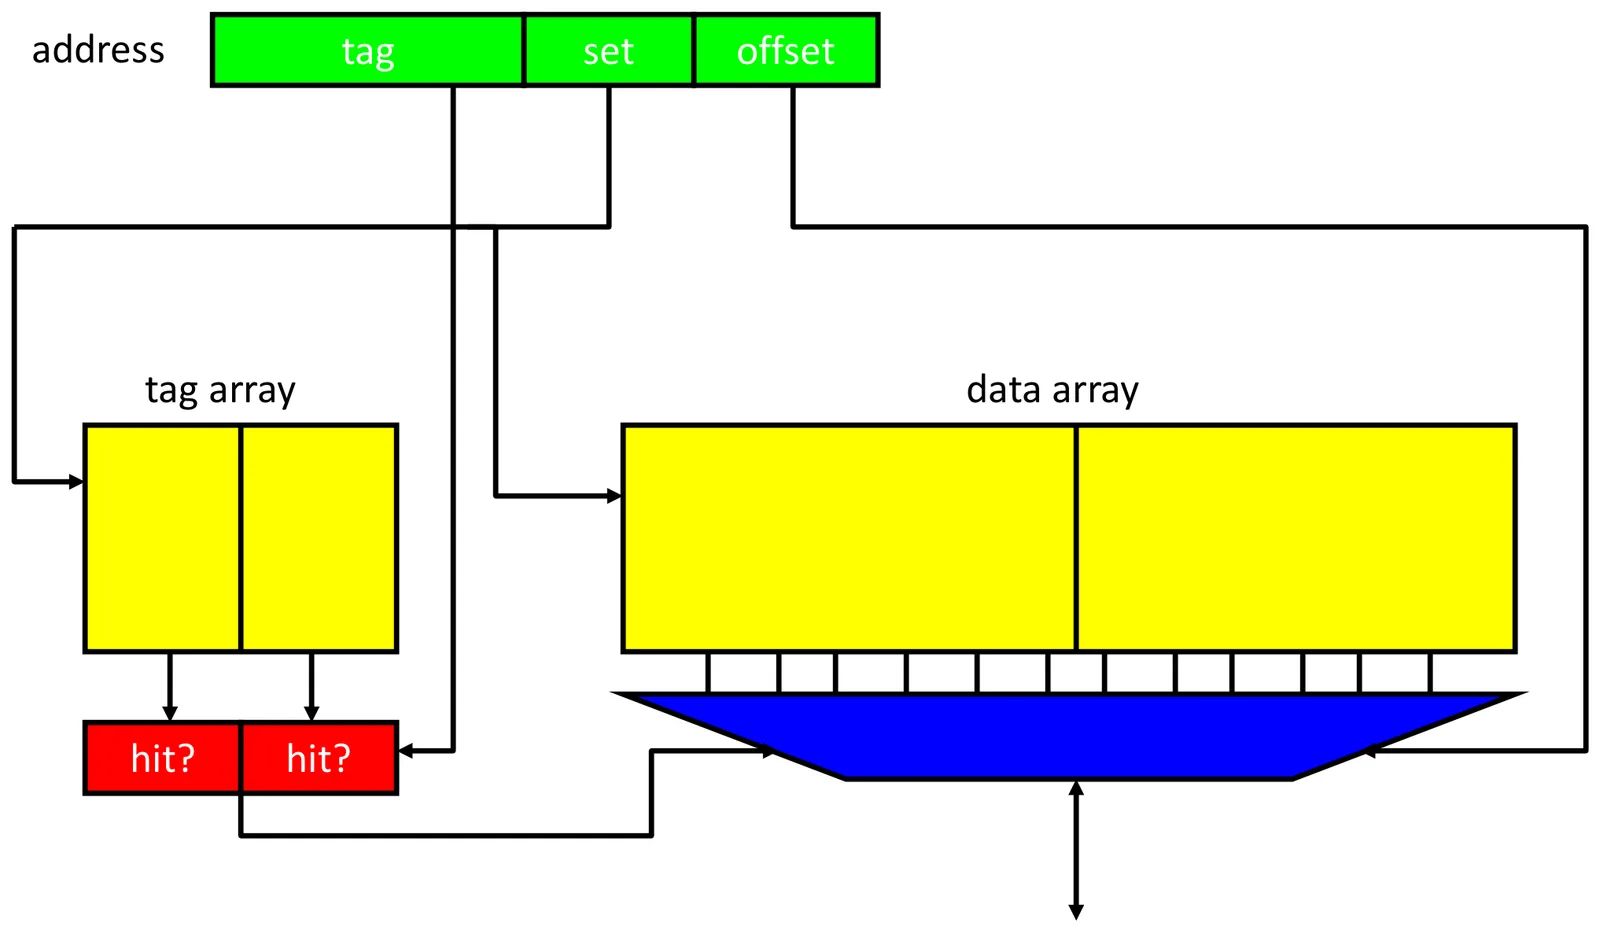
两块分开放,tag array小、读得快,hit / miss能先算出来。两块怎么配合着读(并行读还是串行读),见Cache性能优化。
参考
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed.
- Wikipedia, CPU cache
Discussion
Loading comments…
Checking sign-in…