接上篇:上篇讲了cache的结构和地址划分(Tag、Index、Offset),这一篇讲cache怎么读写、set满了换掉哪一条,以及多份副本怎么保持一致。
一、Read / Write 策略
Read / Write策略回答三个互相独立的问题:
| 问题 | 两种选择 | 小节 |
|---|---|---|
| read miss时,要不要把块装进cache? | read allocate / read no-allocate | 2. Read miss |
| 写的时候,要不要同时更新DDR? | write-through / write-back | 3. Write hit |
| write miss时,要不要把块装进cache? | write allocate / write no-allocate | 4. Write miss |
1. Read hit
直接把数据返回给CPU。
2. Read miss
① CPU在cache里没找到(miss)→ ② 去DDR读出整条cacheline。DDR返回的数据给谁,有两种做法:
- read allocate:同时交给CPU、写进cache。下次再读就hit。几乎都用这种
- read no-allocate:只交给CPU,不进cache。(很少用)
3. Write hit
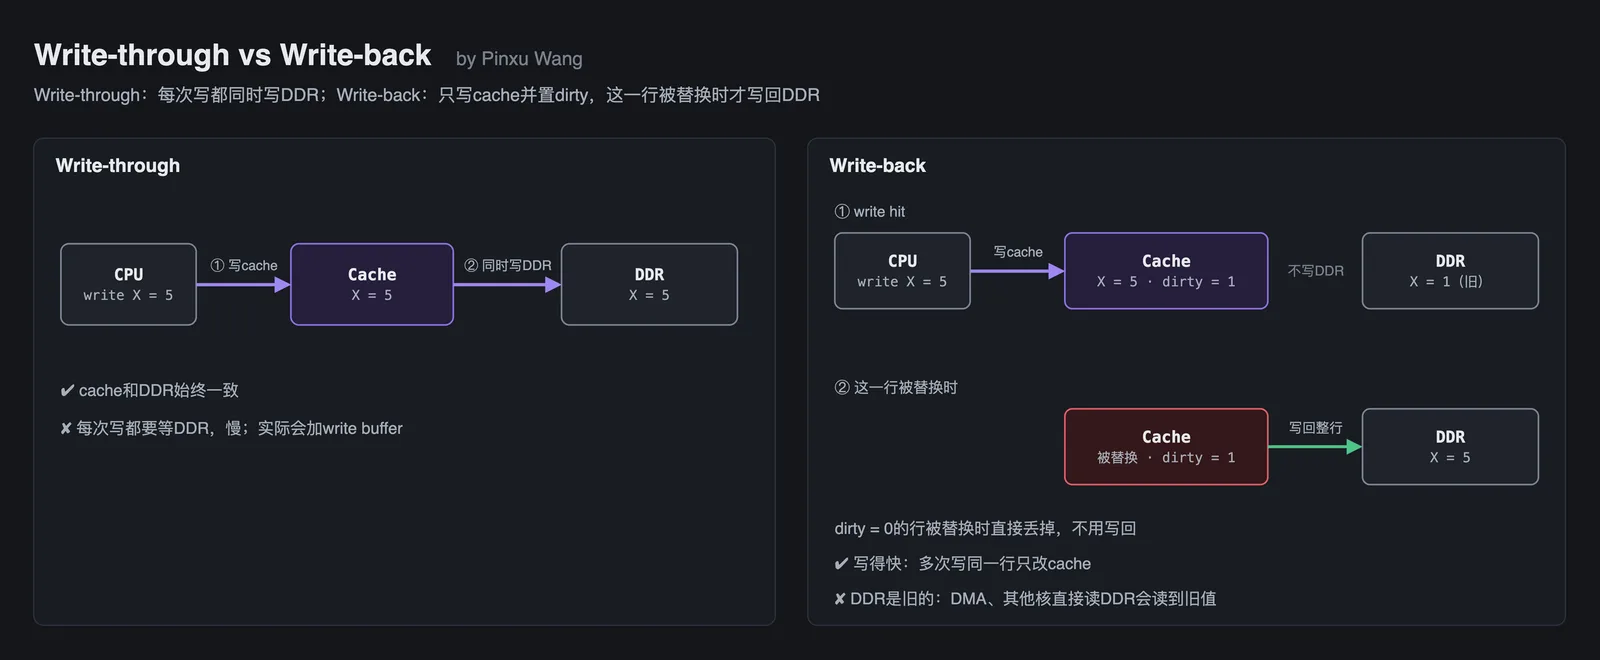
(1) Write-through
CPU写cache的同时也写DDR:
CPU → cache → DDR
- 优点:cache和DDR始终一致,实现简单
- 缺点:每次都要访问DDR,latency大。
- 实际设计会加write buffer:CPU写进buffer就继续往下执行,buffer再慢慢写DDR
(2) Write-back
CPU只写cache,不写DDR,所以写得快。这时cache里的数据比DDR新:
- 被写过的cacheline置dirty bit,表示「这一cacheline比DDR新」。
- 什么时候写回DDR:这一行被evict时。
- evict是把一条cacheline从cache里踢出去,给新的cacheline腾位置。它不等于cache满:只有miss了、而且新数据要放的那个set里没有空位,才需要踢走一条;有空位就直接放进去,不用evict
- 如果dirty = 1,先把整行写回DDR,再装入新行;dirty = 0说明和DDR一样,直接丢掉
- 缺点:
- cache小、evict频繁时,dirty行写回的次数多;一次miss可能要「先写回旧行、再读入新行」,miss penalty变大
- DDR里的数据是旧的,别的core或DMA直接读DDR会读到旧值,见第三节
- 写策略:CPU写的时候只写cache,把dirty置1,不访问DDR
- 写回动作:这一行被evict时,dirty = 1才把整行写回DDR
write hit时发生的是前者;只有evict才会触发后者。
两种策略放在一起看:
4. Write miss
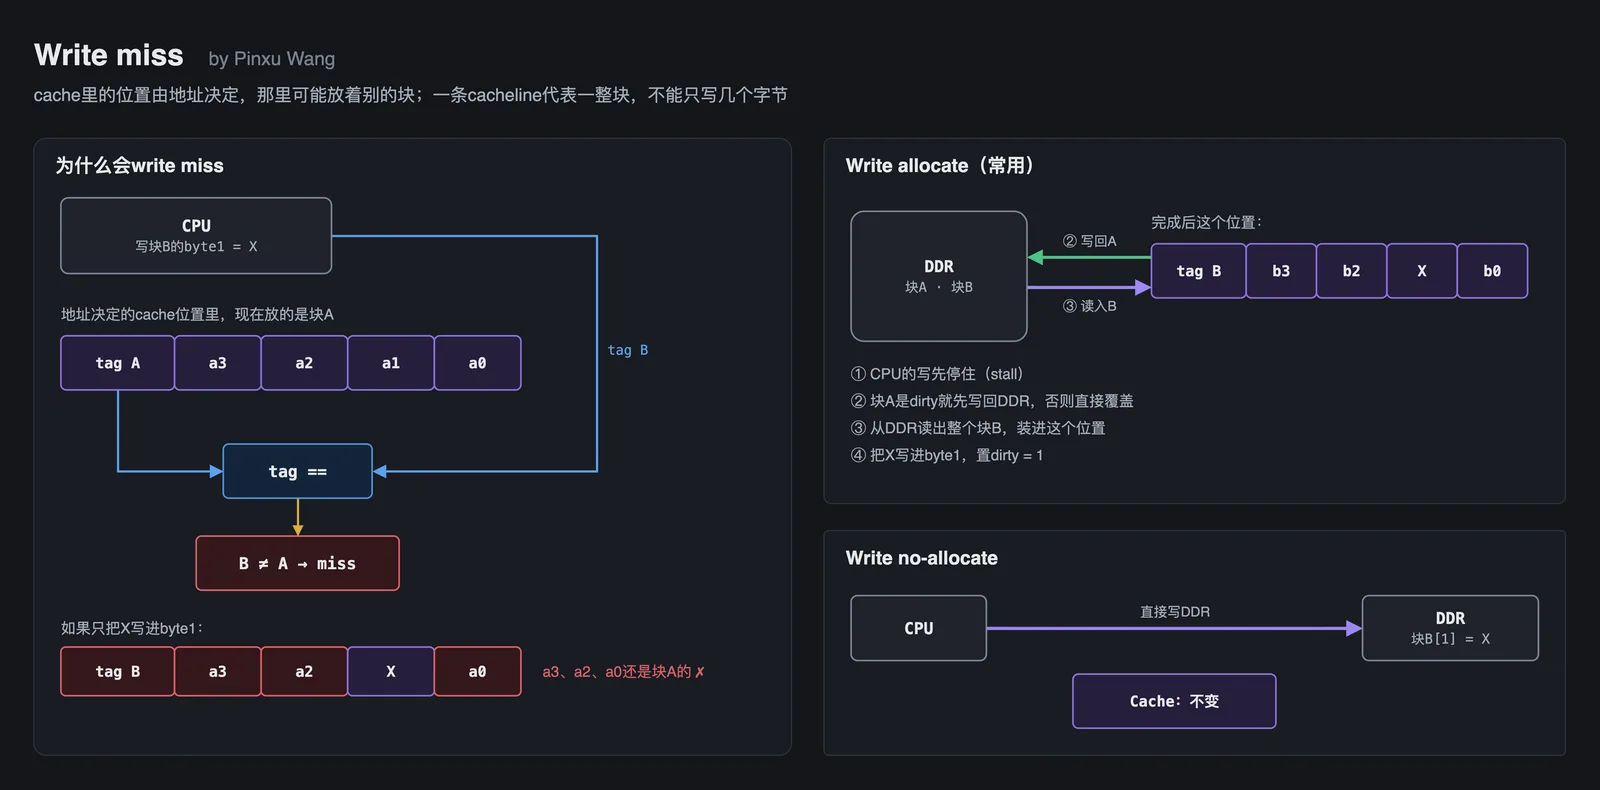
CPU要写的地址,所在的那一块不在cache里,就是write miss(见上篇第一章第5小节的callout)。这时不能只把要写的几个字节写进cache:一条cacheline只有一个tag,改成新块的tag后,这一行里其余的字节还是旧块的数据,读出来就错了(图左)。所以只有两种处理:
- write allocate:先把整块读进cache,再按write hit处理(步骤见图右上)
- write no-allocate:不进cache,直接写DDR
5. 常见组合
- write-back + write allocate + read allocate:最常用。write allocate把整行装进来,之后对这一行的写都在cache里完成,配合write-back最省DDR bandwidth
- 前提是temporal locality:写过的块很快还会被访问。只写一次就不再用的数据(比如一次性清零一大块内存),allocate反而白读一整行,还会挤掉有用的cacheline
- write-through + write no-allocate:反正每次写都要到DDR,write miss时再把整行装进cache意义不大
6. 用状态机实现
cache的控制逻辑是一个状态机。write-back + write allocate的cache,常见的写法有4个状态:
- IDLE:等CPU的请求,来了就去HIT
- HIT:比较tag(进了这个状态不一定真的hit)。hit:读就返回数据,写就写进cache,回到IDLE;miss:要换掉的那一行是dirty就去WRITEBACK,否则去ALLOCATE
- WRITEBACK:把dirty的那一行写回下一级,写完去ALLOCATE
- ALLOCATE:从下一级读入新的一行,写进cache,回到HIT再比较一次,这次一定hit
二、Cache 替换策略
miss时,如果对应的set已经满了,要在set里挑一条cacheline换出去,这一条叫victim,踢出哪一条就是Cache替换策略研究的东西
1. Random
随机选一条。实现最简单,不利用locality。
2. FIFO
使用FIFO来记录Set内cacheline的替换情况,先进先出:换掉最早装进来的那一条。它只看装入的先后,不管最近有没有被访问
- 缺点:装得早、但一直在用的cacheline也会被换掉
3. LRU(Least Recently Used)
替换最久没有被访问的一条cacheline,利用的是temporal locality。可以想成一个stack:
- 当访问到达当前cache set内发现所有的cacheline都是Valid状态,查询距离当前时间节点之前的cacheline的状态
初始(top → bottom):④ ③ ② ①
访问②:②挪到top → ② ④ ③ ①
miss、要腾位置:evict bottom的①
- 缺点:way多时(一个set里cacheline的数量)硬件开销大。要记住set内所有行的完整先后顺序,每次访问都要更新整个顺序。所以实际常用PLRU来近似
4. Tree-PLRU(pseudo-LRU)
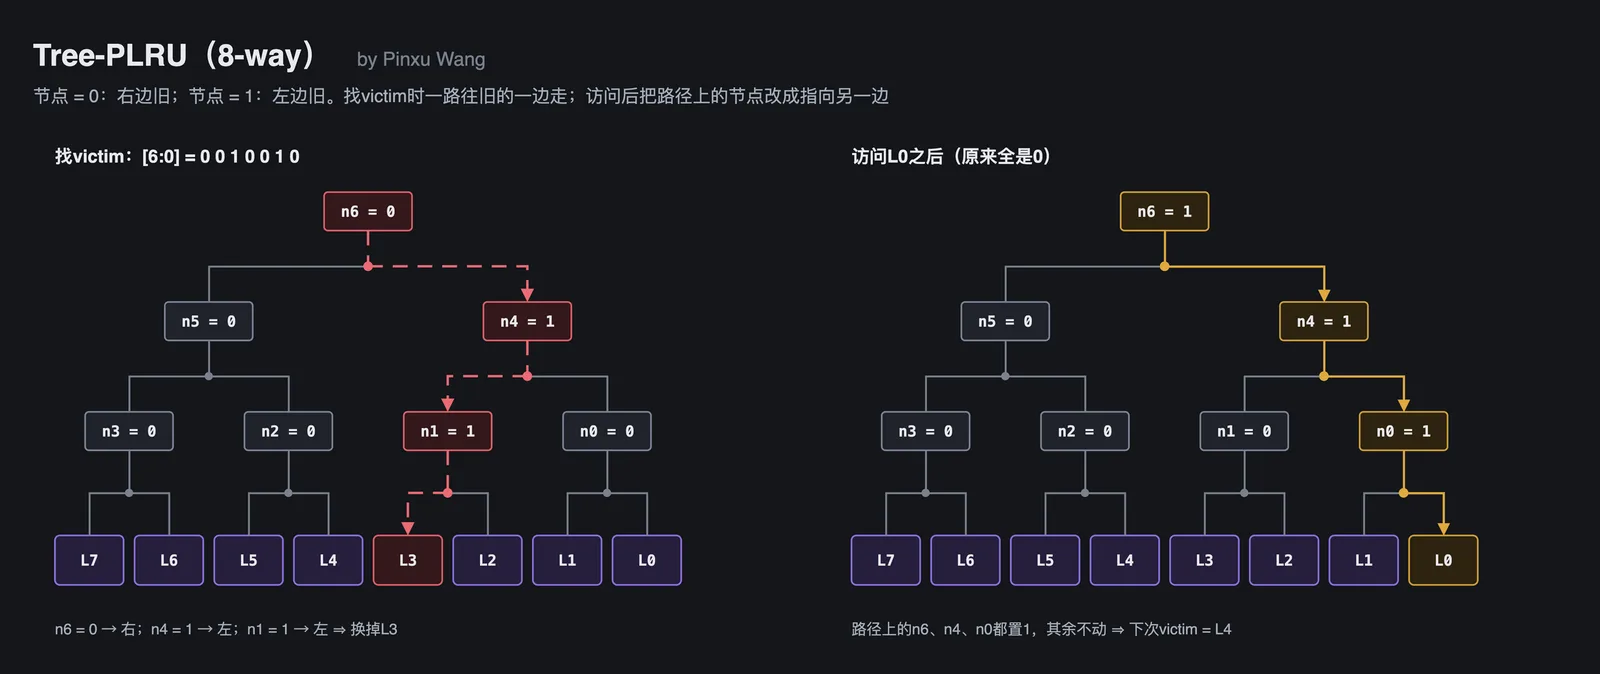
用一棵binary tree近似LRU:N-way需要N-1个node,每个node 1位。8-way要7位[6:0],4-way要3位。每个set存一份这些位;它们上电时要清零,所以一般用flip-flop实现,不放进SRAM。
(1) Node编号
8-way时一个set里有8个cacheline:
                 n6
          /             \
        n5               n4
      /    \           /    \
    n3      n2       n1      n0
   /  \    /  \     /  \    /  \
L7 L6 L5 L4 L3 L2 L1 L0node数量=一个set里的cacheline数-1 (PLRU Tree变量数据位宽)
- node 6管理cacheline7-4和3-0
- node 5管理cacheline7-6和5-4
每个node记录它下面「哪一边更旧」:
- node = 0:右侧是旧的cacheline(右旧)
- node = 1:左侧是旧的cacheline(左旧)
| 路径上的node:{最高层, 中间层, 最底层} | PLRU树认为最老的cacheline |
|---|---|
| 000:右右右 | 0 |
| 001:右右左 | 1 |
| 010:右左右 | 2 |
| 011:右左左 | 3 |
| 100:左右右 | 4 |
| 101:左右左 | 5 |
| 110:左左右 | 6 |
| 111:左左左 | 7 |
(2) 访问后更新
假设在程序运行某一时刻,PLRU tree的值[6:0]= 0_00_0000(代表cacheline 0 是最老的)
- 此时访问cacheline 0 ,下一周期PLRU值更新:cacheline 0的关联节点全部改成指向另一边,不是取反。cacheline 0在它们的右侧,即bit0、4、6置为1 —— 1_01_0001(此时cacheline 4 最旧)
(3) 4-way查表
4-way只有3个node:n2管理cacheline 3-2和1-0,n1管理3和2,n0管理1和0。规则同上,整理成一张表:
| cacheline | 访问后(n2 n1 n0) | 选它当victim的条件(n2 n1 n0) |
|---|---|---|
| 3 | 0 0 - | 1 1 X |
| 2 | 0 1 - | 1 0 X |
| 1 | 1 - 0 | 0 X 1 |
| 0 | 1 - 1 | 0 X 0 |
-:不变;X:不用看。两列正好相反:刚访问过的那条,下一次一定不会被选中。
(4) PLRU的缺点
PLRU只记了每个分叉「哪边更旧」,没有记完整顺序,所以选出来的不一定是真正最久没用的那一条,但一定不是刚刚访问过的那一条。
4-way的一个set,依次访问cacheline 1 → 0 → 3 → 2 → 3 → 1,之后要替换一条:
- LRU:最久没访问的是cacheline 0,换0
- PLRU:最后访问的1在右半边,n2 = 1(左旧);左半边里3比2后访问,n1 = 0(右旧)—— 换cacheline 2
两者选的不一样:PLRU只知道右半边刚用过,就去左半边挑;其实右半边里的cacheline 0才是最久没用的。
程序若一直访问一个左侧7-4 cacheline,突然访问一次右侧cacheline。下一次node会更新为左侧为老,会踢出左侧的一条cacheline。虽然存在此缺点,但仍然是替换策略的最优选之一
5. NMRU(Not Most Recently Used)
每个set只记录最近访问的是哪一条,替换时从其余几条里随机选一条。利用的是temporal locality:刚访问过的那条最可能马上再用,先保住它。命中率和硬件开销都介于Random和LRU之间。
- 缺点:其余几条之间不分先后,可能换掉一条马上要用的
6. 例子:一串读写走一遍
把前面几章串起来:cache 16字节、cacheline 4字节、2-way set associative(2个set);地址5位,拆成Tag = ADDR[4:3]、Index = ADDR[2]、Offset = ADDR[1:0];write-back + read / write allocate,交替替换。
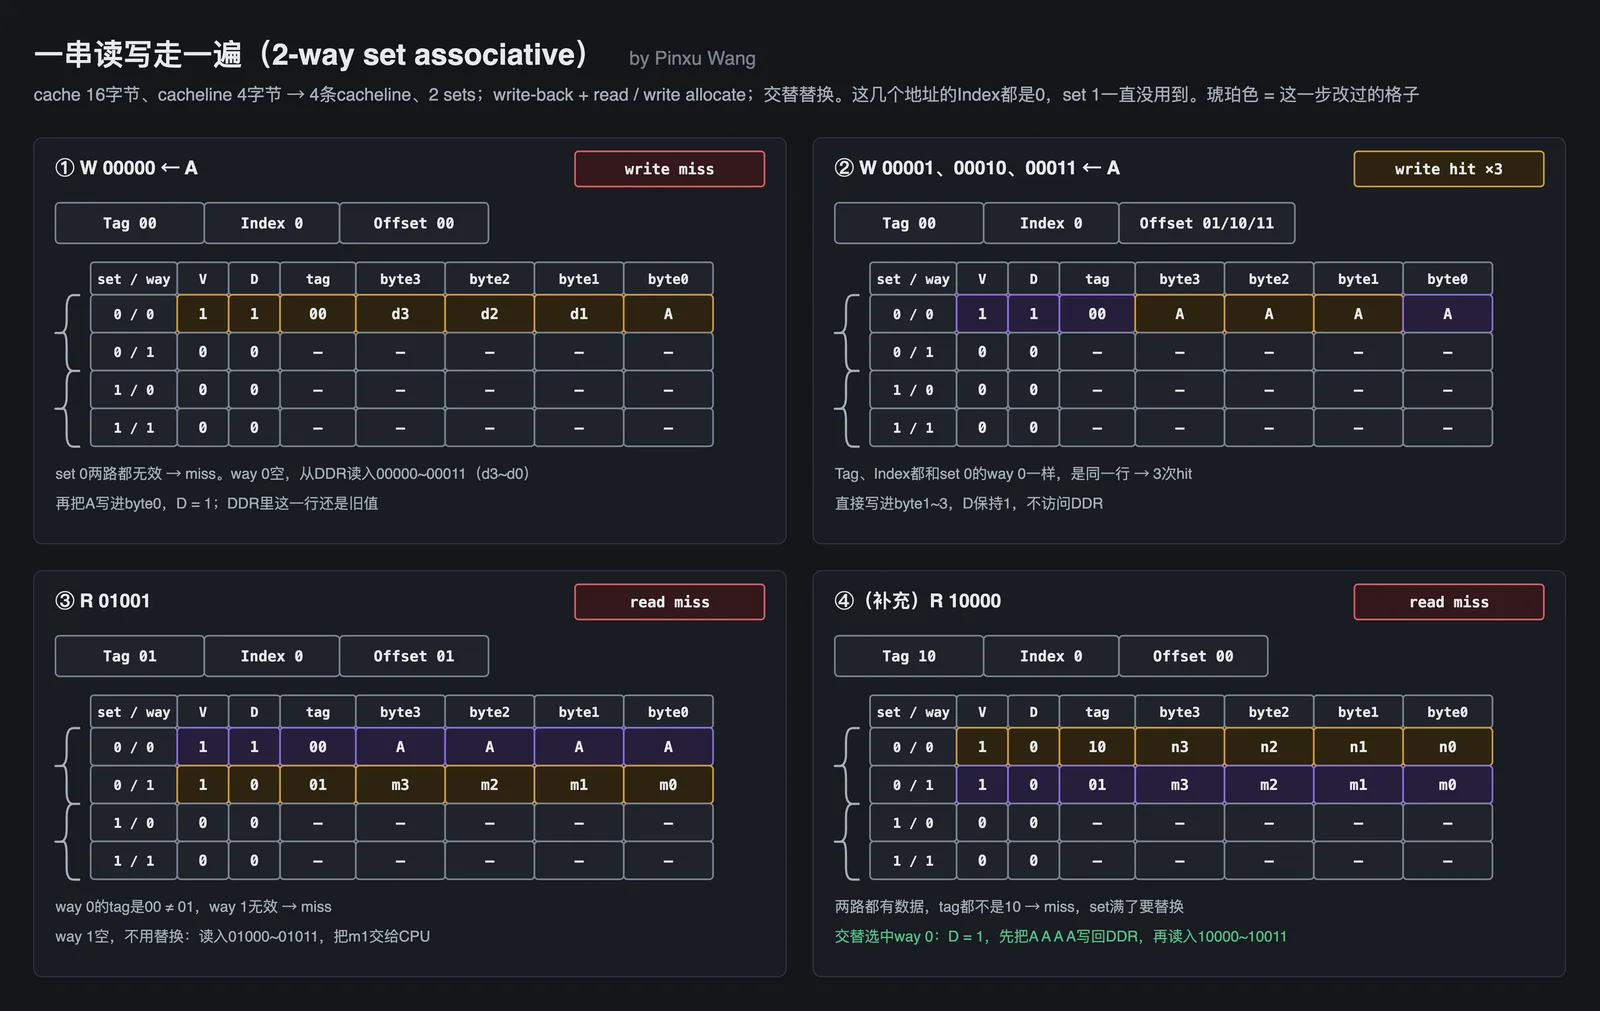
④R 10000:Tag 10、Index 0。两路都有数据,tag都对不上,set满了,这时才evict。交替选中way 0,它D = 1,先把A A A A写回DDR,再读入10000~10011
三、Coherence
1. 为什么会不一致
同一份数据在好几个地方有副本,一处改了,别处没跟上:
- write-back cache:数据只改在cache里,DDR里是旧的
- 多核:每个core有private L1,共享L2。两个core的L1里可能都有同一行,一个core改了它,另一个core读到的还是自己L1里的旧值
- DMA等外设:直接读写DDR,不经过cache
2. 软件维护:flush和invalidate
- flush(有的架构叫clean):把dirty的cacheline写回下一级,让下一级的数据变成最新
- invalidate:把cacheline的valid bit清0,下次访问就重新从下一级取
典型用法:
- CPU准备好一块数据,交给DMA发出去:先flush,确保DDR里是最新的
- DMA把数据写进DDR,CPU要读:先invalidate,避免读到cache里的旧副本
3. 硬件维护:Cache Coherence Protocol
多核之间一般由硬件自动维护,常见两种做法:
- snooping:每个cache都监听bus上其他core的读写,发现别人要改自己也有的行,就把自己那份invalidate
- directory:用一张directory记录每一行在哪些core里有副本,只通知相关的core。core多时比snooping省bandwidth
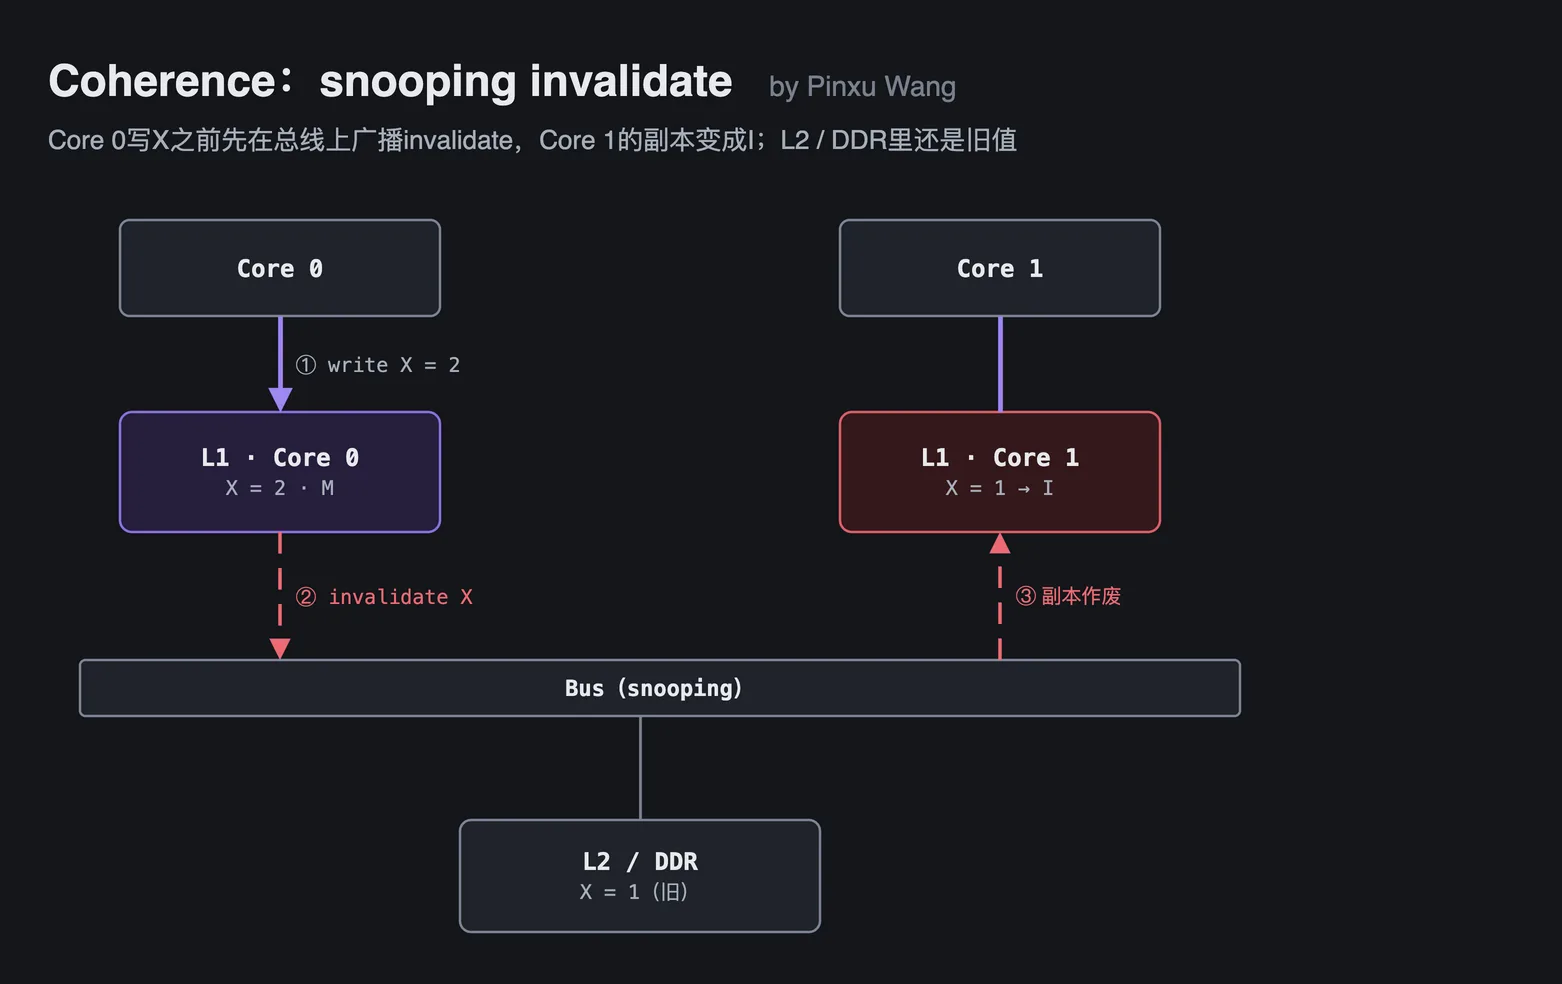
最常见的协议是MESI,每条cacheline处于4种状态之一:
| 状态 | 含义 |
|---|---|
| M(Modified) | 只有本core有,而且改过(dirty),DDR里是旧的 |
| E(Exclusive) | 只有本core有,和DDR一致 |
| S(Shared) | 多个core都有,和DDR一致 |
| I(Invalid) | 无效 |
核心规则:一个core要写某一行,先让其他core里这一行的副本都变成I,所以同一时刻只有一个core能改这一行。
参考
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed.
- Wikipedia, CPU cache
Discussion
Loading comments…
Checking sign-in…