随便的笔记
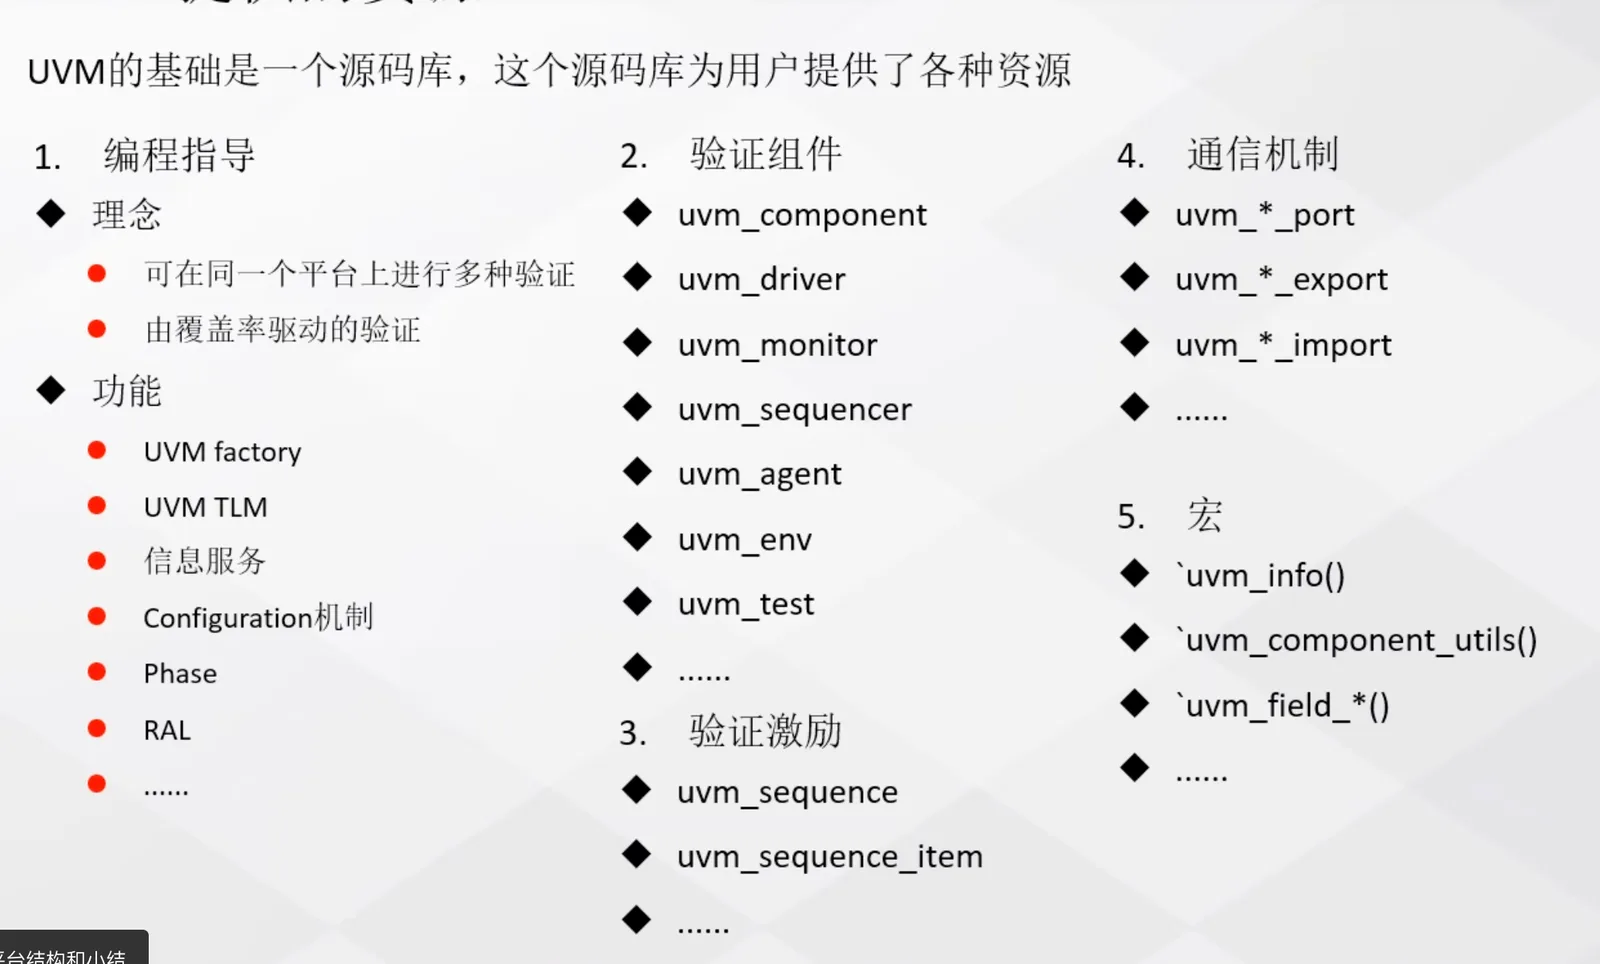
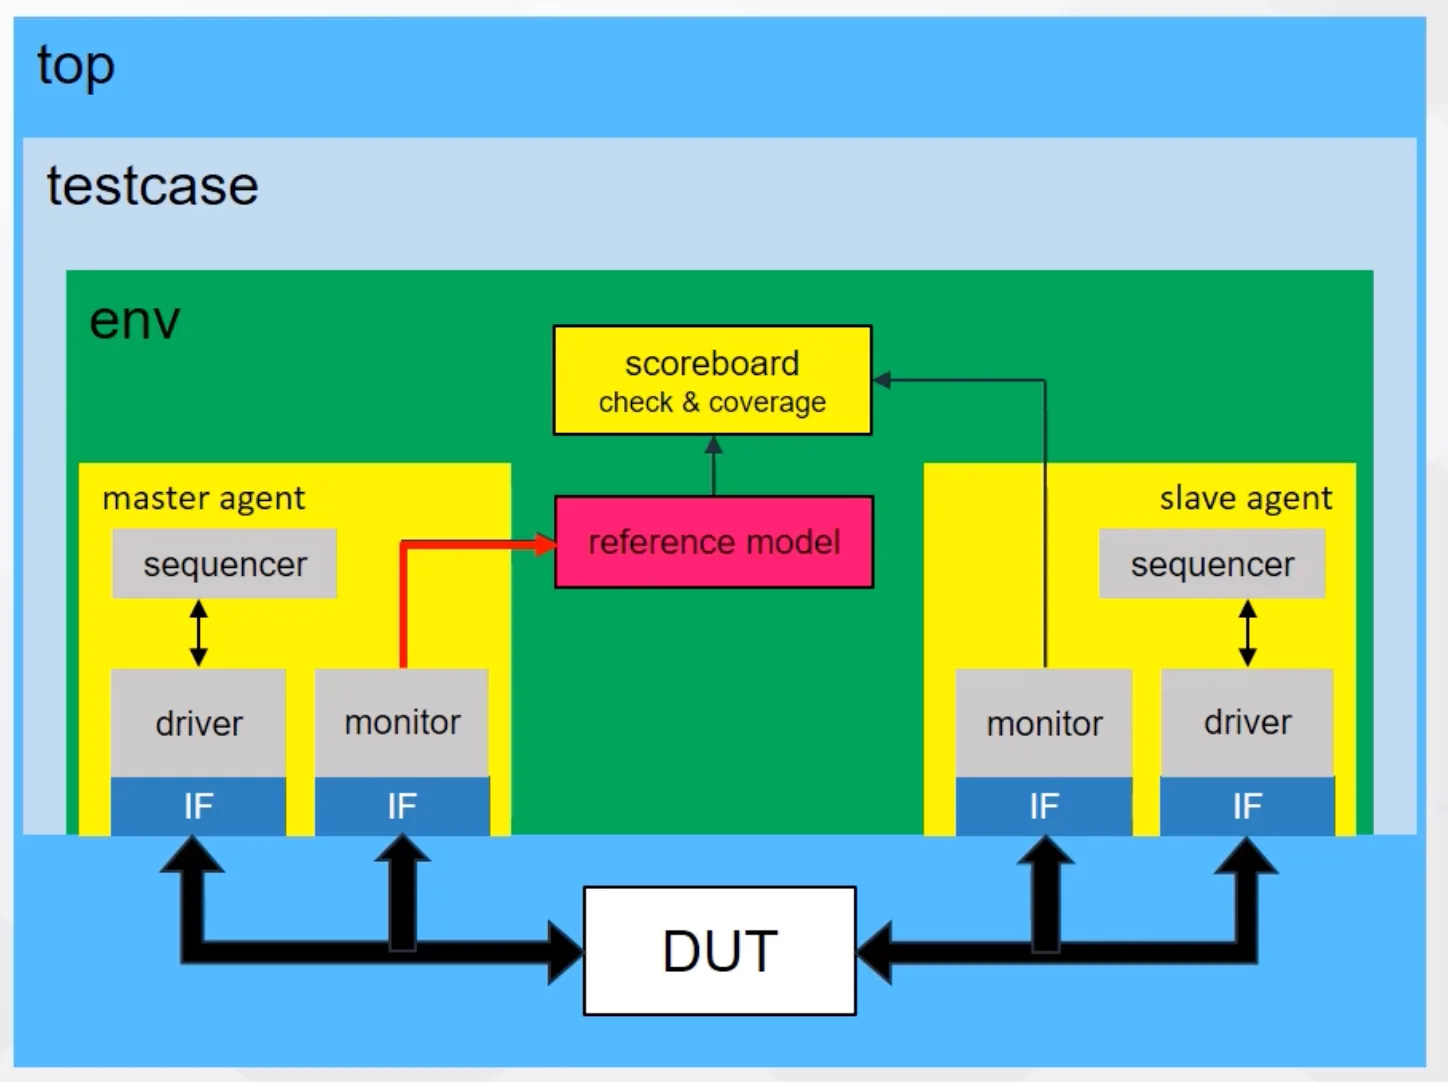
UVM验证环境: 最高层次环境:testtop 是静态的模块级代码(module、initial、force、assert),负责把DUT接起来;env/ 是动态的类(class,UVM对象),负责发激励、比对、收覆盖率。两者靠 virtual interface 连接。
UVM总览
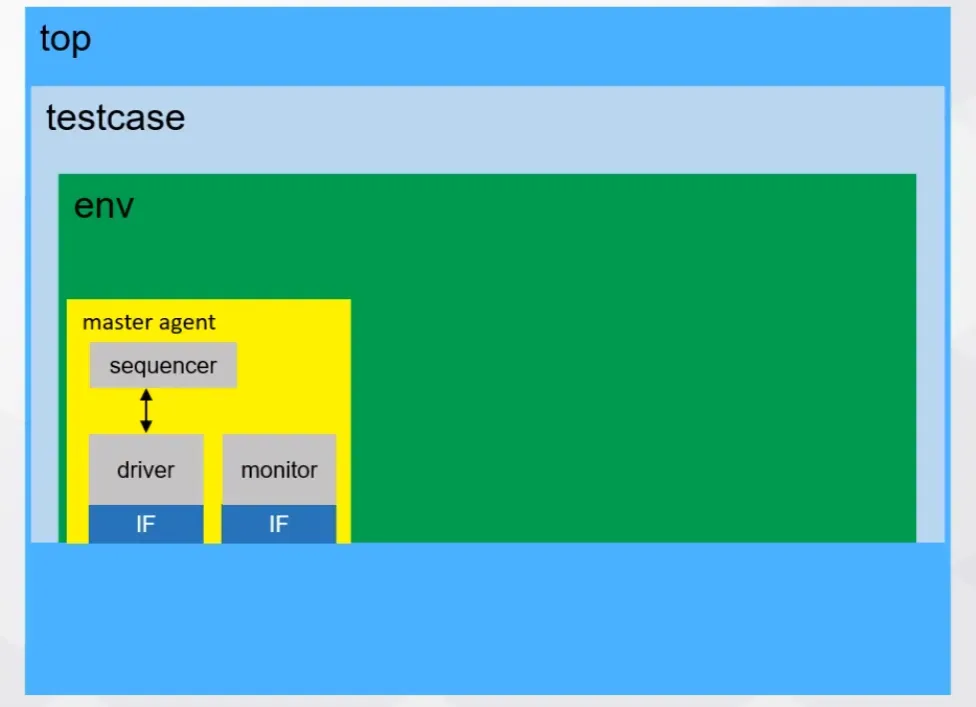
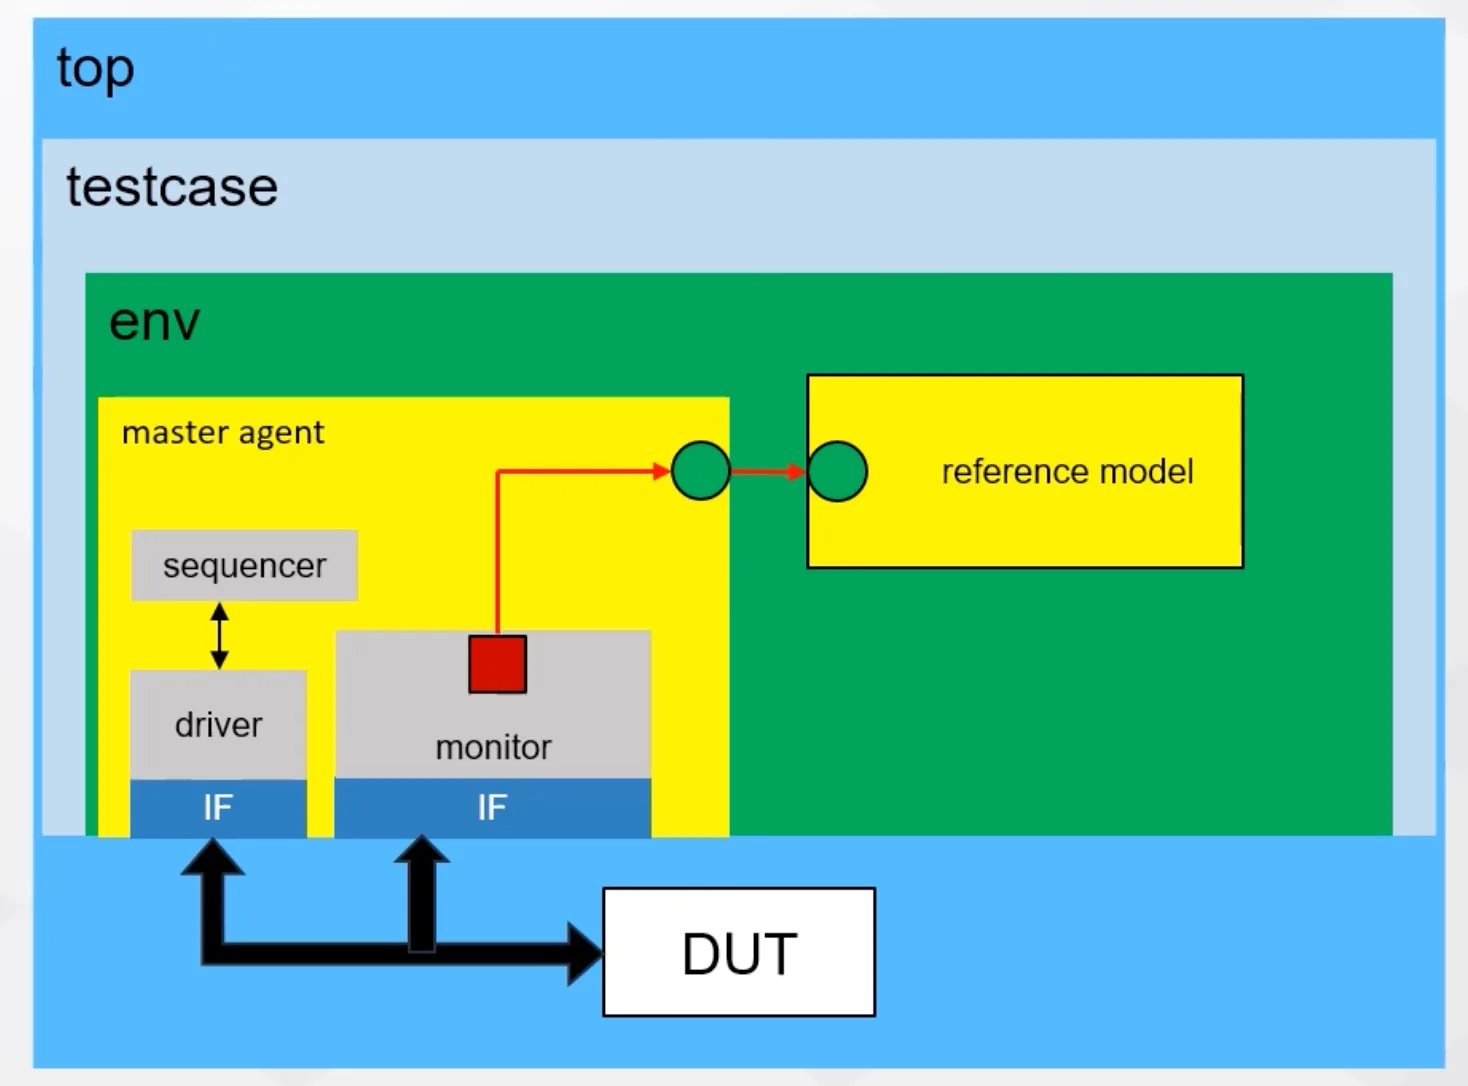
UVM框图
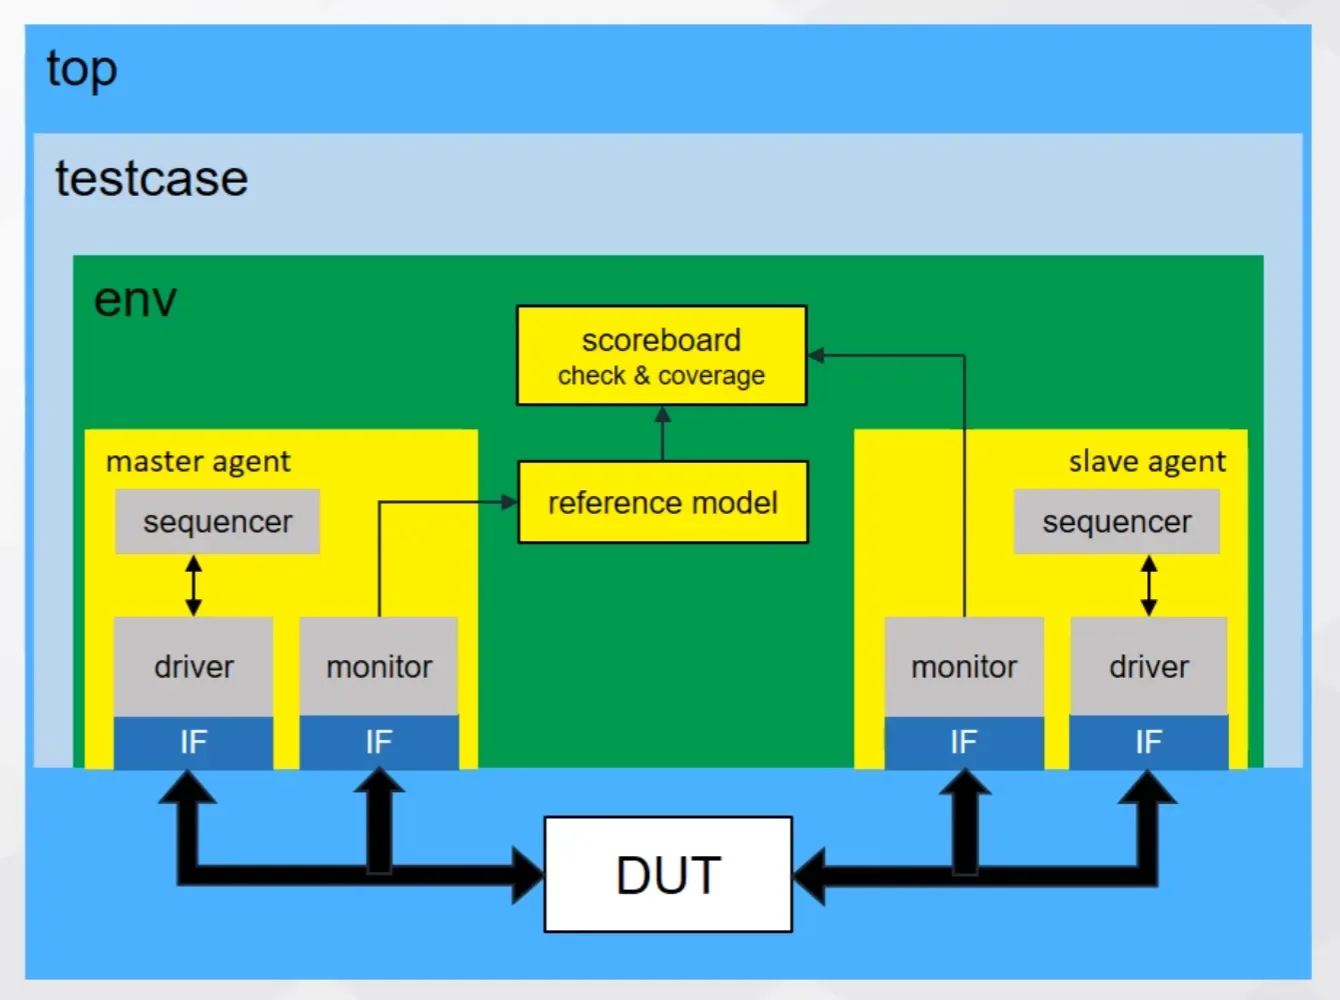
注:
- 没有sequencer和driver的agent称为passive agent
- env- 可包含多个agent、reference model、scoreboard以及其他连接组件和配置组件,因为这些组件互相之间存在通信
在实际项目中,Testcase会有很多,但是env只有一个,一旦确定就不能随意更改
对整个平台的配置是在testcase中完成的,所以env是需设计成可配置的
多个模块存在的UVM环境
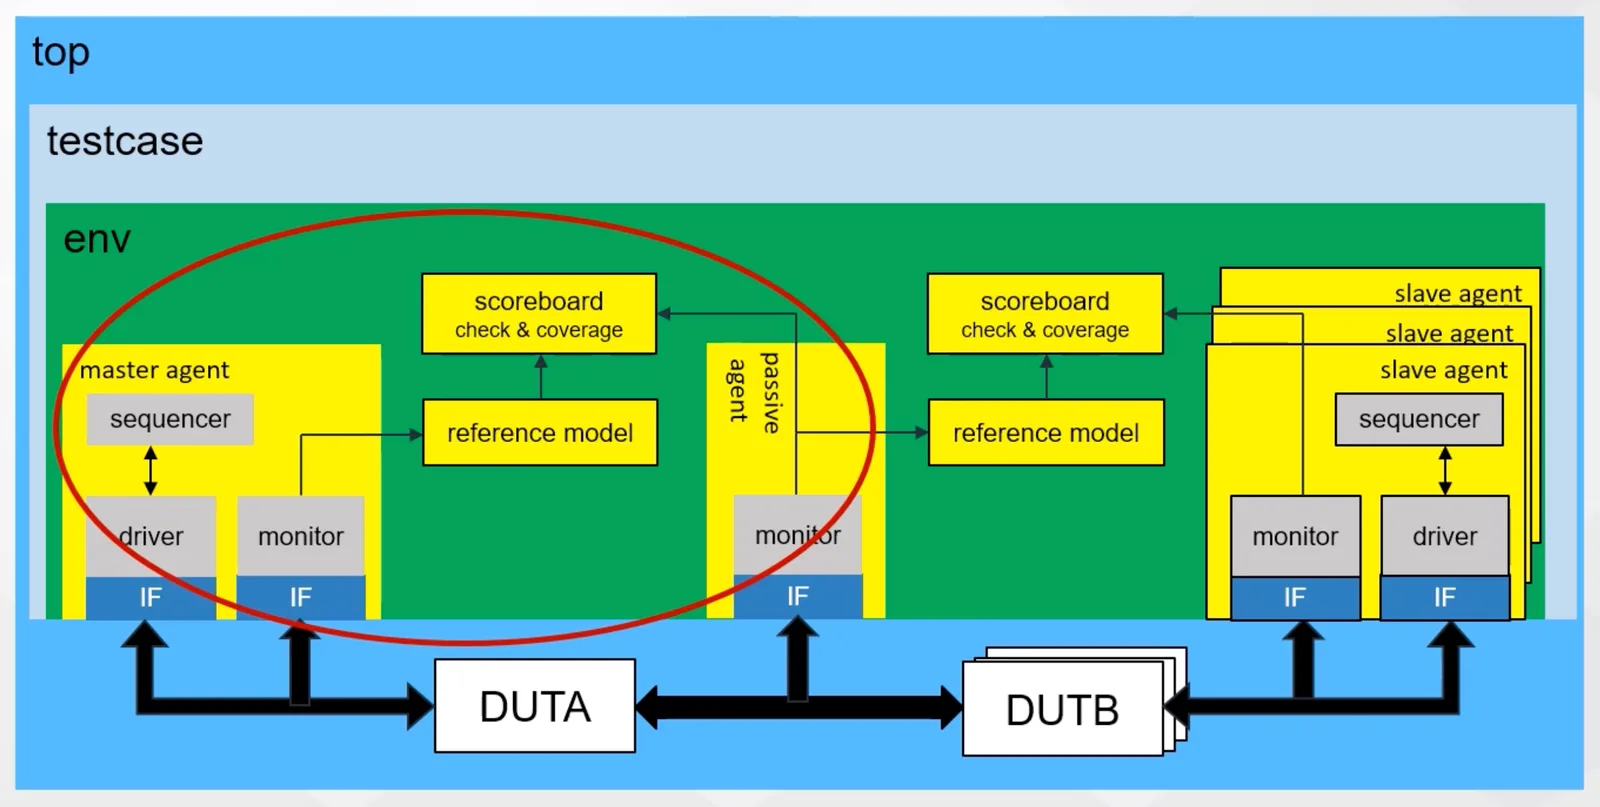
多个DUT对应多个slave agent
构成UVM平台的组件
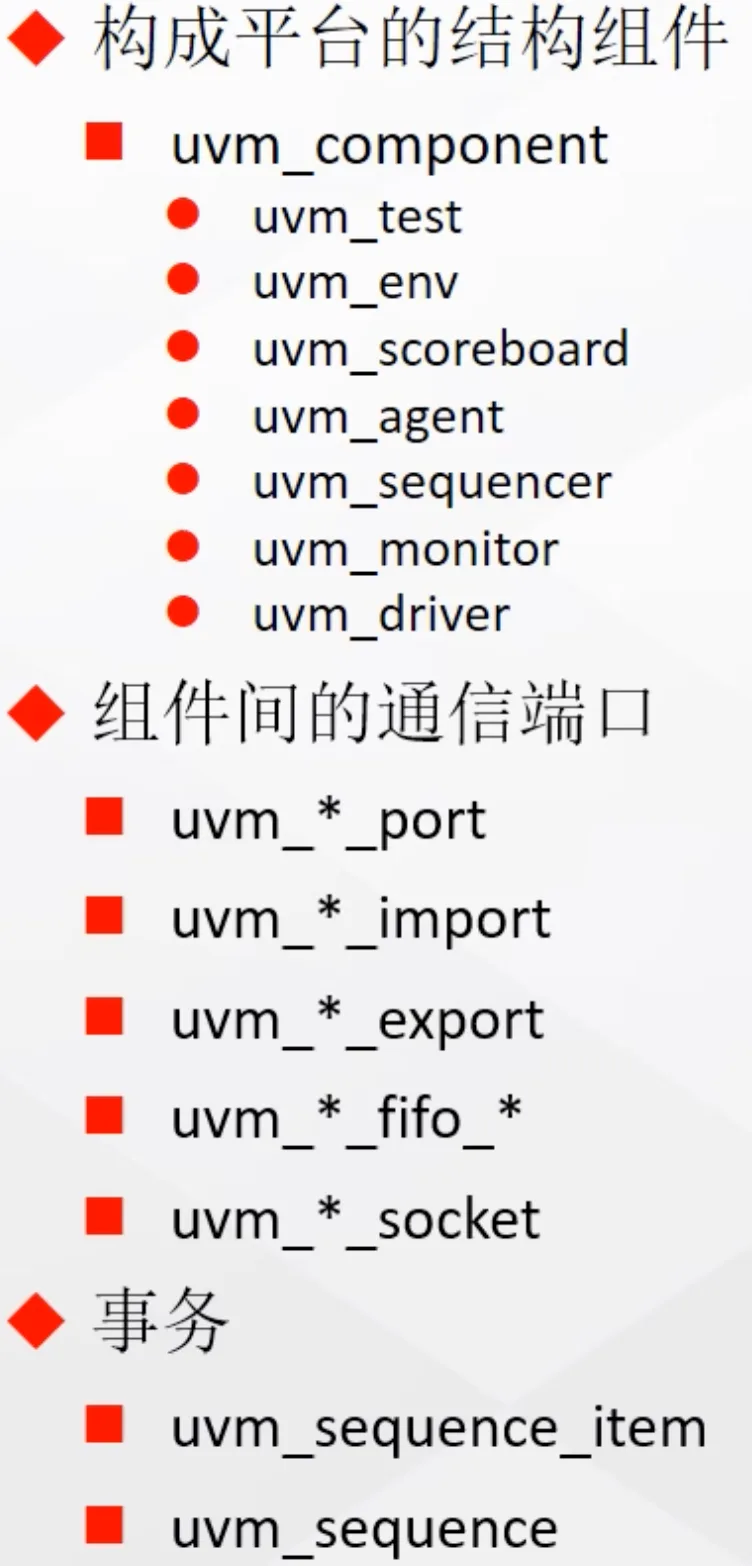
注意reference model继承自uvm_component
1.简化UVM平台
产生事务,并将其发送到driver上
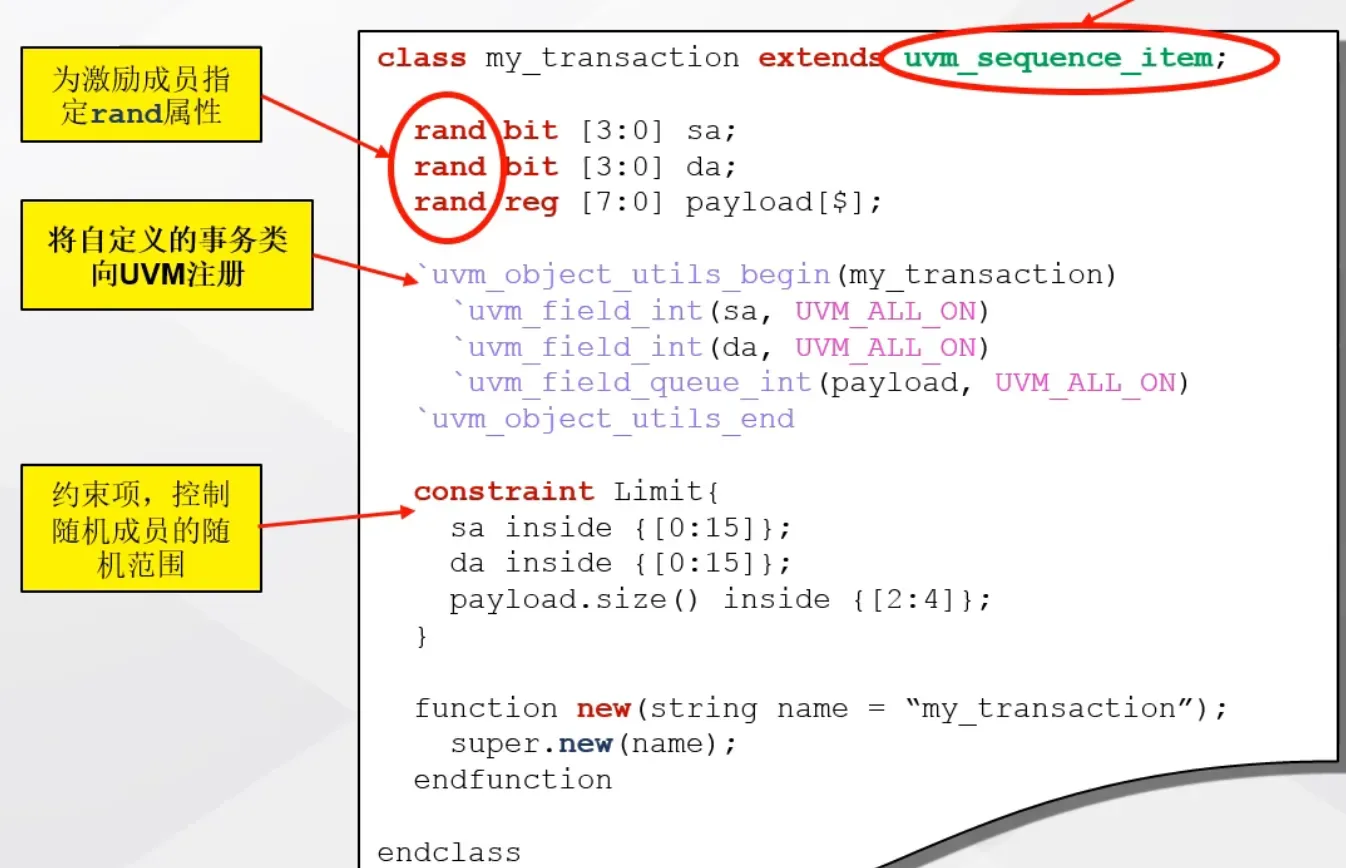
1.1 创建Transaction
- Transaction 是穿梭于各组件之间的基本信息单元,是一种数据对象。也就是事务对象。
- Transaction 的基类是 uvm_sequence_item
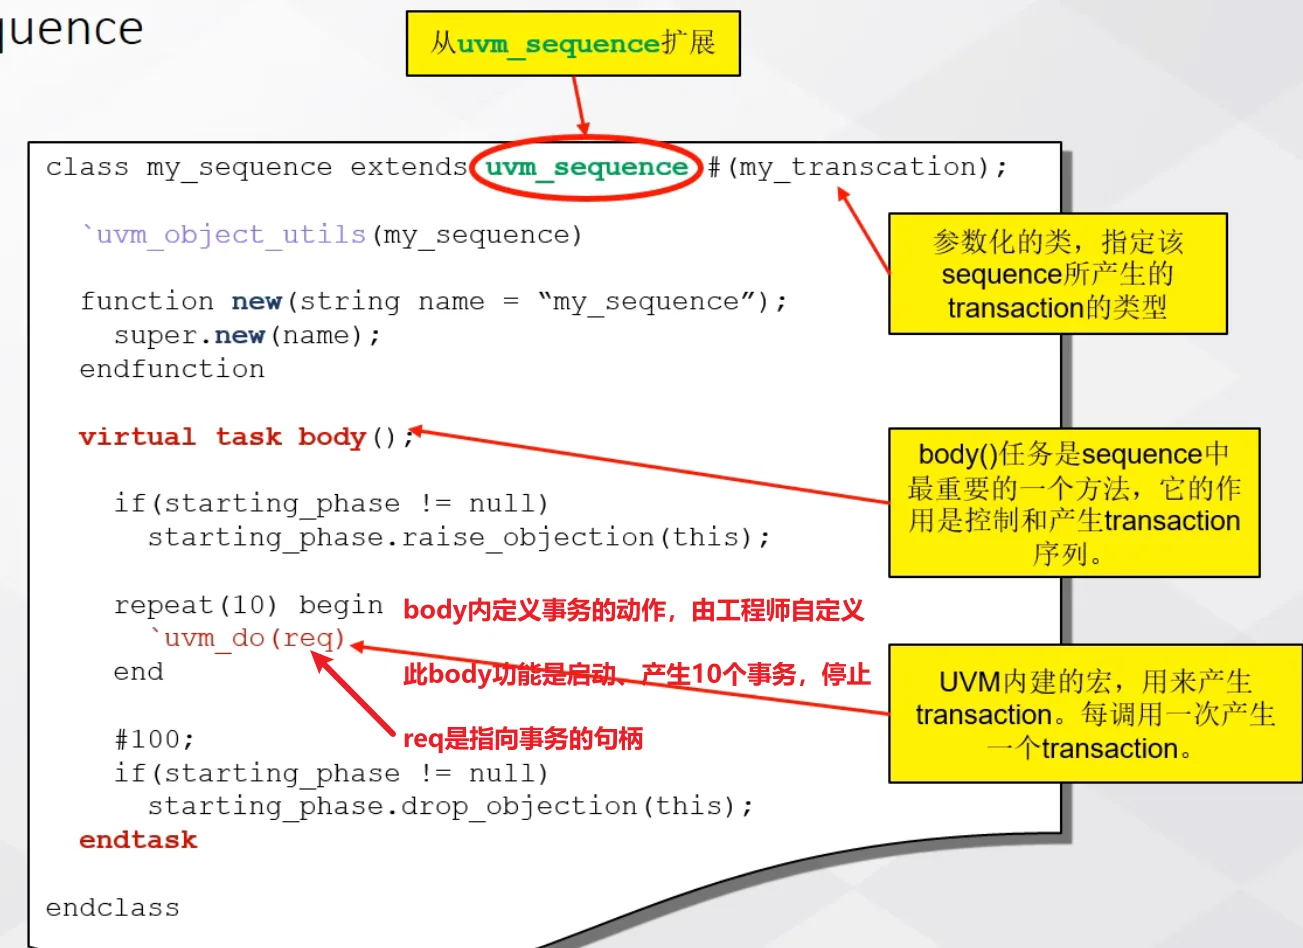
1.2 创建sequence
sequence也可以理解为事物发生器
- 基类是 uvm_sequence - sequence 控制并产生一系列 transaction
- 一种sequence一般只用来产生一种类型的transaction
- 在继承基类的时候,需要给定一个参数,这个参数是一个 transaction
- sequence中最重要的部分是
body()任务- 可以将sequence理解为管理和存储一系列事务的仓库
1.3 创建sequencer
从UVM的平台结构上看,sequence_item和sequence并不属于结构的一部分。它们其实是流动在这些组件中的数据流。 uvm_sequencer的作用:
- 启动sequence
- 将sequence产生的item发送到UVM的组件中
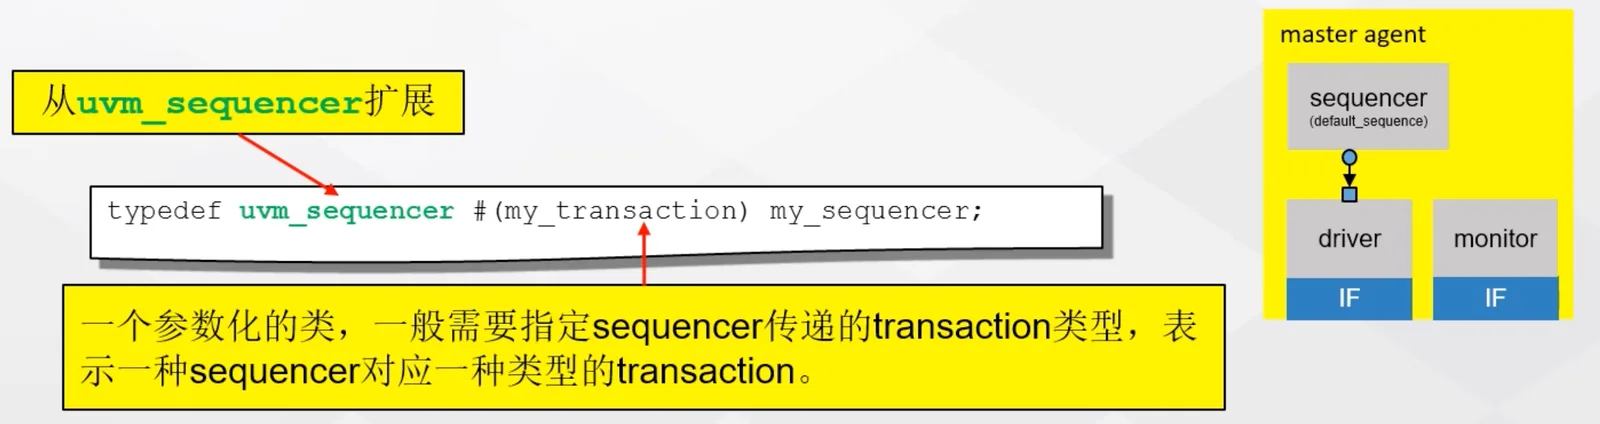
sequencer的功能大多数已经在UVM源码中实现,所以创建sequencer的工作是比较简单的。 直接用 typedef 即可,因为 uvm 已经写好了大部分代码。
1.3.1 phase机制
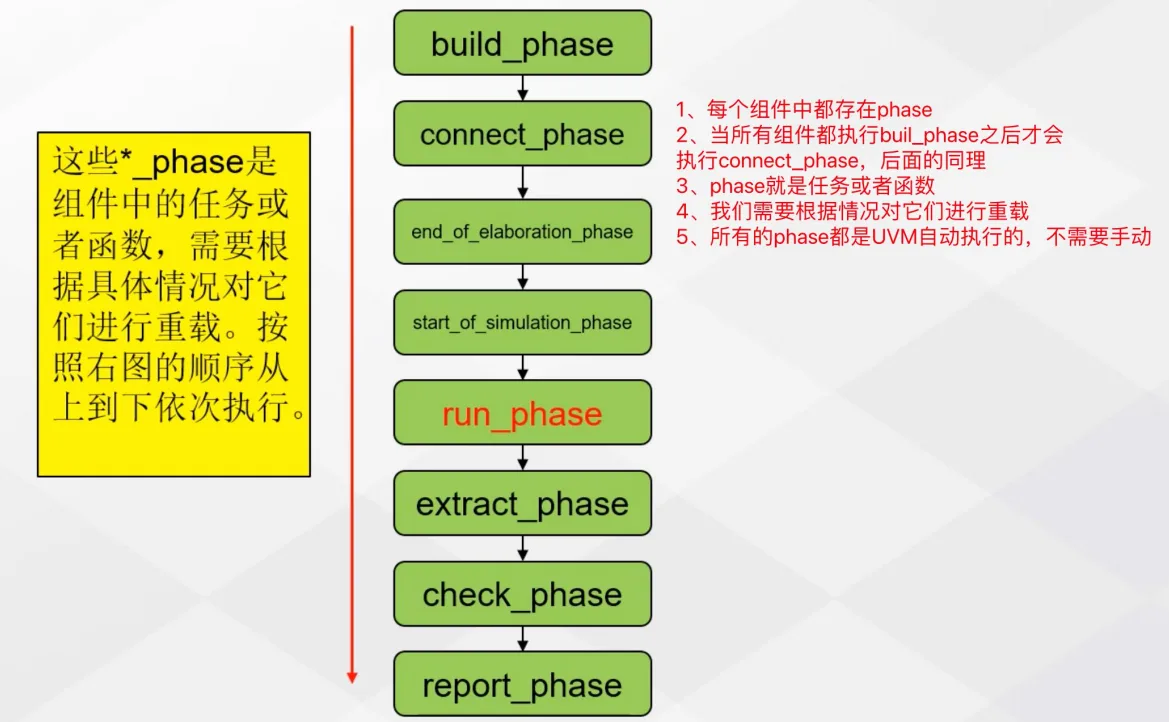
UVM平台中的所有组件都具有phase的概念,它们由按照一定顺序执行的任务或函数组成。
1.4 driver
Driver的主要职能有三个:
- 从sequencer获取transaction
- 由于DUT只能接收PIN级的信号,所以Driver需将transaction分解为DUT可以接受的PIN级信号
- 将转化之后的PIN级信号按照DUT总线协议的方式驱动给DUT
- 注意:到driver层级需要在构建函数中指定父对象
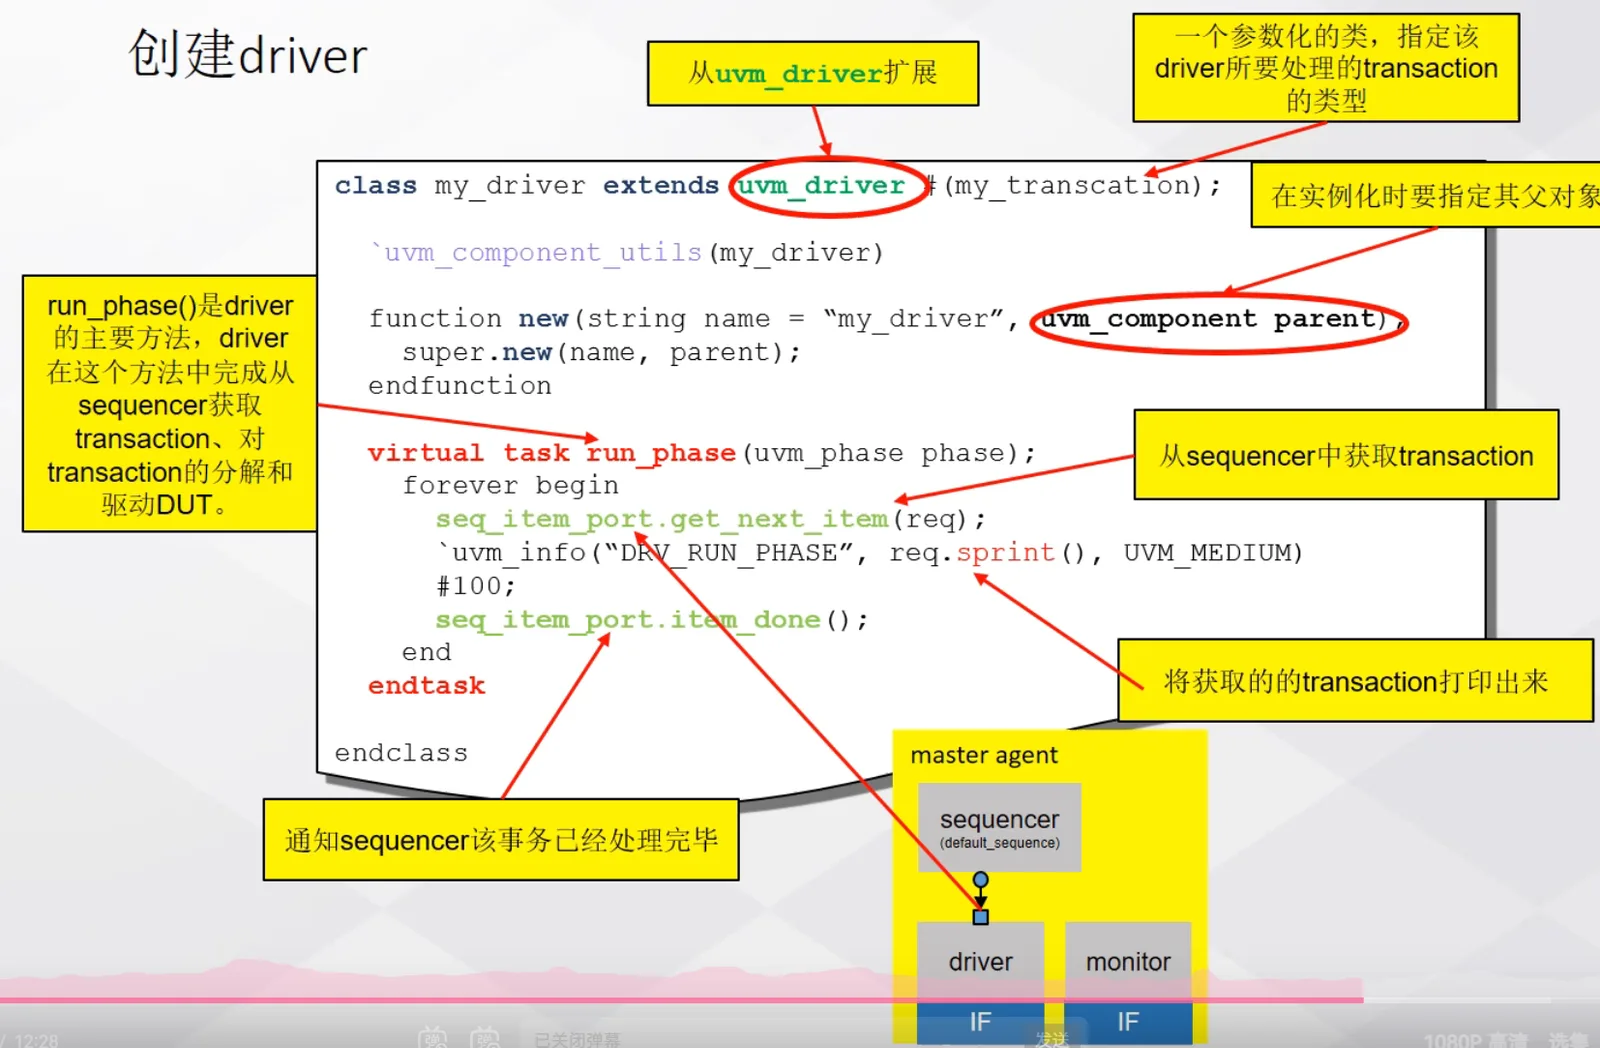
存疑:为什么driver要通知sequencer处理完毕? —— driver想sqr发出请求,也要发出响应。 driver获取事务,是由get_netx_item和item_done协同完成的
1.5 monitor
-
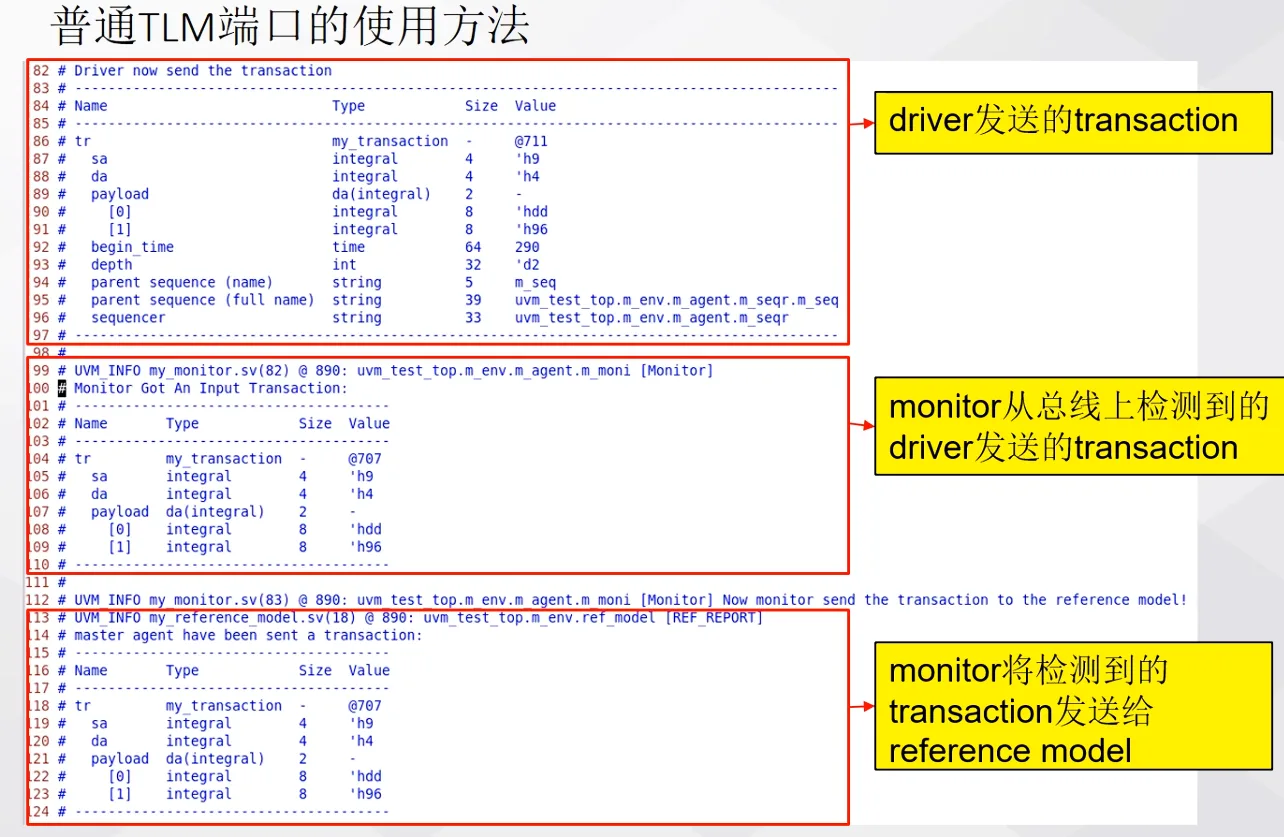
monitor的主要功能是监视接口信号,捕获接口上活动的事务,并且将pin级的信号事务转化为事务级的数据包,之后将这些数据包发送到analysis组件(包括reference model、 scb等)进行分析和产生报告。
-
monitor通过TLM-port(UVM通信机制)与其他组件相连。(后续补充)
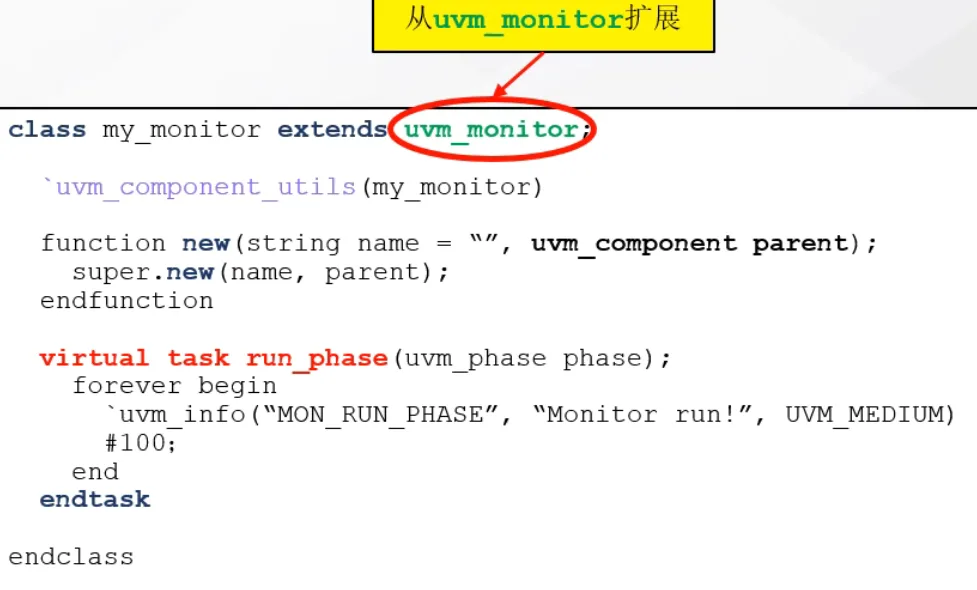
注释:这个monitor的功能很简单,每过100个时间单位就打印一条信息,没有监视接口信号,也没有与其他组件进行联系。
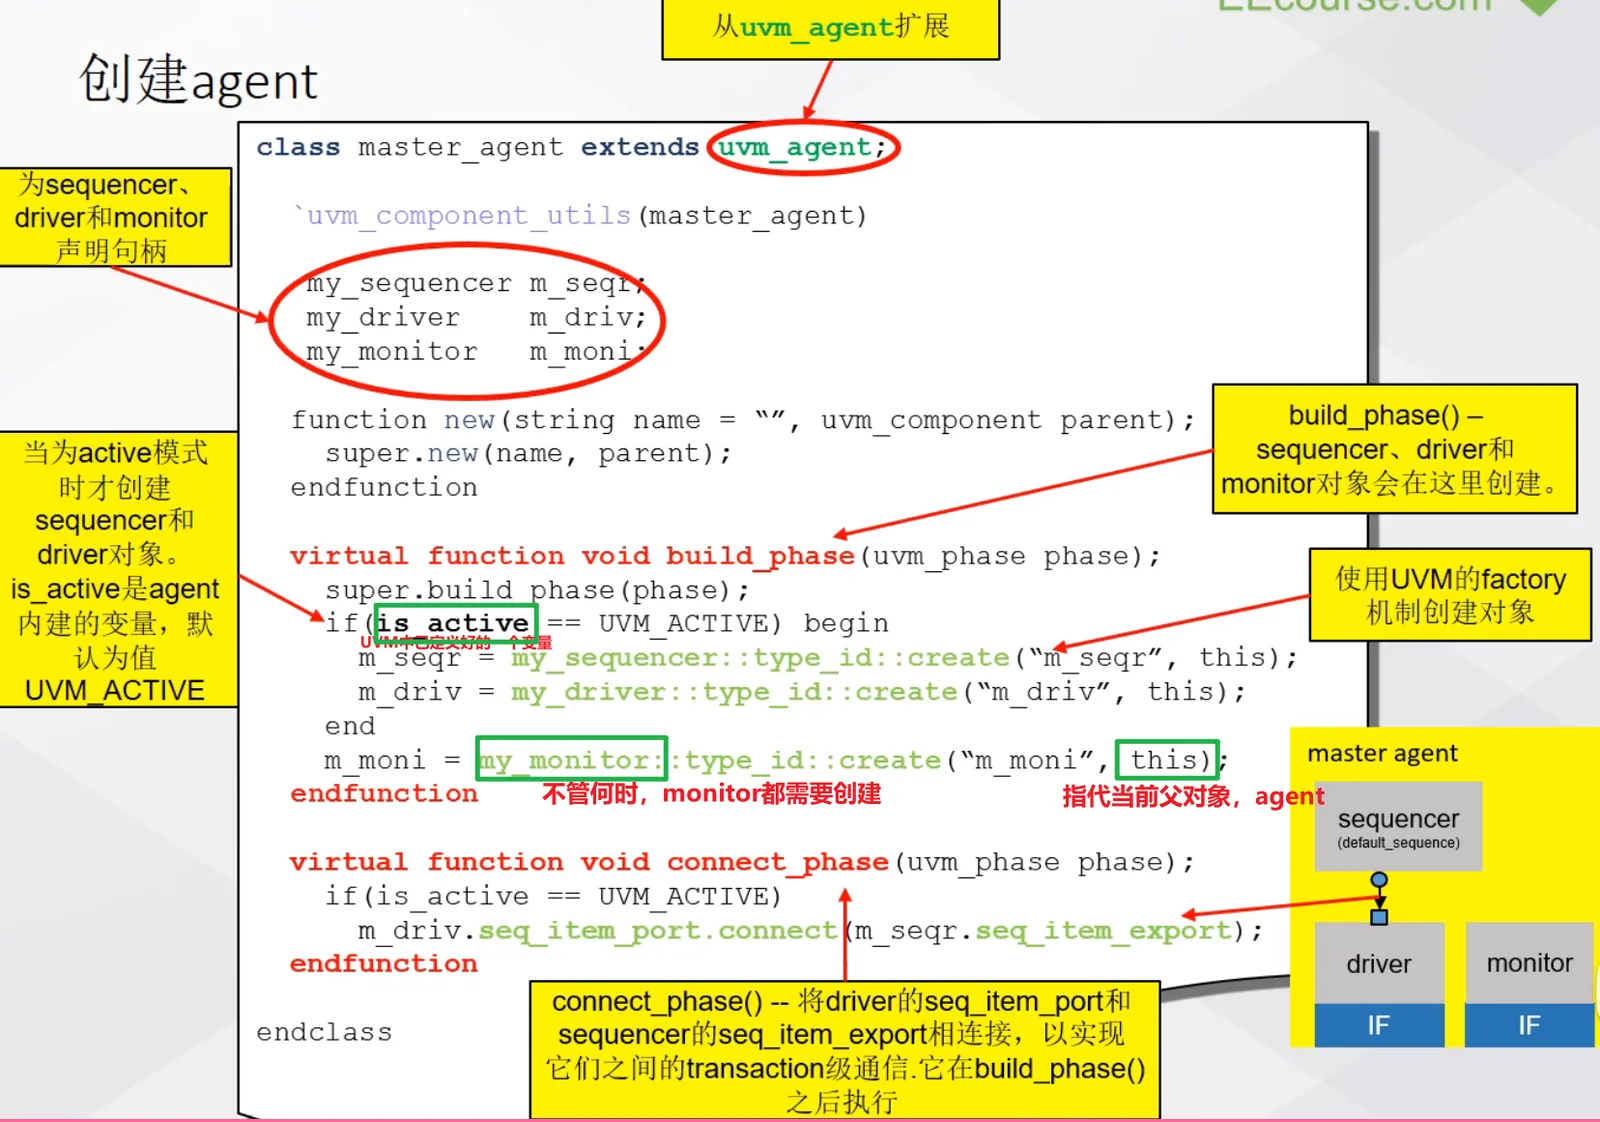
1.6 agent
- 作用:封装sequencer、driver、monitor
- build_phase函数
- agent中需要实例化sequencer、 driver和monitor对象并将sequencer和driver连接起来。
- connect_phase函数
- agent有active和passive之分。passive模式的agent只包含monitor而没有sequencer和drvier。
1.7 env
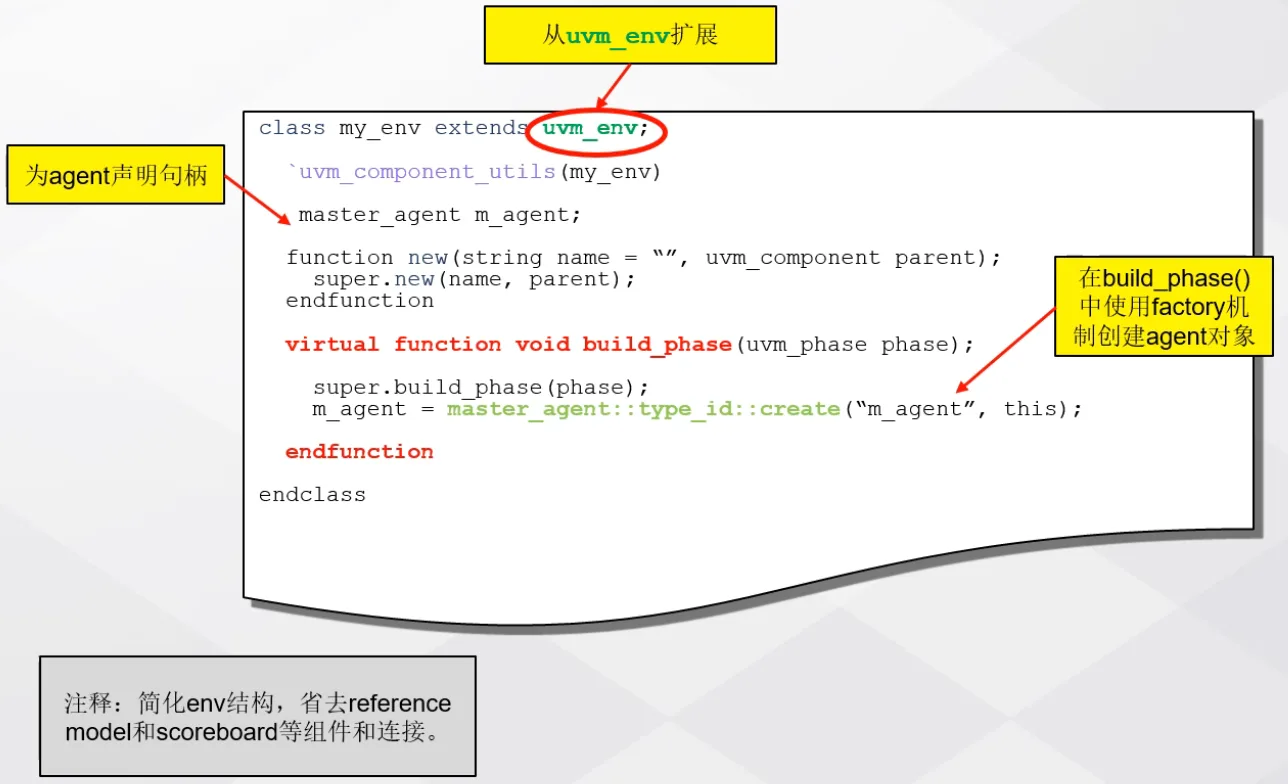
- environment中封装了一个或者多个agent、 reference model、scoreboard以及其他组件。
- environment需要实例化agents、reference model、 scoreboard以及其他组件并将这些组件相互连接
1.8 testcase
testcase用来完成不同内容的测试工作,但env只有一个,一般不对其做出修改
- 作用:实例化和配置env
- 配置需要启动的sequence
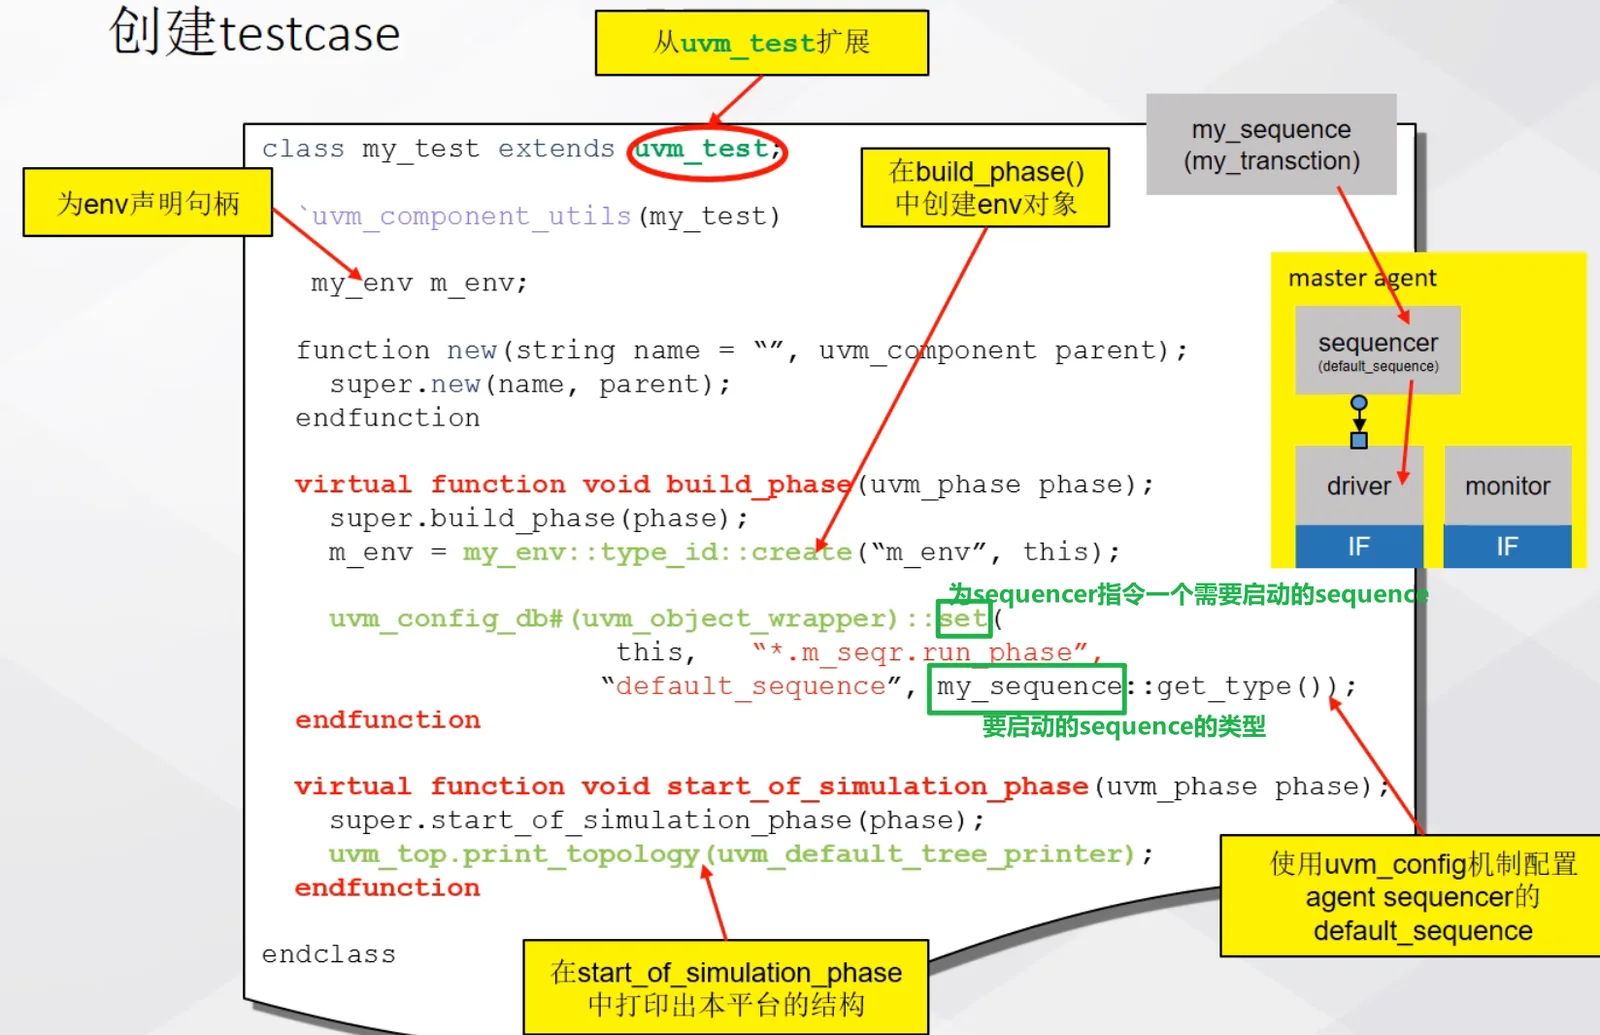
uvm_config_db的四个参数:
- 启动位置
- 被配置变量的相对路径
- 目标变量标识符
- 启动sequence类型
1.9 仿真运行
在学习SystemVerilog时知道, program可以用来启动仿真平台(或model中)
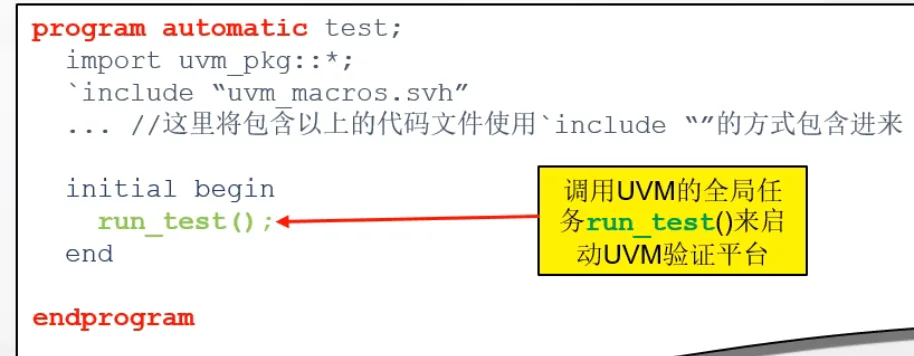
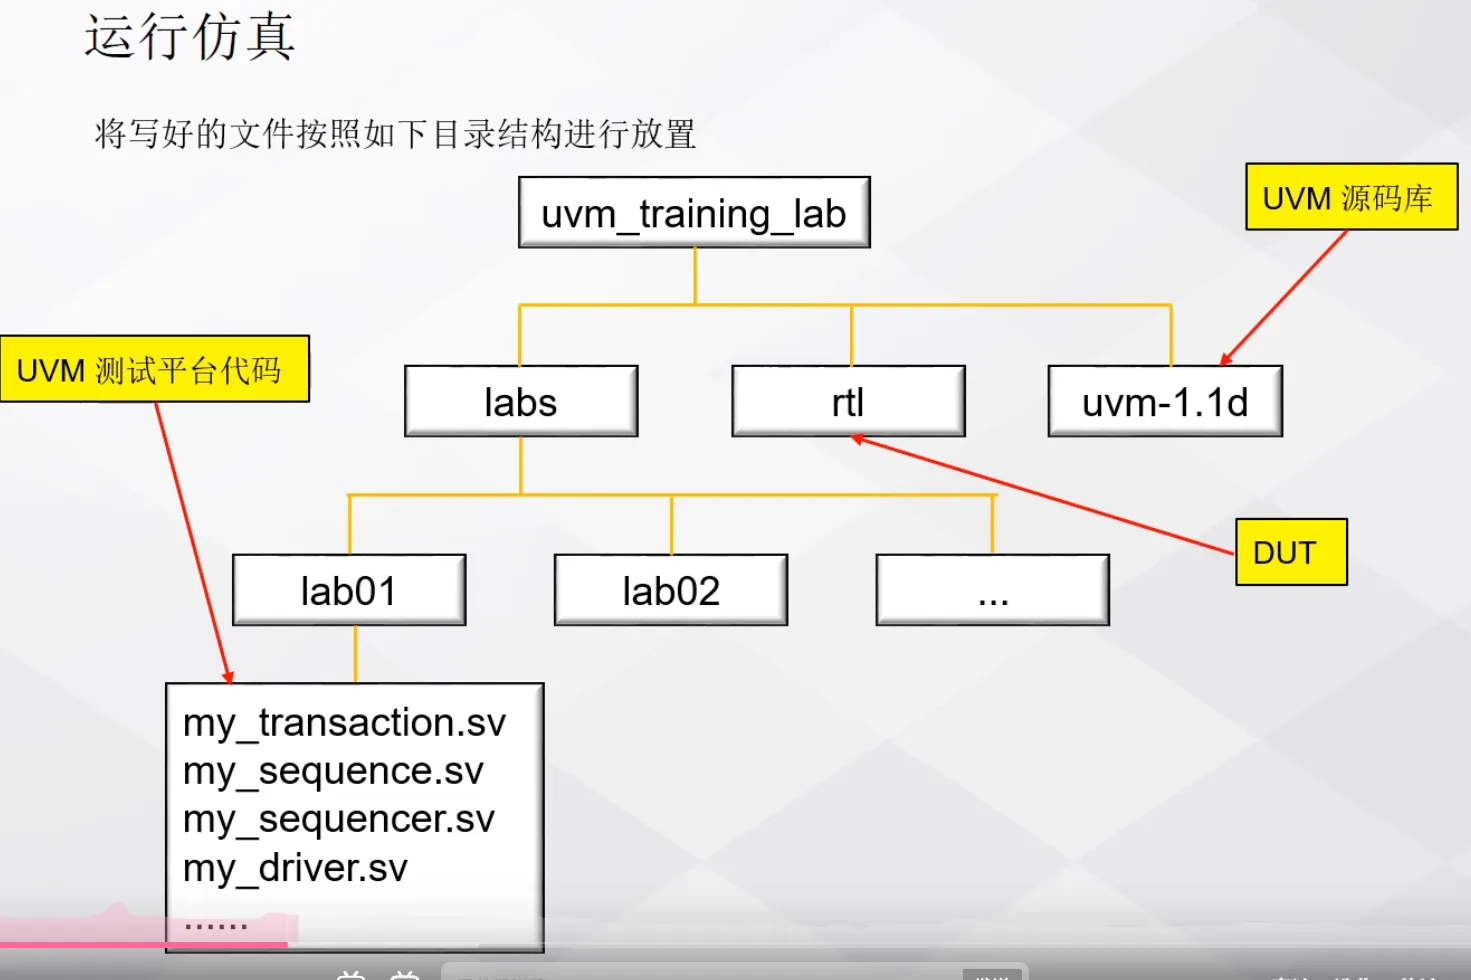
进入lab01目录下,运行仿真
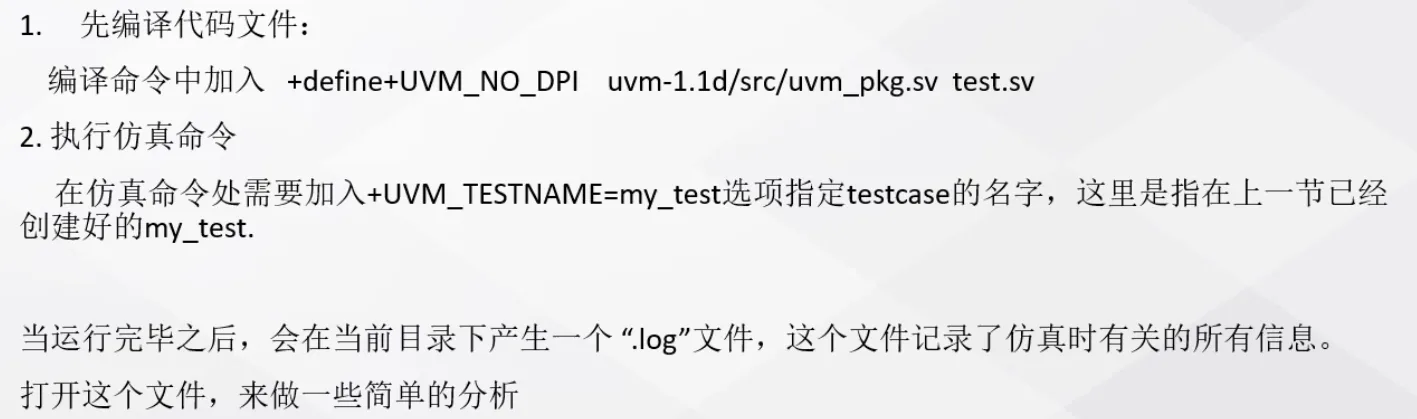
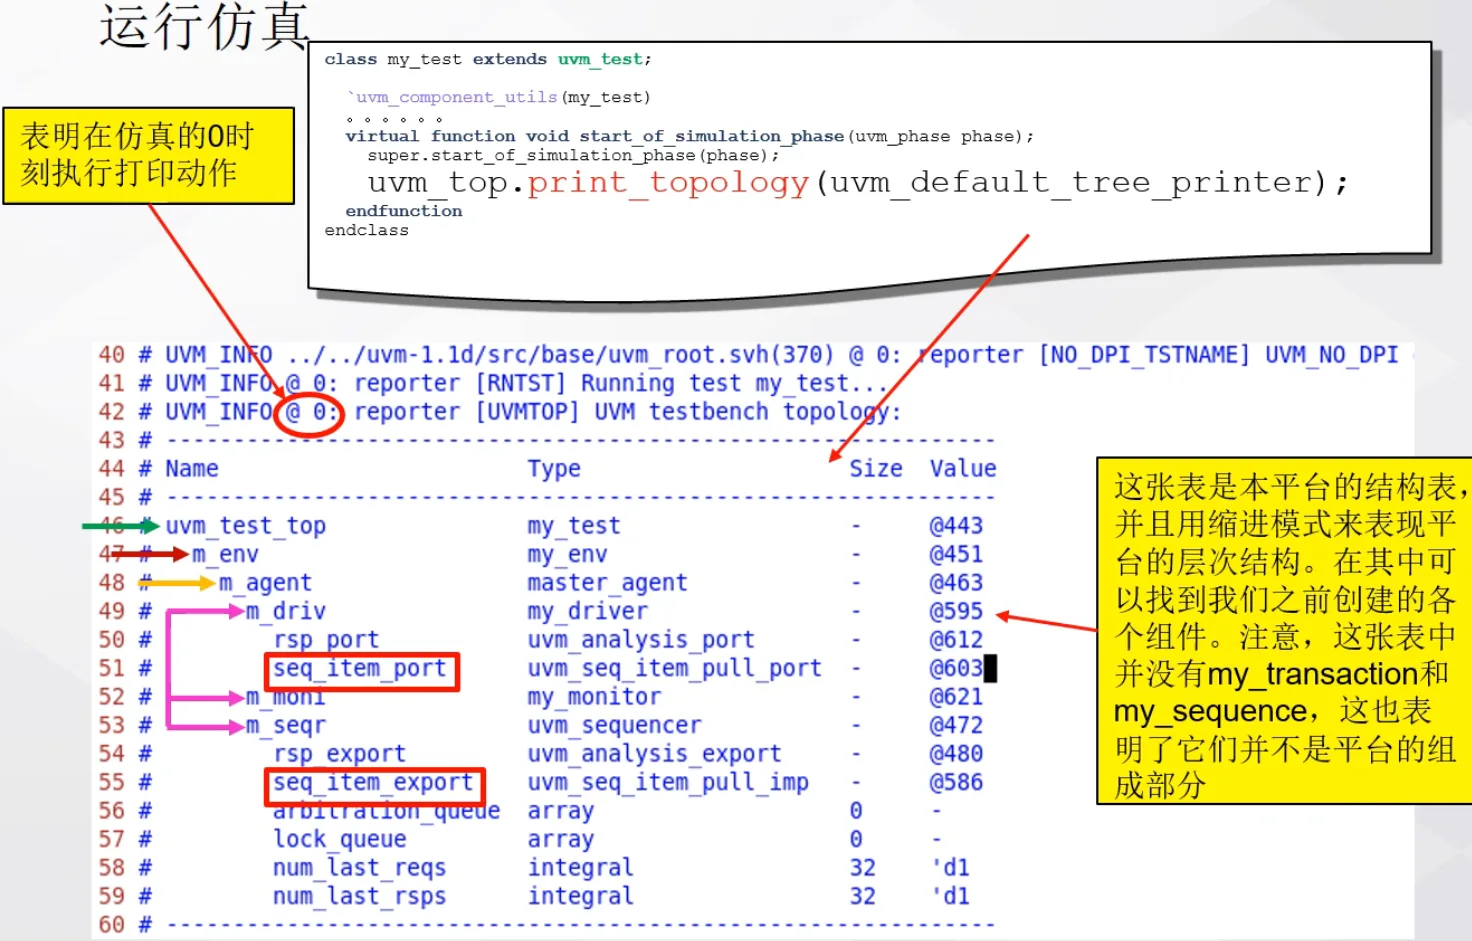
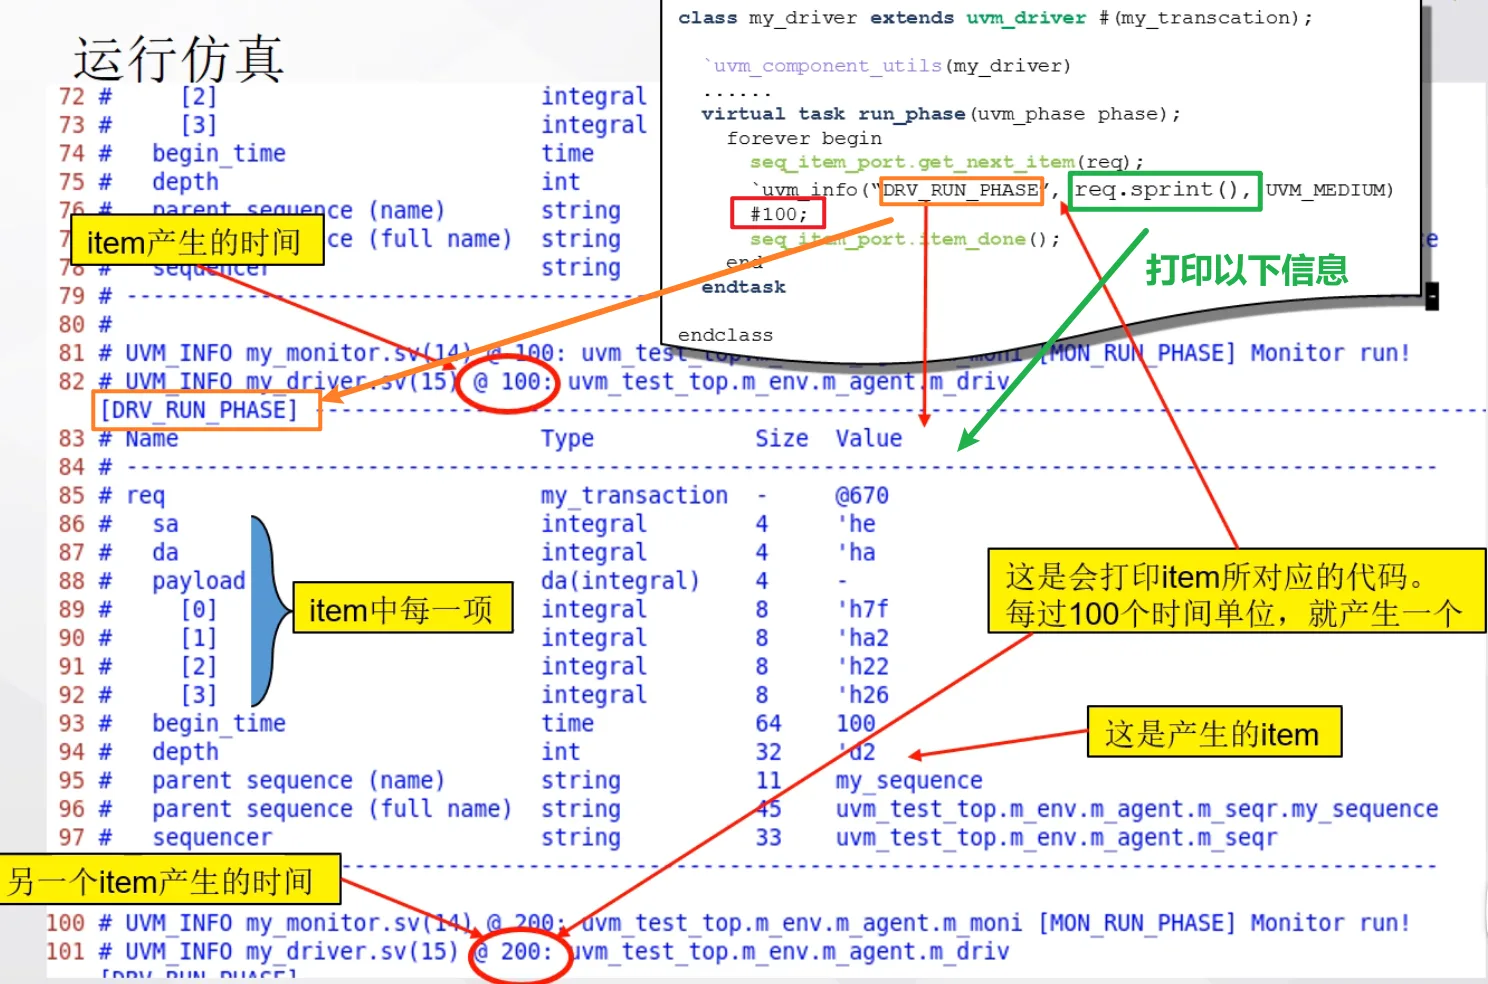
小结:
transaction的创建
- sequence创建
- sequencer创建 —— 发送sequence
- driver —— 接受sequence,然后对其分解,驱动给DUT
- monitor —— 监控发送给DUT的事务
- agent封装
- env创建
- test —— 具体的测试项目,基于env并对其配置
2 UVM平台组件
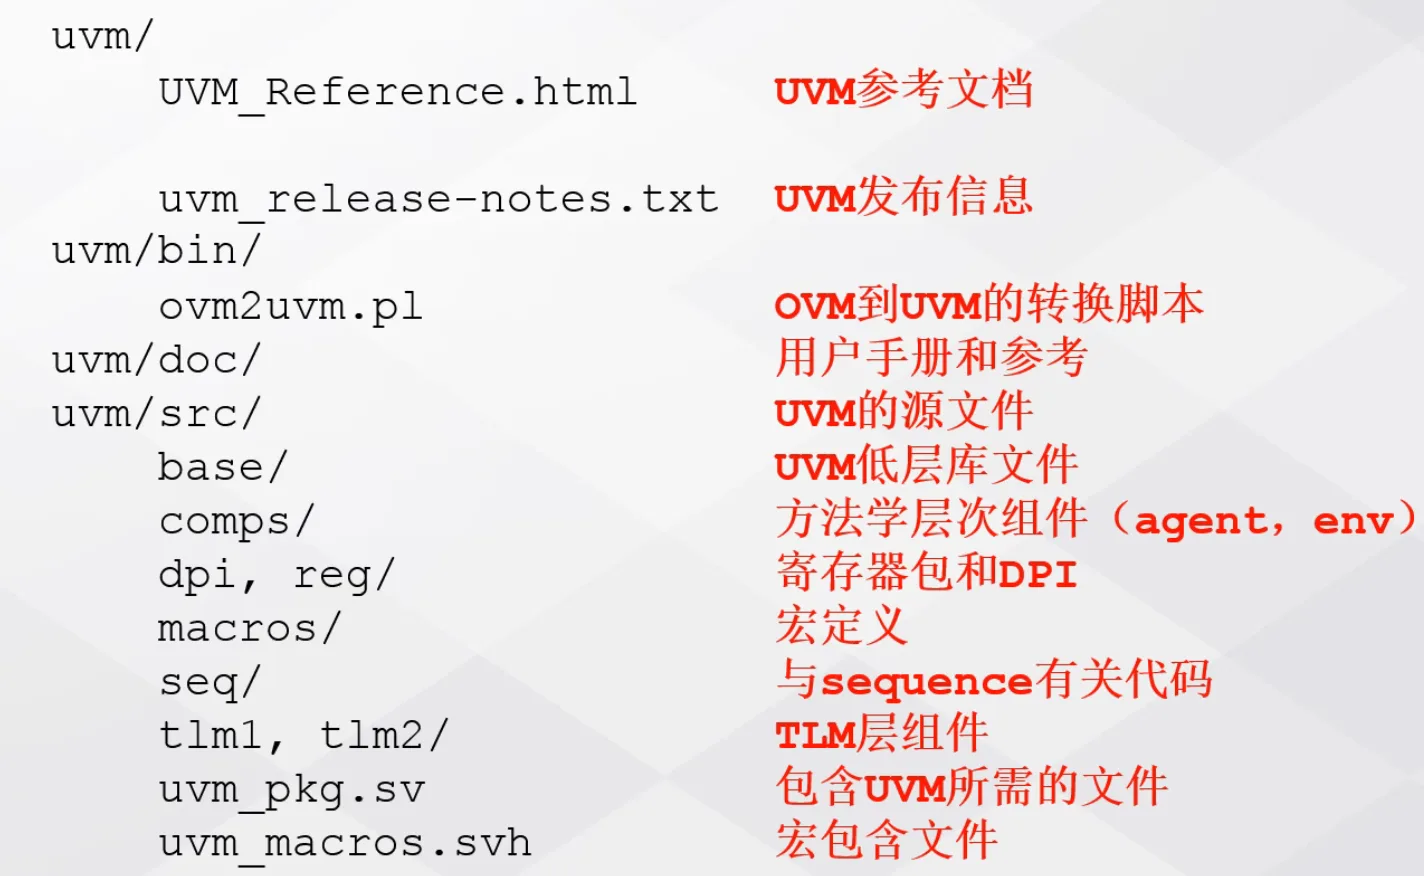
2.1 UVM库
UVM 库的文件目录结构
UVM package包含了三个主要的类
- uvm_component:用来构建UVM testbench层级结构最基本的类
- uvm_object:作为UVM的一种数据结构,可作为配置对象来配置测试平台
- uvm_transaction:用来产生激励和收集响应
2.2 uvm_component
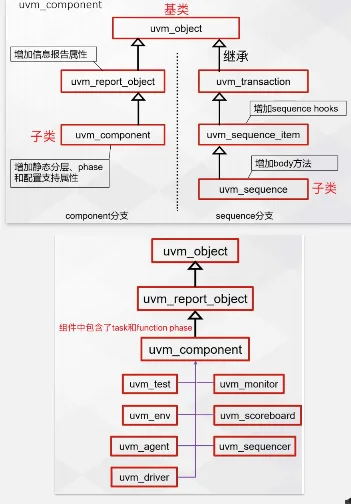
UVM继承关系
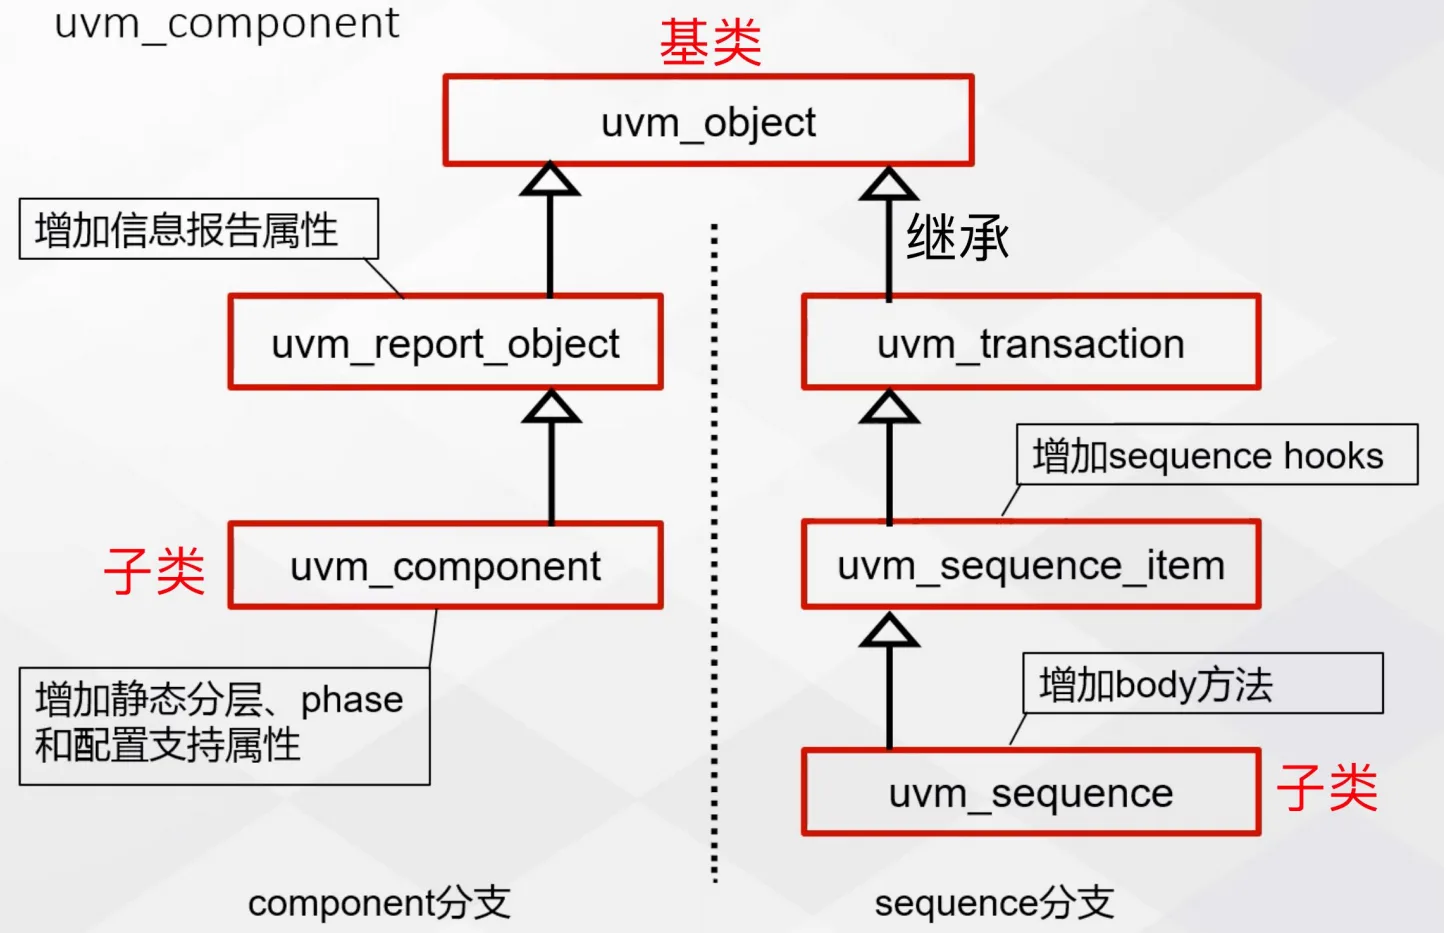
uvm_component
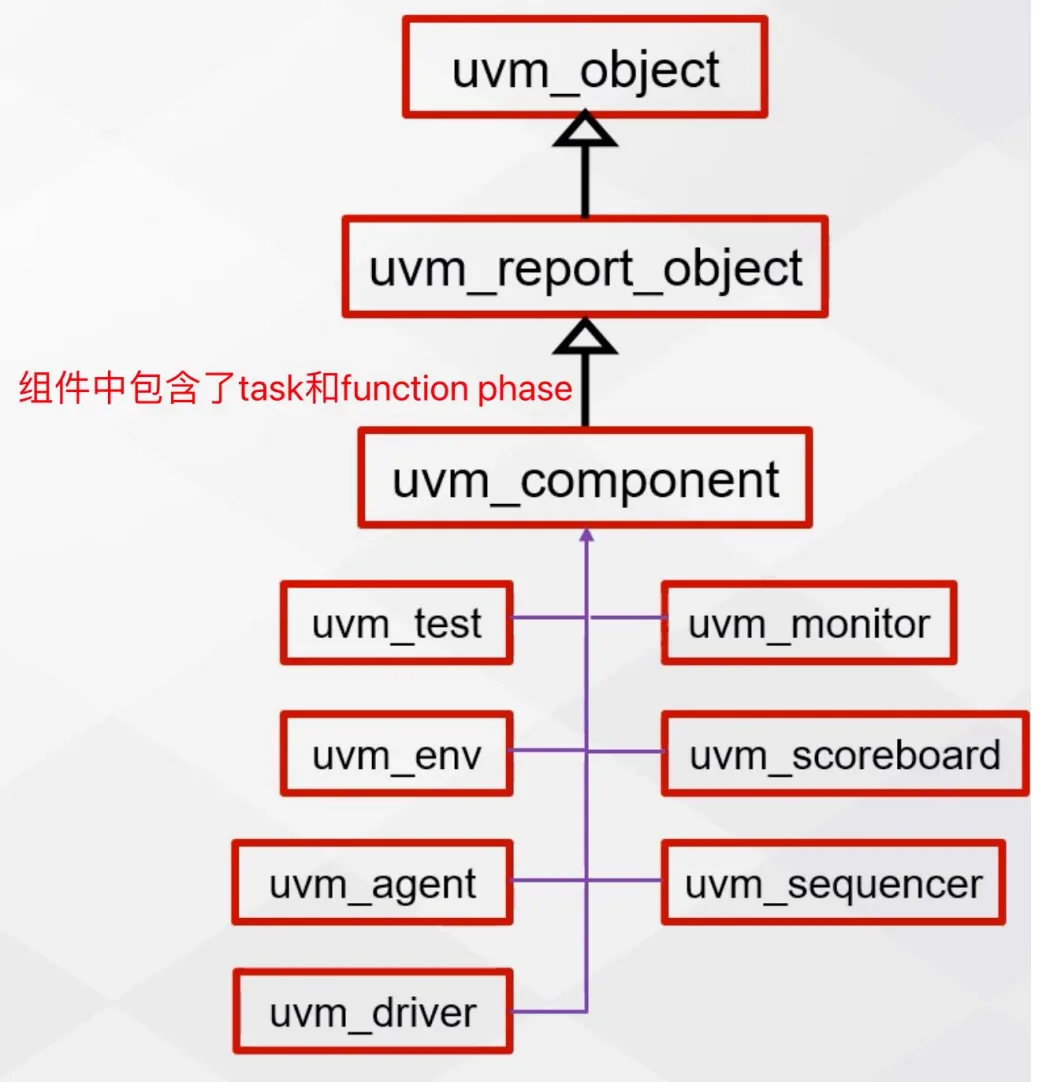
2.2.1 uvm_object 与 uvm_component
uvm_object
├── uvm_transaction
│   └── uvm_sequence_item
│       └── uvm_sequence_base
│           └── uvm_sequence
└── uvm_report_object
    └── uvm_component
        ├── uvm_env
        ├── uvm_agent
        ├── uvm_driver
        ├── uvm_monitor
        └── … (所有 testbench 组件)
生命周期管理:
uvm_object- 用
new()创建。 - 生命周期由用户代码自己控制,创建时机完全手动。
- 不参与 UVM 的 phase 机制。
- 用
uvm_component- 用
create()(工厂方法)创建,需要指定 父组件(parent),这样 UVM 才能组织成一棵组件树。 - 生命周期受 UVM framework 管理。
- 自动参与 build, connect, run, report, check, final 等 phases。
- 用
| 特性 | uvm_object | uvm_component |
|---|---|---|
| 继承体系 | UVM 基础类 | 继承自 uvm_object |
| 创建方式 | new() / ::type_id::create() | ::type_id::create(name, parent) |
| 生命周期 | 用户手动管理 | UVM 框架自动管理 |
| 是否参与 phase | ❌ 不参与 | ✅ 参与(build, connect, run 等) |
| 是否有层级树 | ❌ 无 | ✅ 有(需要 parent) |
| 典型用途 | 数据对象(transaction, sequence) | 结构组件(env, agent, driver, monitor) |
注意:
raise_objection / drop_objection管的是 uvm_component 的 run_phase 执行时长,不是uvm_object(如 transaction / sequence_item)的存在时间。
2.3 UVM结构树
UVM树这种结构称为逻辑层次结构
UVM构建逻辑层次结构原因:
- 为config机制提供搜索路径
- 为override机制提供搜索路径
- 是phase自动执行的需要
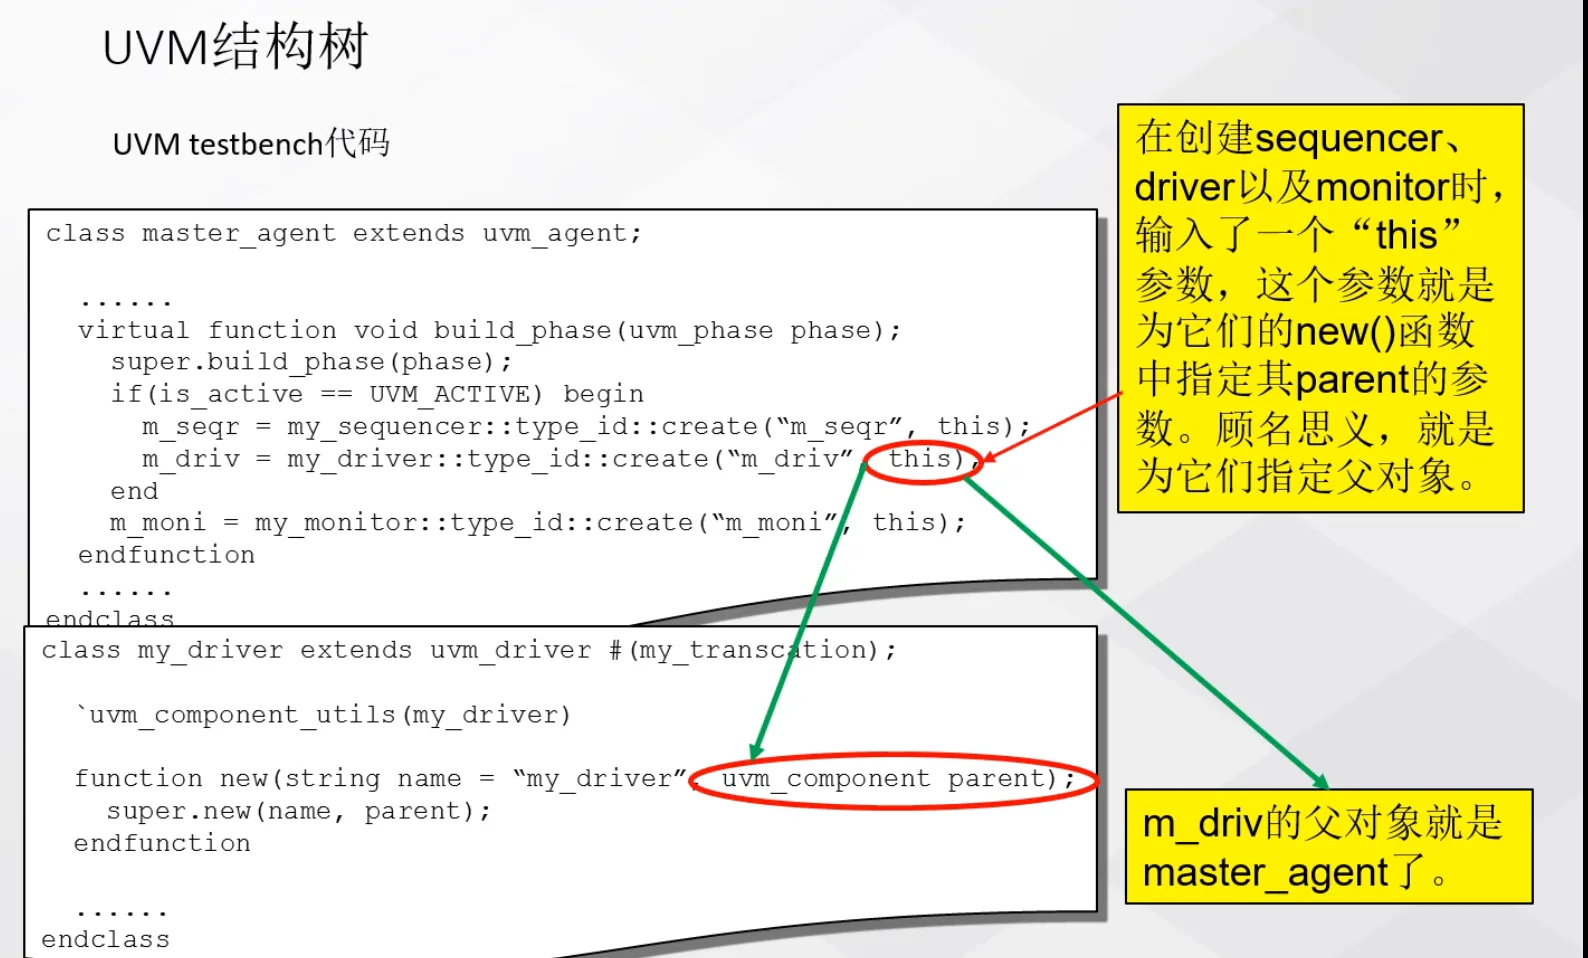
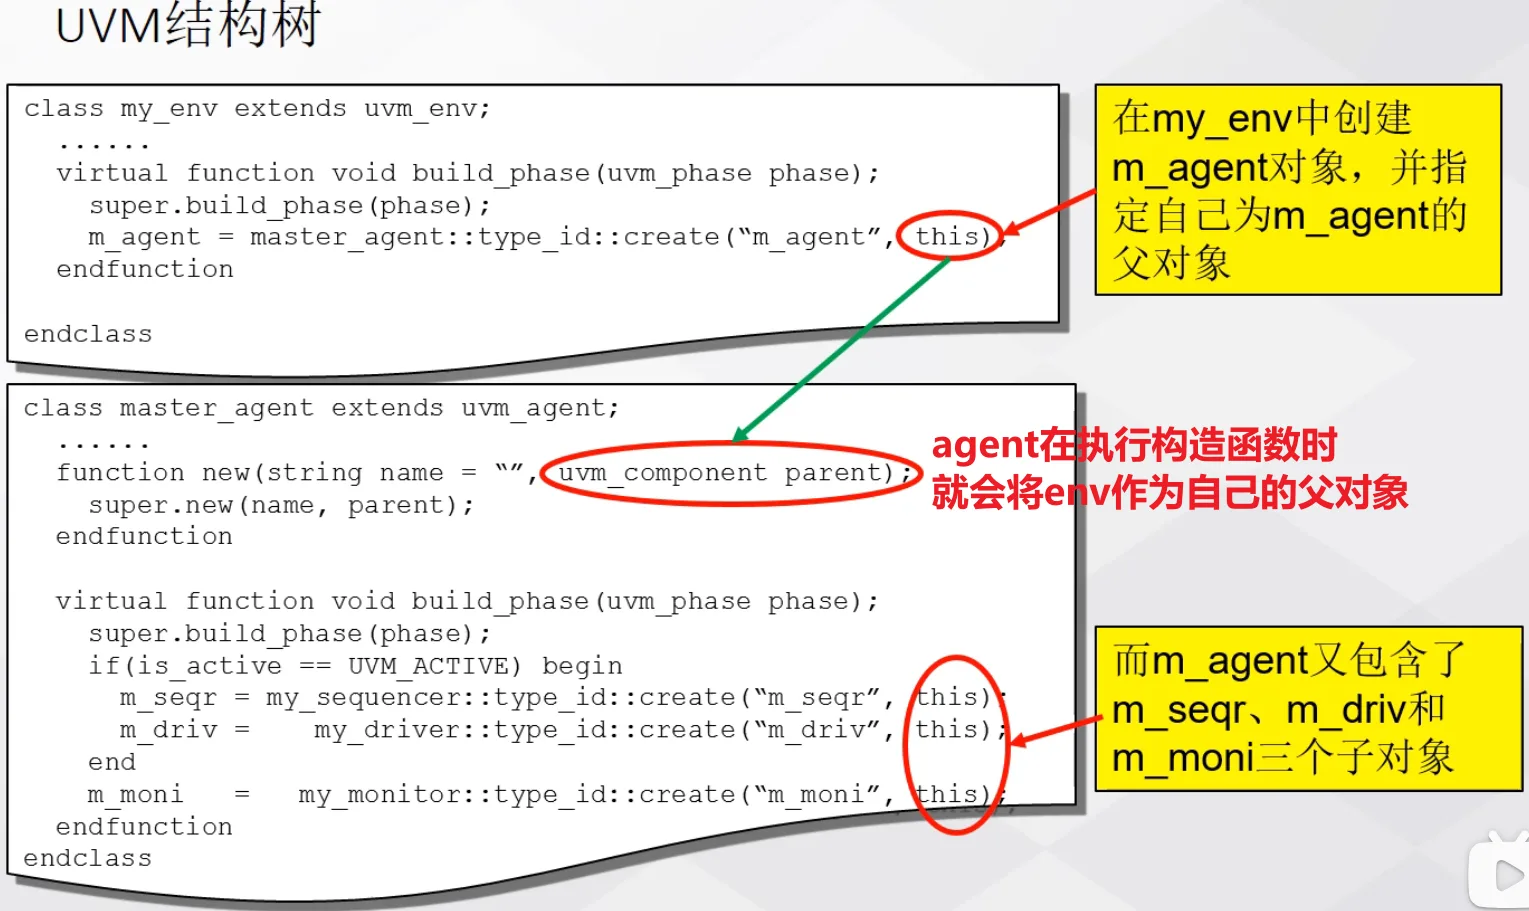
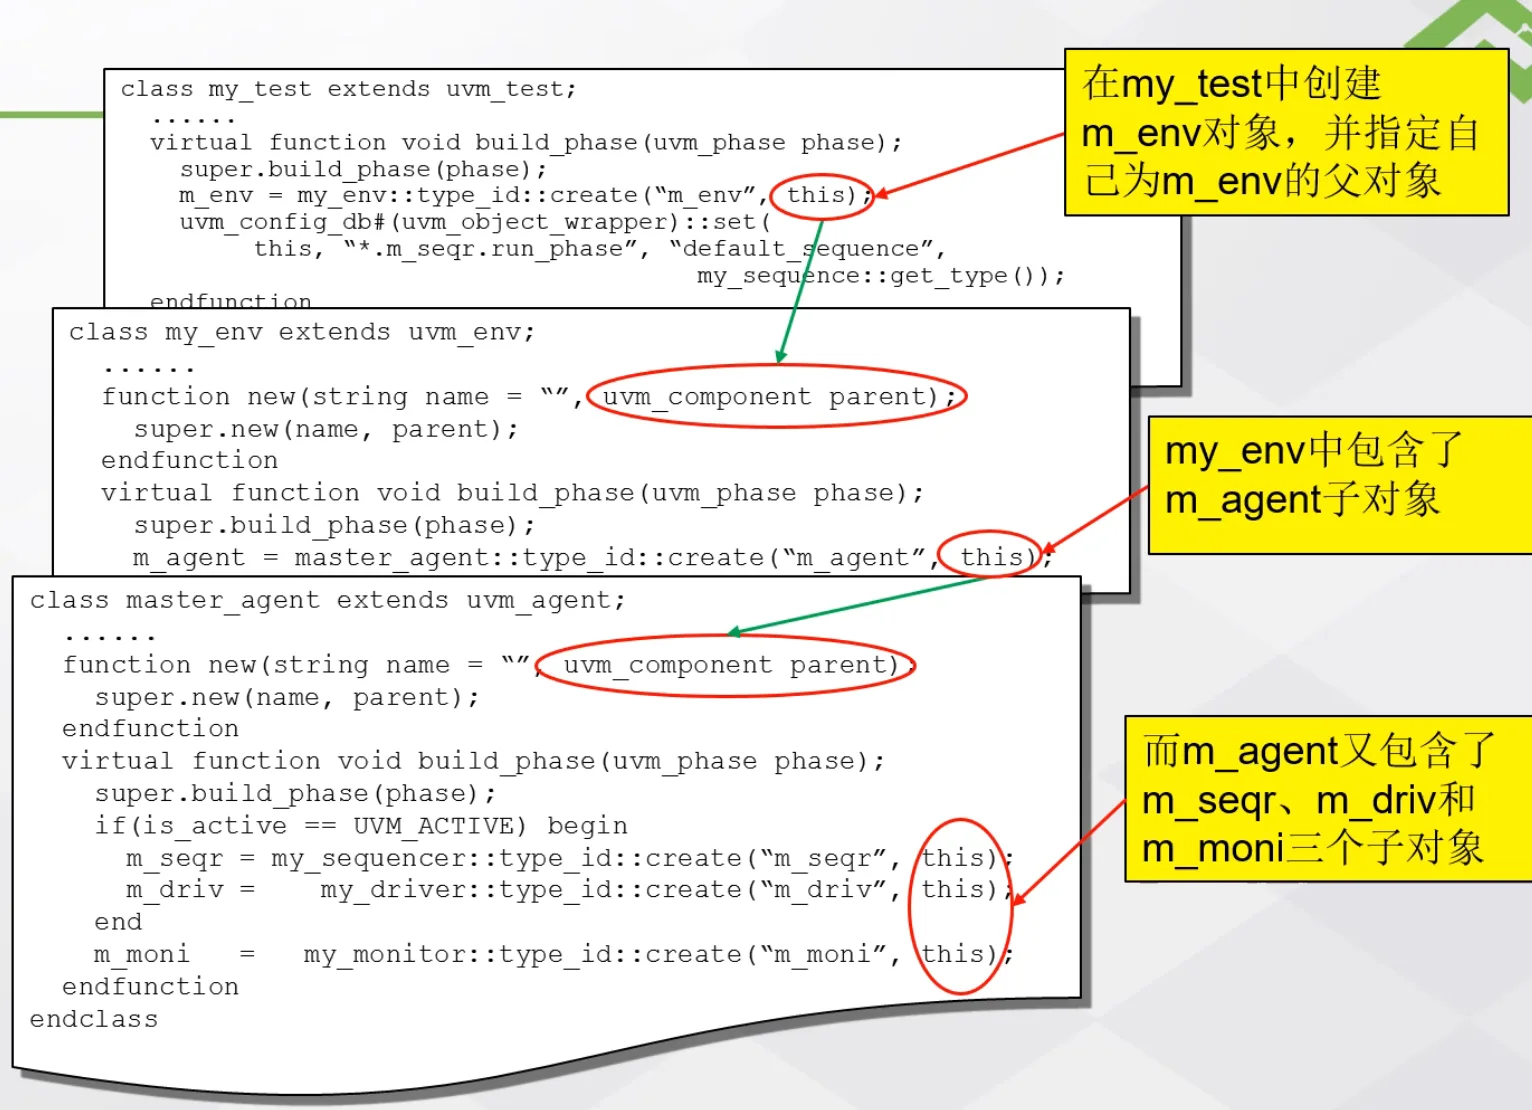
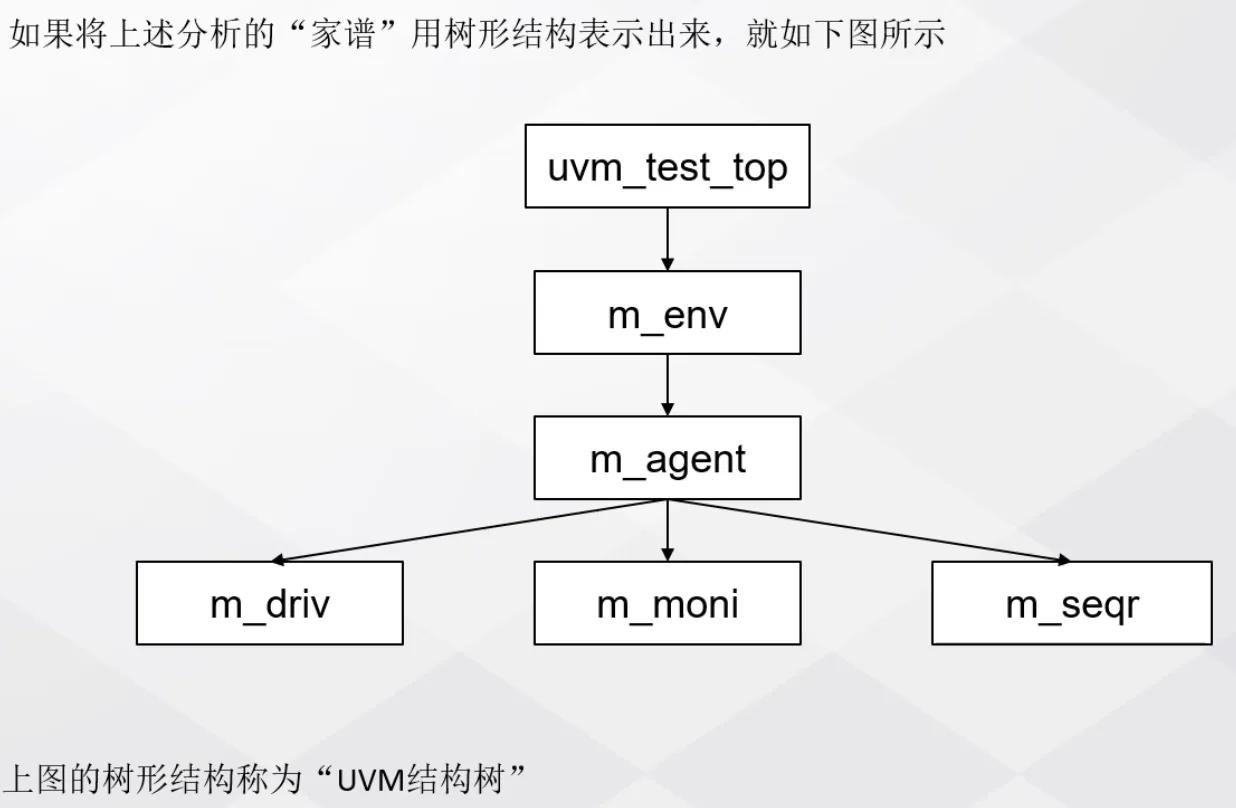
env实际上包含了更多的子对象
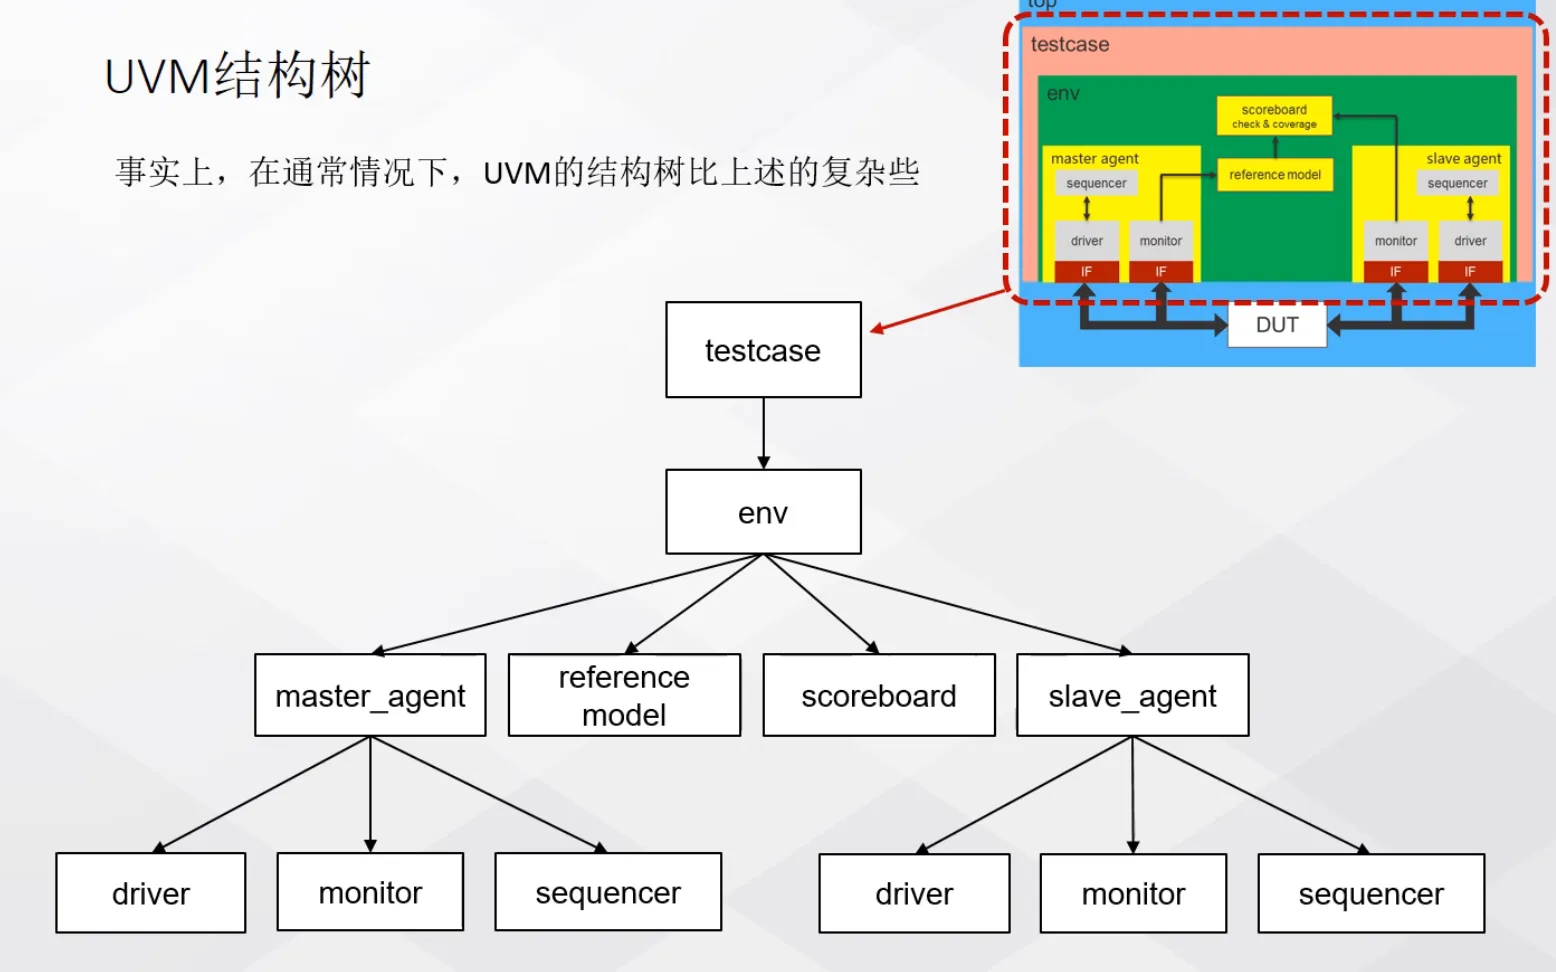
UVM结构树可以与之前打印的log文件中看到对照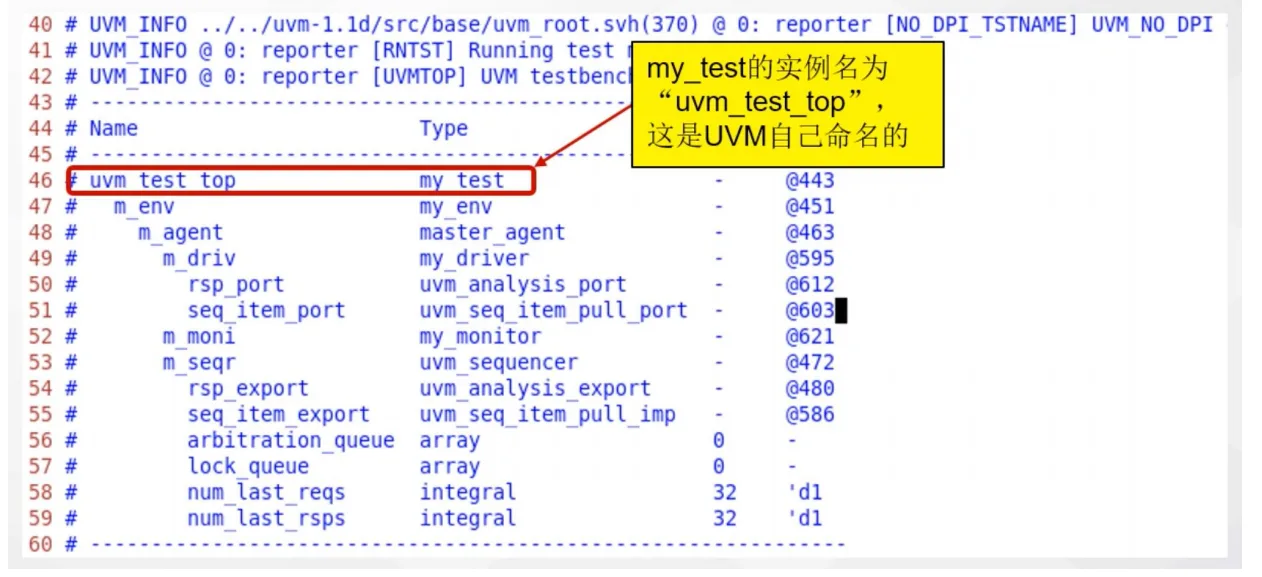
补充:sequence相当于子弹,sequencer相当于弹夹,driver相当于手枪。
补充:uvm_root - UVM结构树的根节点
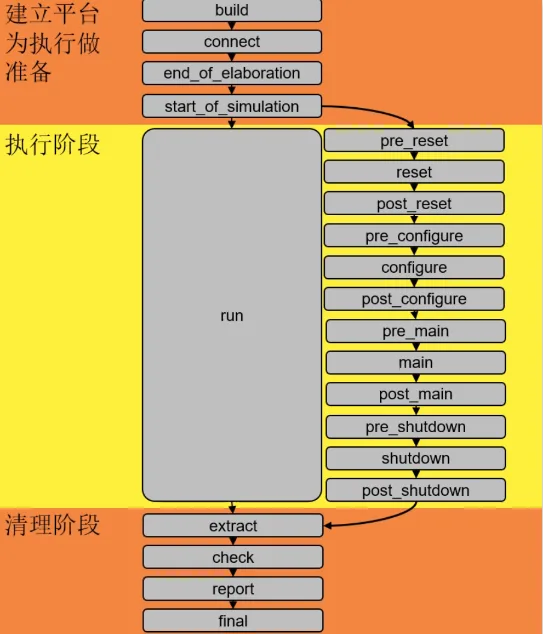
2.4 UVM phase
为什么需要phase?: 一般而言,从验证平台的构建,到配置,到连接,再到运行,最后停止需要有一定的先后顺序。
- UVM中为平台组件定义了一套phase流程来控制仿真平台的执行过程。
- phase是uvm_component(平台组件)的属性。
phase的特性:
- phase是按照下图中的顺序执行的
- 不同phase和components中的相应的任务或者函数相对应
- 比如build对应function void build_phase()
在test的build phase调用后,会调用其所有子类的build phase(自顶向下执行)。 connect_phase 等其他func phase按照自底向上执行
- run_phase阶段是所有组件同步执行。
现象:Test、Env、Agent、Driver、Monitor 等所有组件的
run_phase都在同一时刻(0时刻)开始独立运行。它们之间的同步和交互不是靠启动顺序来保证的,而是通过事件(Event)、TLM 通信、Sequence 机制以及 Objection 机制来协同工作的。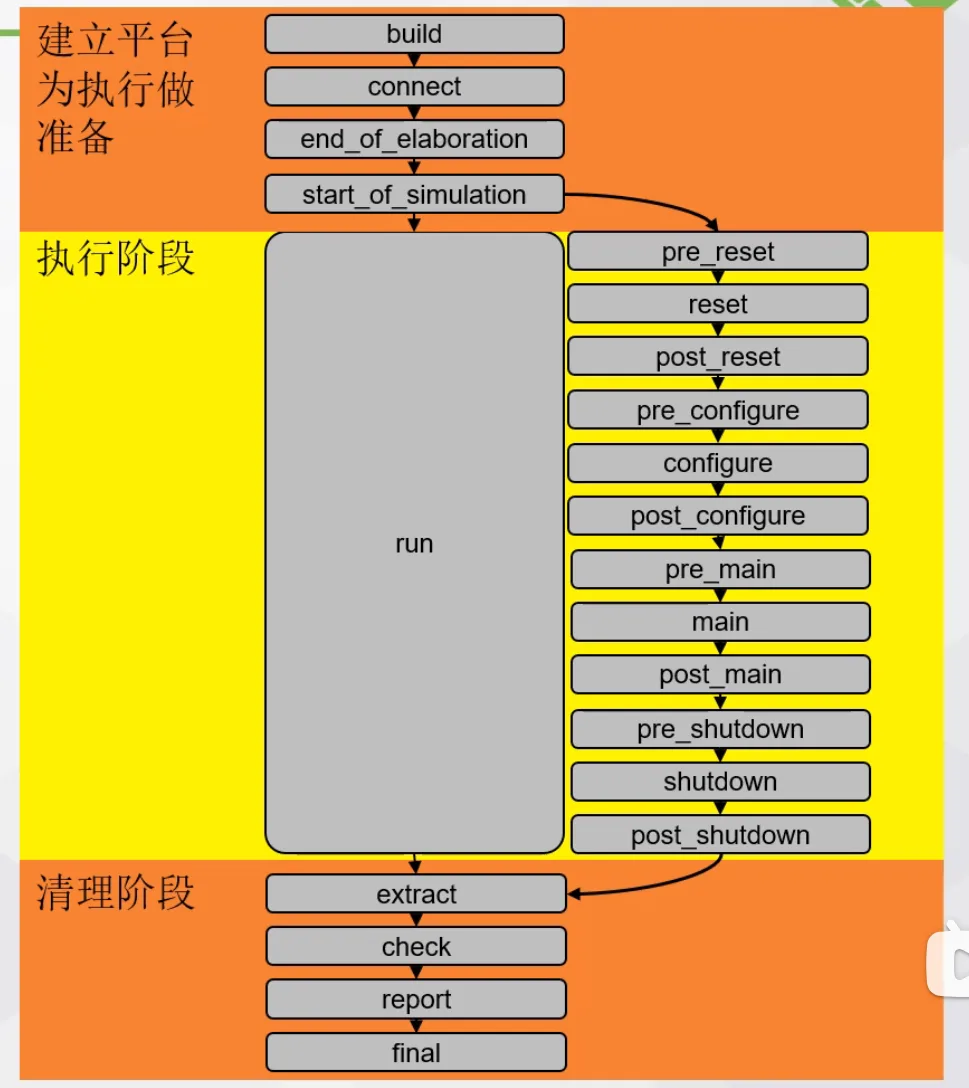 黄色区域为task phase(消耗仿真时间),橙色为function phase
为什么需要phase这种机制?
一般而言,从验证平台的构建,到配置,到连接,再到运行,最后停止需要有一定的先后顺序。phase机制为代码的执行先后顺序做一个区域的划分,执行相同的功能代码放在一起执行
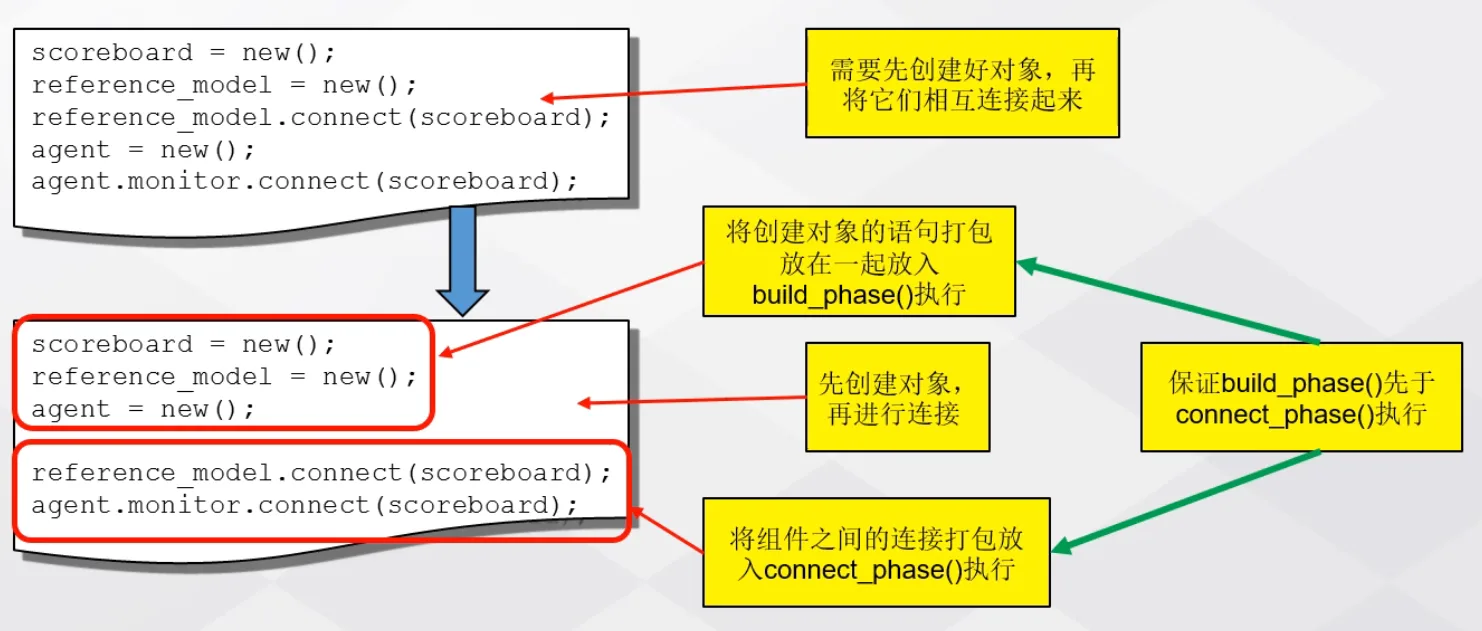
这里浅显的理解: phase机制就是将 实例化对象 和 连接 这两个操作 独立开来 , 分别放在build_phase和connect_phase任务中执行,再将其分先后顺序。
(比如需要先实例化 reference model 和 scb,然后再连接,反之会出现错误)
为执行代码做区域划分,执行相同功能的代码放到一起执行且分顺序
2.4.1 phase原理
在test的build phase调用后,会调用其所有子类的build phase(自顶向下执行)。其他的都按照自下向上执行
build_phase 要自顶向下执行,因为父组件必须先存在,才能 create() 子组件。
当父类的build_phase调用完成后,会依次调用子类对象的build_phase
test.build() └ env.build()biduan └ agent.build() └ driver.build() / monitor.build() / …
注:driver,sequencer,monitor三个同级的 component 的 build_phase 执行顺序不定,由UVM内部决定
别的 phase ,如connect_phae和run_phase都是“自底向上”,因为其他 phase 是“行为执行”,有时候子模块先执行比较合理,比如run_phase,driver 要先跑起来等指令,monitor 要先准备好监听,test 最后才下命令
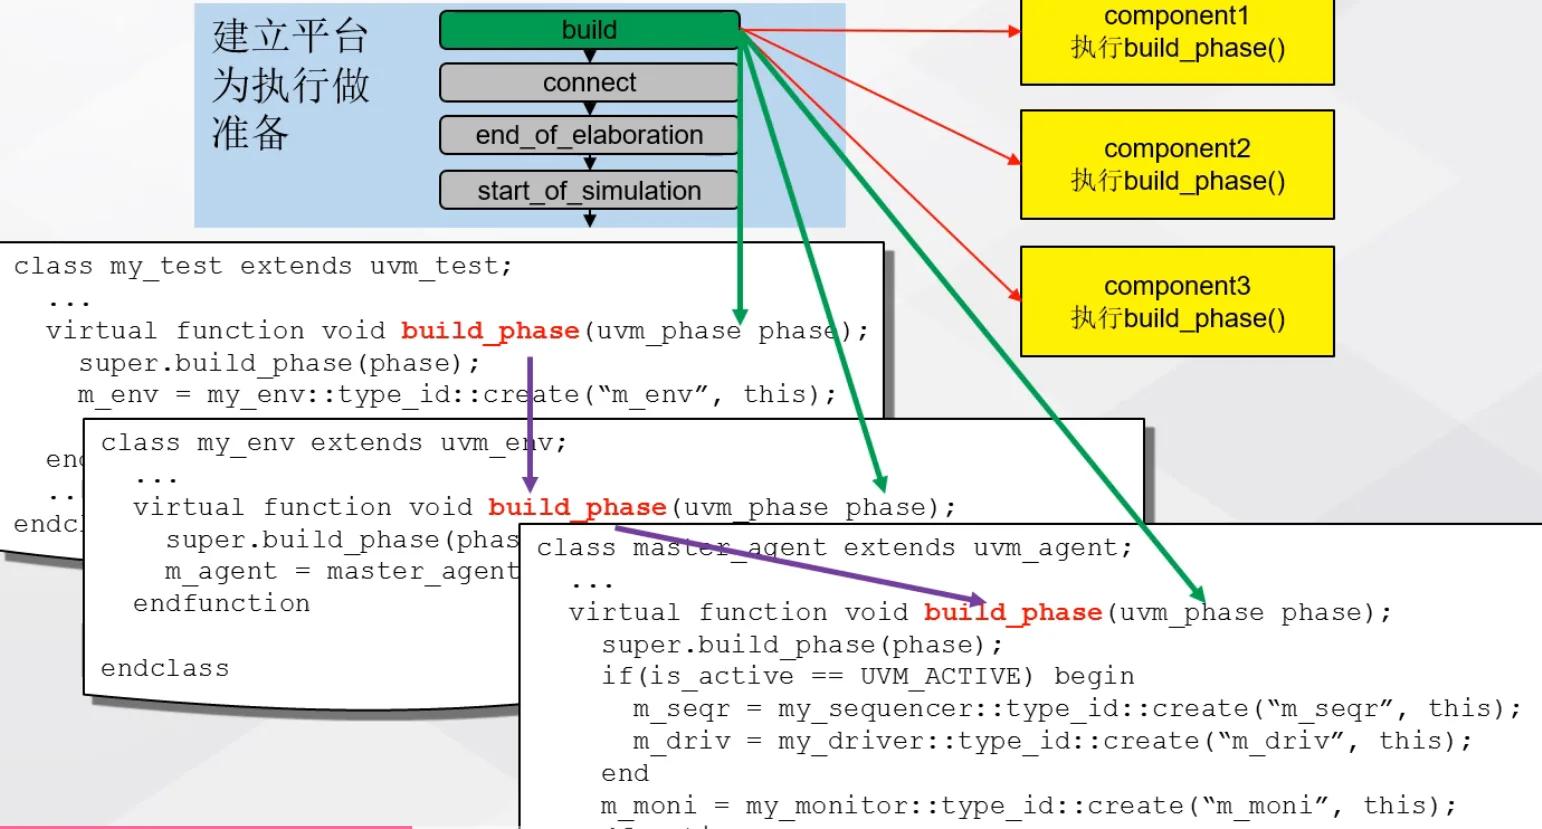
Task phase & Function phase
- task phase(黄色)会消耗仿真时间
- 在Function phase(橙色) 中除了build_phase是自顶向下执行的,其他都是从底向上执行的
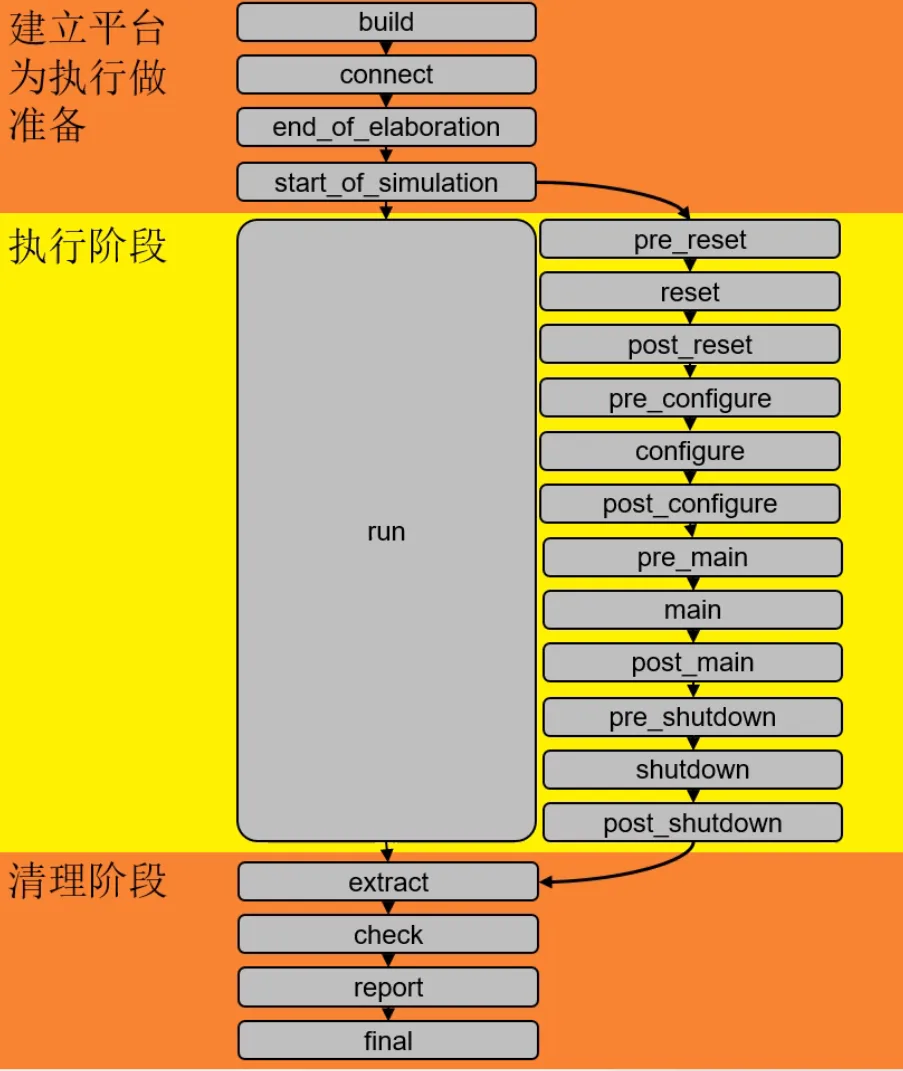
function phase中
- build phase是自顶向下执行
- 其余phase是自下向上执行
task phase:
- 12个run time phase顺序执行
- 每个组件相同的task phase并行执行
注意:
- 只有当所有component的同名phase都执行完毕后,才会执行下一个phase
- 同名phase在不同的component中的执行顺序:由父组件到子组件的顺序决定。父组件的phase会在子组件的phase之前执行。
- run phase和12个run-time phase是同时存在,并行发生的
- 也就是说run + pre_reset并行开始到run + post_shutdown并行结束,然后到extract phase
2.4.2 不同phase功能
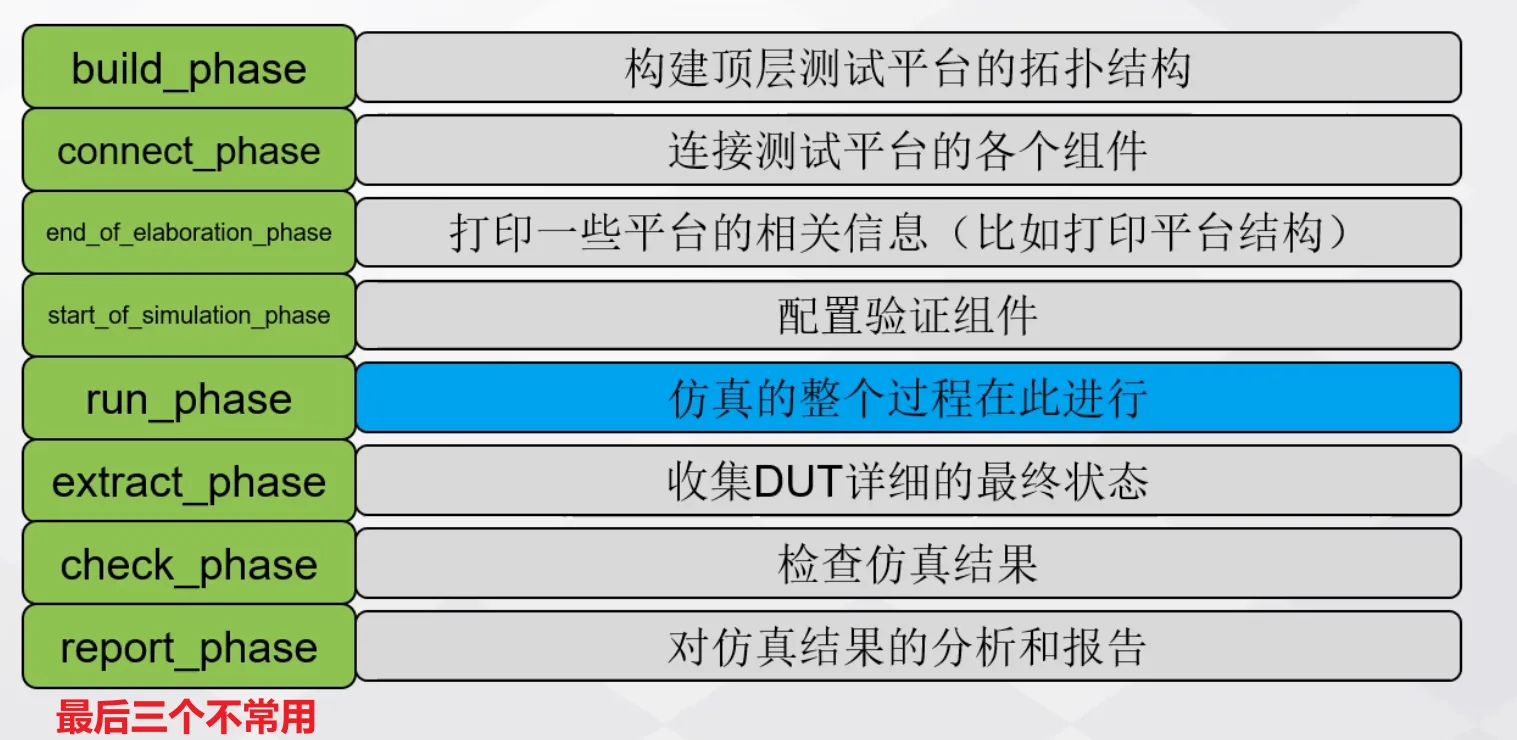
一般来说,function phase 中常用的只有 build phase 和 connect phase,配置相关的操作也放在 build phase 中,其他 phase 很少用到
run-time phase
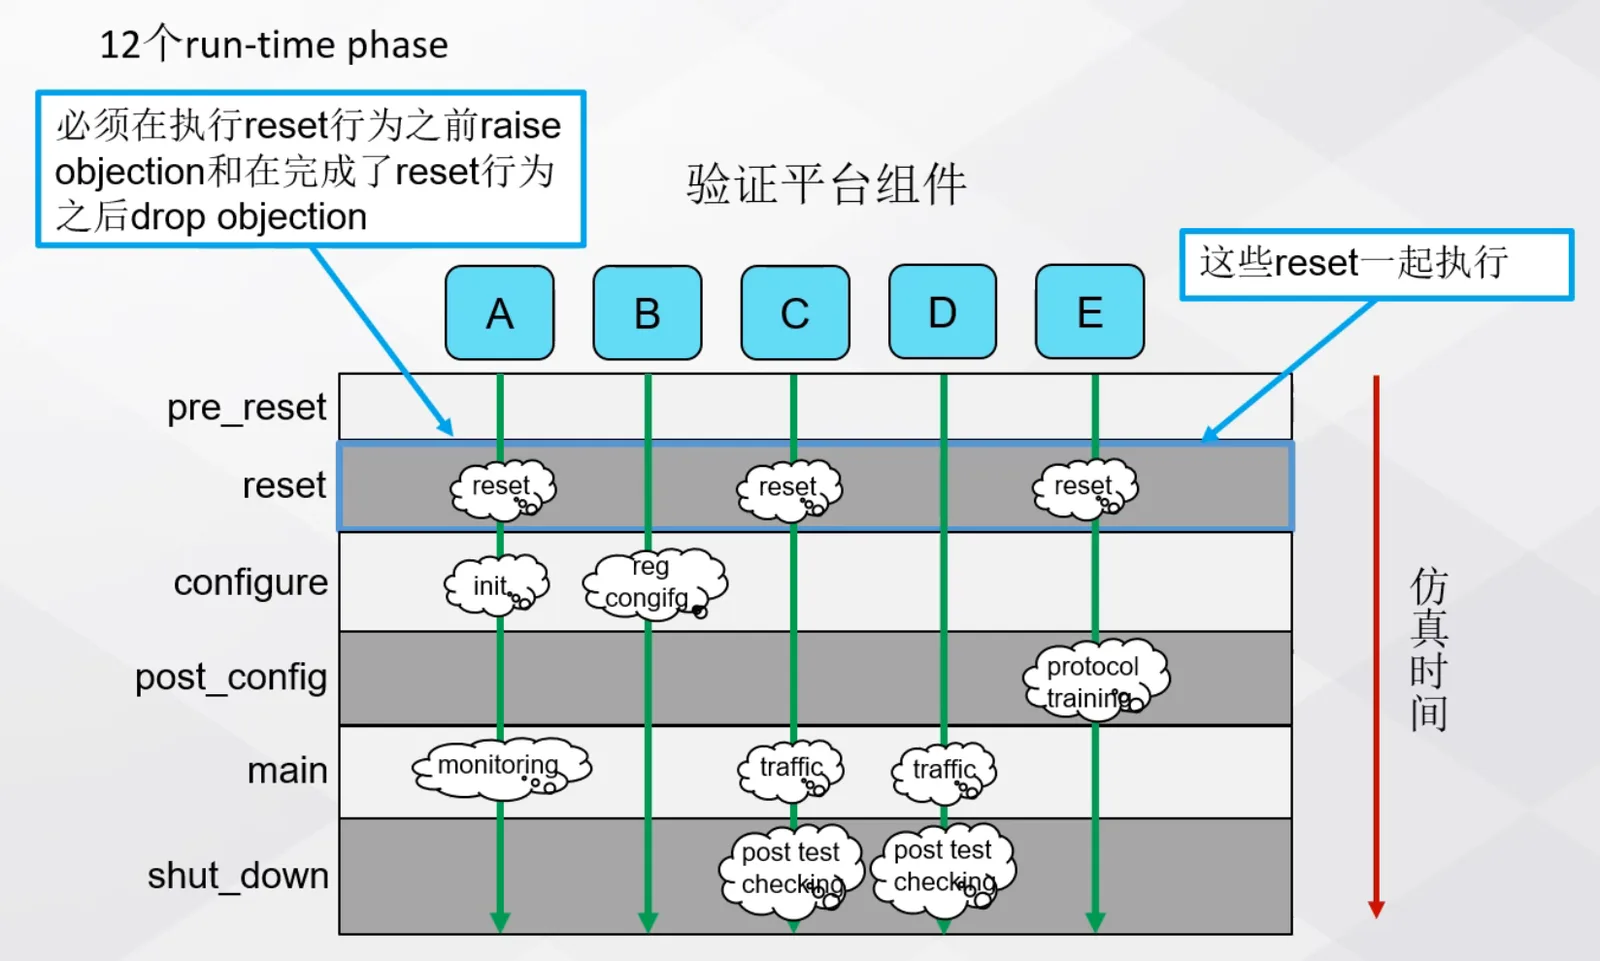
不一定每个组件都要使用全部task phase功能
phase的启动:run_test() —— 一般写在moduel或program中
2.5 UVM objection
UVM task phase具有objection属性。UVM phase的objection属性有两个作用:
- 控制task phase的运行与终止
- 同步各个components同名的task phase
objection的使用方法:
- 在task phase中调用 raise_objection() 和 drop_objection()
- task phase(run_phase)中其他需要执行的语句放在这两个方法之间
UVM objection注意事项:
- Objection对于task phase才有意义,控制task phase的运行和终止。(task phase会消耗仿真时间)
- 先 raise 后耗时:必须在执行消耗仿真时间的语句之前raise objection。
- 忘 drop 卡死:在task phase结束时drop objection,否则永远不会执行下一个phase
- raise/drop成对:在每个task phase中都raise和drop objection一次。
- 同名 phase 全局共享:在一个component中的某个task phase中raise和drop objection会影响到其他component中相同名字的task phase。
此外,派生类一重写,父类body里的raise/drop和上电序列全没了。除非每个派生类都记得写 super.body()
UVM启动sequence时固定按这个顺序调三个: pre_body() → body() → post_body() 父类的 派生类的 父类的
所以一般上电序列都写在pre_body() 中。防止子类没写super.body。
objection注意1:
在每个task phase中都raise和drop objection
举例:
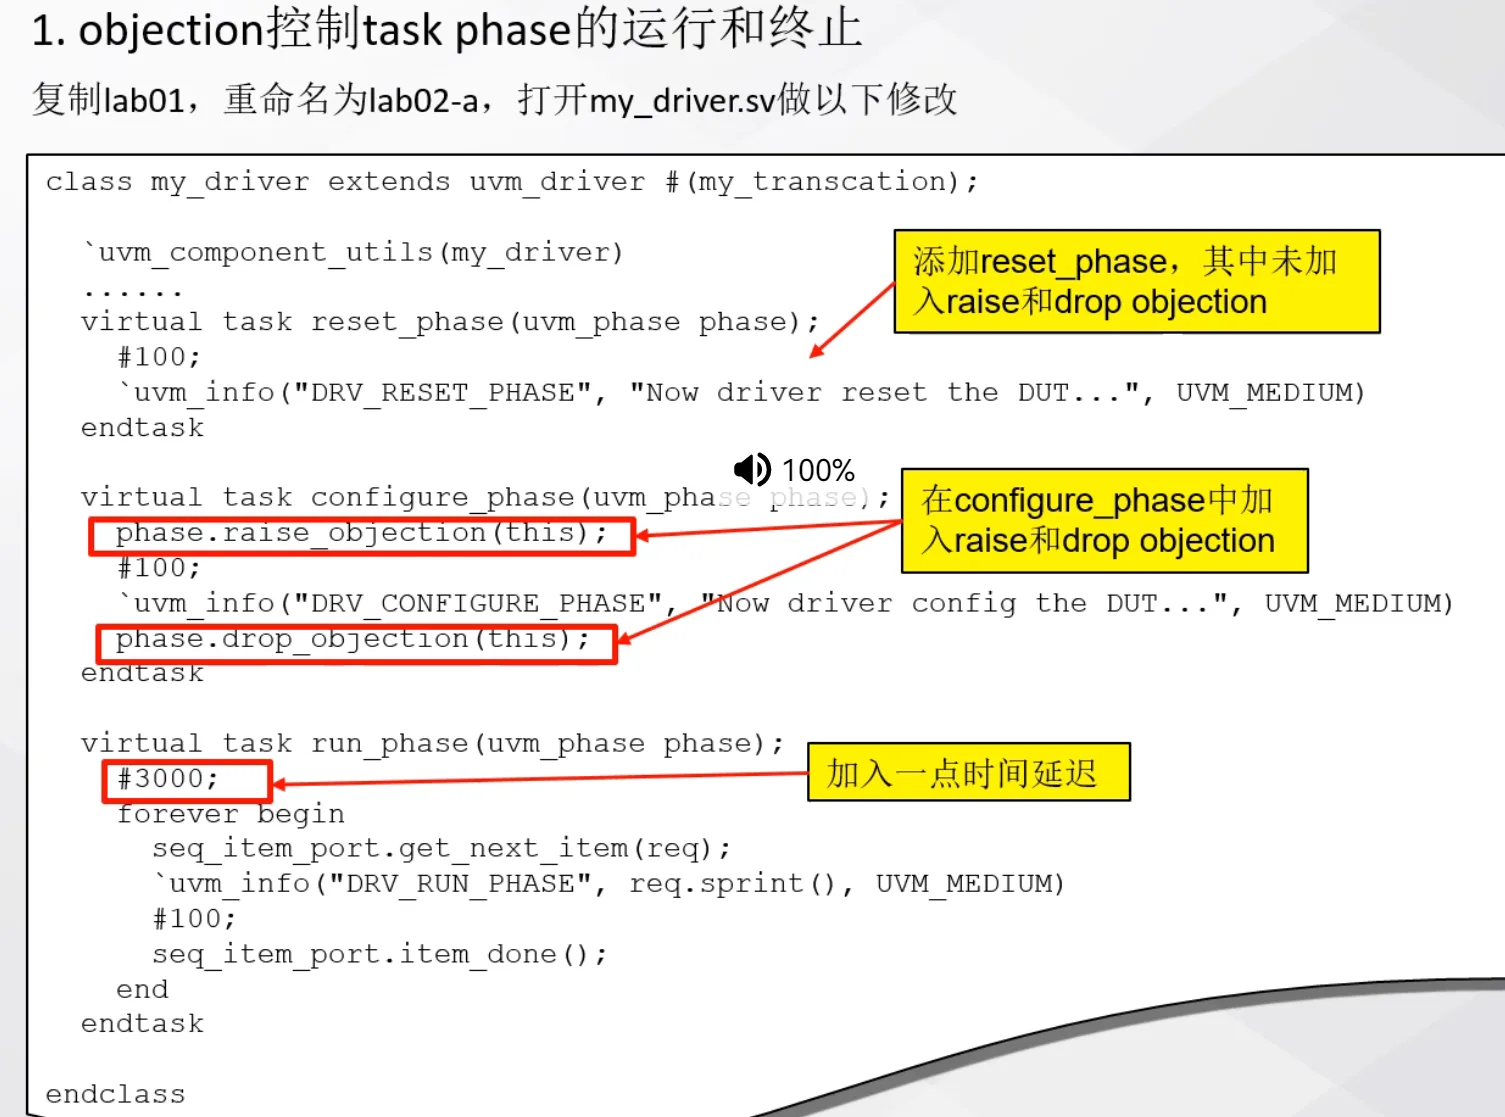
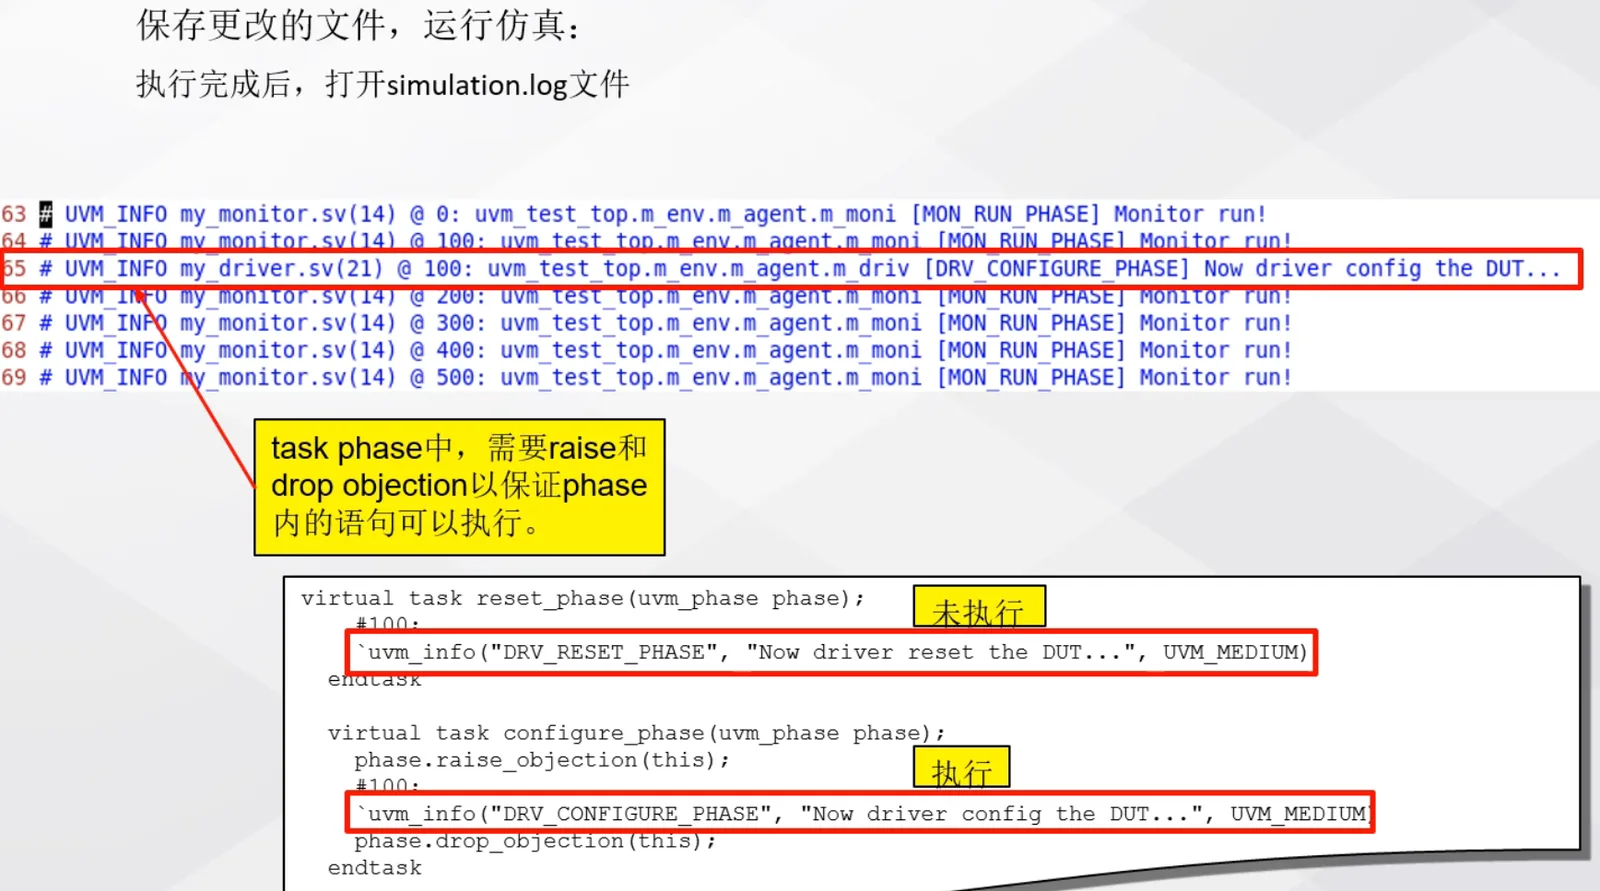
以上例子发现尽管在task phase中reset_phase应该优先于configure_phase执行,但实际reset_phase中的语句并未执行,这表明raise_objection和drop_objection产生了了控制
更改后正常显示:(在每个task phase中都raise和drop objection一次)
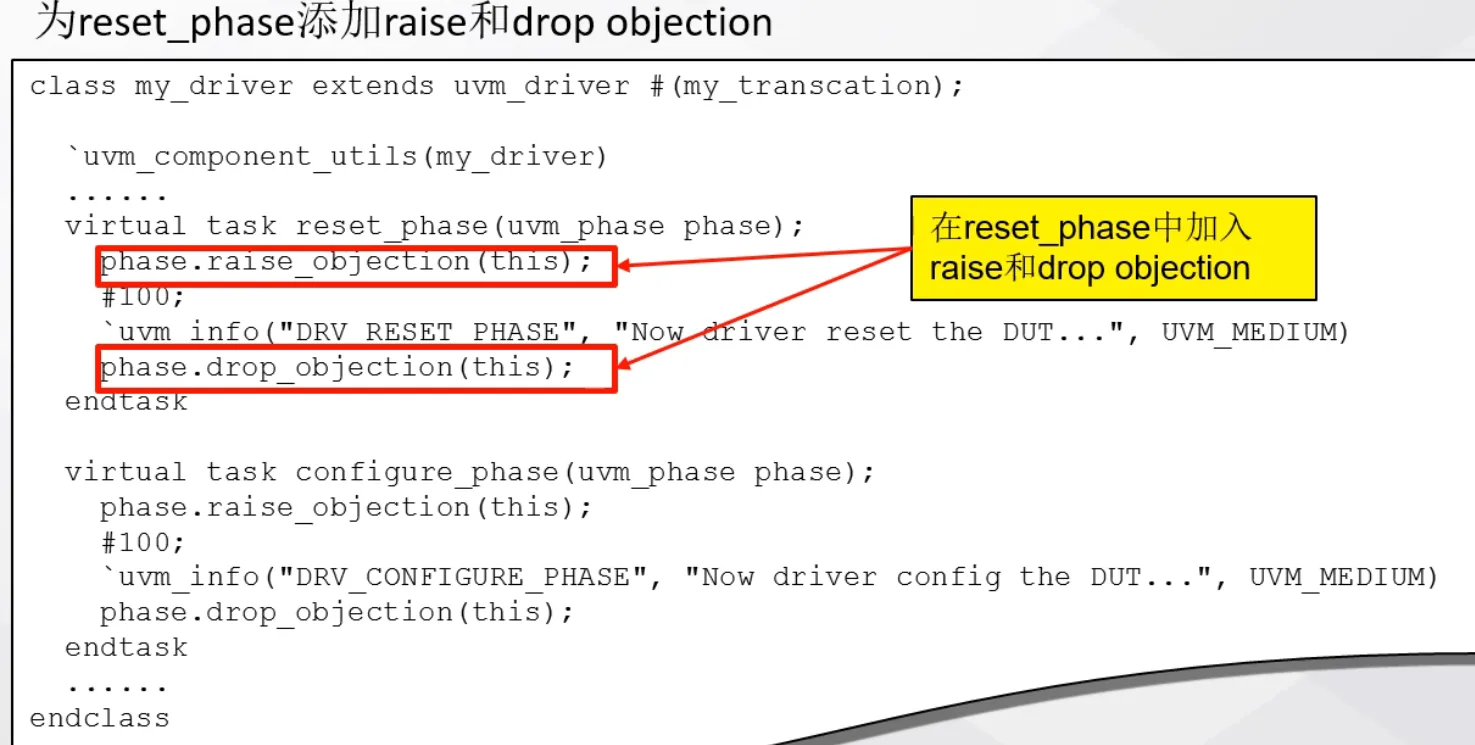
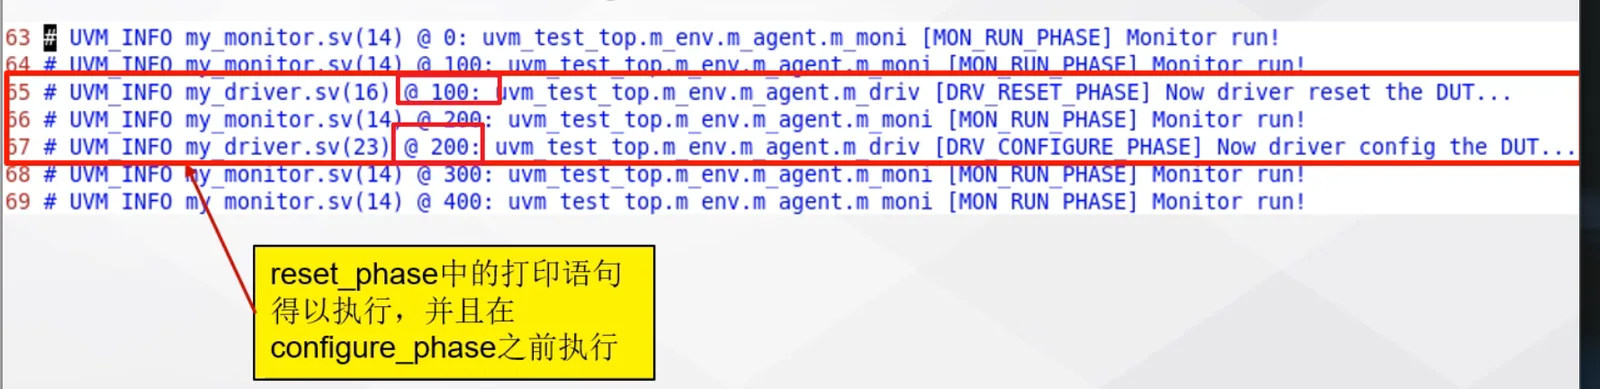
此时configure打印时间为正常的@200处
因此在每个task phase中都raise和drop objection能一定程度上保证其中每个phase中的语句的执行
objection注意2
添加raise和drop objection不一定就能保证代码的执行
必须在执行消耗仿真时间的语句之前raise objection
实验:在task phase代码中添加raise和drop_objection不一定能保证代码被执行。
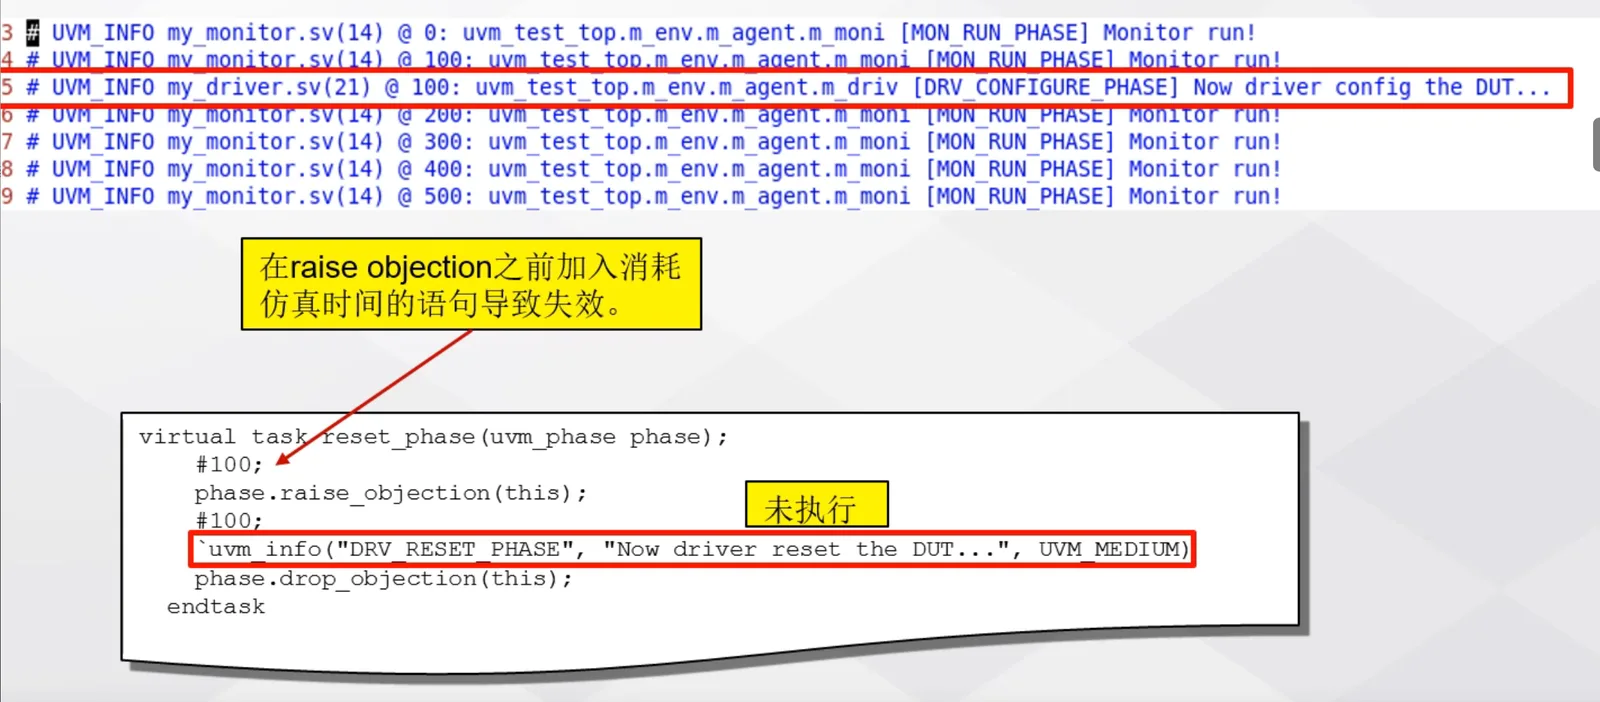
在以上reset_phase例子中,raise_objection之前有一个延迟语句,导致raise和drop中的语句不被执行。
结论:必须要在消耗仿真时间语句之前raise_objection
objection注意3
raise和drop成对使用,否则无法停止仿真
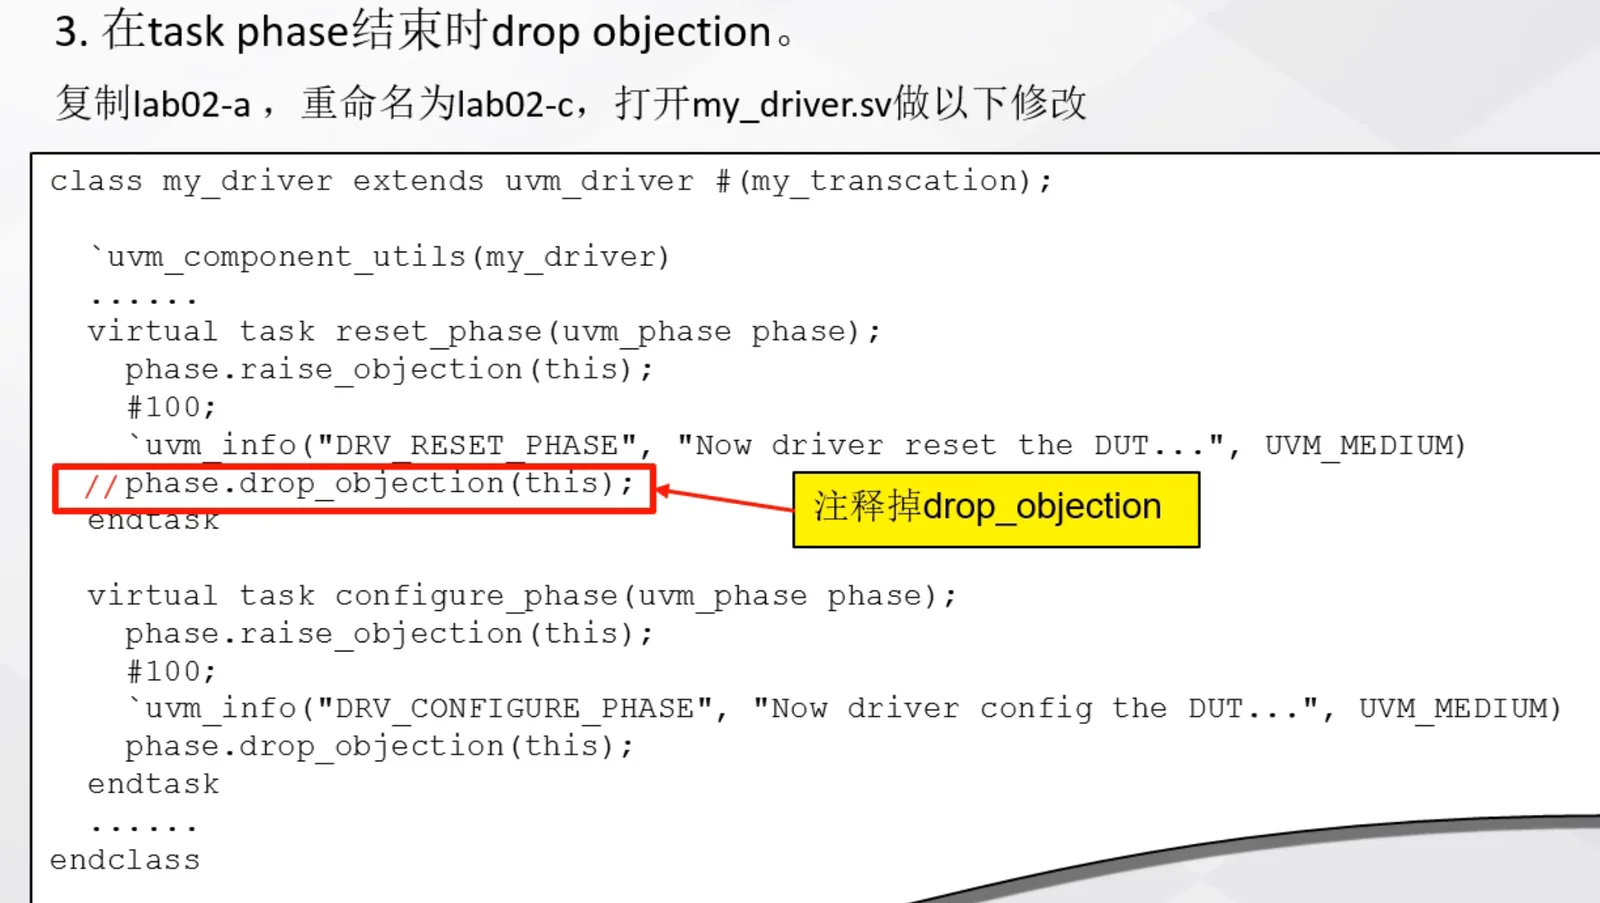
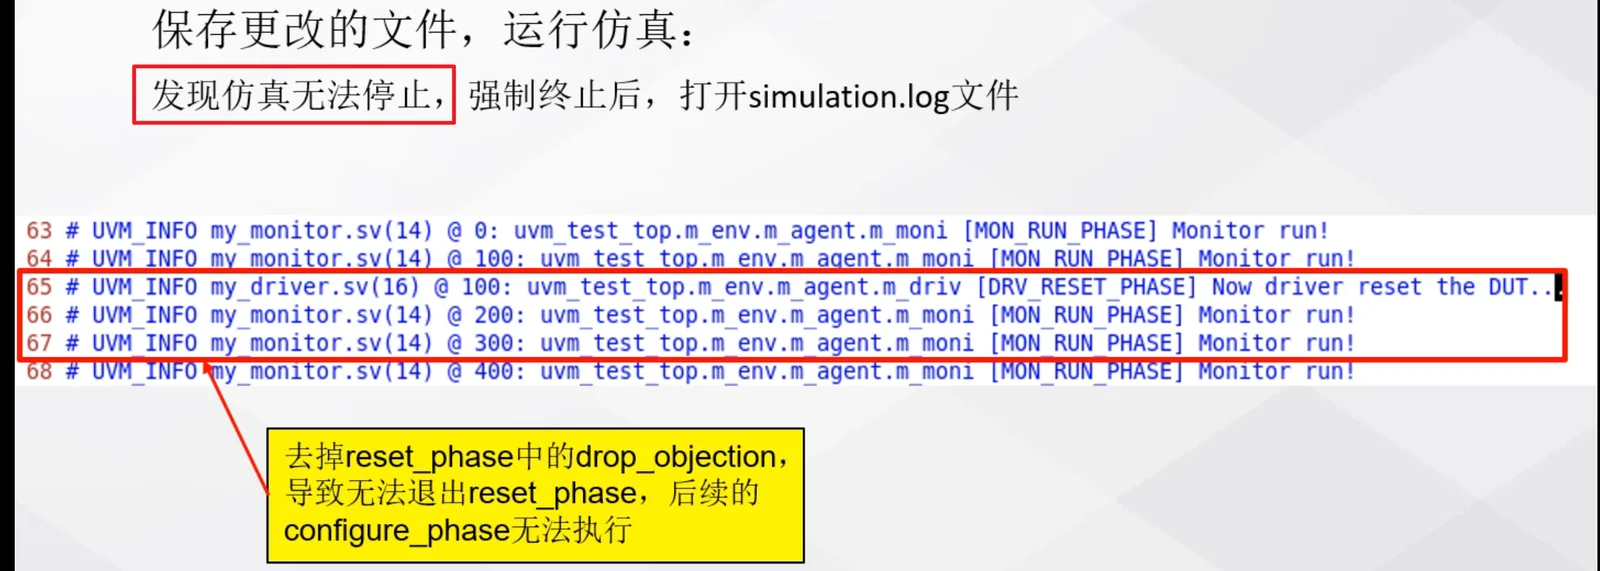
objection注意4
多个组件间的objection机制互相影响:在各个组件中,相同的task phase会并行执行,同时开始和退出。
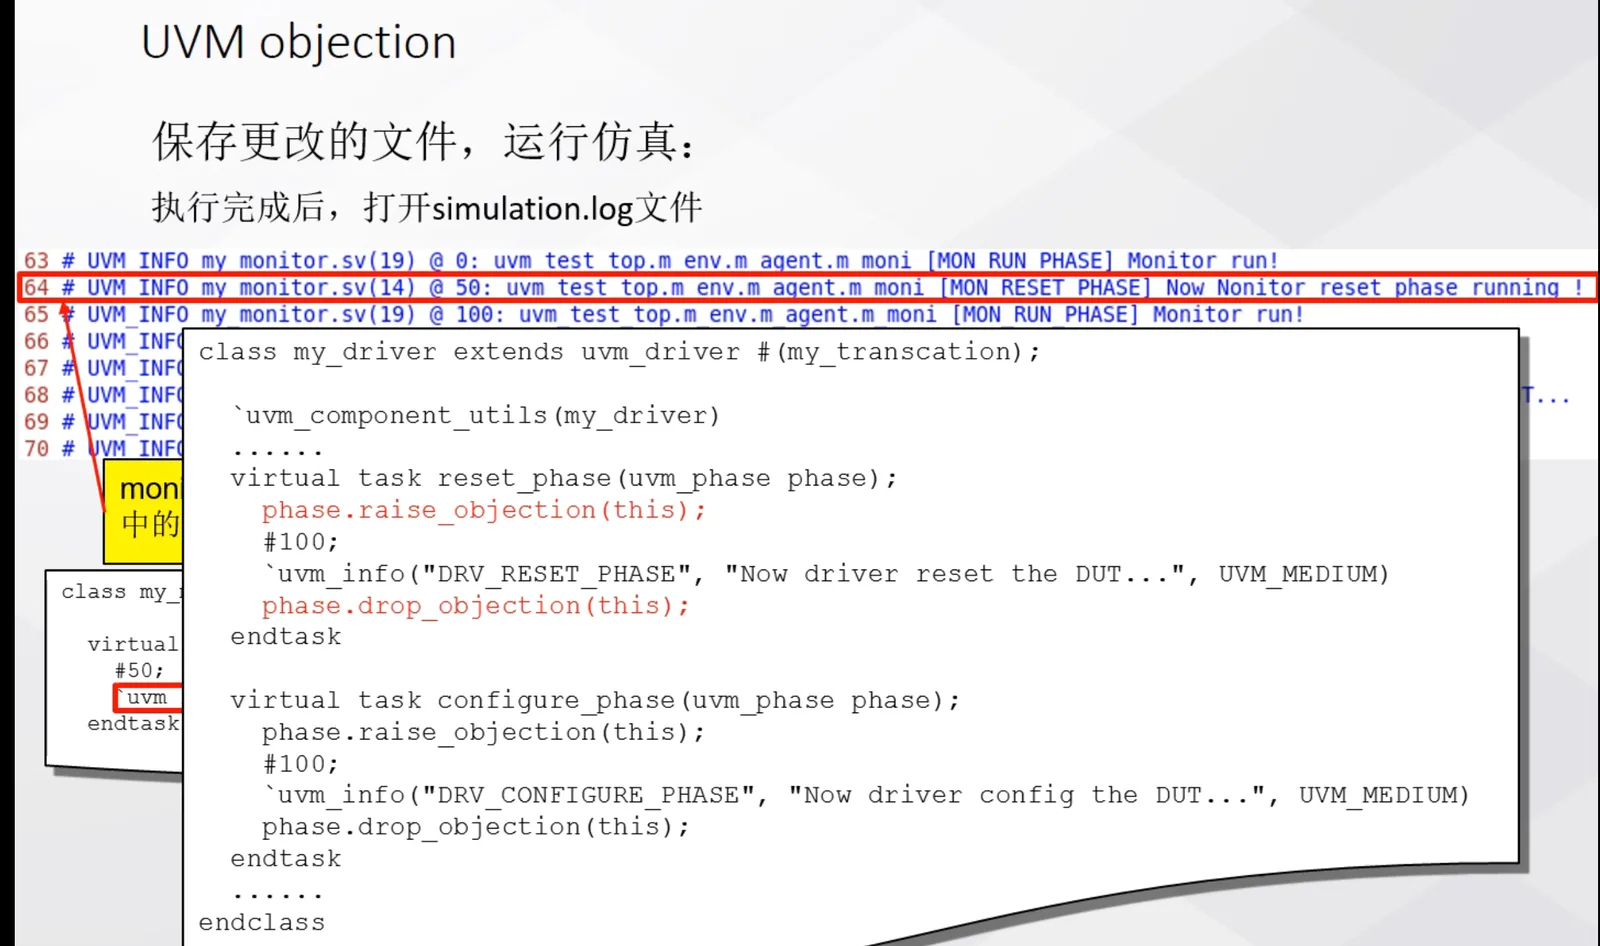
- 即 driver中的reset phase没有退出,则monitor中的reset phase即使没有raise和drop也会执行(因为phase相同名字)
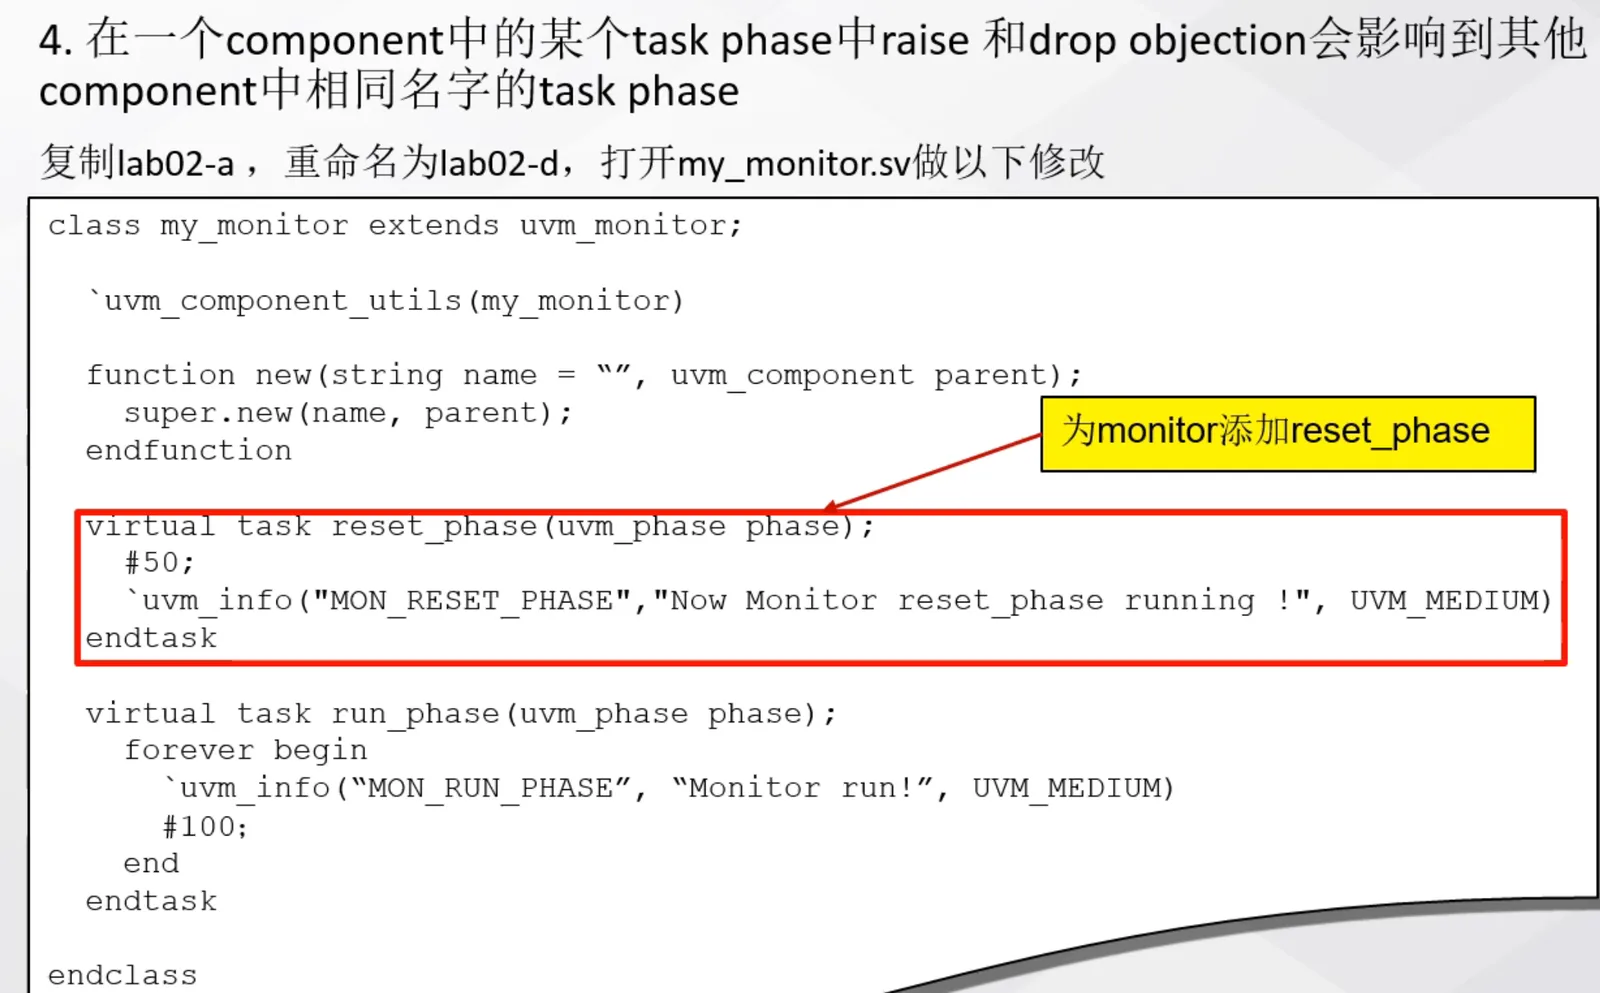
以上reset_phase中并未raise和drop_objection,但还是执行了,原因在于driver中raise和drop了(如下图),所以只要driver中的reset_phase没有退出,则monitor中的就会继续执行
继续实验,将monitor组件中reset_phase的#50改为#150
monitor中的延迟比driver高,导致即使同名,也不能打印monitor中reset_phase语句(# 150时刻已经drop_objection了)
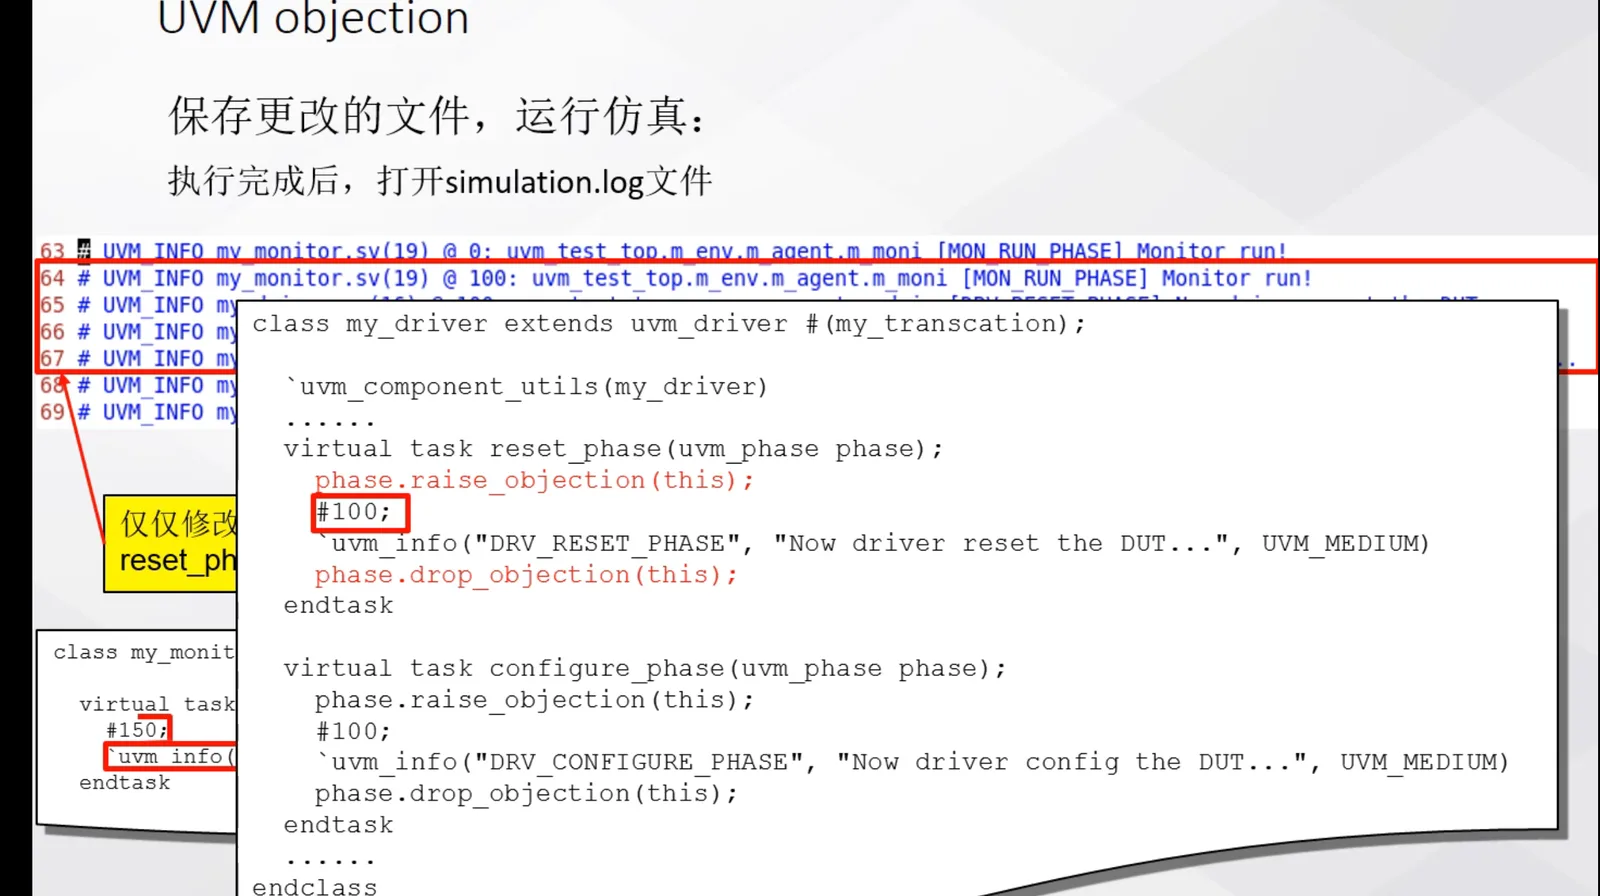
多个组件间的objection机制互相影响:在各个组件中,相同的task phase会并行执行,同时开始和退出。
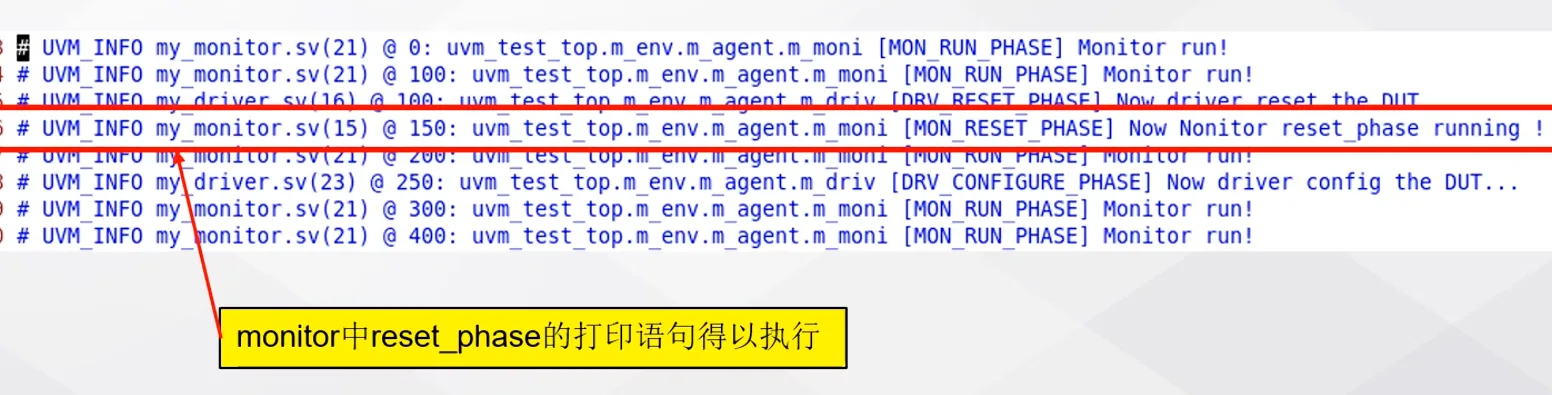
为了避免各个组件phase中的代码完整执行,建议在每个task phase中都raise和drop objection一次
修改代码在monitor中增加raise和drop_objection后,发现可 正常打印了,且结束时间为monitor的@150
objection使用原则总结
在使用objection时应该遵循的原则:
- 尽量在每个task phase使用raise_objection和drop_objection
- 不要在拥有无限循环的task phase中使用raise_objection和drop_objection
- raise / drop_objection成对使用
- 每个phase中尽量只使用一次
- 先raise后耗时
3. UVM factory机制
3.1 概念
- UVM工厂机制可以使用户在不更改代码的情况下实现不同对象的替换
- 在UVM中,组件的创建通常非常复杂,需要管理父子关系、配置和构建。通过使用 factory机制,组件的创建可以统一管理,减少了手动实例化和维护对象的复杂性
- 即 通过 UVM工厂在仿真时指定不同的
sequencer类型或选择不同的monitor- 实现UVM平台的重用性:在不改变原来平台的代码的情况下即可实现不同激励的产生。
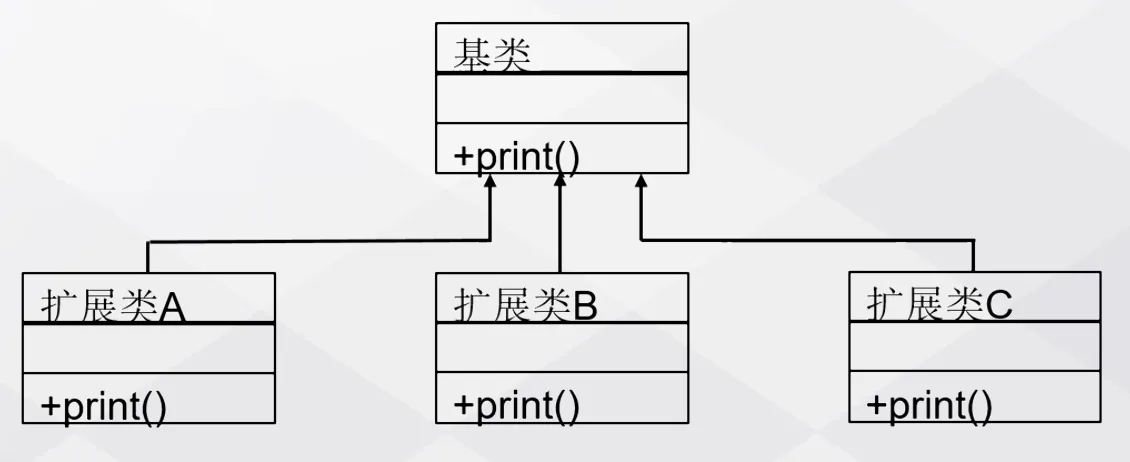
- factory机制是UVM的一种数据结构。它的作用范围是整个平台空间,它有且仅有一个实例化对象(即单实例类)。它是一个多态构造器,可仅仅使用一个函数让用户实例化很多不同类型的对象。
并不是所有实现代码复用性的机制都是 factory机制。factory只是其中一种
为了使用一个函数而可以返回多种对象, 这些对象必须从一个基类扩展而来。(正如一个面包厂不可以生产汽车一样)
3.2 原理
factory机制是UVM的一种数据结构,其原理是包含了 两张表格 和 相关函数,
-
注册表和替换表,
- 注册表 (Y)记录了已注册的类,比如注册的test顶层,env等组件
- 替换表(X extends Y)记录了替换关系(替换的类之间需要有继承关系)。
`uvm_component_utils (my_driver) 这串代码的作用就是将 当前类 注册在factory的注册表中、
- 注:像是sequence和transaction这样的非component就使用:uvm_object_utils(my_transaction_da3) 来注册
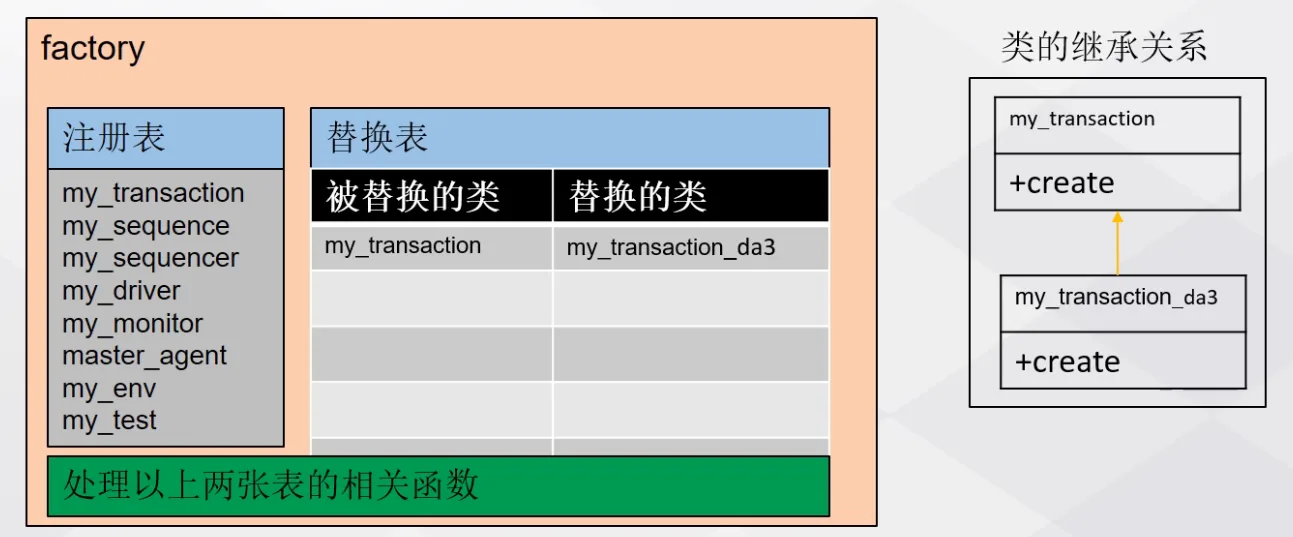
factory机制的运作步骤
- 注册:将用户自定义的类向factory的注册表进行注册。(uvm_component/object _utils)
- 实例化对象:要使用”class_name::type_id::create()”来代替new实例化对象。(这种方法是专门为factory机制服务的)
- 替换:根据具体要求向替换表添加替换条目。(override机制)
- set_type_override_by_type(…); —— all object
- set_inst_override_by_type(…); —— designated path object
- 一般来说,override函数都是在build_phase中使用的 4.在运行仿真时, UVM会根据这两张表自动的实现factory机制。
使用factory机制需要注意的几点:
- 用户需要向注册表注册。(uvm_ component/object _utils(类名))
- 用户需要向替换表添加项目。 (override)
- 继承关系:被替换对象的类型是替换对象类型的基类。
3.3 使用
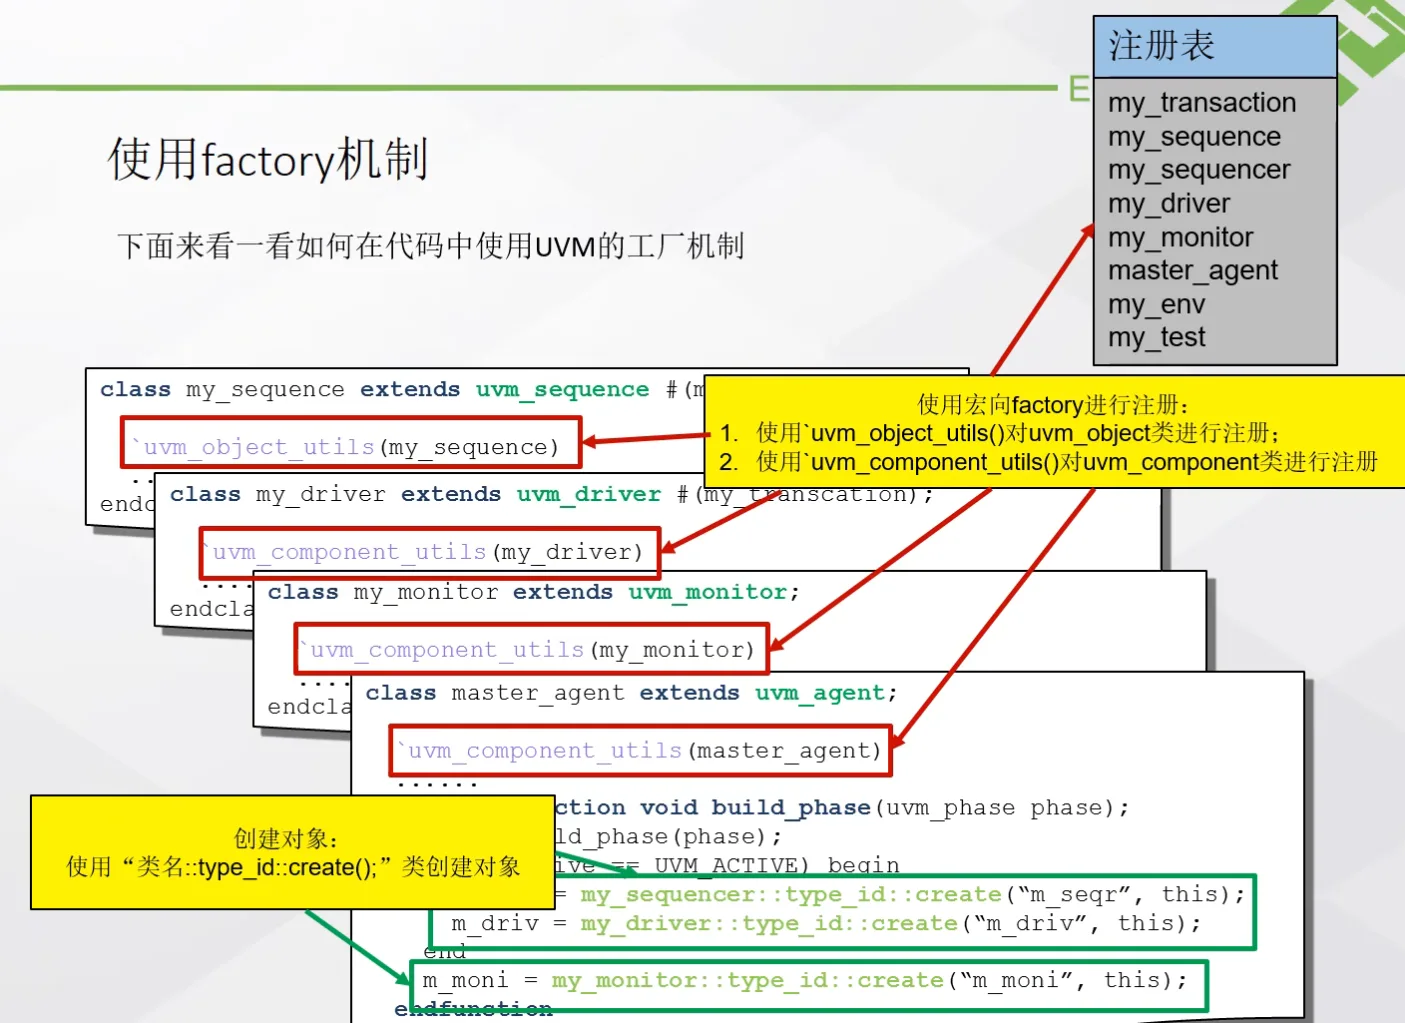
注册factory的宏:
- uvm_component_utils() 针对component类进行注册 ;
- uvm_object_utils() 针对object类进行注册
宏的作用如下:
- 为注册的类 创建一个typy_id静态代理类:(因为type_id是代替new构造函数的,所以称为代理类)
- 创建一个注册类 的对象 并将该对象向factory注册(了解即可)
- type_id 内建 create函数,该函数的任务是 根据替换表 创建指定类的对象
- 创建一个静态函数get_type()
- 创建一个函数get_object_type() , 只不过不是静态函数
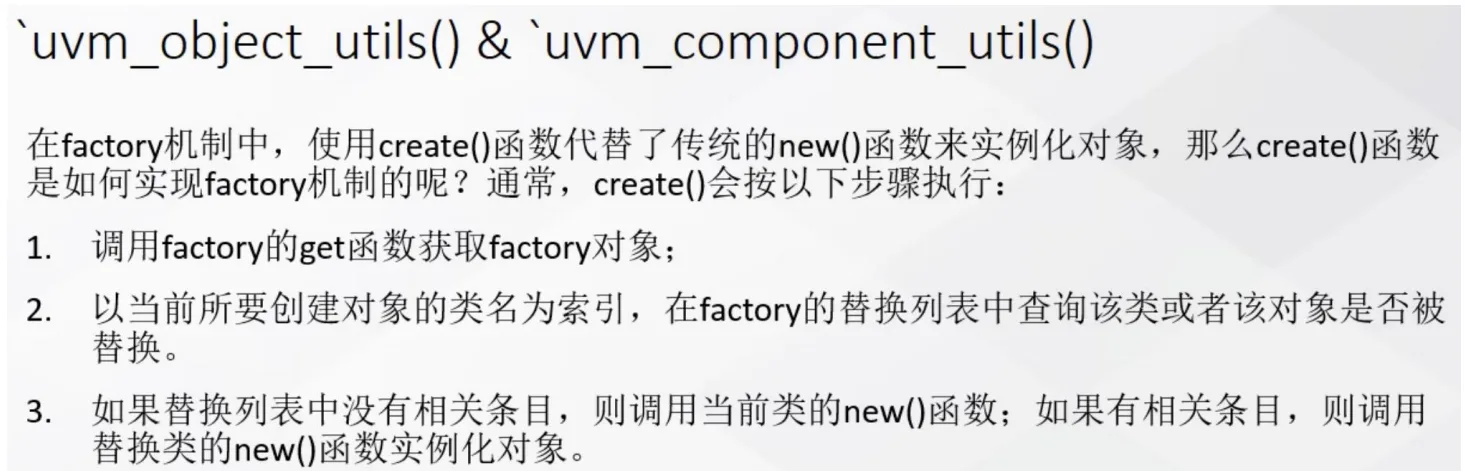
此外,若要注册一个参数话的类需要使用:
- uvm_component_param_utils() 针对component类进行注册 ;
- uvm_object_param_utils() 针对object类进行注册
这两个宏分别用在哪类:
uvm_object_utils(~): 用于 uvm_sequence / transuvm_component_utils(base_test): 用于uvm_test/ env / agent … / uvm_sequencer
带 field 的注册写法:
`uvm_object_utils_begin(my_transaction)
      `uvm_field_int(dmac, UVM_ALL_ON)
      `uvm_field_int(smac, UVM_ALL_ON)
      `uvm_field_int(ether_type, UVM_ALL_ON)
      `uvm_field_array_int(pload, UVM_ALL_ON)
      `uvm_field_int(crc, UVM_ALL_ON)
 `uvm_object_utils_end
3.4 factory 机制与 override 机制
在factory替换列表中添加替换项
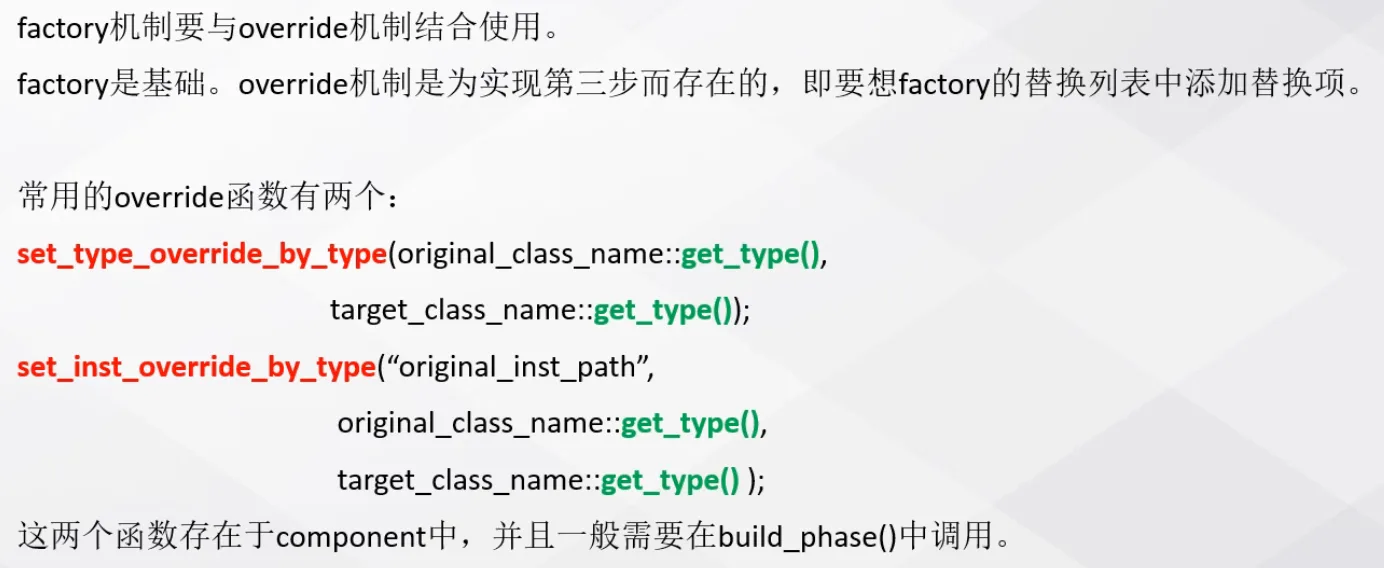
1.override使用:
辅助理解:用后面的去替换前面的(前面是被替换对象)
一般来说,override函数都是在build_phase中使用的
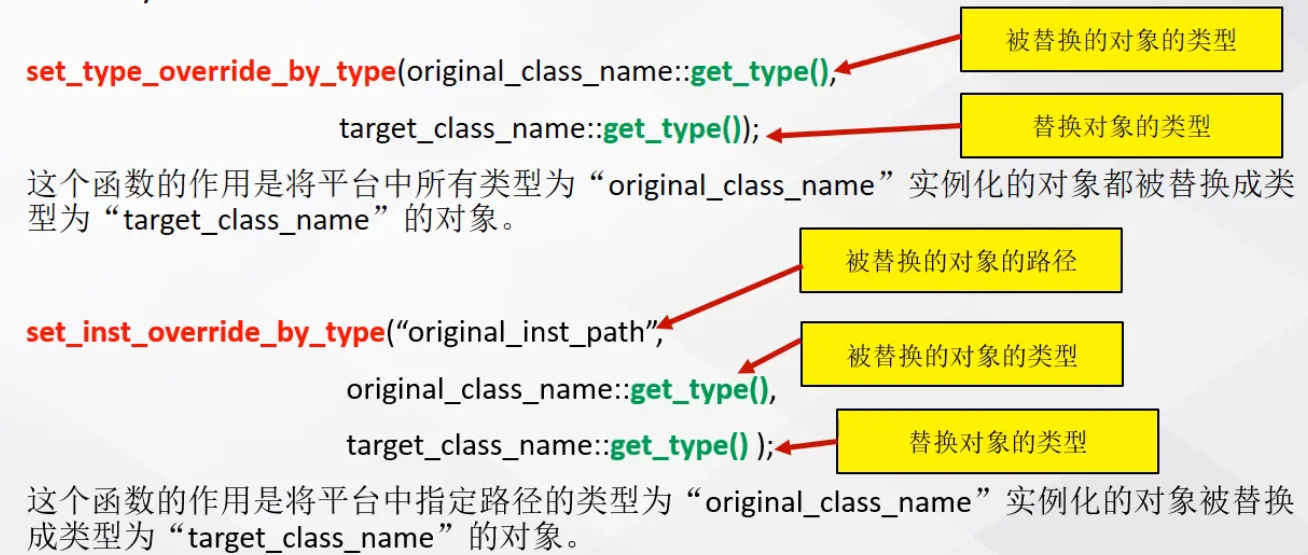
- 对于set_type:替换全部对象
- 而对于set_inst:替换具体路径的对象
若没有事先使用`uvm_component_utils(my_driver)来注册,则以上get_type()静态函数无法生效。
2.set_type机制举例
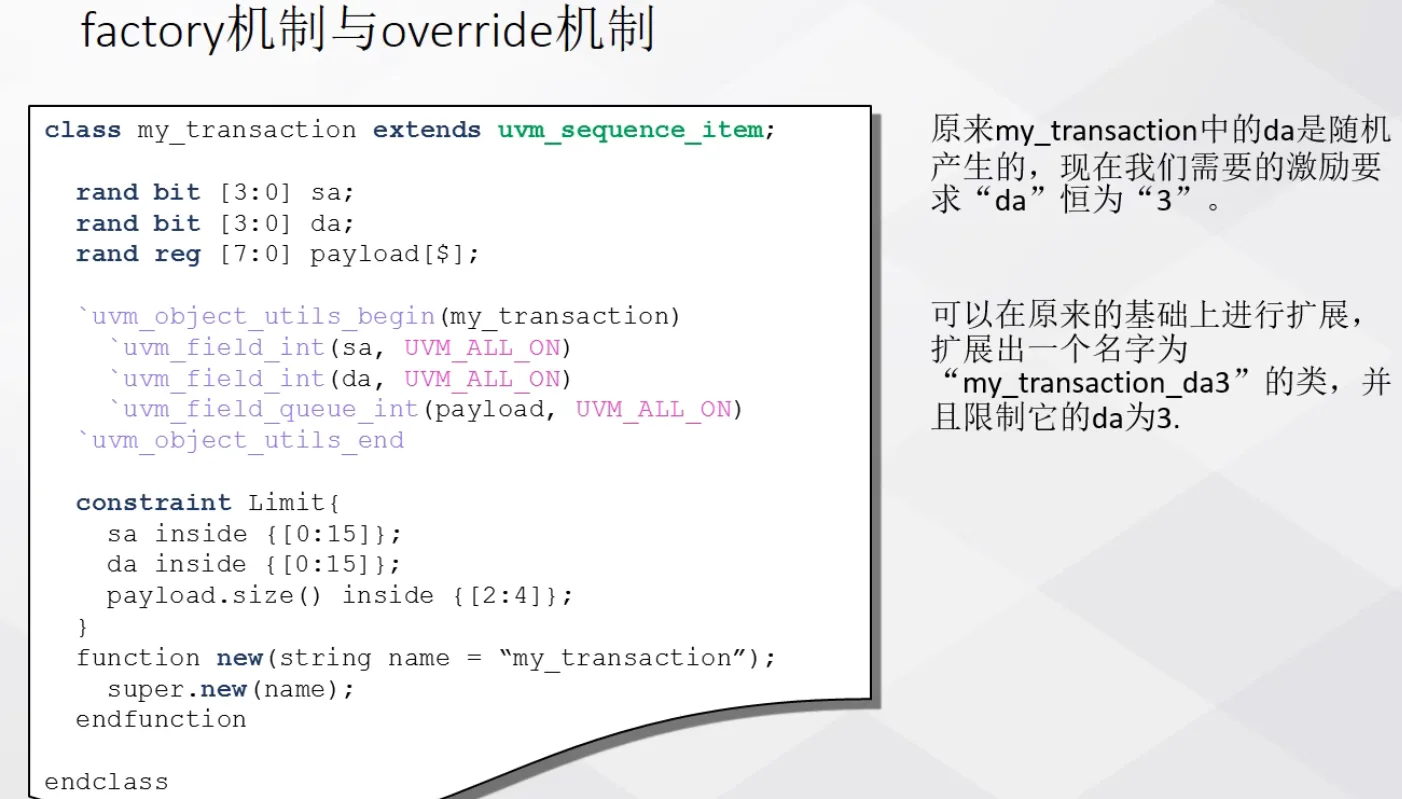
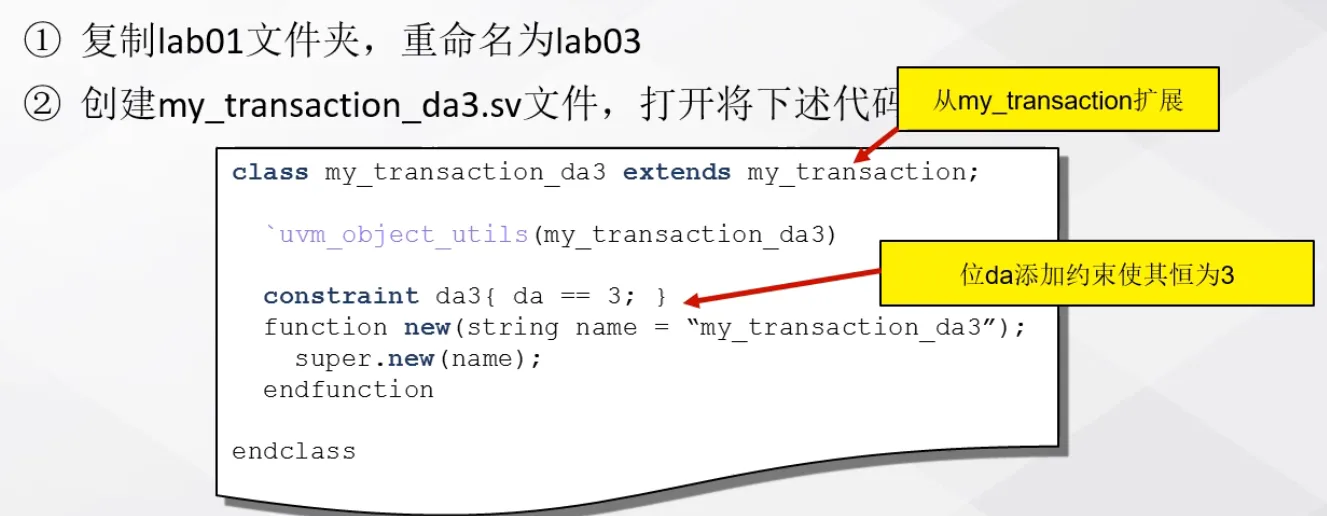
这里也可以从uvm_test基类中拓展
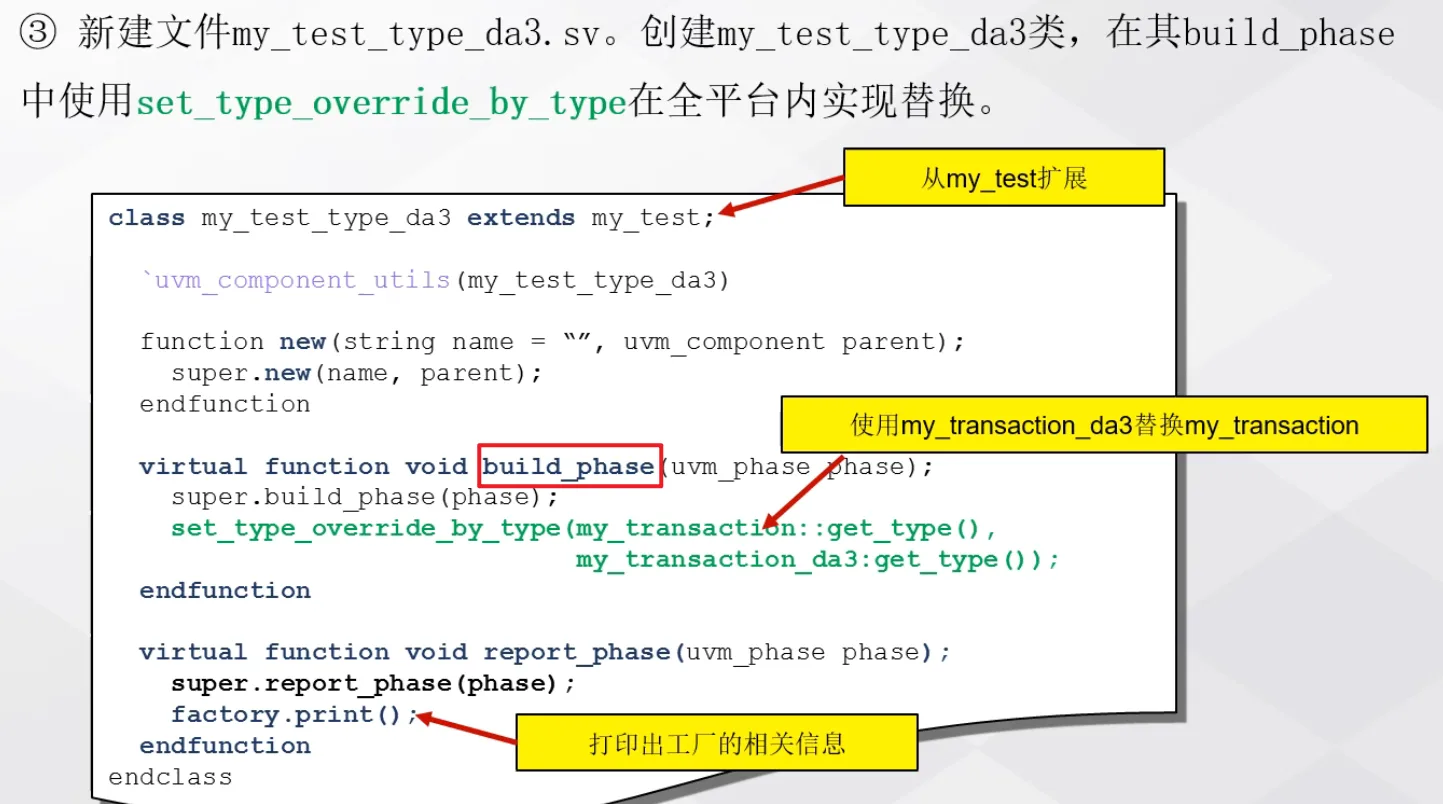
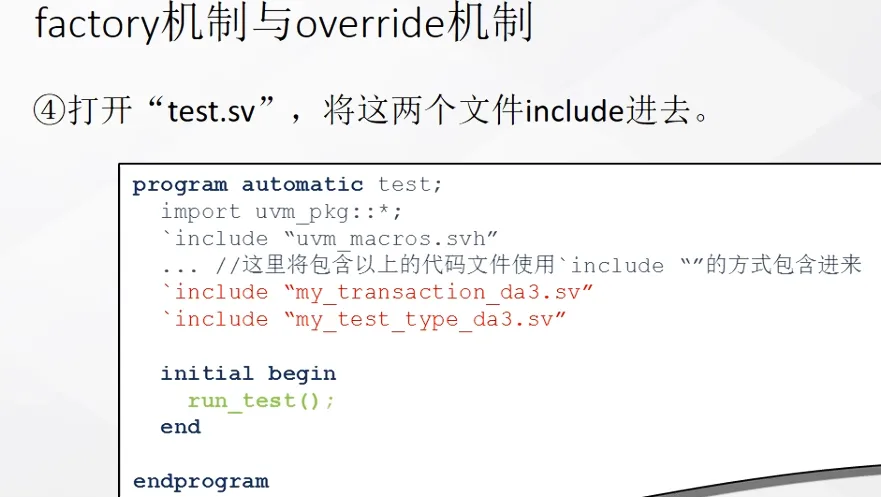
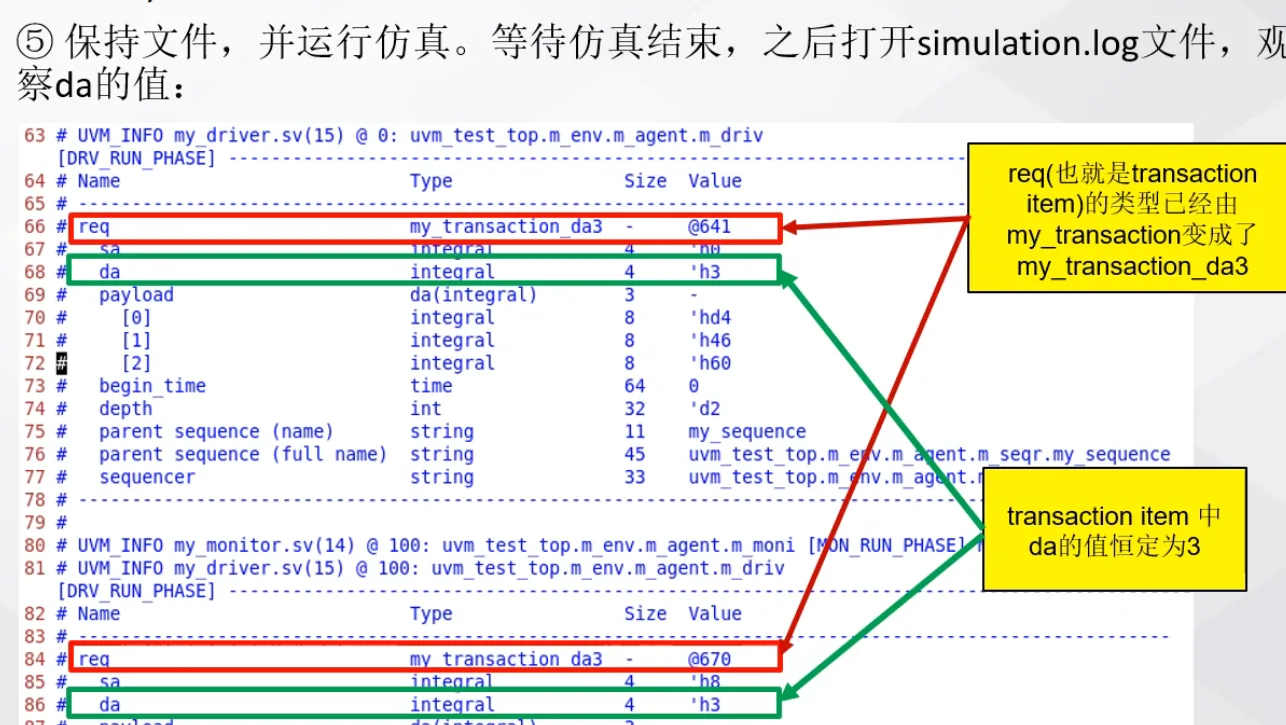
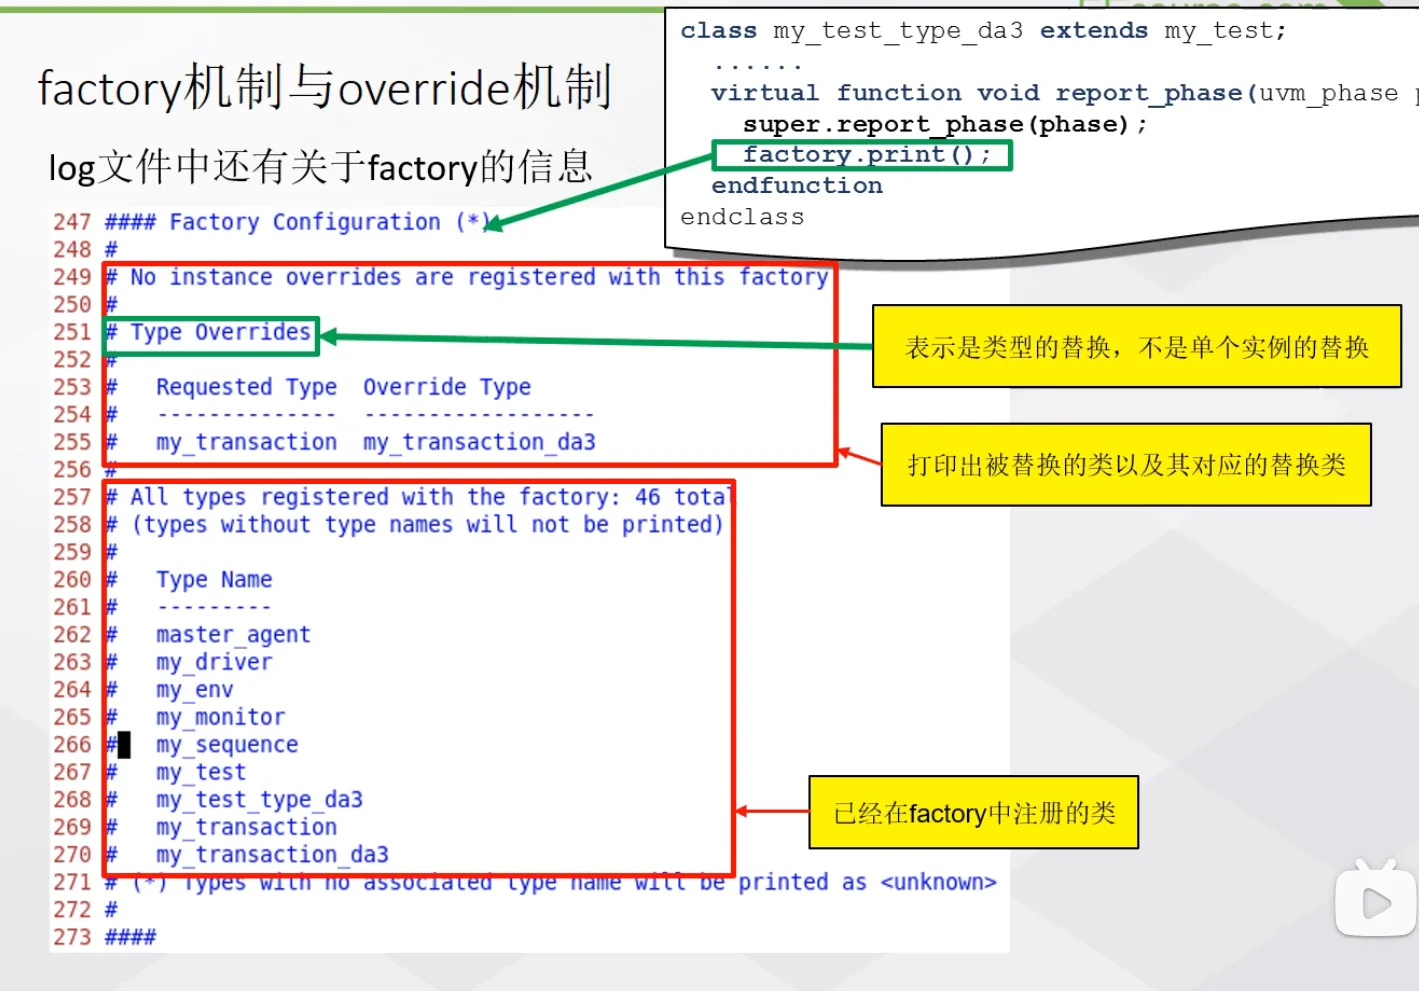
调用的factory的print函数查看override是否成功
查看factory中已注册的类
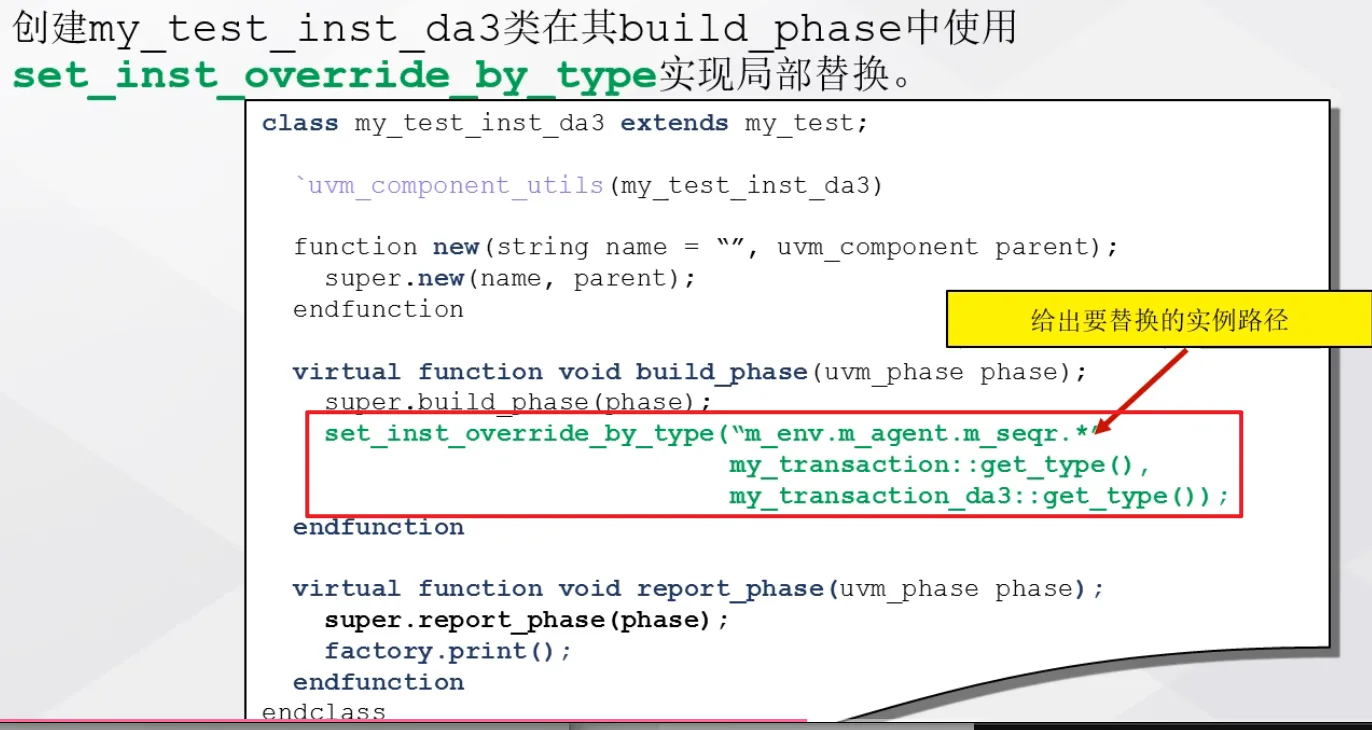
3.set_inst例
如果仅仅希望替换master_agent中sequencer中的transaction类型而不是整个平台中的呢?这时候需要使用set_inst_override_by_type.
可以把这个路径看作是一个范围
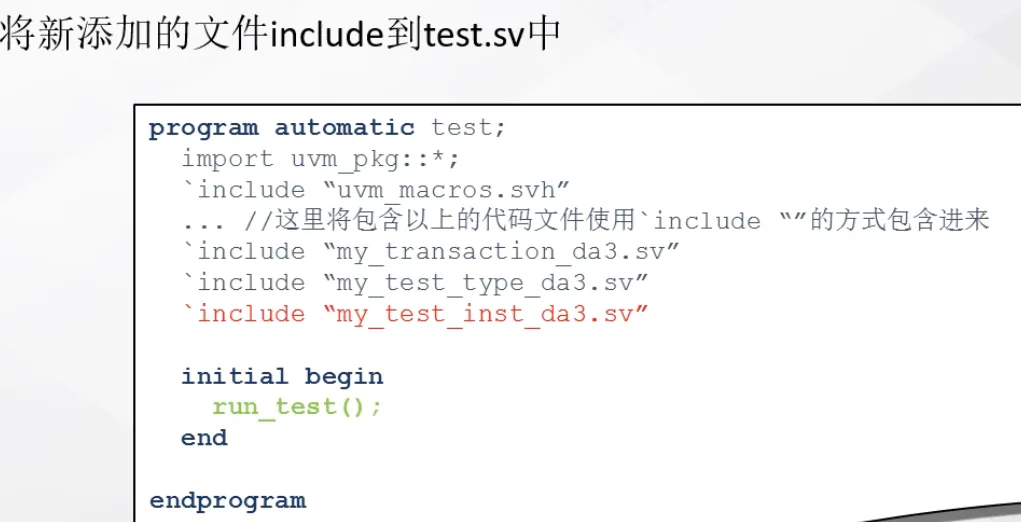
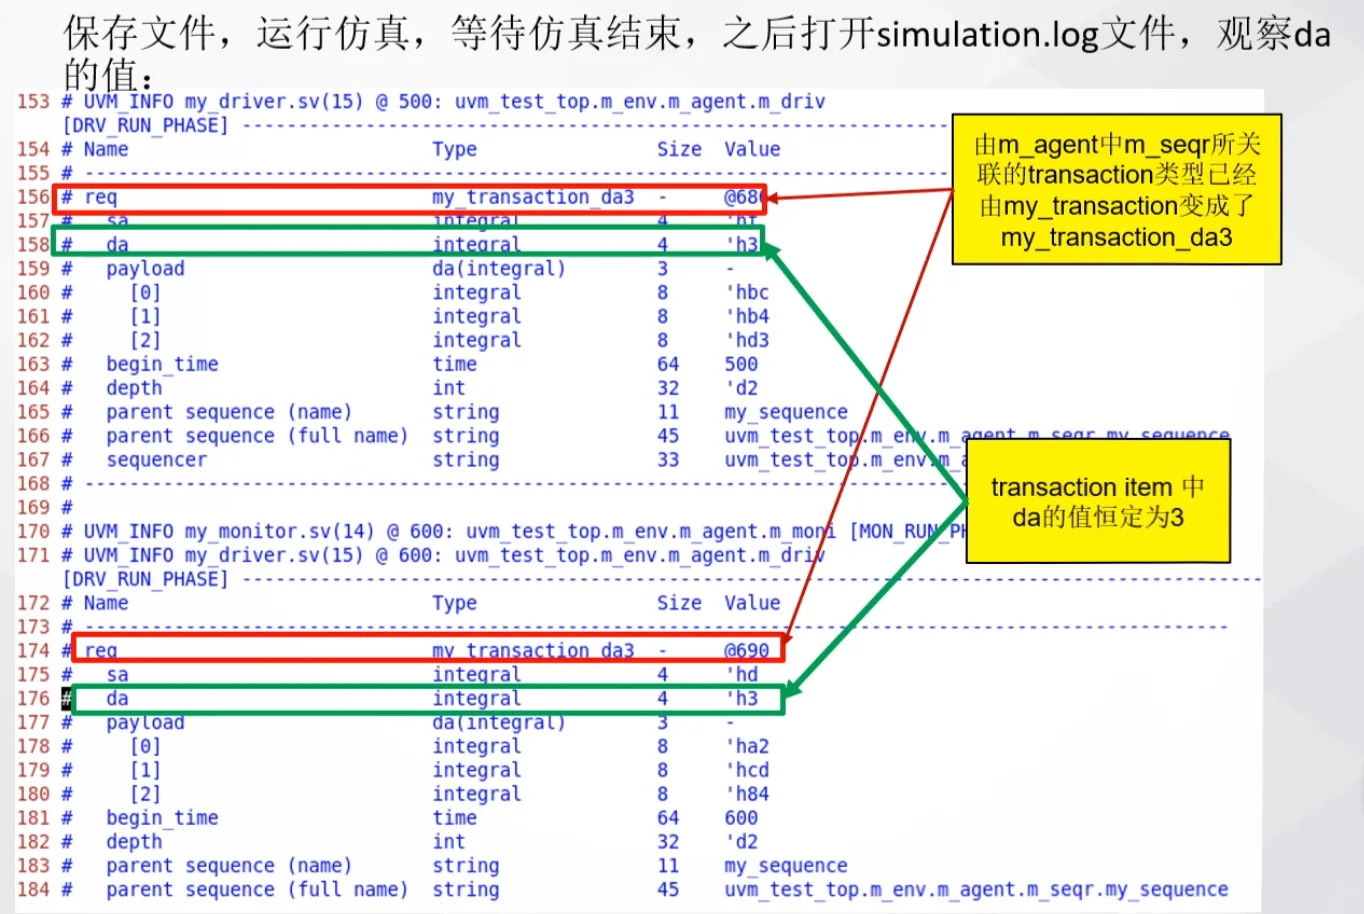
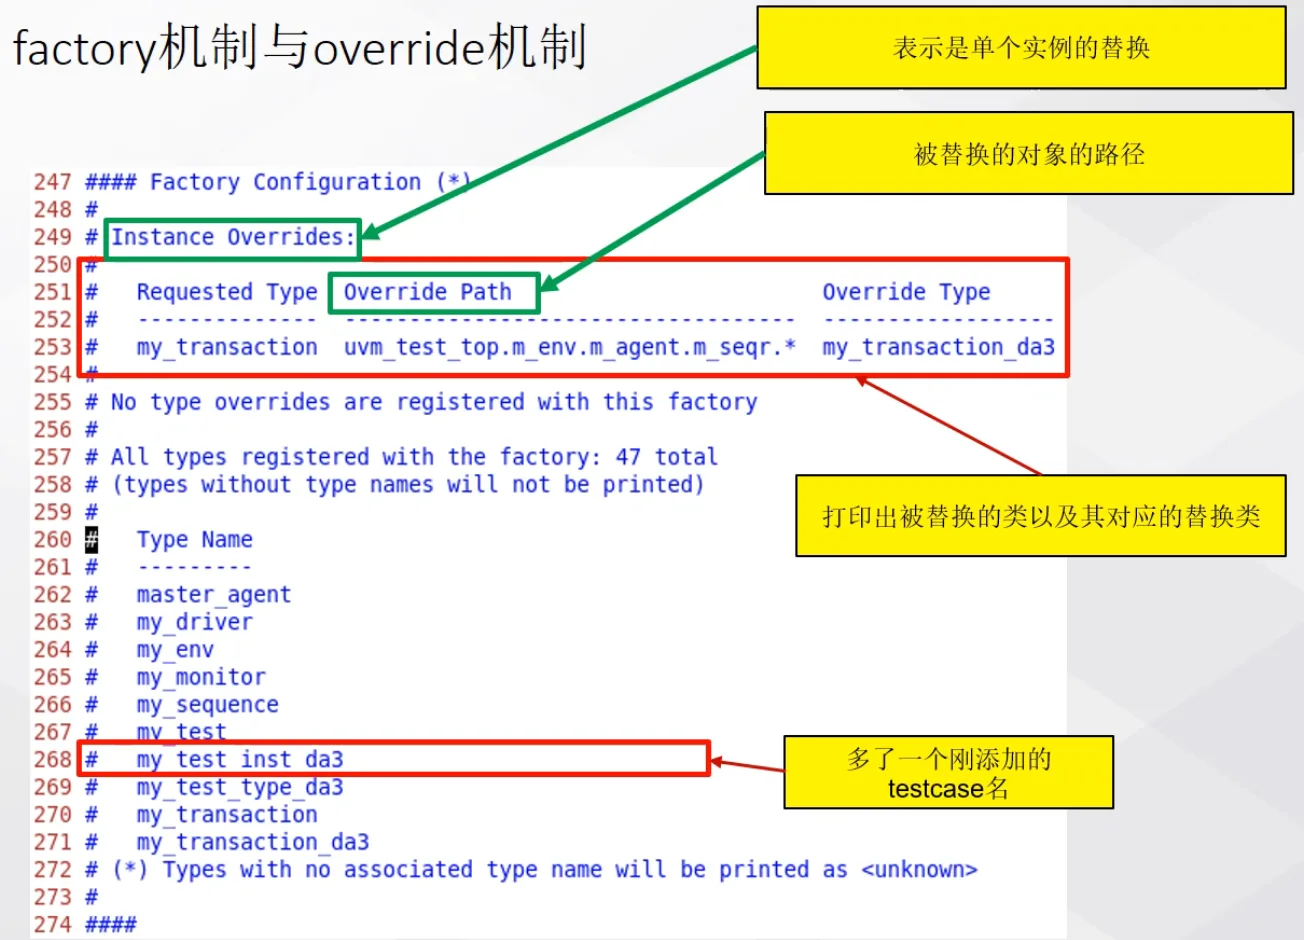
4.factory与override机制总结
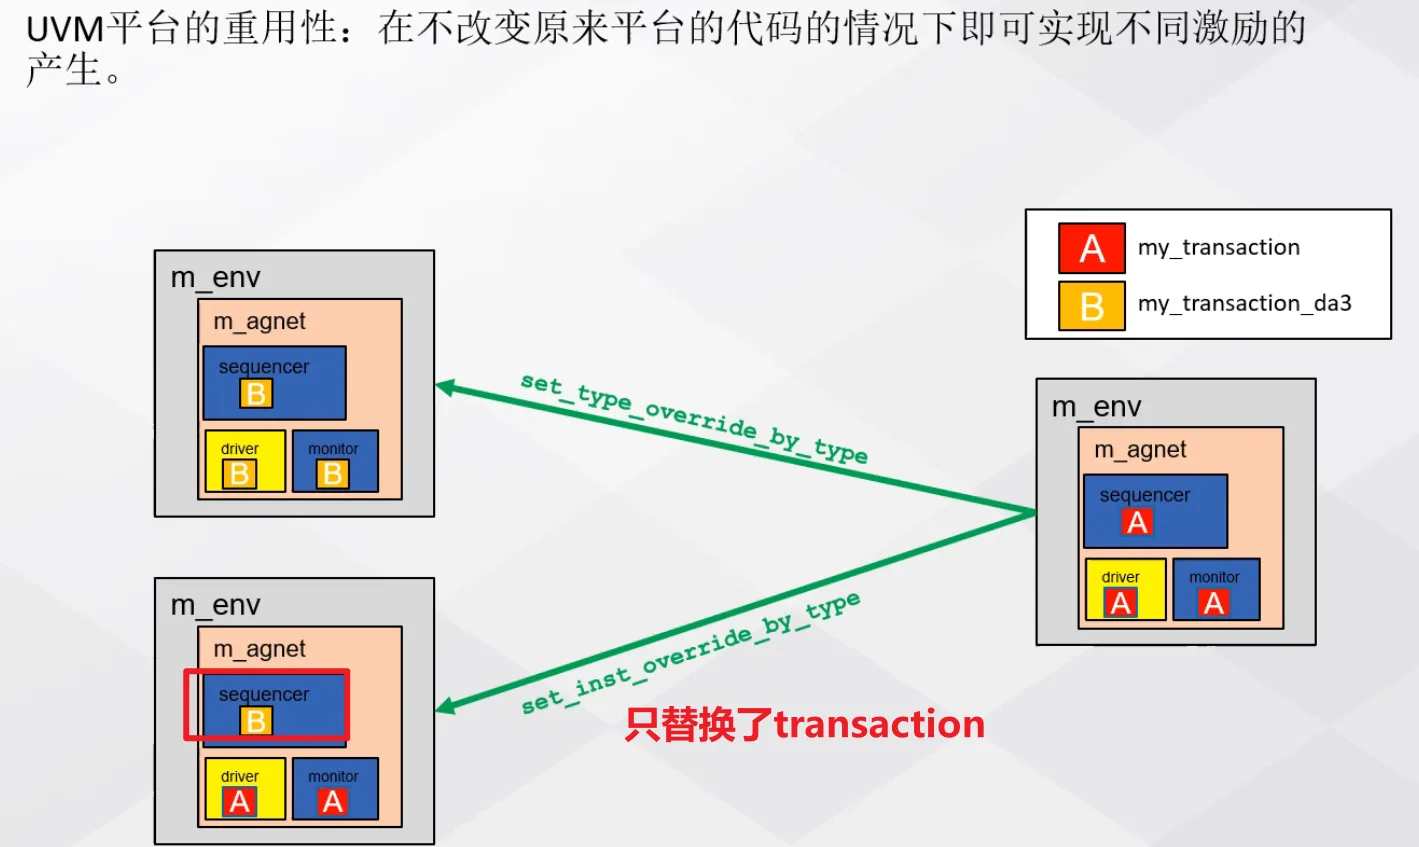
4. UVM事务
4.1 概念
事务是一系列具有一定关系和功能的数据集合。(比如AXI事物)事务是UVM验证平台各个组件间通信的基本单元
将具有一定关系的功能的数据包打包在一起的过程就称为事物级建模
4.2 事务从UVM_sequence_item扩展
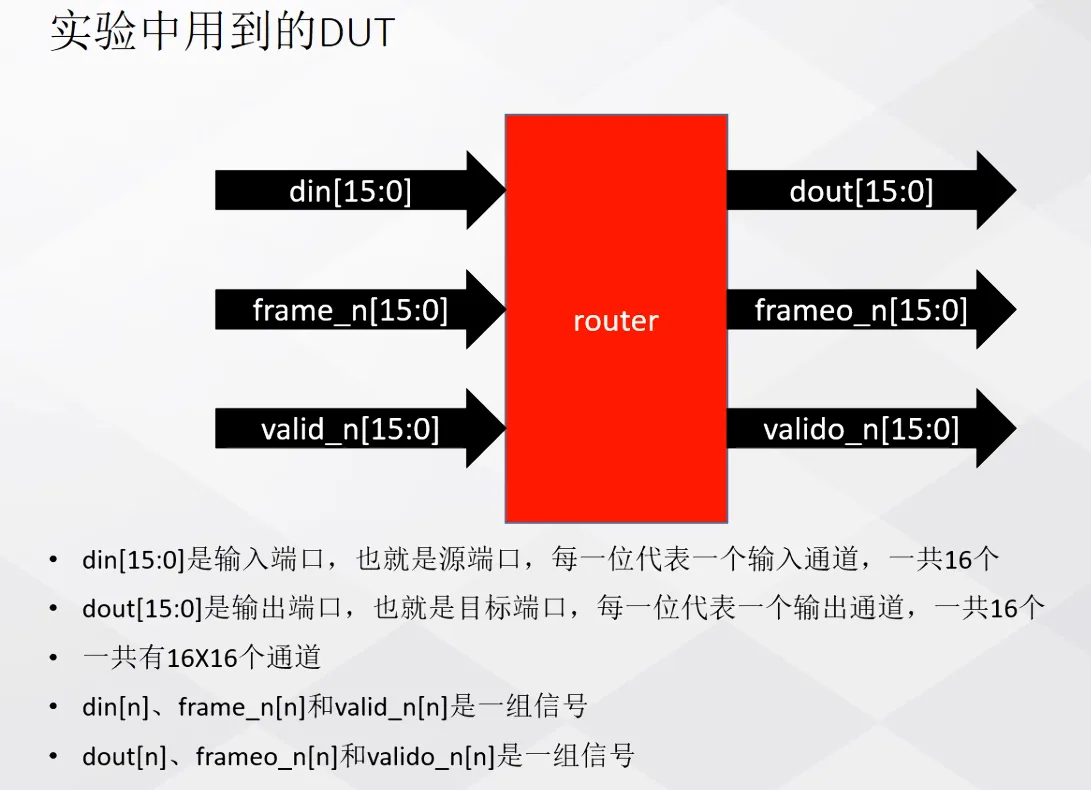
用户对事物进行建模是通过class来进行的
4.3 受约束的随机事务
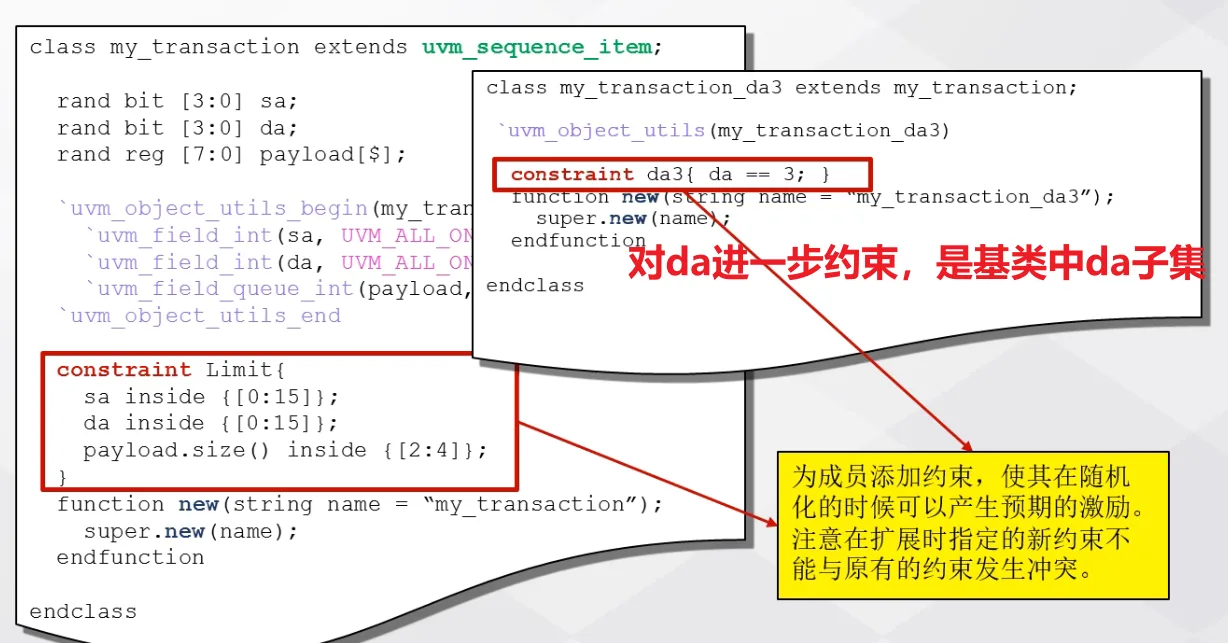
拓展基类项不能与基类项的约束发生冲突
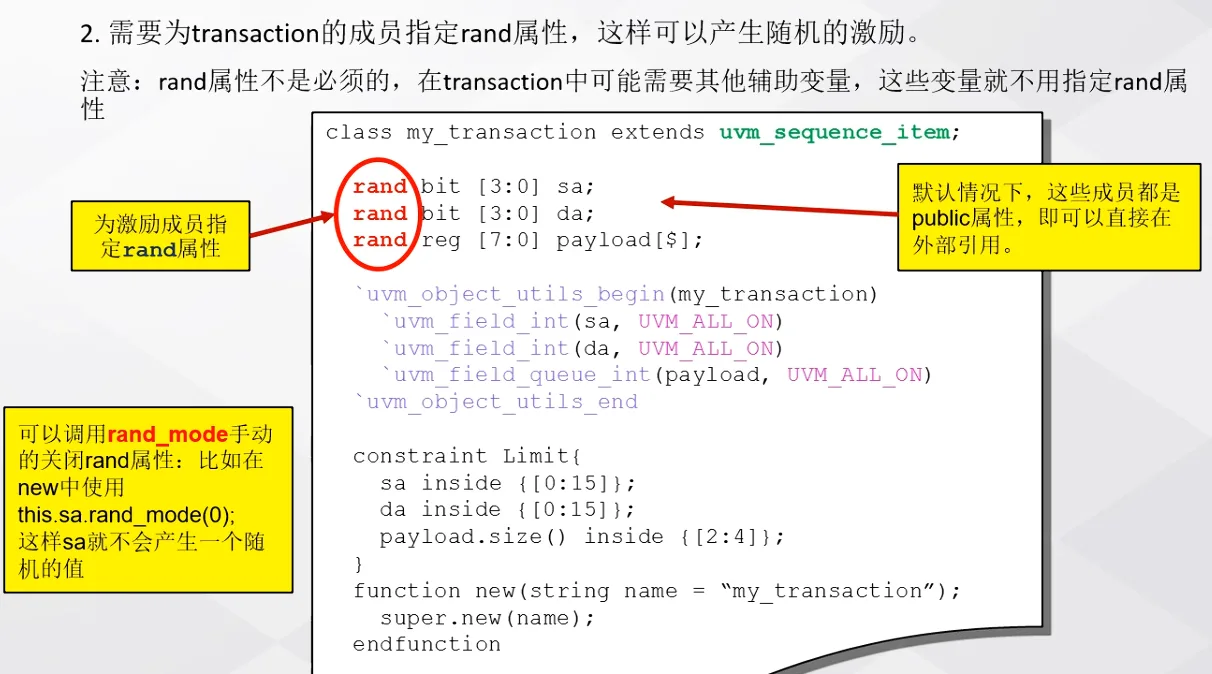 在本节例子中,以上信号sa代表源端口,da代表目标端口,payload代表传输的数据
4.4 field automation机制(宏)
UVM field automation机制是为了方便用户对事务进行 打印、复制、打包、解压、比较、记录等一系列功能而建立的一套服务机制。
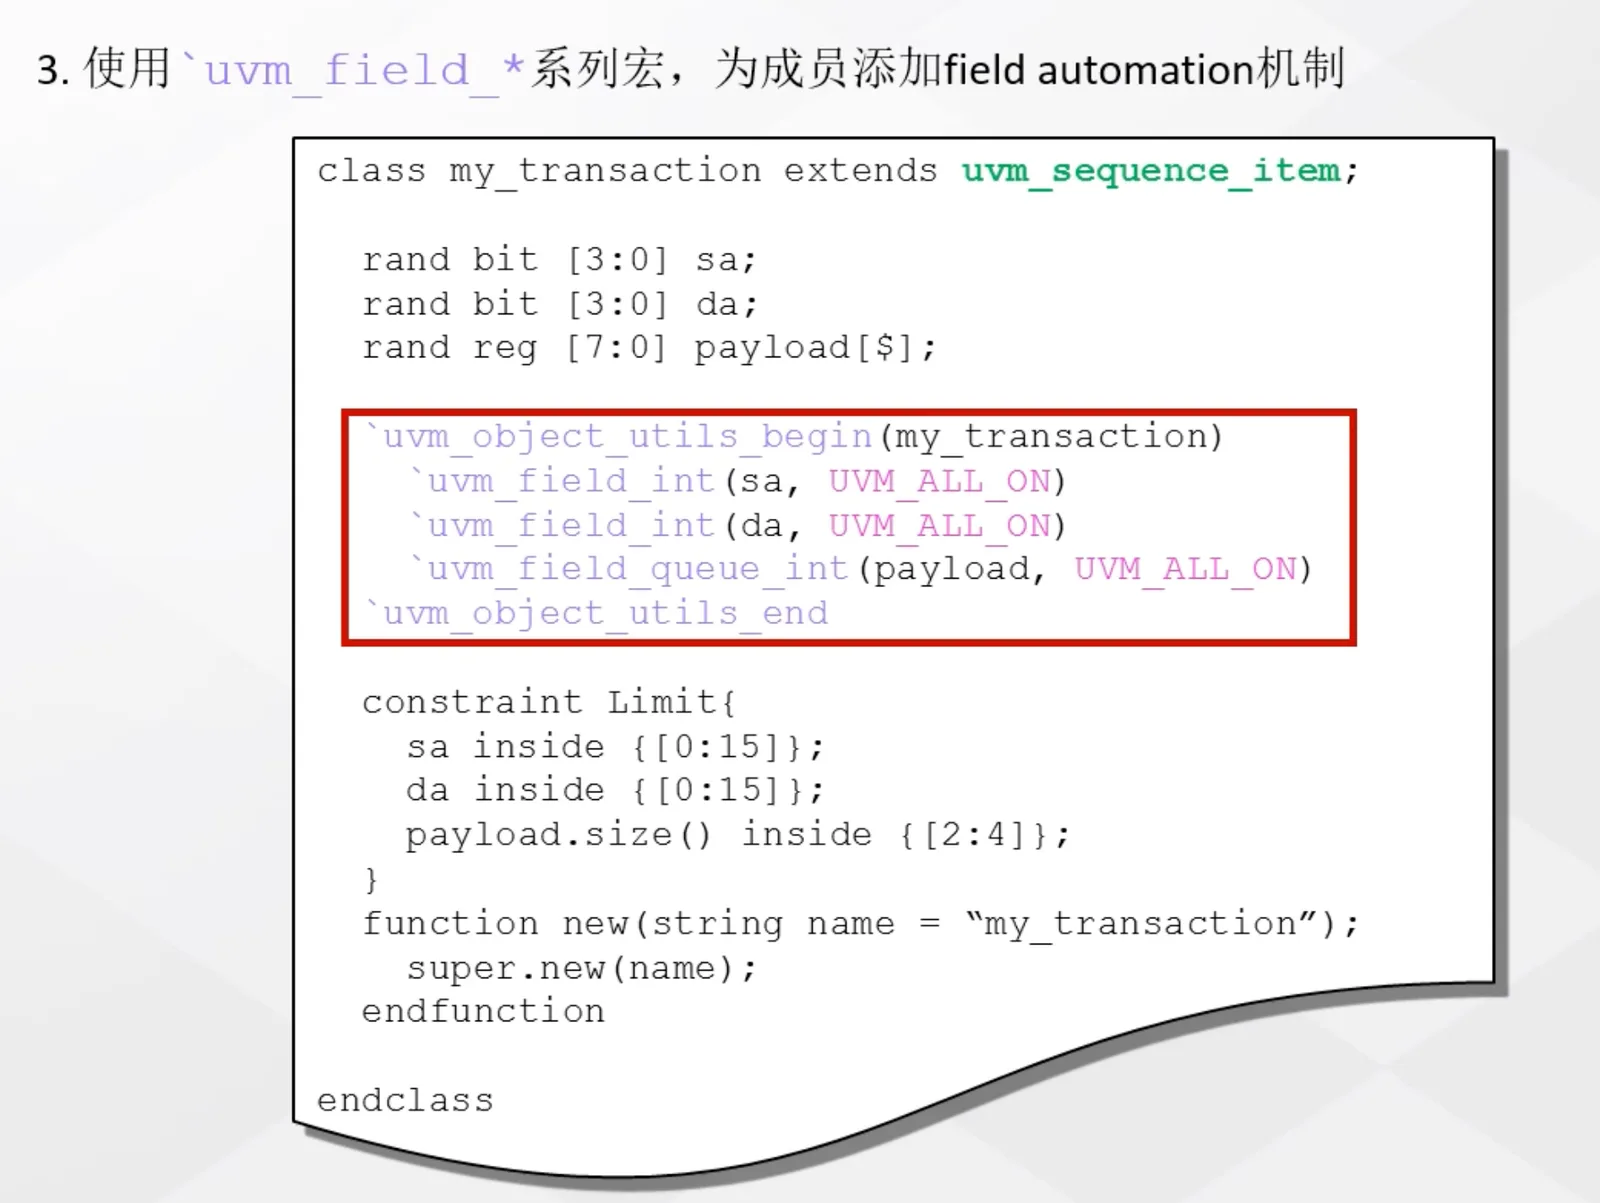
概念:类本身没有复制,sprint等方法,而 UVM field automation机制 可以对类中的成员自动创建这些方法。 简单的来说就是可使用UVM内建的函数对事务进行处理。
field automation机制(宏)不止可以用在事物类中,也可以定义在其他平台组件中
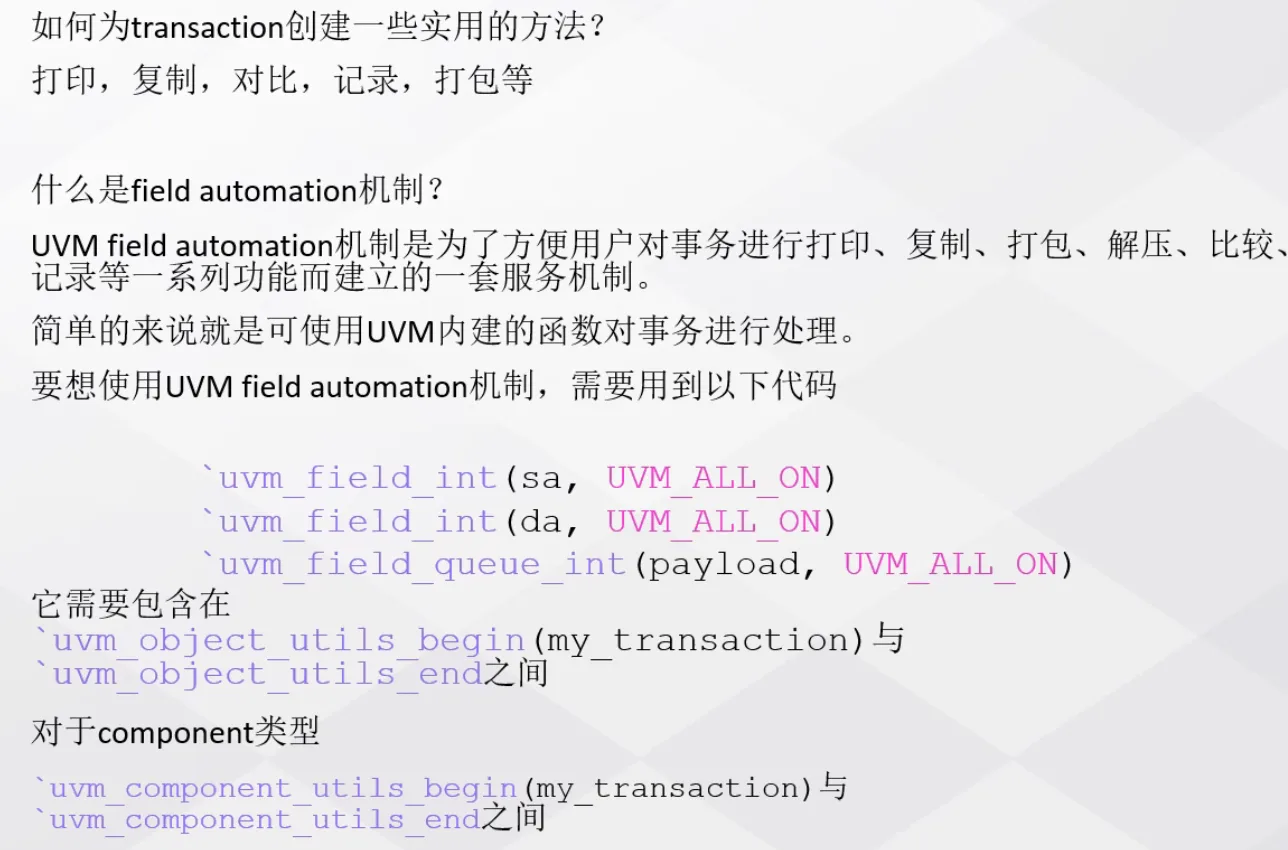
1.事物类函数
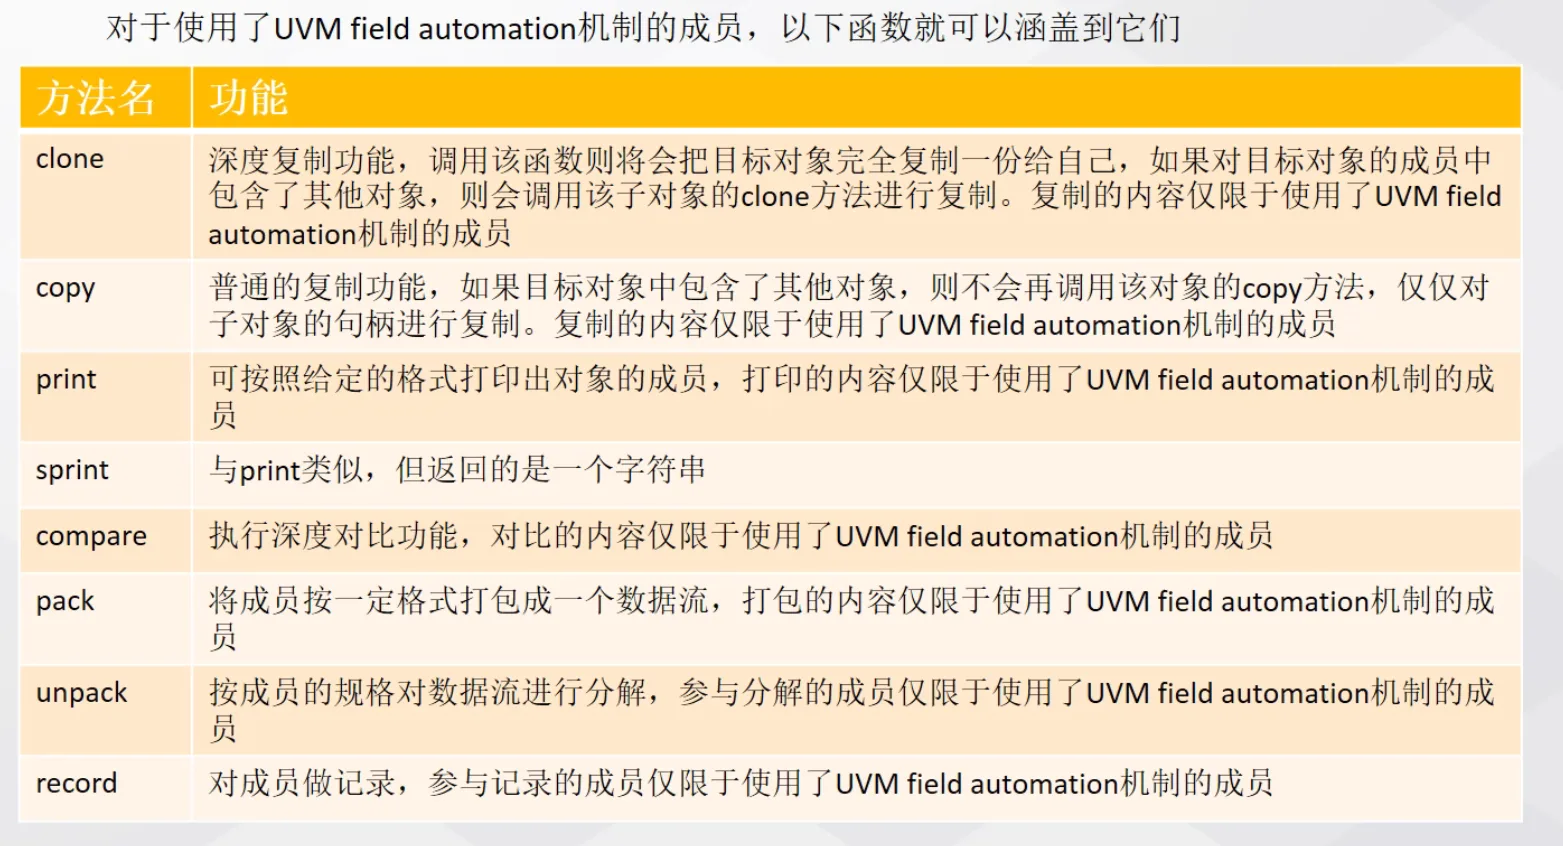
表里copy和clone的区别说得不对:copy()同样会深拷贝用uvm_field_object注册的子对象,只有字段标了UVM_REFERENCE才只复制句柄。真正的区别是:clone()先create一个新对象再调用copy(),返回这个新对象;copy()把数据复制进一个已经存在的对象。
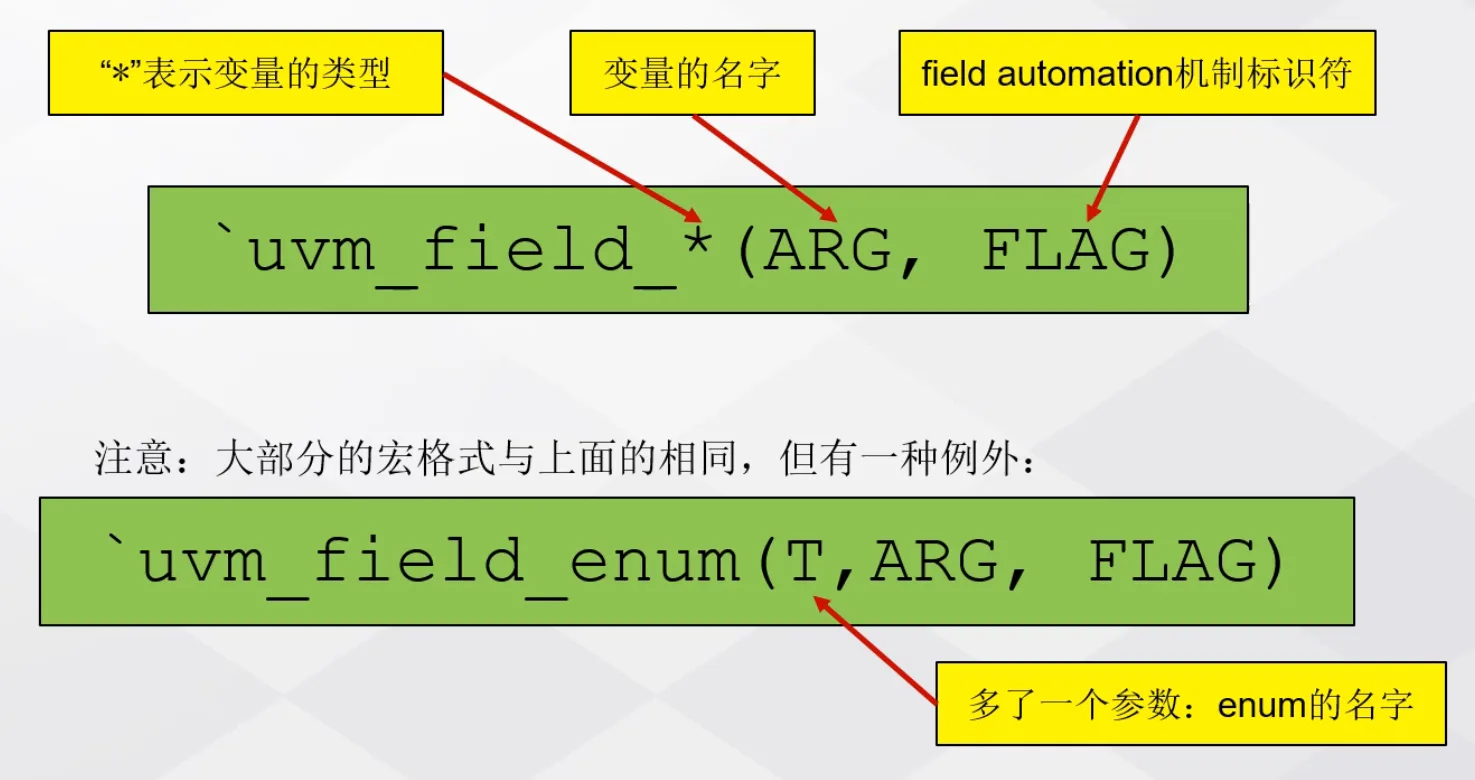
机制语法
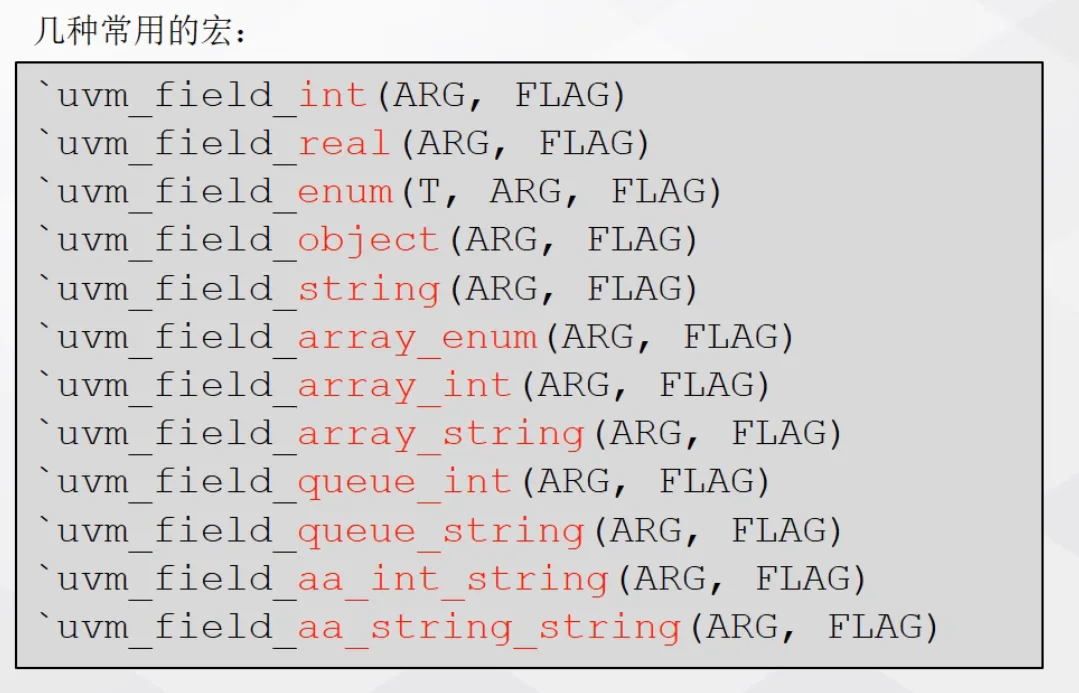
2.常用宏
3.FLAG - 标识符
用于打开/关闭成员的某些属性
标识符的本质是15位的向量,向量的每一位代表一个开关
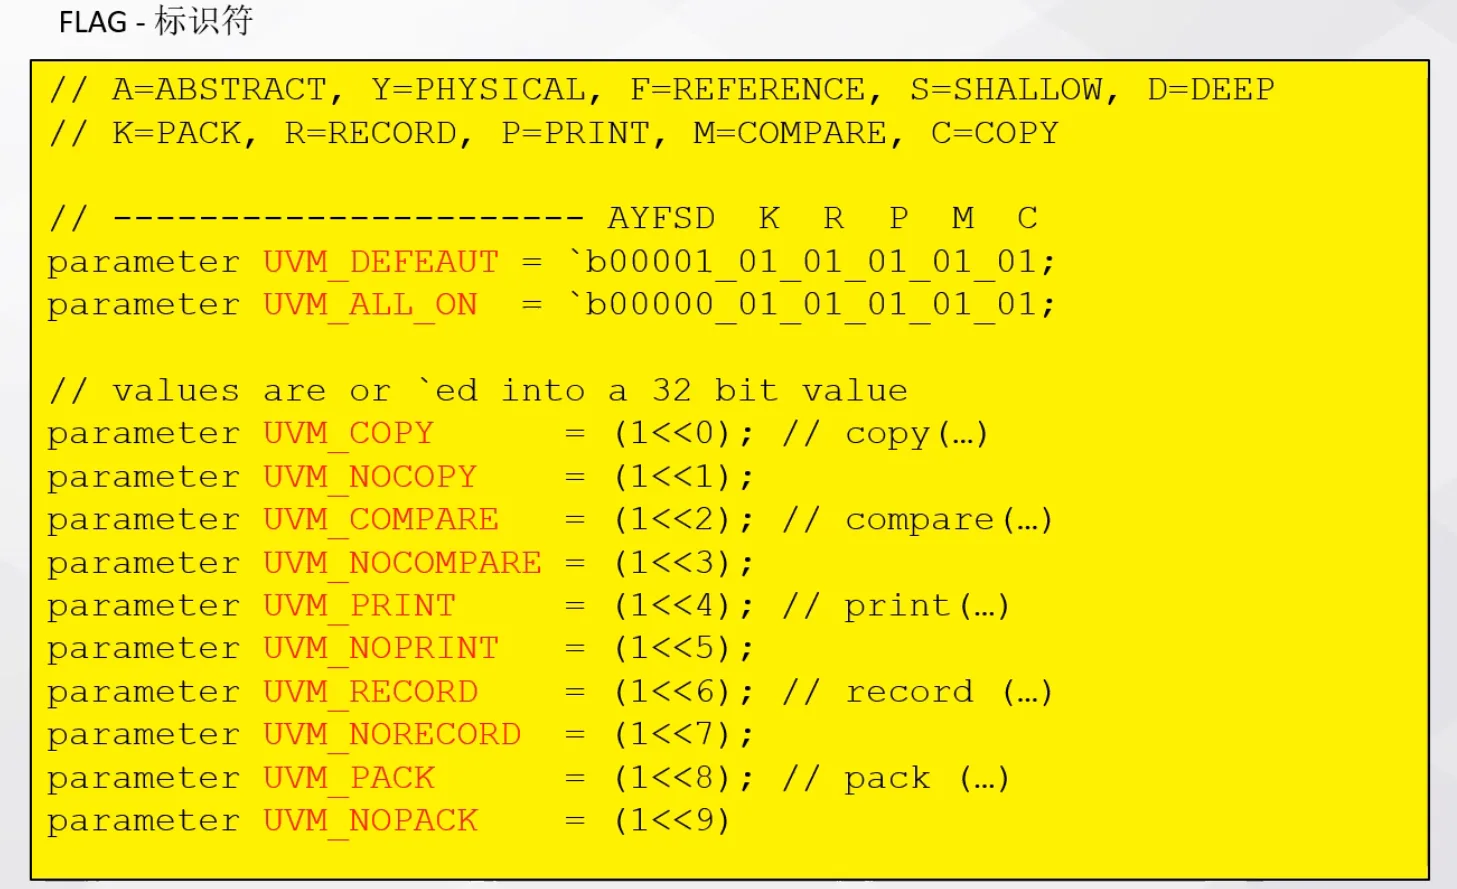
所有的 FLAG(标志位)都是 (1 << n) 的位移操作,这些位最终被组合成一个 位掩码(bitmask),而 UVM 规定该掩码是 32 位整数(bit[31:0])
1<<0代表 第 0 位 被置 1,表示UVM_COPY。
举例:
默认情况下
uvm_field_int(addr, UVM_ALL_ON);
如果不希望 addr 参与 compare()
uvm_field_int(addr, UVM_ALL_ON | UVM_NOCOMPARE);
UVM_ALL_ON 和 UVM_NOCOMPARE 进行 按位 OR(|) 操作后,第 3 位变成了 1,表示 NOCOMPARE 被激活
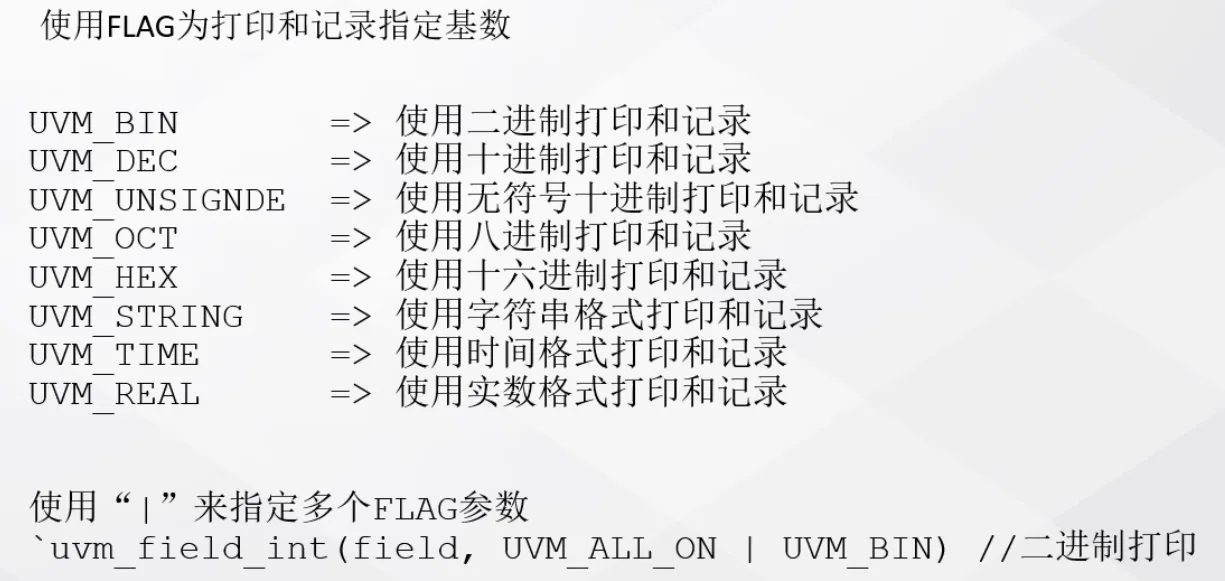
5 UVM信息服务机制
5.1 UVM信息服务机制
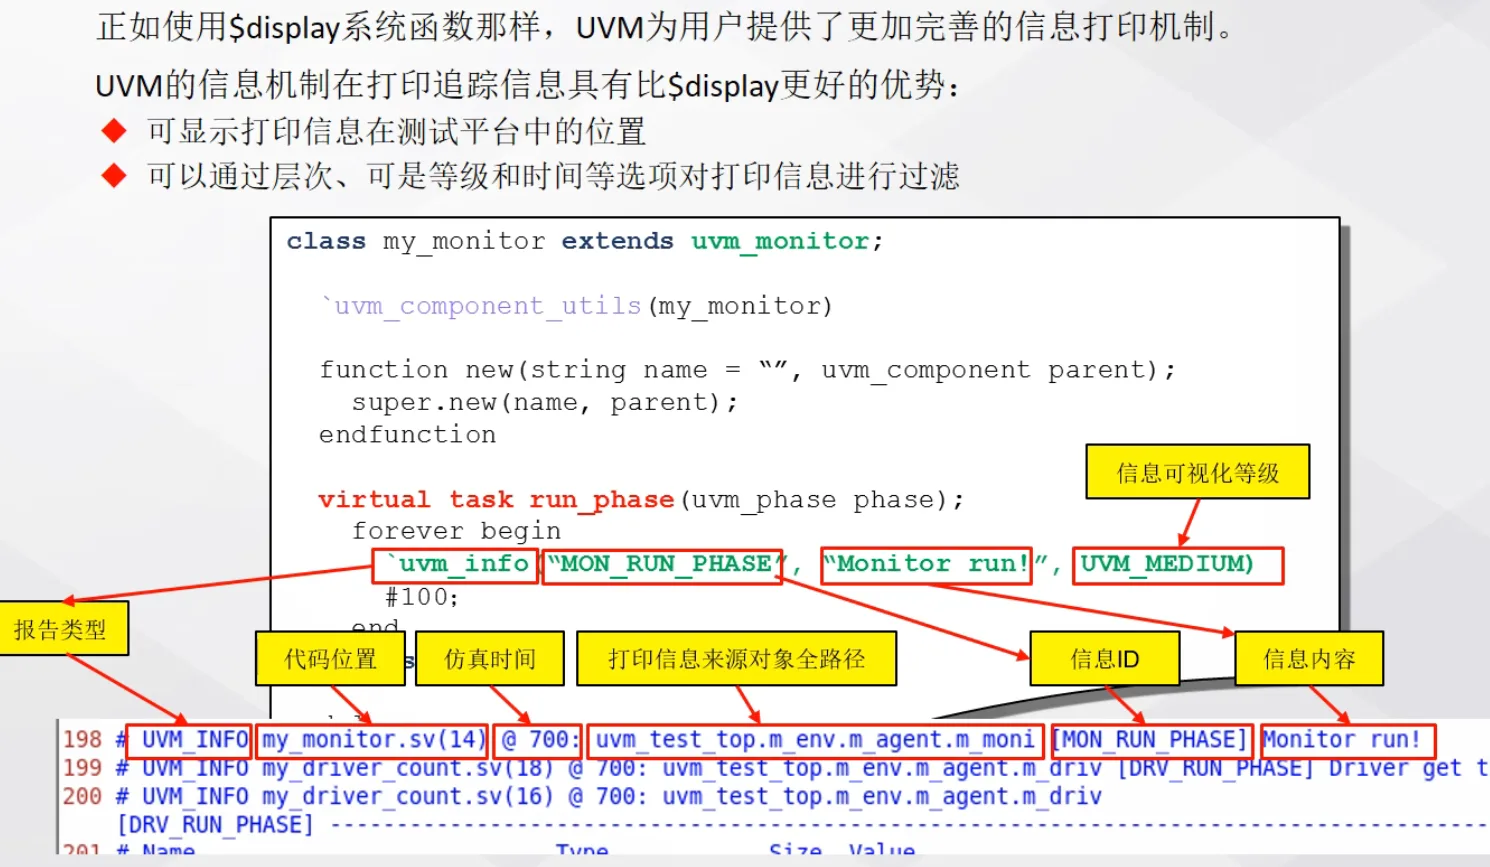
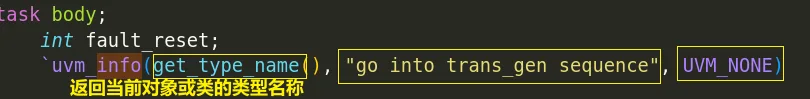
uvm_info的三个参数:
- 信息ID
- 信息内容
- 信息等级
5.2 信息安全等级以及信息行为
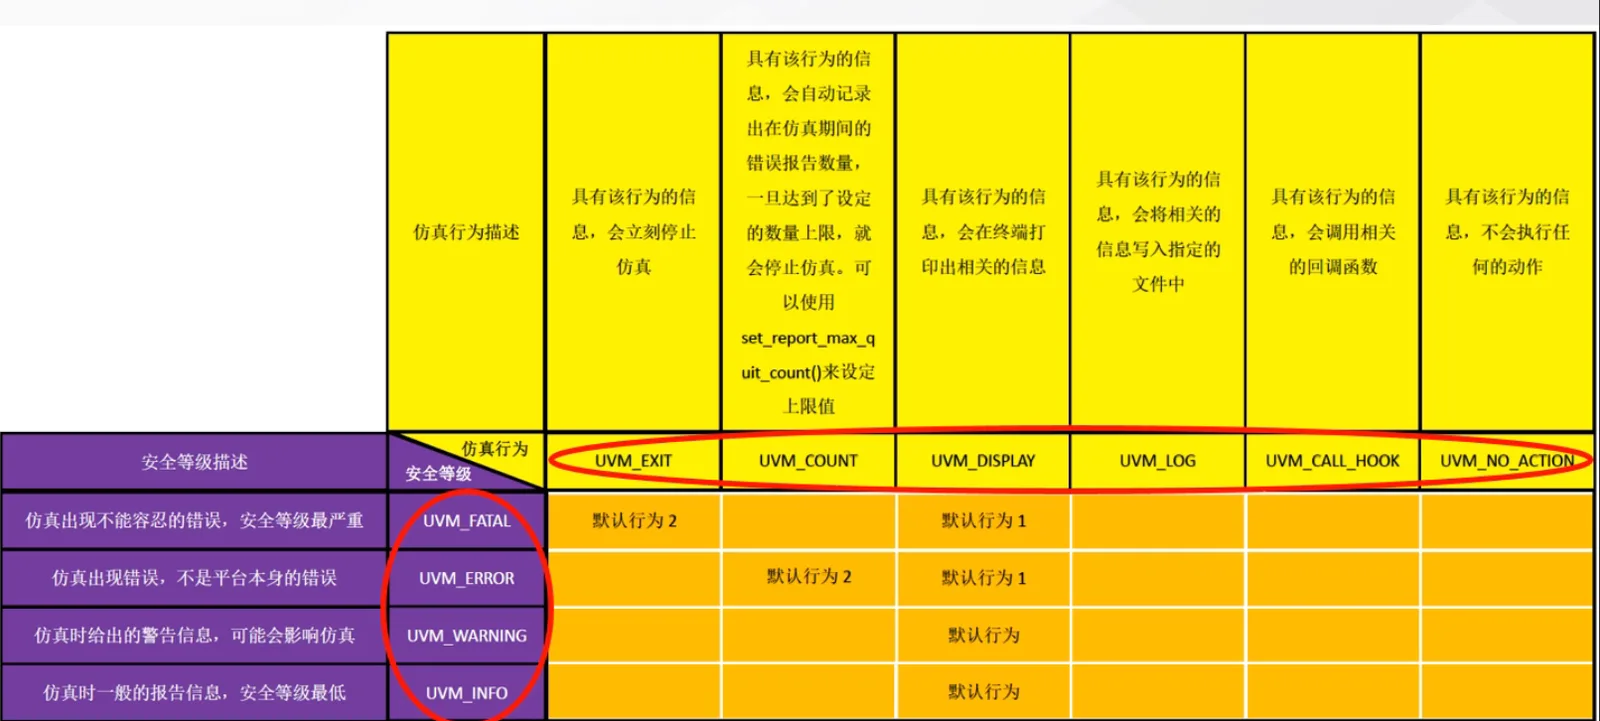
uvm_fatal
5.3 实现四种信息安全等级的宏
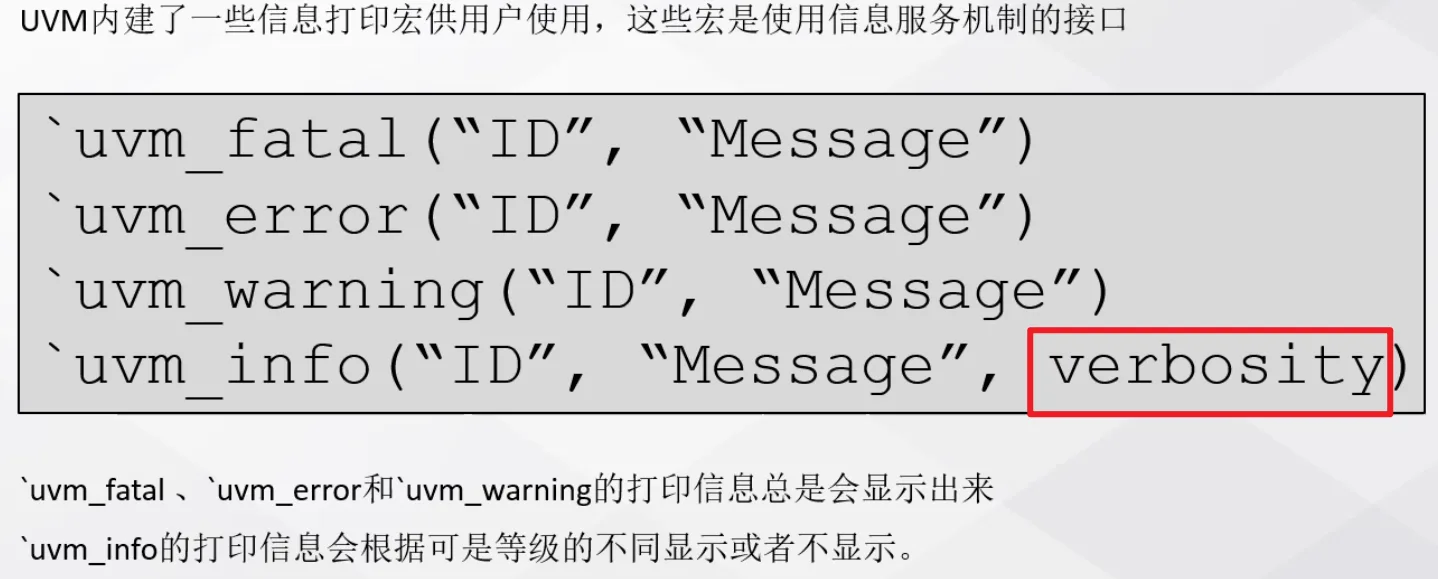
也可以设置局部某个函数的信息verbosity
uvm_info安全等级
等级越高越容易被屏蔽
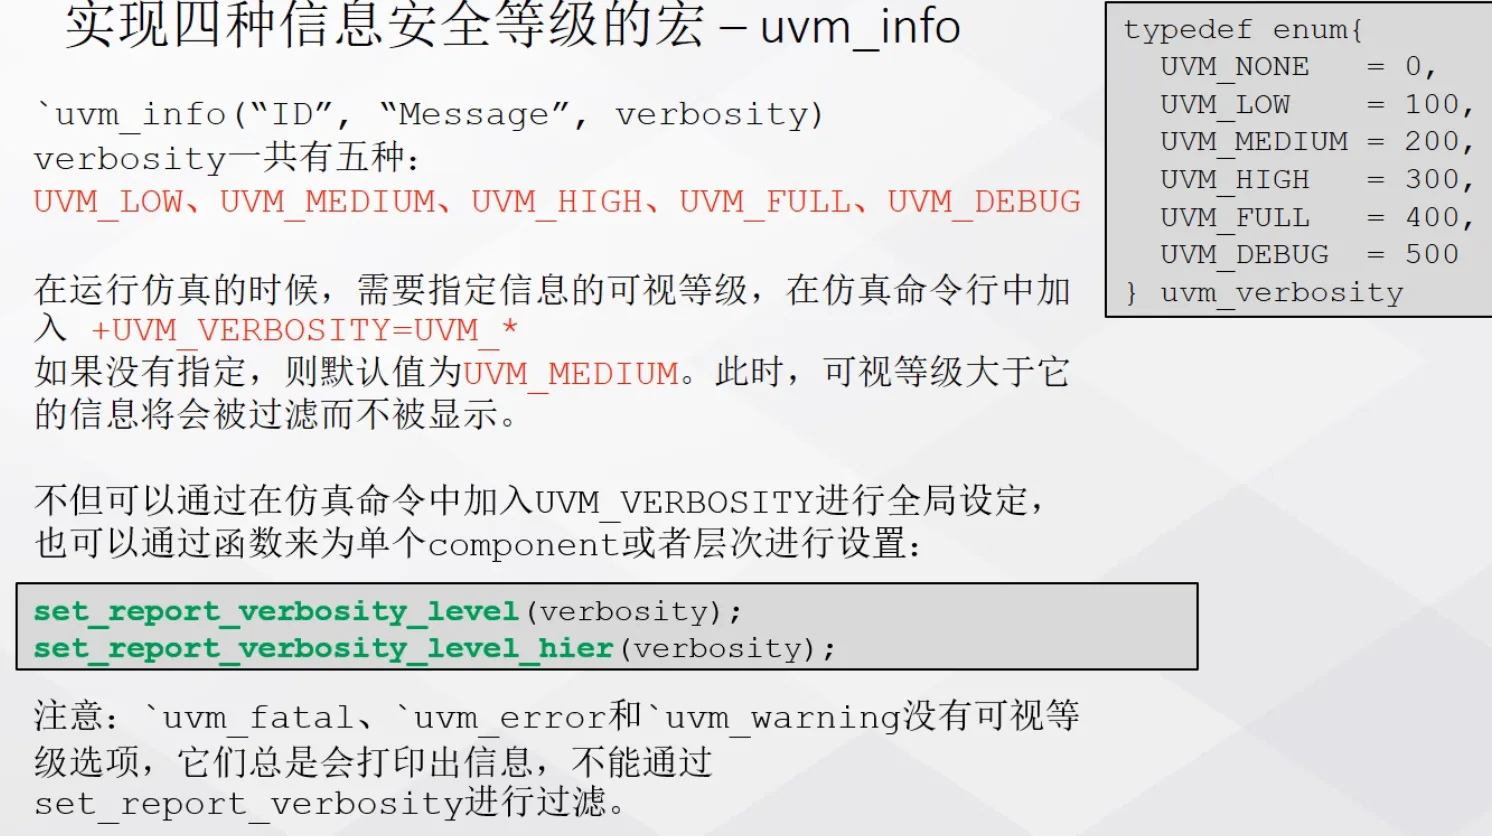
uvm_none不能被用户直接使用
如果指定为uvm_high,则高于high的都会被频闭掉,(full和dubug会被屏蔽) - 默认为medium
也可以在仿真命令中加入--test_arg=+UVM_VERBOSITY=UVM_DEBUG 来使得信息打印等级为最高(即不打印任何信息)
信息屏蔽等级单独设定 set_report_verbosity_level (verbosity); //设置 当前组件 打印信息屏蔽等级 set_report_verbosity_level_hier (verbosity);//设置 当前组件以及其以子组件 信息屏蔽等级
5.4 自定义信息的行为
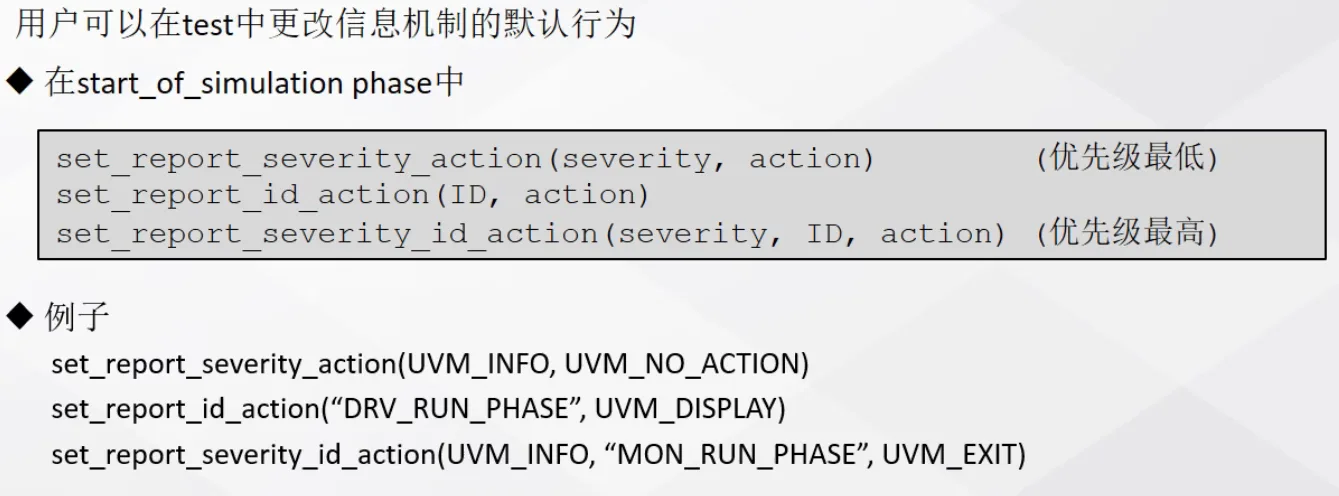
例子中:第一条信息:所有UVM_INFO执行UVM_NO_ACTION的行为。即不打印信息
第二条信息:ID为~ 的执行 DISPLAY行为(会覆盖第一条语句),意味着有这个ID的UVM_INFO会被打印出来
第一条信息:意味着UVM_INFO中含有这个ID的停止仿真(覆盖前两条)
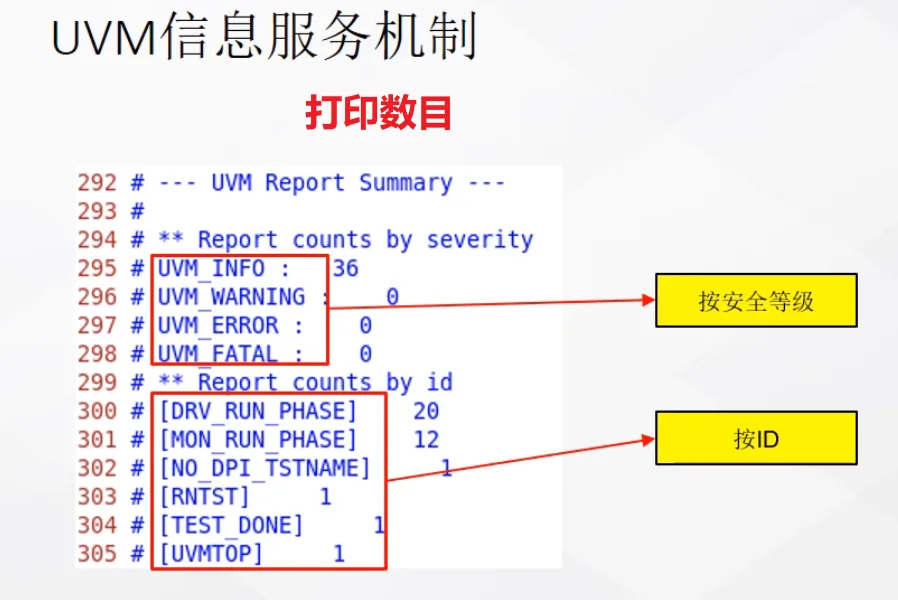
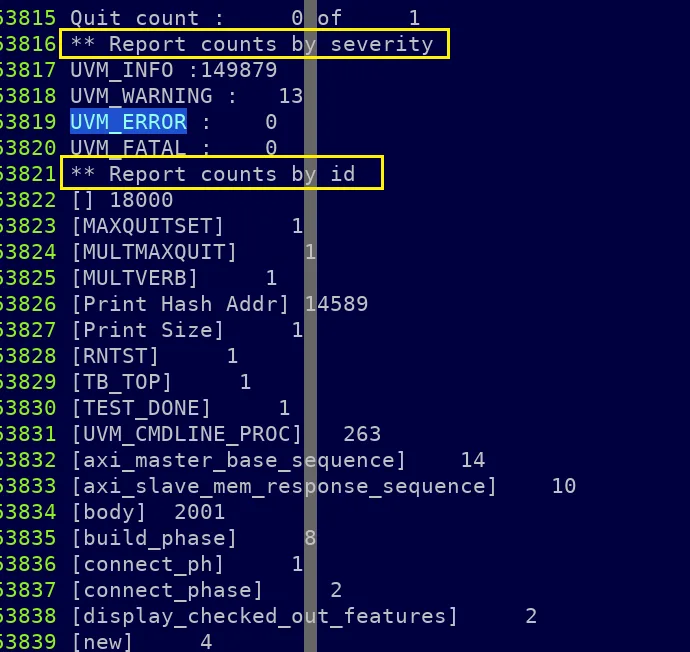
6 UVM configuration机制
6.1 概念
是一个强大的 属性配置工具
UVM_Config_db:这是一个全局数据库,用于存储和访问配置对象。
功能:比如在仿真时候可以配置sequence产生多少个事务等
配置传递:验证环境中,父级组件可以通过 set() 方法将配置传递给子组件。子组件则通过 get() 方法来检索它们所需的配置项。配置对象通常是类的实例,且可以是任何类型的数据结构
default_sequence:可以通过设置默认值来确保组件在没有显式配置的情况下仍能正常工作,而通过UVM配置数据库的覆盖功能,父组件可以覆盖子组件的默认配置。
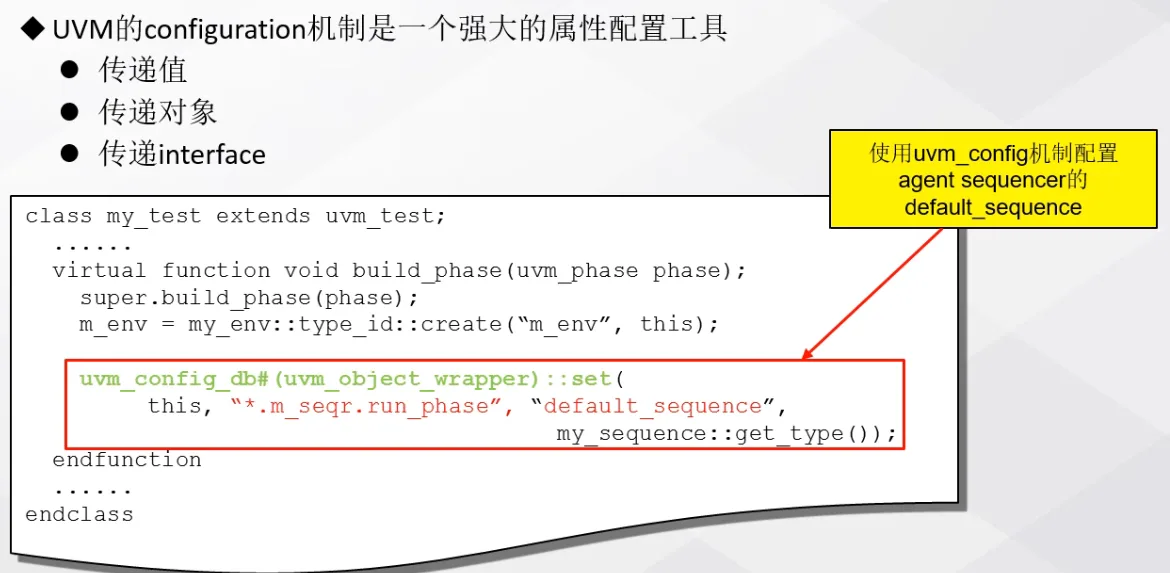
6.2 特点
- 半个全局变量,避免全局变量带来的风险
- 实现代码重用性:高层组件可以通过configuration机制实现在不改变代码的情况下更改它所包含子组件的变量
- 在各个层次上都可以使用configuration机制
- 方便路径搜索:持通配符和正则表达式对多个变量进行配置,可同时间配置多个目标
6.3 原理
set配置,get获取
UVM configuration机制实现由两部分组成:
- 设置配置资源set
- 获取配置资源get
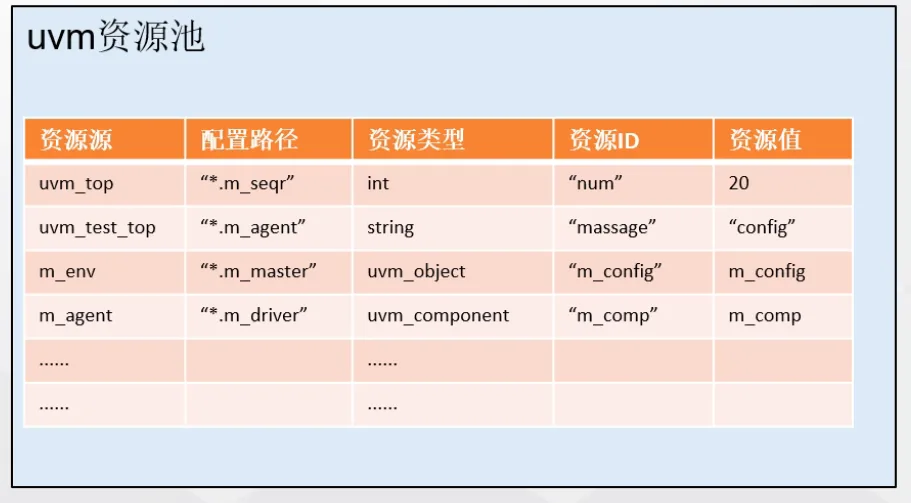
设置配置资源:
在 UVM 中,组件可以使用 uvm_config_db 设置配置项。这个配置项可以是任何类型的数据,设置后它们会存储在一个共享的配置资源池中。例如,uvm_top 组件设置了一个整数类型的配置项 num,其值为 20。这些配置资源在配置池中存储,并且可以由任何需要的子组件访问。
获取配置资源:
在其他组件中,可以通过 uvm_config_db 获取配置项。在本例中,uvm_test_top 获取了一个字符串类型的配置项 message,其值是 config。组件可以根据资源ID访问配置池中的资源。
6.4 使用
高层中set(写值到资源库),低层中get(查找资源库)
set() 静态函数
if (!uvm_config_db#(数据类型)::set(上下文对象, 实例名称, ID, 输出值)) begin
// 错误处理逻辑
end上下文对象(cntxt):在哪个组件环境中来set这个值,通常是当前组件,用 this 表示。(也成为设置资源源是谁)
- 可以填 null → UVM 内部直接把它换成 uvm_root::get(),起跳点=全局顶层(跟当前组件是谁无关)
- this → 起跳点=this.get_full_name()(当前组件的路径)
覆盖范围大小由 inst_name 决定,不是 cntxt:cntxt 只定”从哪起跳”,inst_name 定”跳多远”(空=只到起跳点自己,*=起跳点往下全部broadcast):
| cntxt | inst_name | scope pattern | 覆盖范围 |
|---|---|---|---|
this | ""(空) | "env0"(自己完整路径) | 只 env0 自己,不含子组件 |
this | "*" | "env0.*" | env0 底下所有子组件,不含 env0 自己 |
null | "*" | "*" | 整个仿真所有组件,跟”当前组件是谁”无关 |
null | "uvm_test_top"(具体路径,非空非*) | "uvm_test_top" | 只精确命中这一个组件,不广播、不是当前组件。常见于 module top 里 set 给顶层 test(uvm_test_top 是 UVM 保留的顶层 test 实例名) |
在 module top(不在任何 uvm_component 方法内部)里调用 set(),压根没有 this 可用(module 不是 uvm_component 的方法,没有隐式 this)——这里用 null 不是风格选择,是语法上被迫的。
实例名称(inst_name):指定配置的目标组件,通配符/相对路径,描述”覆盖范围”
ID: 配置名称(field_name):查找的配置项名称。一般使用变量名
输出值(value):接收配置资源的变量。
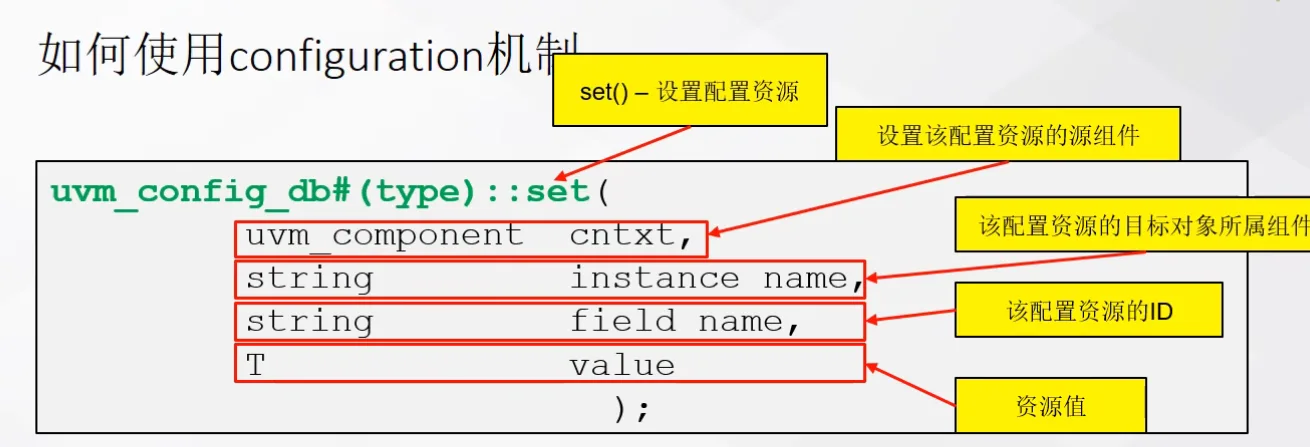
uvm_config_db#(virtual my_dut_tb_if)::set(
    uvm_root::get(),//一般为this,相当于null
    "*" ,   // 适用于整个平台任何组件
    "tb_vif",  //ID
    dut_tb_if); //配置的实际值
get() 静态函数
get() 站在”被配置的组件”角度:目的不是广播,是”查自身这条路径上有没有为它设置的值”。惯用写法两种,等价:
- get(this, "", …)
- cntxt=this(组件自身),inst_name=""
- get(null, get_full_name(), …)
- cntxt=null,inst_name=自己的完整路径 两种拼出来的最终 scope 都一样:“组件自身的 get_full_name()“。这条 scope 去和 resource pool 里 set() 存的 pattern 做匹配(pattern 可以带通配符,get 这边不带,就是个确定地址)
- 以上例子中get_full_name和"" 等价
`uvm_config_db#(数据类型)::get(上下文对象, 实例名称, ID, 值);`每个参数的含义:
- 上下文对象(cntxt):在哪个组件环境中获取值,通常用
this表示(也可用null配合完整路径,效果等价)。 - 实例名称(inst_name):指定要查找的组件路径,例如 “agent.sub_component”。一般留空(配合 cntxt=this,表示查自己),get() 这边不用通配符(通配符是 set() 的语义)
- 与 set() 的关键差异:get() 没有”覆盖范围”这一轴,
| cntxt | inst_name | scope(literal) | 实际查的是 |
|---|---|---|---|
this | ""(空) | "env0" | 组件自身(env0),最常见写法 |
null | get_full_name() | "env0" | 组件自身(env0),跟上一行等价写法 |
this | "drv" | "env0.drv" | 下层子组件 env0.drv(不是组件自身,少见但合法) |
三行「实际查的是」永远只有 1 个具体目标,没有”从1个到全体”的跨度——这才是跟 set() 表的本质差异:inst_name 在这只是拼出”问哪一个”,不是扩大搜索范围。(列名从”覆盖范围”换成”实际查的是”,就是标出这个不同)
- ID: 配置名称(field_name):设置的具体配置项名称。
- 值(value):要传递的配置数据。
- 方向性记忆:set 的第四个参数 = 要把哪个数据发出去;get 的第四个参数 = 把收到的数据装进哪个成员变量。
例如:
uvm_config_db#(virtual dut_interface)::set(null, “env.agent*”, “vif”, vif);
null:全局上下文。相当于uvm_root::get()
"env.agent*":所有名称以 env.agent 开头的组件实例都使用同一个 vif 配置。
"vif":配置名称。
vif:实际传递的虚拟接口。
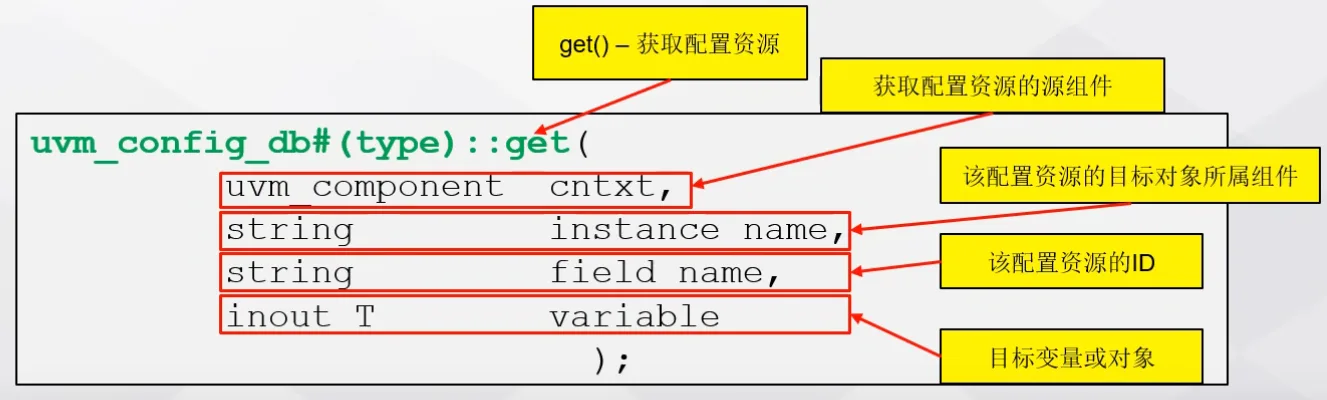
uvm_config_db#(virtual svt_axi_if)::get(
    null,  //在哪个组件环境中设置值
    get_full_name(),  //配置的目标组件,可以为空
    "vif",  //ID
    scb_axi_if)
举例uvm_config_db
三个例子递进关系容易搞混,先说清楚关系:
- 例子1 演示最基础的 set/get 对称用法(配一个变量)
- 例子2 是简化预览:只演示”怎么把 virtual interface 塞给 UVM”这一个概念,用的是最简单的广播写法,不是最终实现
- 例子3 才是完整实现(对应 lab04→lab05 真实代码):interface 会和其他配置一起打包进自定义 config 类,一层层往下传,写法跟例子2 不一样——这是”看不懂例子2和例子3关系”的根源,后面会专门说明两者怎么对上
例1 配置变量
控制 sequence 产生几个 transaction
my_sequence 里 item_num 默认是 10,不改 sequence 代码、临时改成别的值:
// my_sequence.sv
class my_sequence extends uvm_sequence #(my_transaction);
    int item_num = 10;

    function void pre_randomize();
        // get():在"要用这个变量的地方"查。cntxt=m_sequencer(起跳点是这个sequence挂靠的sequencer)
        uvm_config_db#(int)::get(
            m_sequencer,
            "",
            "item_num",
            item_num
        );
    endfunction

    virtual task body();
        repeat(item_num) begin
            `uvm_do(req)
        end
    endtask
endclass
// my_test.sv build_phase 里
// set():inst_name="*.m_seqr" → 整个平台任何叫 m_seqr 的组件都吃这个配置
uvm_config_db#(int)::set(
this,
"*.m_seqr",
"item_num",
3
);知识点:set 在高层、get 在低层,两边字段名("item_num")必须完全一致才能配对成功;这是最基础的一对一/一对多配置模式。
例2 配置interface
这个例子做的事:让 driver 拿到 DUT 的 virtual interface 句柄,从而能真正驱动信号——这是”验证平台”和”DUT”之间唯一的物理连接方式。virtual interface 只能在 module 里实例化,UVM 组件是纯 class,摸不到硬件信号,得靠 config_db 才能把这个句柄从 module 层带进 class 世界。
// module top(不在任何 uvm_component 里,没有 this)
initial begin
    // null:module 里没有 this,只能用 null(全局起跳点)
    // "*.m_agent.*":广播给所有路径里带 m_agent 的组件,driver/monitor 直接收到
    uvm_config_db#(virtual dut_interface)::set(
        null,
        "*.m_agent.*",
        "vif",
        inf
    );
    run_test();
endset() 不是”推送”,是往全局资源池发布一条记录——top 写的时候根本不知道、也不关心谁会来读,driver 长什么样、在哪条路径它都不管。这种”发布者不认识订阅者”的解耦,正是 config_db 要解决的问题:如果是直接传句柄,test/top 就得知道 driver 的存在,退化成手工层层传参。
配套的 dut_interface.sv:
interface dut_interface(input bit clk);
    logic reset_n;
    logic [15:0] din, frame_n, valid_n, dout, busy_n, valido_n, frameo_n;

    // 三套 clocking block:driver 用来驱动激励,两个 monitor 用来采样
    clocking driver_cb@(posedge clk);
        default input #1 output #0;
        output reset_n, frame_n, valid_n, din;
        input  busy_n;
    endclocking

    clocking imonitor_cb@(posedge clk);
        default input #1 output #0;
        input frame_n, valid_n, din, busy_n;
    endclocking

    clocking o_monitor_cb@(posedge clk);
        default input #1 output #0;
        input dout, valido_n, frameo_n;
    endclocking

    // modport 限定每个角色只能碰自己该碰的方向,防止误用/竞争
    modport driver(clocking driver_cb, output reset_n);
    modport imonitor(clocking imonitor_cb);
    modport omonitor(clocking o_monitor_cb);
endinterface
driver 拿到 vif 后,初始化/复位的时机有讲究:
// my_driver.sv
virtual dut_interface m_vif;

virtual function void build_phase(uvm_phase phase);
    // get():cntxt=this(driver自己),去查"vif"这个资源
    uvm_config_db#(virtual dut_interface)::get(
        this,
        "",
        "vif",
        m_vif
    );
endfunction

// pre_reset_phase:复位真正开始前,先把信号拍成未知态 'x 占位
virtual task pre_reset_phase(uvm_phase phase);
    phase.raise_objection(this);
        m_vif.driver_cb.reset_n <= 'x;
        // ...
    phase.drop_objection(this);
endtask

// reset_phase:真正驱动复位脉冲
virtual task reset_phase(uvm_phase phase);
    phase.raise_objection(this);
        m_vif.driver_cb.reset_n <= '1;
        repeat(5) @(m_vif.driver_cb);
            m_vif.driver_cb.reset_n <= '0;   // 拉低,复位生效
        repeat(5) @(m_vif.driver_cb);
            m_vif.driver_cb.reset_n <= '1;   // 拉回,复位结束
    phase.drop_objection(this);
endtaskget() 是 driver 自己主动去查有没有人给它这条路径留了东西;查到后复制一份赋给自己的成员变量 m_vif(virtual dut_interface m_vif;)。m_vif 之后就是 driver 类的普通字段,不在资源池里——资源池只是临时的”发布-查询”中转站,不是最终存放位置。
例子2 全链路:top 发布一条 "vif" 记录到全局池(set)→ driver 在 build_phase 里主动查这条记录、复制到本地 m_vif(get)→ 之后 pre_reset_phase/reset_phase/run_phase 里用这个本地句柄去驱动接口信号。config_db 只负责句柄的解耦式投递,真正”驱动”是拿到句柄之后的普通 SV 代码干的。
pre_reset_phase 只负责”摆姿势”(未知态占位),不产生真正复位;reset_phase 才真正拉复位信号。两者顺序执行,避免复位那一刻某些信号还没准备好导致的毛刺。
DUT 和 interface 的电气连接,是 top.sv 里 router dut(.reset_n(inf.reset_n), ...) 这行module 级端口连接做的——elaboration 时就定死,跟 virtual interface、跟 config_db 毫无关系。
virtual interface 不是”UVM 平台和 DUT 的连接方式”,是让 class 世界的 driver/monitor 摸到那条已经接好的线的一把钥匙(句柄/引用)。set/get 传递的也不是”连接”,只是这把钥匙本身——get() 里的”赋值”是把句柄 copy 进 driver 自己的成员变量 m_vif,不是给 DUT 信号赋值;真正驱动信号靠的是拿到句柄之后 m_vif.driver_cb.xxx <= ... 这些普通 SV 代码。
三层顺序:
- 1.结构连线(top.sv 端口连接,真连接)
- 2.句柄传递(config_db set/get,只搬引用,不是连接)→
- 3.真正驱动(通过句柄操作 interface 信号)。
是否所有验证项目都靠 virtual interface 连 DUT? 不是。只要平台里有 class-based 组件(driver/monitor 这种),就必须靠 virtual interface 把 module 级的物理 interface 递进 class 世界——这也是 UVM 里几乎 100% 会用到它的原因。少数纯 module-level 的老式/简单 testbench(没有 class,直接 initial block 写激励)本身就在 module 里,普通 interface 或直接端口连线就够,不需要这层 virtual interface。
dut_interface这个模块是验证人员写的代码,根据DUT的输入输出接口来写
- 但interface比DUT端口列表多两样东西,DUT本身没有,是验证人员自己加的:
- clocking block(driver_cb/monitor_cb)——定义同步时序,避免竞争
- modport——限定driver/monitor各自只能碰哪些信号方向
例3 配置自定义config类
多个变量一个个单独 set/get 会很乱,索性打包成一个 config 对象整体传递: 一般对同一个组件的所有配置变量使用class封装起来
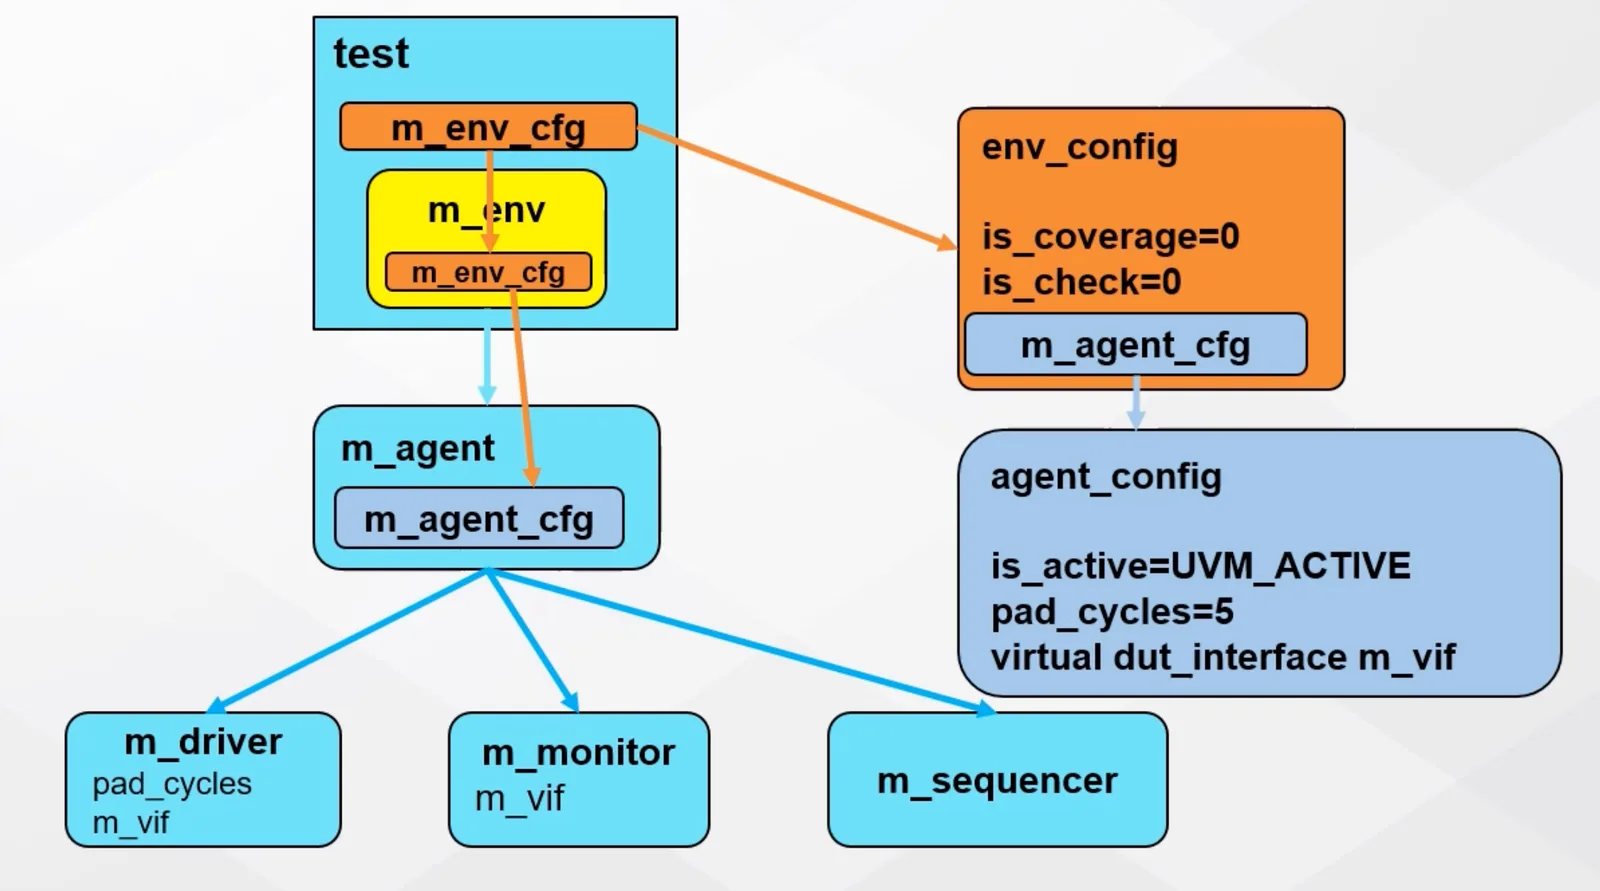
打包关系:env_config 装 is_coverage/is_check,里面嵌了一个 agent_config(装 is_active/pad_cycles/m_vif)。一个 env_config 对象就把 env、agent 两层所有配置都带全了——interface 也是打包进来的字段之一,这就是它跟例子2 走法不同的原因。
配置类不是平台组件,所以需要拓展自uvm_object基类
// agent_config.sv
class agent_config extends uvm_object;
    uvm_active_passive_enum is_active = UVM_ACTIVE;
    int unsigned pad_cycles = 5;
    virtual dut_interface m_vif;   // interface 也是打包字段之一

    `uvm_object_utils_begin(agent_config)
        `uvm_field_enum(uvm_active_passive_enum, is_active, UVM_ALL_ON)
        `uvm_field_int(pad_cycles, UVM_ALL_ON)
    `uvm_object_utils_end

    function new(string name ="agent_config");
        super.new(name);
    endfunction
endclass

class env_config extends uvm_object;
    int is_coverage = 0;
    int is_check = 0;
    agent_config m_agent_cfg;      // 嵌套:env_config 里包一个 agent_config

    `uvm_object_utils_begin(env_config)
        `uvm_field_int(is_coverage, UVM_ALL_ON)
        `uvm_field_int(is_check, UVM_ALL_ON)
        `uvm_field_object(m_agent_cfg, UVM_ALL_ON)
    `uvm_object_utils_end

    function new(string name ="env_config");
        super.new(name);
        m_agent_cfg = new("m_agent_cfg");   // 记得实例化嵌套对象,不然是空句柄
    endfunction
endclass
传递链路:module top → my_test → my_env → master_agent → my_driver/monitor,每一层都是”从上一层 get,配置/改完,再 set 给下一层”:
// ① module top:拿到真正的 interface,精确投给 uvm_test_top(不是广播)
uvm_config_db#(virtual dut_interface)::set(
    null,
    "uvm_test_top",
    "top_if",
    inf
);
// ② my_test.sv build_phase
env_config m_env_cfg; // 声明配置对象句柄
function new(string name="", uvm_component parent);
super.new(name, parent);
m_env_cfg = new("m_env_cfg"); // 先 new 出来,才有地方装值
endfunction
virtual function void build_phase(uvm_phase phase);
m_env = my_env::type_id::create("m_env", this);
// 给对象的各个字段手动赋值——config对象的内容都是这样一条条填出来的
m_env_cfg.is_coverage = 1;
m_env_cfg.is_check = 1;
m_env_cfg.m_agent_cfg.is_active = UVM_ACTIVE;
m_env_cfg.m_agent_cfg.pad_cycles = 10;
// 从①那里精确取回 interface,直接填进 agent_cfg.m_vif 这个字段
uvm_config_db#(virtual dut_interface)::get(
this,
"",
"top_if", //test层级从top取得inf句柄,并随着m_env_cfg对象一步一步向下传递直到driver来激励
m_env_cfg.m_agent_cfg.m_vif //配置验证环境的virtual inf 连接上top层级例化的DUT
);
// 整个 env_config 对象一次性往下传给 m_env
uvm_config_db#(env_config)::set(
this,
"m_env",
"env_cfg",
m_env_cfg
);
endfunction// ③ my_env.sv build_phase
env_config m_env_cfg;
virtual function void build_phase(uvm_phase phase);
// 从 my_test 那收下整个对象
uvm_config_db#(env_config)::get(
this,
"",
"env_cfg",
m_env_cfg
);
// 拆出里面的 agent_config,继续往下传给 agent
uvm_config_db#(agent_config)::set(
this,
"m_agent",
"m_agent_cfg",
m_env_cfg.m_agent_cfg
);
// 顺手在env环境中用配置值控制平台行为
if(m_env_cfg.is_coverage)
`uvm_info("COVERAGE_ENABLE", "...", UVM_MEDIUM)
if(m_env_cfg.is_check)
`uvm_info("CHECK_ENABLE", "...", UVM_MEDIUM)
m_agent = master_agent::type_id::create("m_agent", this);
endfunction// ④ master_agent.sv build_phase
agent_config m_agent_cfg;
virtual function void build_phase(uvm_phase phase);
uvm_config_db#(agent_config)::get(
this,
"",
"m_agent_cfg",
m_agent_cfg
);
is_active = m_agent_cfg.is_active; // 赋值给 uvm_agent 自带的 is_active,不要另外声明局部变量顶掉它
// 到这一层才把打包的字段"拆包",分别用不同字段名广播给具体子组件
uvm_config_db#(int unsigned)::set(
this,
"m_driv",
"pad_cycles",
m_agent_cfg.pad_cycles
);
uvm_config_db#(virtual dut_interface)::set(
this,
"m_driv",
"vif",
m_agent_cfg.m_vif
);
uvm_config_db#(virtual dut_interface)::set(
this,
"m_moni",
"vif",
m_agent_cfg.m_vif
);
if(is_active == UVM_ACTIVE) begin
m_seqr = my_sequencer::type_id::create("m_seqr", this);
m_driv = my_driver::type_id::create("m_driv", this);
end
m_moni = my_monitor::type_id::create("m_moni", this);
endfunction// ⑤ my_driver.sv build_phase —— 链路的最后一站,直接用
virtual dut_interface m_vif;
virtual function void build_phase(uvm_phase phase);
uvm_config_db#(int unsigned)::get(
this,
"",
"pad_cycles",
pad_cycles
);
uvm_config_db#(virtual dut_interface)::get(
this,
"",
"vif",
m_vif
);
endfunction
//在driver层级对m_vif下的变量进行reset或激励操作
virtual task run_phase(uvm_phase phase);
m_vif.driver_cb.din[req.sa] <= 1'b1;
...
endtask整体回顾(一张图看完整条链路):
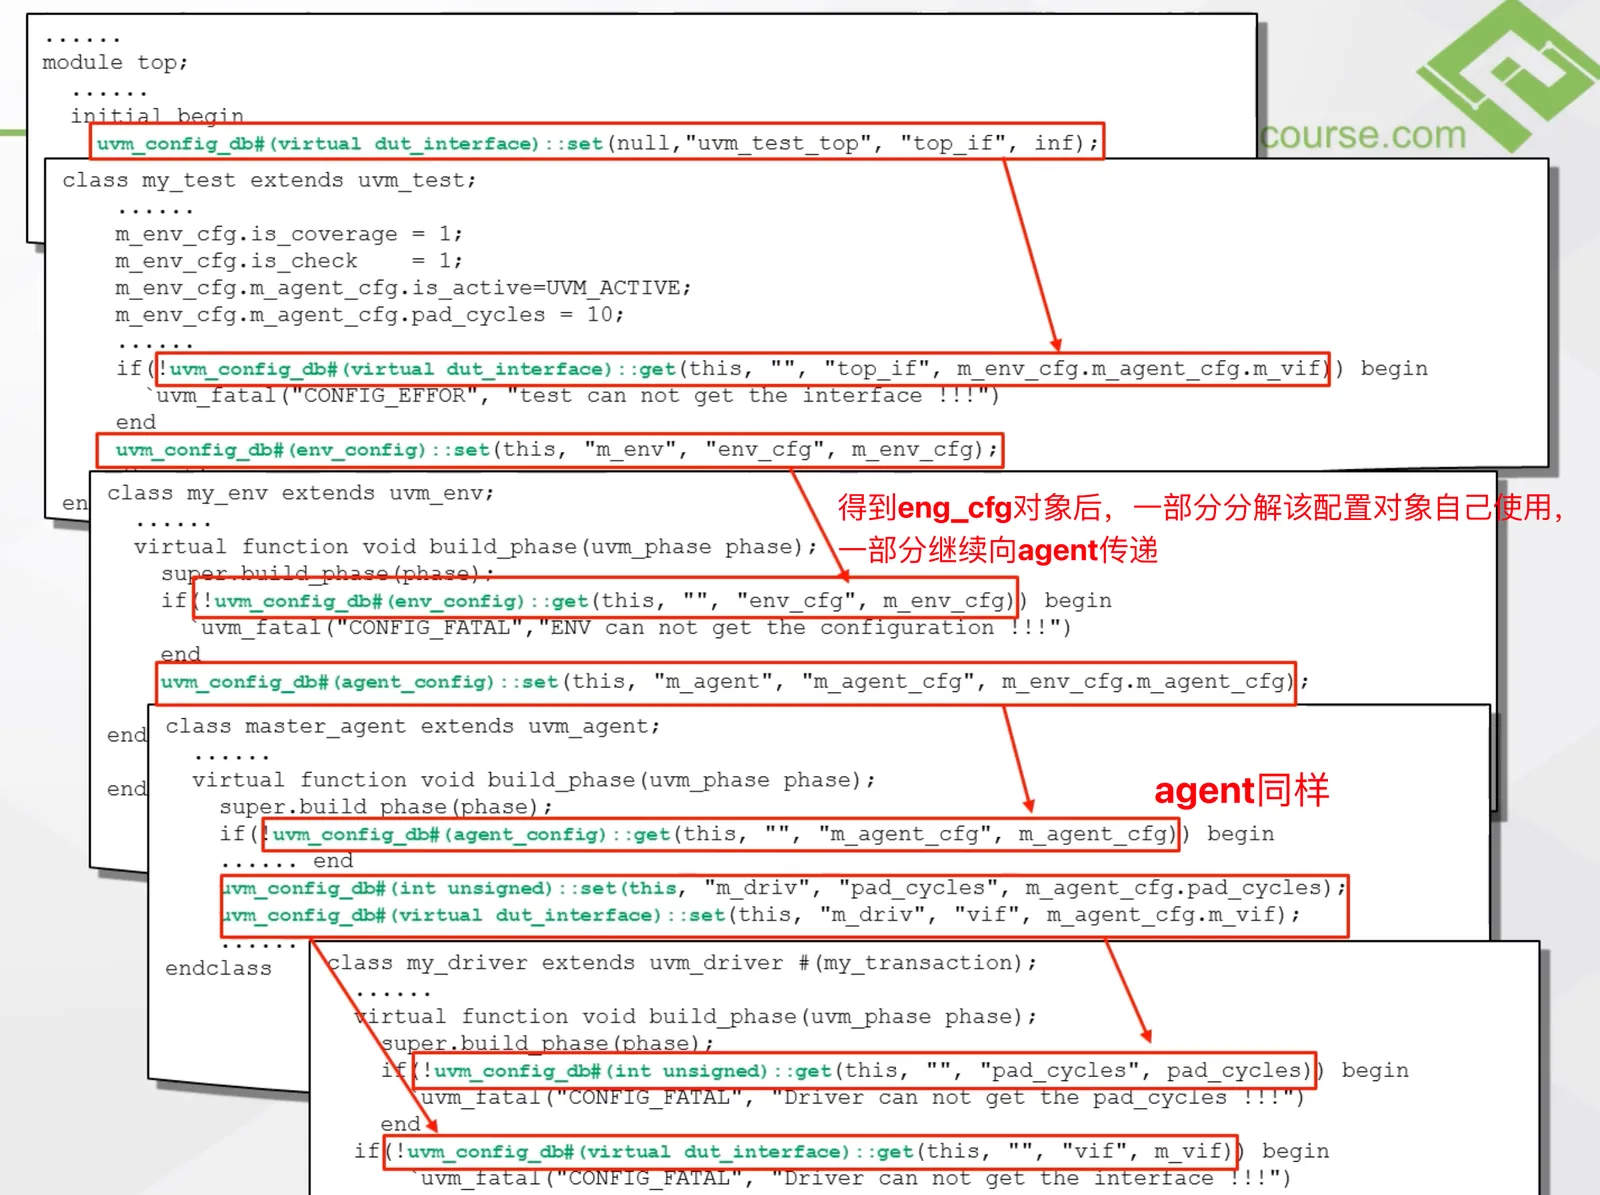
例子2 里 driver 直接从全局广播拿 "vif";例子3 里 interface 先精确传到 test(字段名 "top_if"),塞进自定义对象的字段里一路打包往下带,到 agent 这层才重新用 "vif" 这个名字广播给 driver/monitor。两条链路最终都能让 driver 拿到 vif,只是”打包传”顺便把 is_active/pad_cycles 等其他配置也一起带下去了——这才是自定义 config 类的价值:省得每个变量都单独开一条 set/get。
本节总结
- 是什么:UVM configuration 机制是一个全局配置资源池,父组件 set,子组件 get
- 原理:cntxt 定起跳点,inst_name 定覆盖范围(set 可广播,get 永远查唯一地址)
- 用法:变量可单独传(例子1),也可打包进自定义 config 类整体传(例子3);virtual interface 跨 module/class 边界的传递是它最重要的应用场景之一(例子2/3)
7 UVM sequence机制
概念
控制和产生一系列事物,并将事物发送给driver的一套机制
- 1.控制:控制何时产生 / 发送事物
- 2.产生:产生事务
- 3.发送:收到sequencer的请求后,发送给它。再由sqr转发给drv。当drv发送完毕后,会回传到seq(产生完成的标志响应)。接下来会产生下一个事物,并等待sqr call
注意:Sequence 的执行接口是 task,因此允许等待时钟、延时和阻塞握手;
- 所以不能在
function phase中直接启动并执行 sequence。 - Sequence 通常在
run_phase、main_phase等 task phase 中执行。
但 sequence 不一定真的推进仿真时间,也不是只能在 task phase 中“出现”——它可以在 function phase 中被创建、配置或登记。
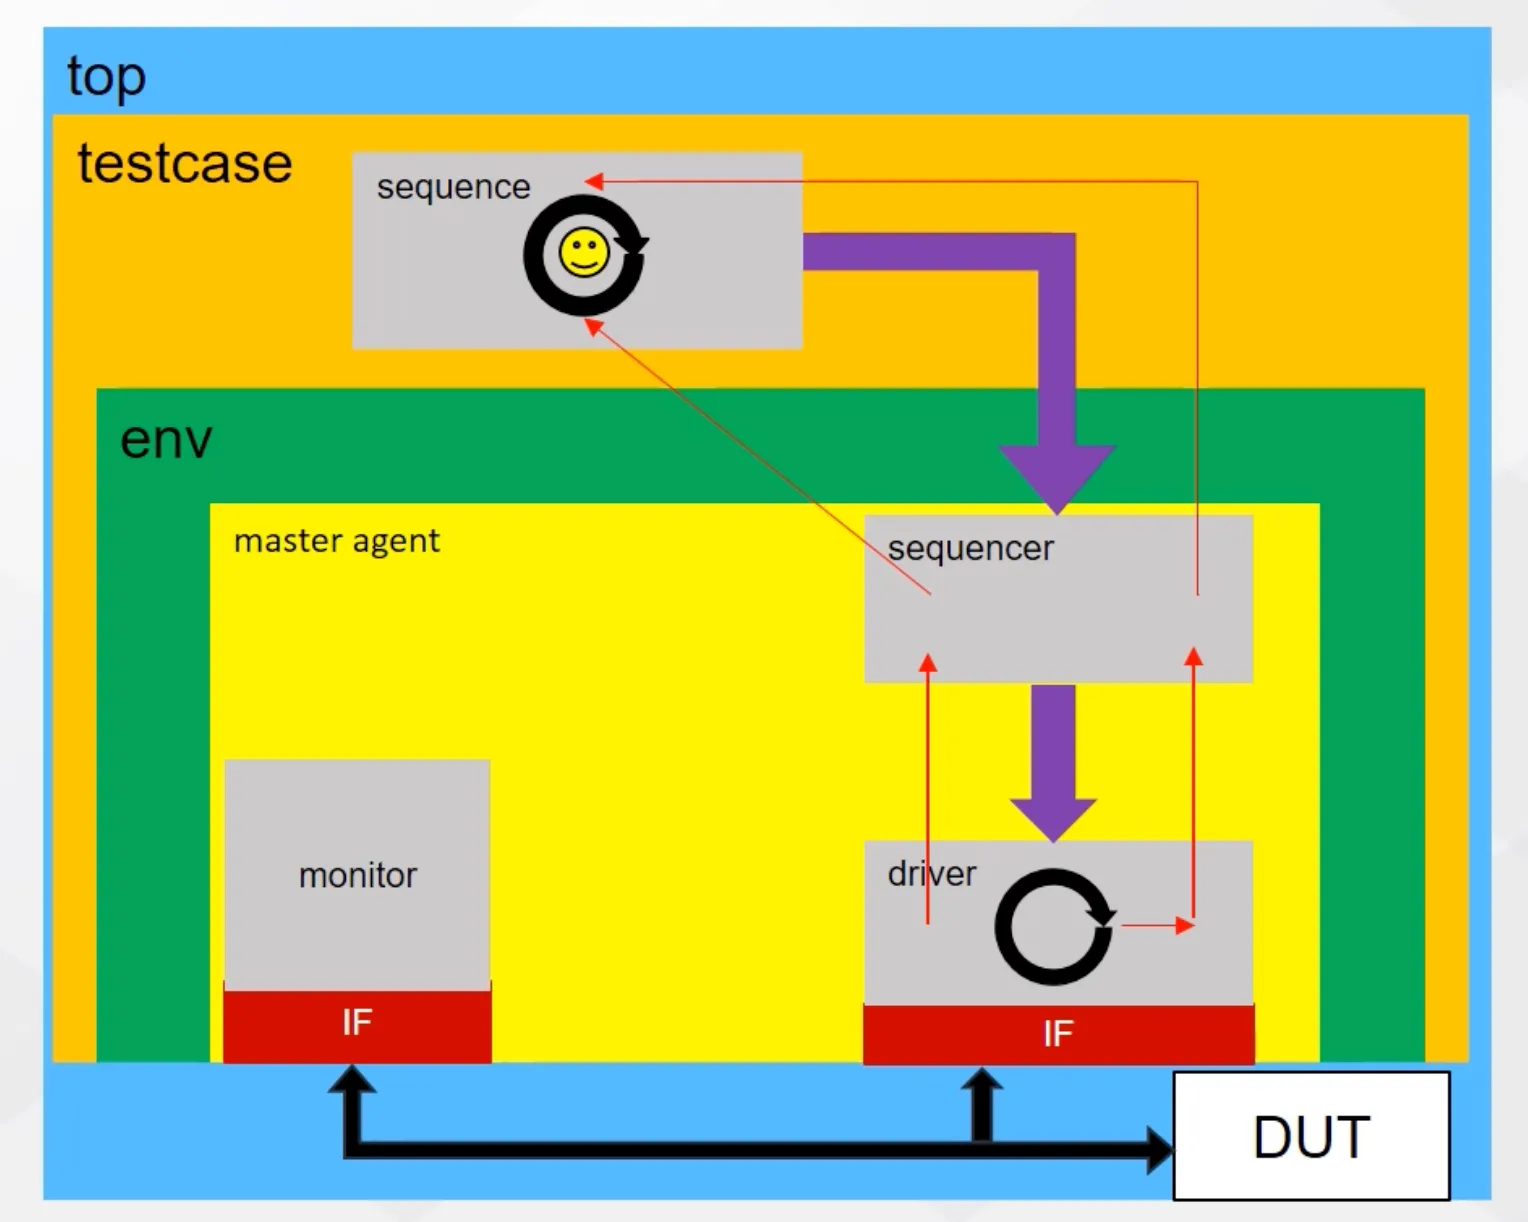
UVM为什么需要sequence:
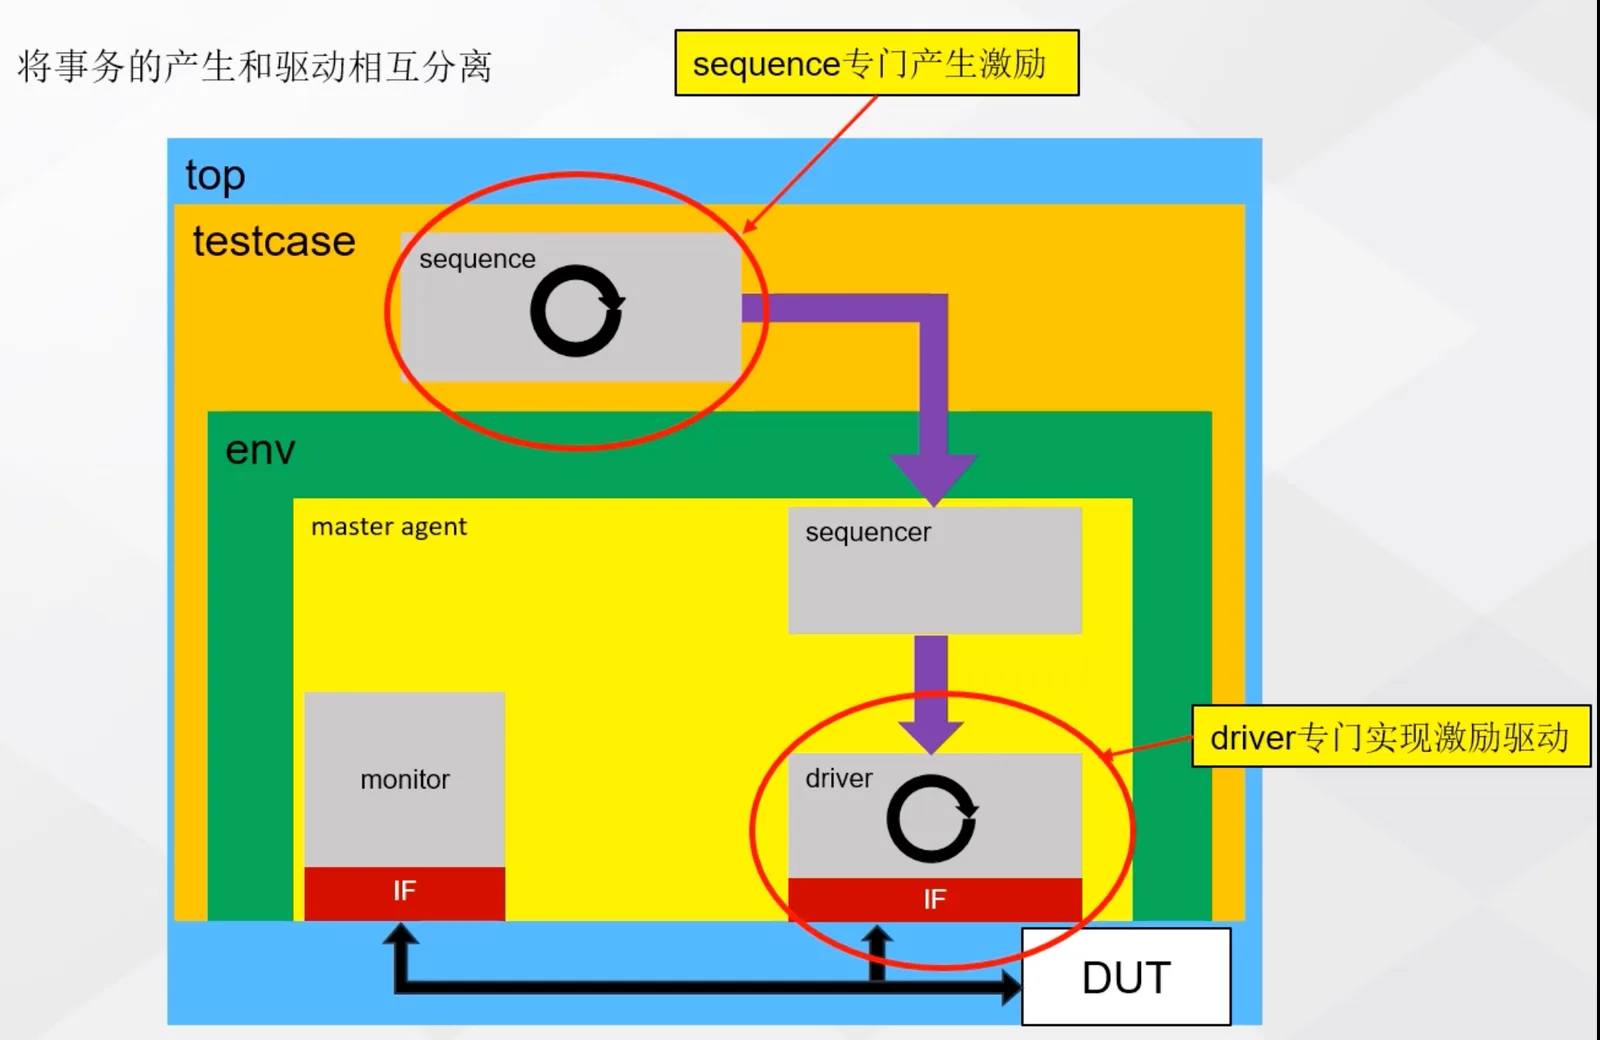
分离:将事物的产生和驱动分离开来,即driver可以不再需要关注事物的产生,专心将获取的事物驱动到dut上,对于不同的事物,可以使用同一个drv来驱动,实现drv重用性。
灵活:事物产生不再依赖于平台组件
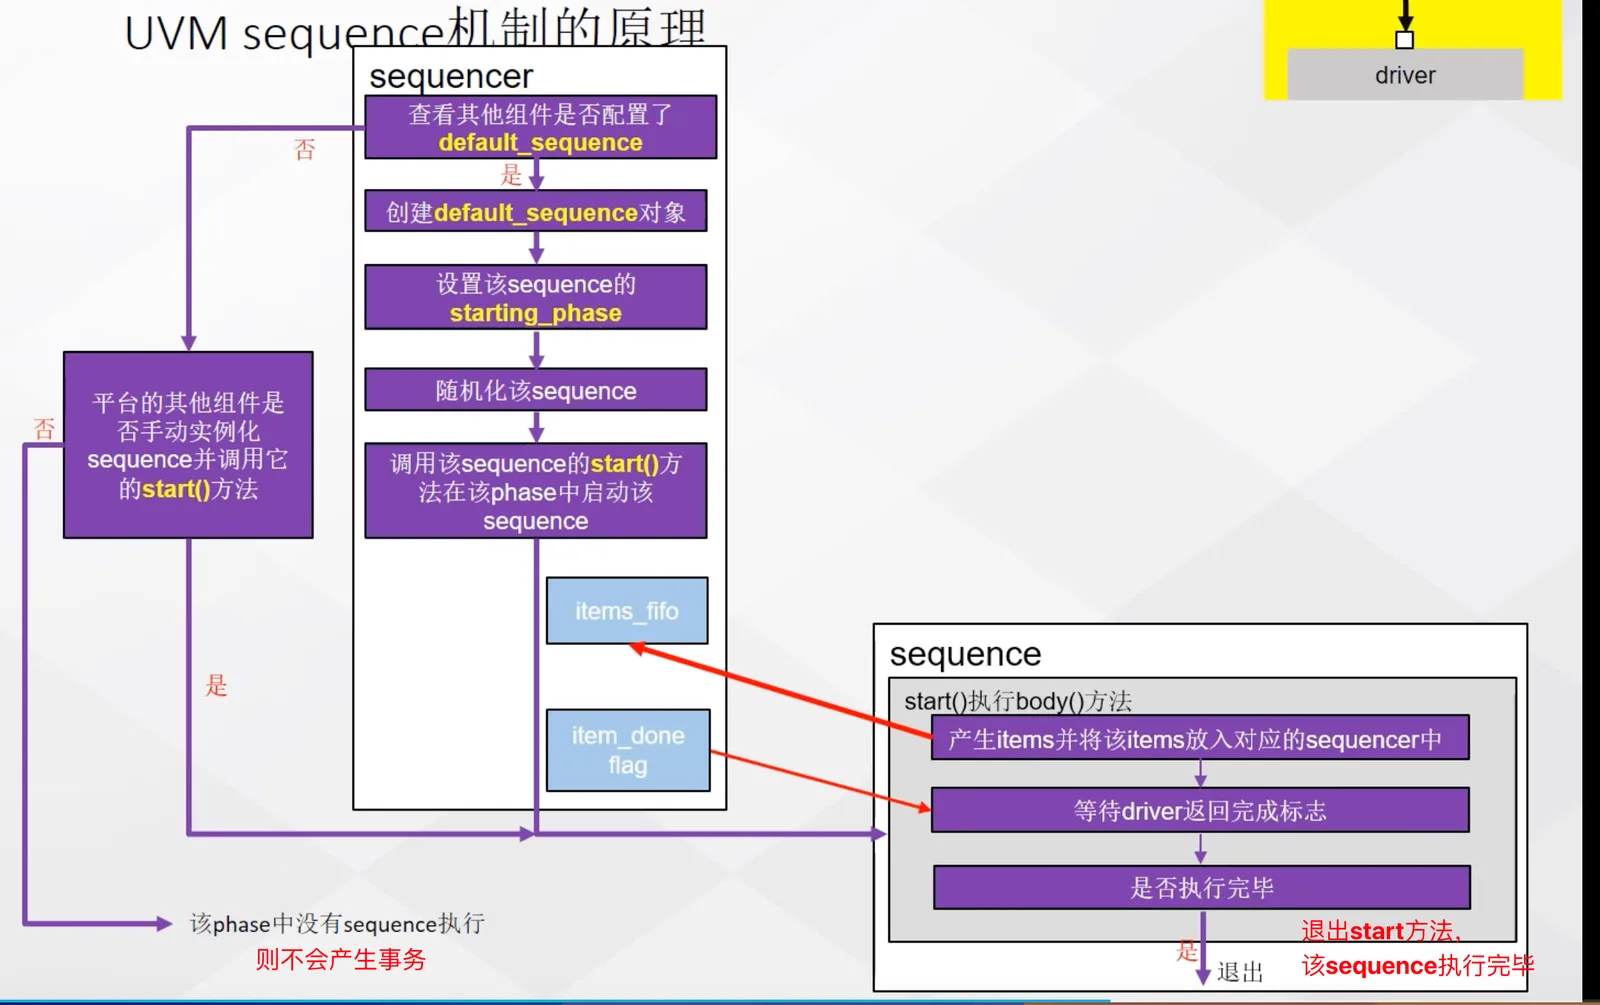
原理
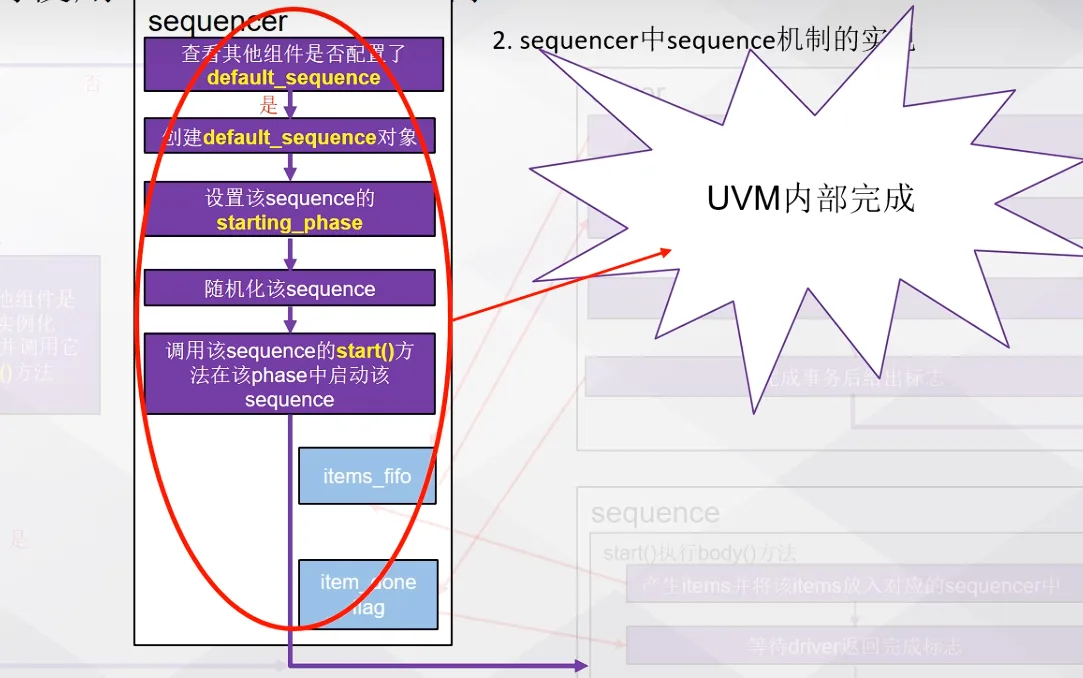
当进入某个task_phase后,sequencer会检查其内部default_sequence(内部的一个指针)是否被配置,然后…
- sequence在收到sequencer的请求后,会将item发送给它。再由sqr转发给drv。
- 当drv激励dut完毕后,会回传信息告诉seq其已完成数据传递。sequence接下来会继续产生下一个事物放入item_fifo中,并等待sqr call
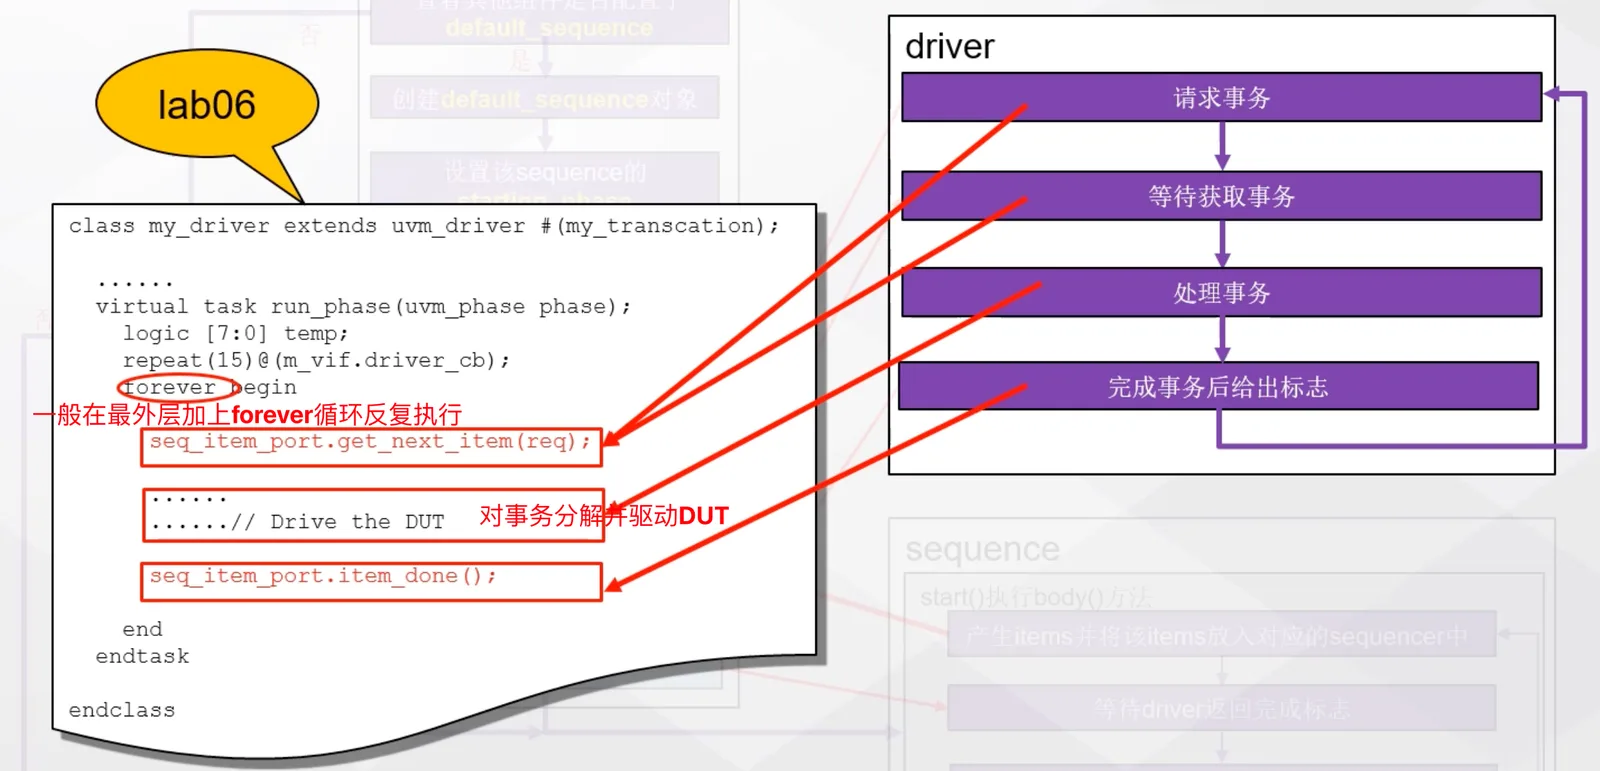
与此同时,driver的动作:
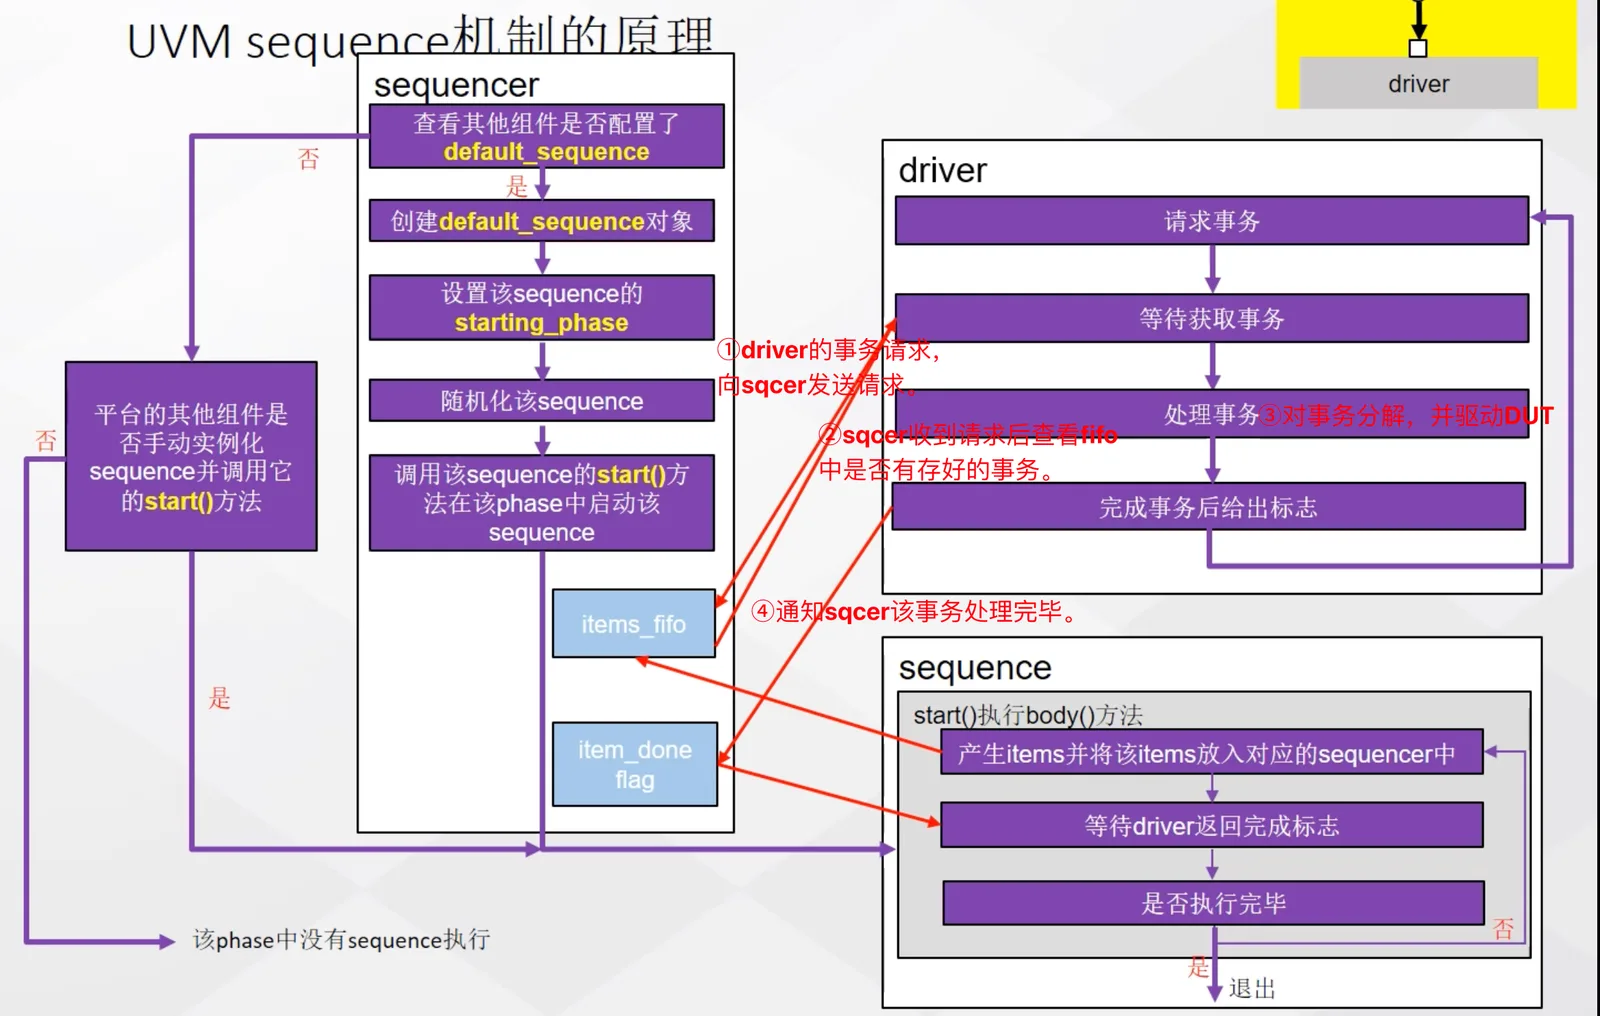
driver与sequence的交互是通过sequencer完成的。sequencer只是扮演的一个中间角色。
- 事务的产生在sequence中
- 事务的处理在driver中
objection 生命周期的时序图
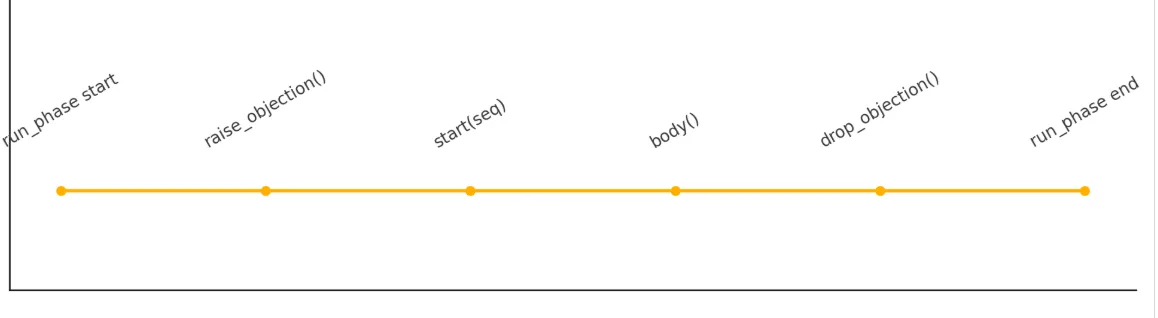
所有在 UVM phase(如 run_phase)中执行耗时任务(如 #delay、wait、seq.start() 等) 的 UVM component,都包含在 raise_objection()和drop_objection()中间,以防止仿真提前结束。
m_sequencer 与 p_sequencer
sequence 和 sequencer 是成对使用的:
- sequence:产生 traffic(事务序列)。
- sequencer:调度 sequence,把事务交给 driver。
sequence 想和 sequencer 交互,sequence 必须要能拿到 sequencer 的”句柄”。
m_sequencer
- 含义:指向当前 sequence 正在运行 的 sequencer。
- 用途:让 sequence 能通过它访问一些 sequencer 的通用功能。
- 定义位置: 定义在 sequence 中(xx extends uvm_sequence)。
p_sequencer
- 是 sequence 访问 sequencer 的正确入口。
p_sequencer是 sequence 内部访问所属 sequencer 的指针。- 动态绑定: sequence 是被 UVM 调度启动的,哪一个 sequencer 启动它,它的
p_sequencer就指向哪一个 sequencer。
class my_sequence extends uvm_sequence #(my_item);
  // 声明 p_sequencer,并且类型绑定为 my_sequencer
  `uvm_declare_p_sequencer(my_sequencer)

  task body();
    // 现在可以访问 my_sequencer 里自定义的方法了
    p_sequencer.my_custom_method();
  endtask
endclass
(后面 virtual sequence 一节里用 uvm_declare_p_sequencer 代替 $cast,就是这个机制。)
使用
1.driver中的sequence
2.sequencer中的sequence
UVM内部实现,直接拿来使用即可
3.sequence机制实现
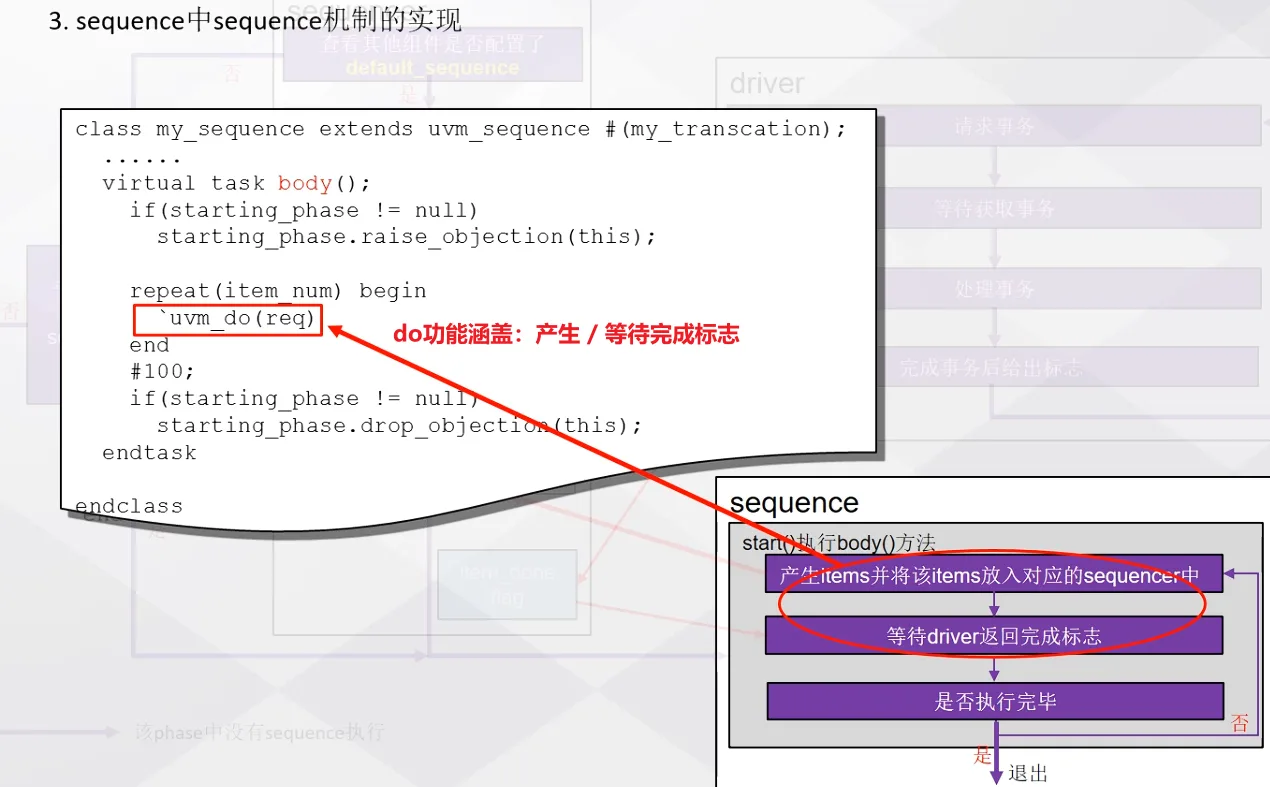
uvm_do宏
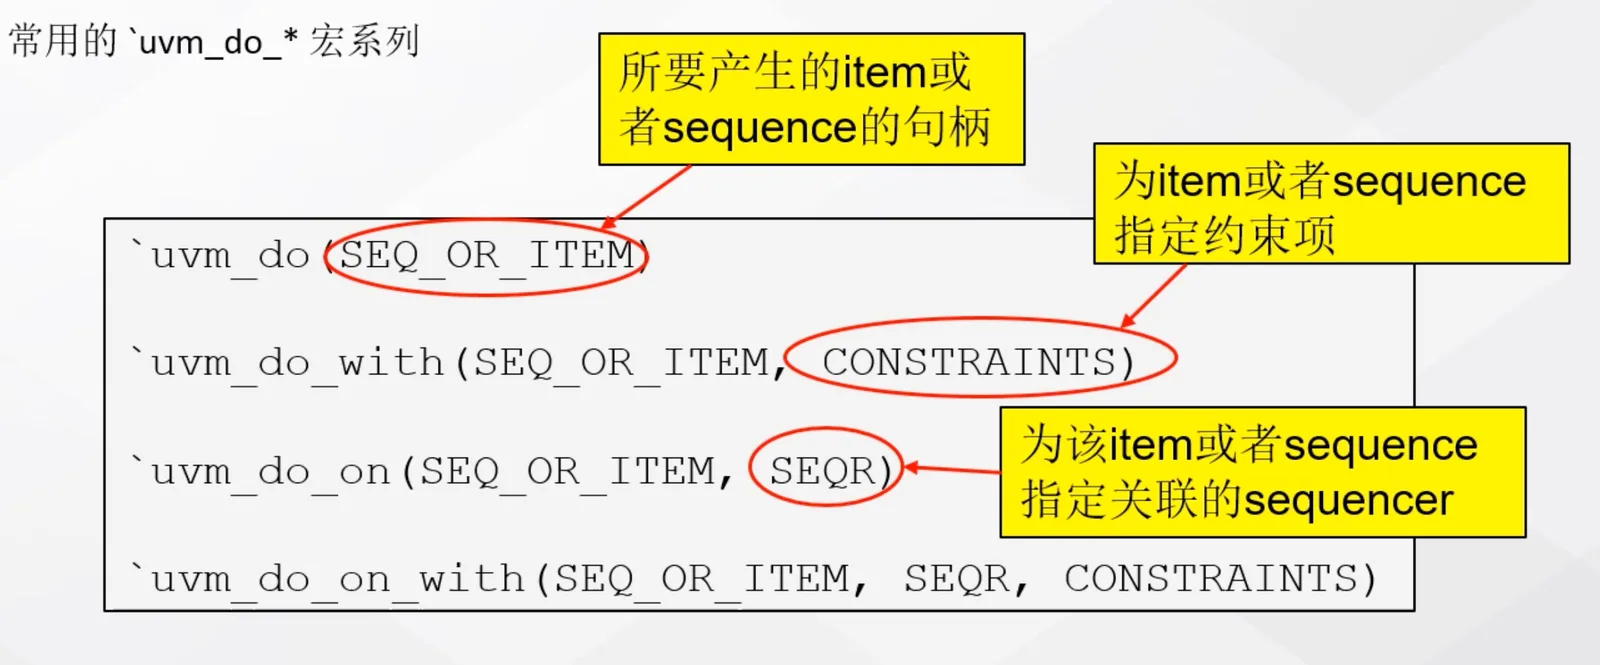
1.常用的uvm_do_* 宏
2.uvm_do_* 宏分解
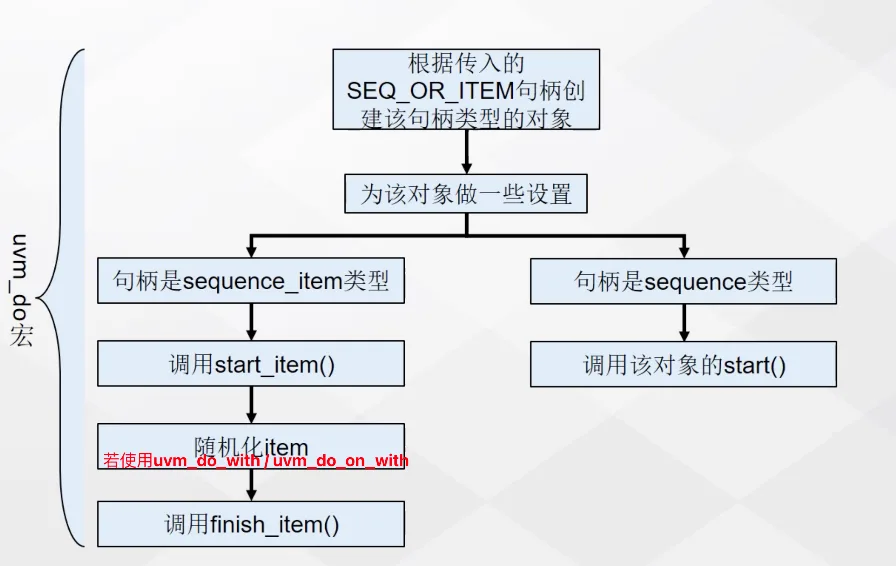
文字版 —— 一句话区别:do 做四件事,send 只做两件事(start_item(req); 和 finish_item(req);)。
| API | 用在 | 作用 |
|---|---|---|
start() | 在 test / driver / env 中启动一个 sequence,即自动调用 sequence 中的 task body(body 中就写了 uvm_do) | 启动整个 sequence,UVM 调用 body() |
start_item(req) + finish_item(req) | 在 sequence 内部,一般使用 uvm_do 概括使用 | 与 sequencer/driver 握手,发送一个事务 item |
uvm_do = “全自动发送一条 transaction(new + randomize + send)“,内部会做以下四件事:
- 创建一个 transaction(如果没提供现成的 item)。
- 随机化(调用
randomize(),如果有约束会一起生效)。 - 启动(调用
start_item())。 - 结束(调用
finish_item(),最终交给 sequencer → driver)。 本质上就是用来简化 sequence_item 的创建、随机化和发送过程。
uvm_send = “只发送,其他自己搞定”。
task body();
    req = my_item::type_id::create("req");
    assert(req.randomize() with { addr == 8'h10; });
    start_item(req);   // 通知 sequencer
    finish_item(req);  // 完成并交给 driver
    // 或者简写成:
    uvm_send(req);
endtask
此外,还有:
uvm_do_on(tr, this.m_sequencer)uvm_do_on_pri(tr, m_sequencer, 100)uvm_do_on_with(tr, this, {tr.pload.size == 100;})
uvm_do_on_pri有三个参数:第一个是 transaction 的指针,第二个是 sequencer 的指针,第三个是优先级。
uvm_do_with 在发送事务之前增加一个判断:
`uvm_do_with(m_trans, {m_trans.addr == 16'h9;
                       m_trans.bus_op == BUS_RD;})
这表示 m_trans 事务在执行时必须满足 addr == 16'h9 且 bus_op == BUS_RD 这两个条件。只有在这些条件满足时,事务才会被发送。
4.两种产生item的方法
也可以不使用do宏来产生事务。
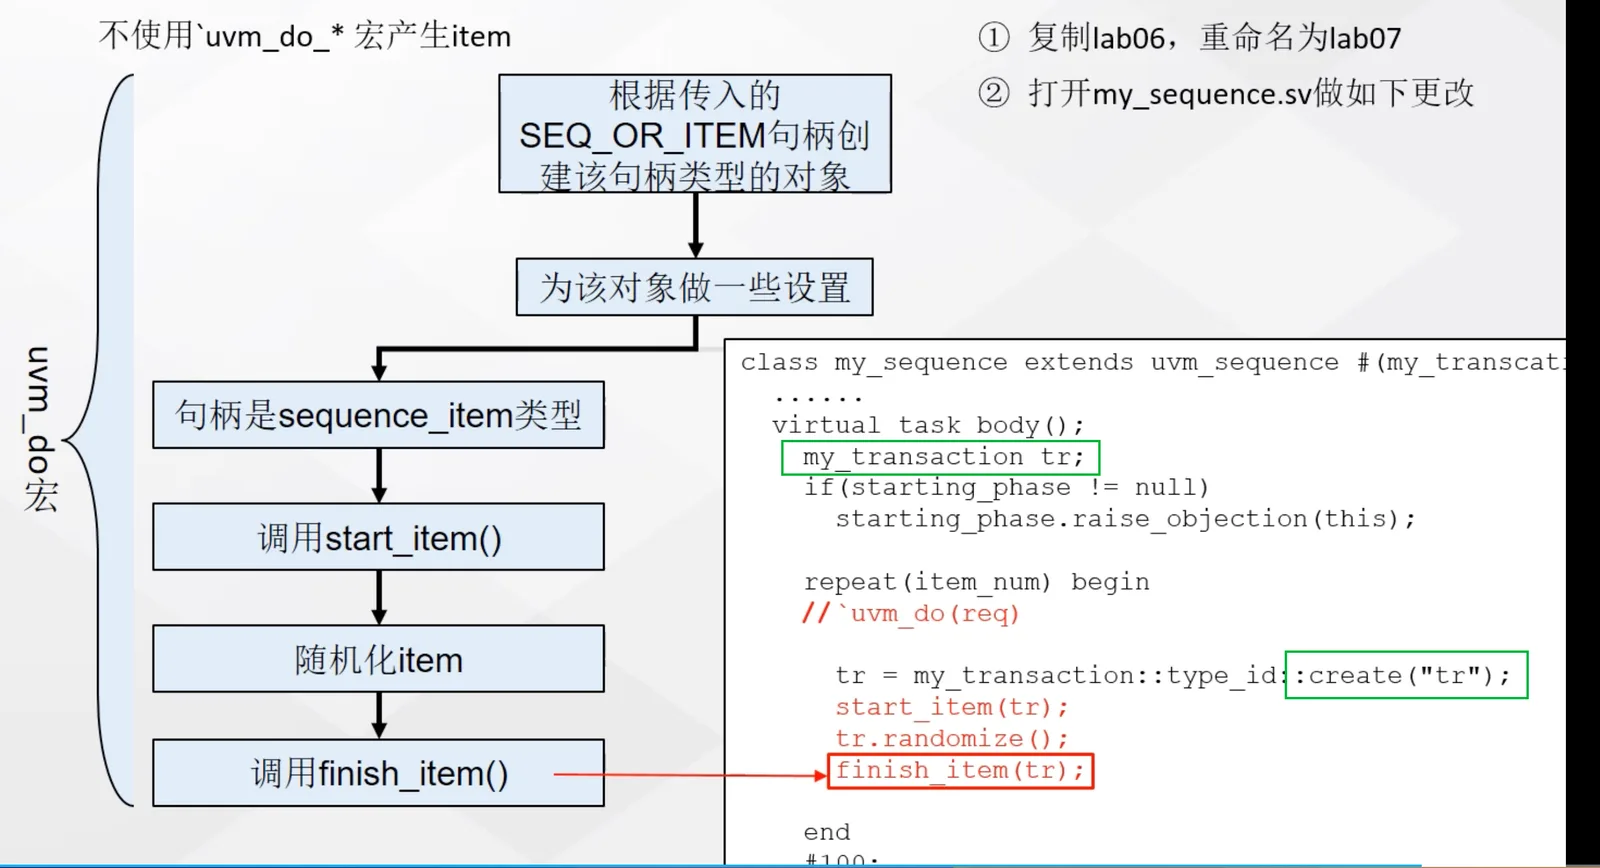
- 在 uvm_test 里的
run_phase中手动启动 sequence,需要使用raise_objection()和drop_objection()来防止仿真提前结束; 而在 sequence 的body()里调用子 sequence 的start(),则不需要这些操作。-
💡 Component 负责 phase 生命周期,必须处理 objection;Sequence 只处理事务逻辑,不参与 objection
-
sequence 是 uvm_sequence,它不是 component,没有 phase,也没有 objection 机制。它只是被 test 或 environment 启动的逻辑块,它的生命周期是由调用者负责的。
-
5.两种启动sequence的方法
5.1 default_sequence
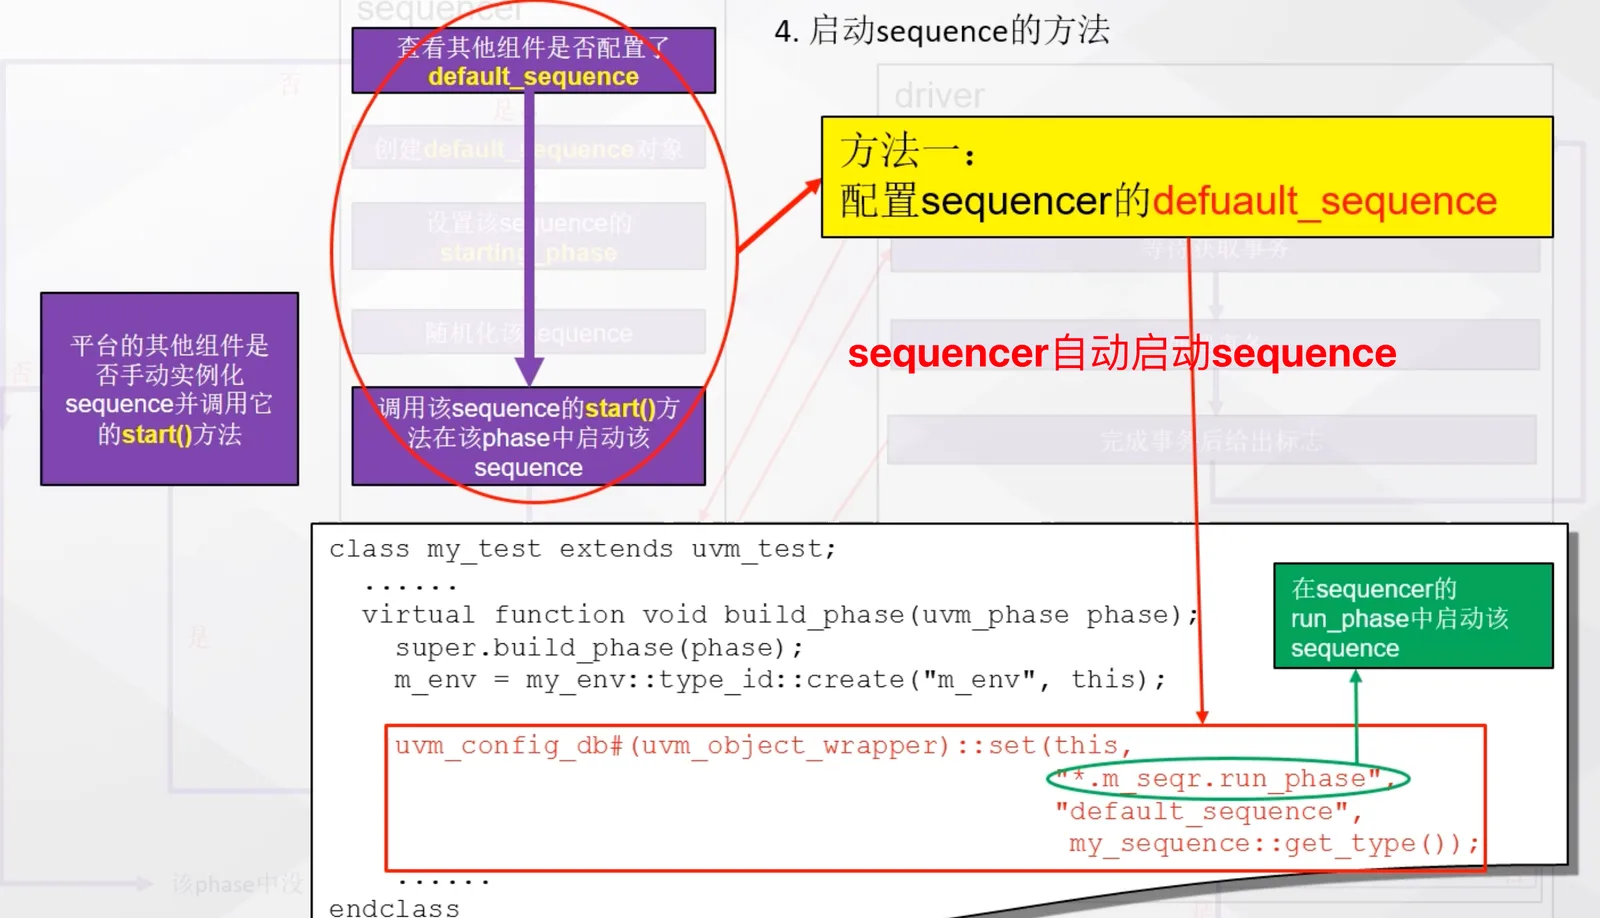
告诉 sequencer:run_phase 开始时,自动启动 名为 my_sequence 的sequence
default_sequence
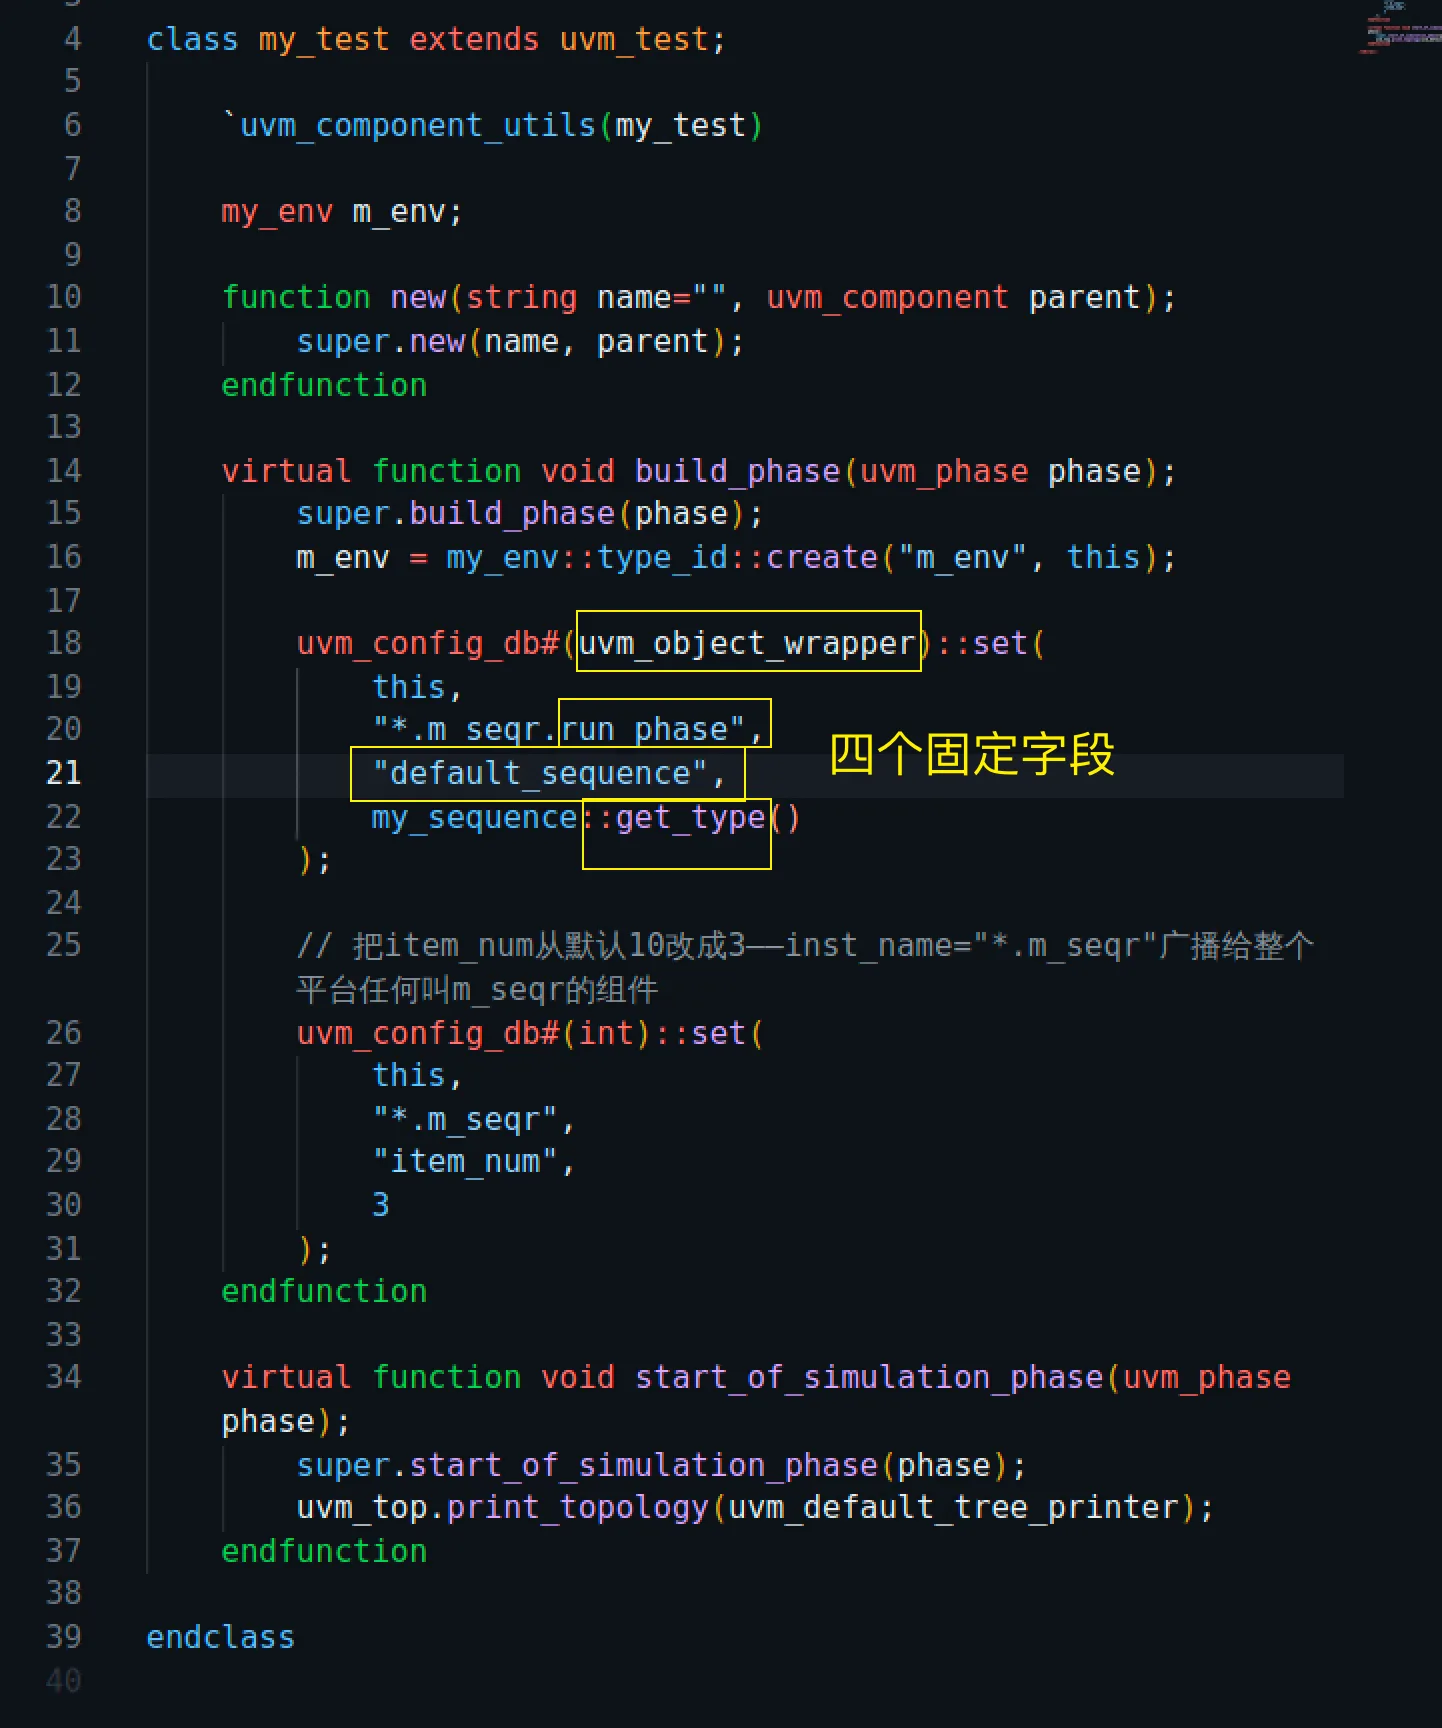
这里configuration机制不是set变量值,是告诉 sequencer 自动跑哪个 sequence 类。
- inst_name 拆解: “*.m_seqr.run_phase” —— 通配符匹配平台里任何叫 m_seqr 的组件,精确到它的 run_phase 这个阶段。>
- 作用: sequencer 进入 run_phase 时,内部会自动检查有没有人给它这个 phase 配置了 default_sequence。配了的话,自动 create 并 start 这个 sequence,不需要你手写 m_seq.start(m_env.m_agent.m_seqr)。
- my_sequence::get_type() 拿到的是 my_sequence 这个类型在 factory 里的类型句柄(不是对象实例), 赋值到 “default_sequence” 这个 UVM 内建的资源名里。
5.2手动启动
更为常用
- 在启用
start方法时,需要指定与该sequence相关联的sequencer
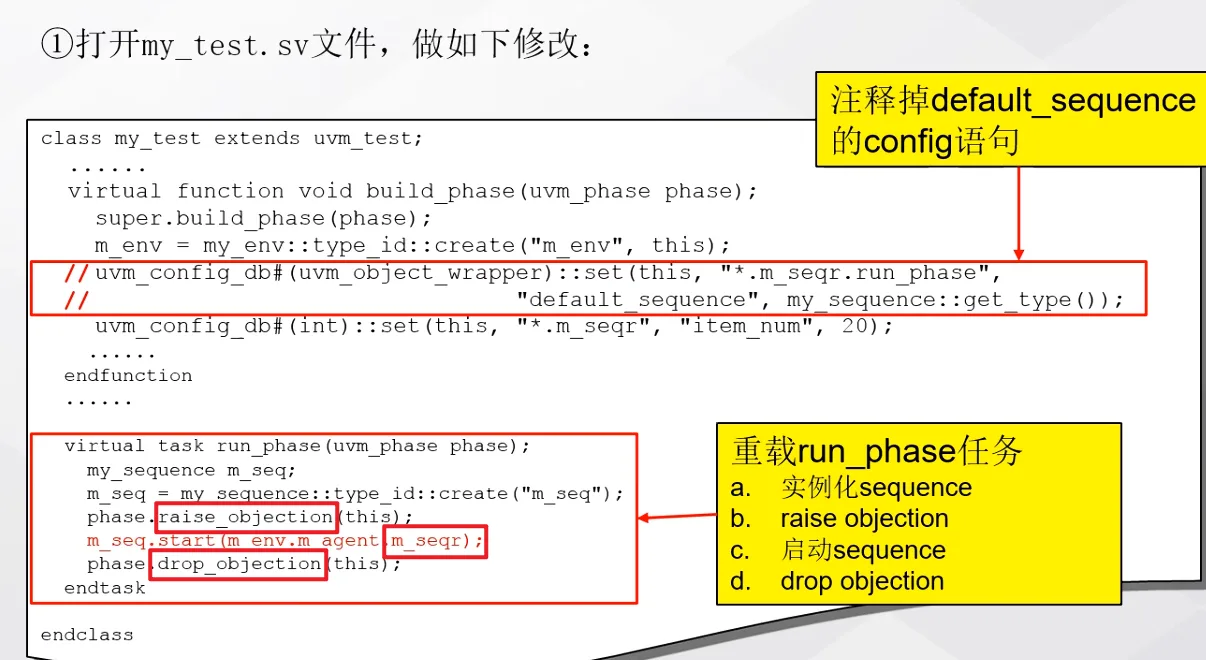
6.sequence嵌套
一个sequence中可嵌套其他子sequence
- 在一个sequence中同时启用reset、write sequence
以下例子中三个sequence会依次启动(由于sequene控制)
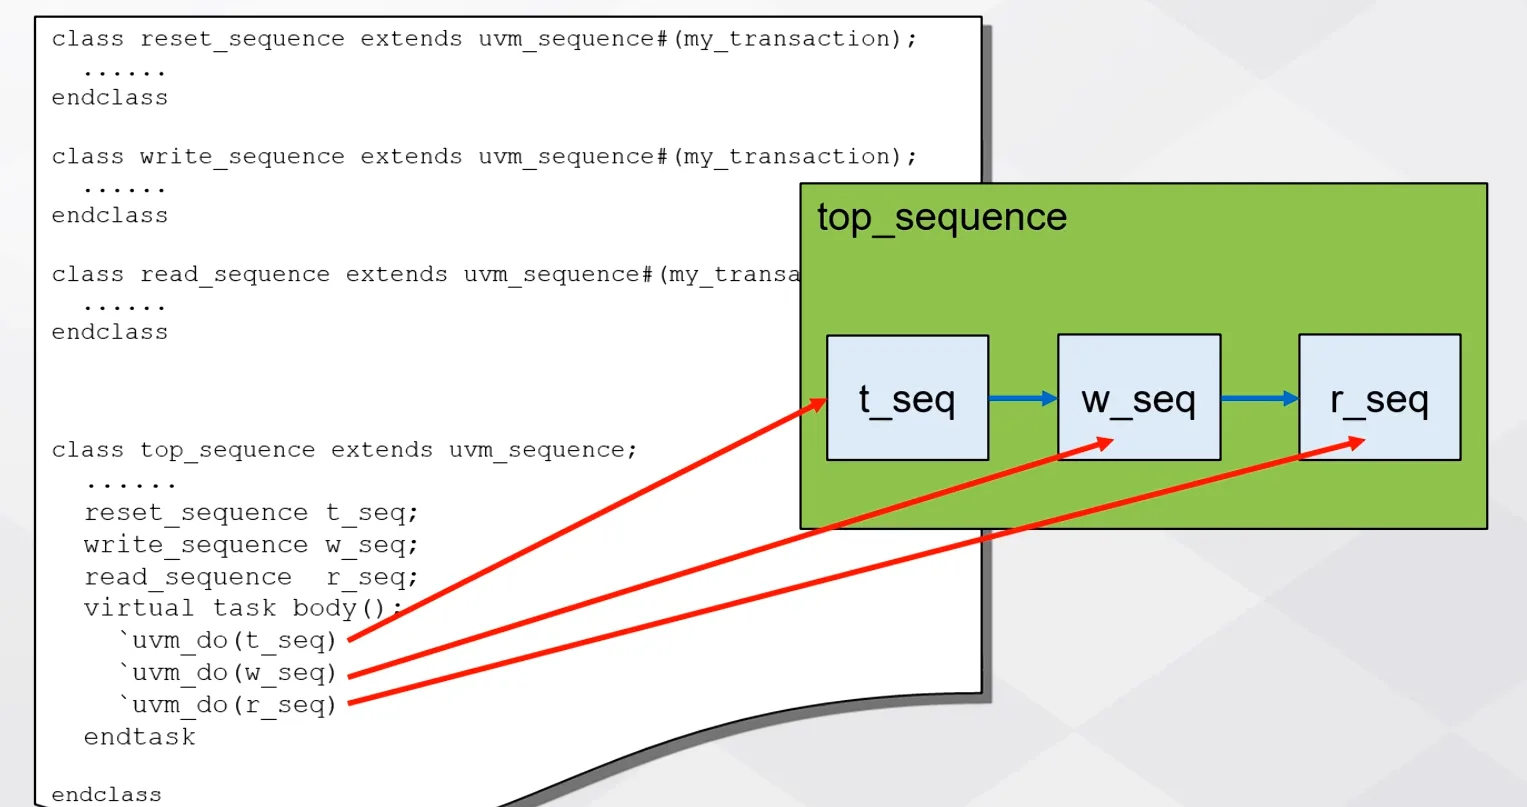
一个sequencer同一时刻只能接收一个对象,所以并行需要仲裁
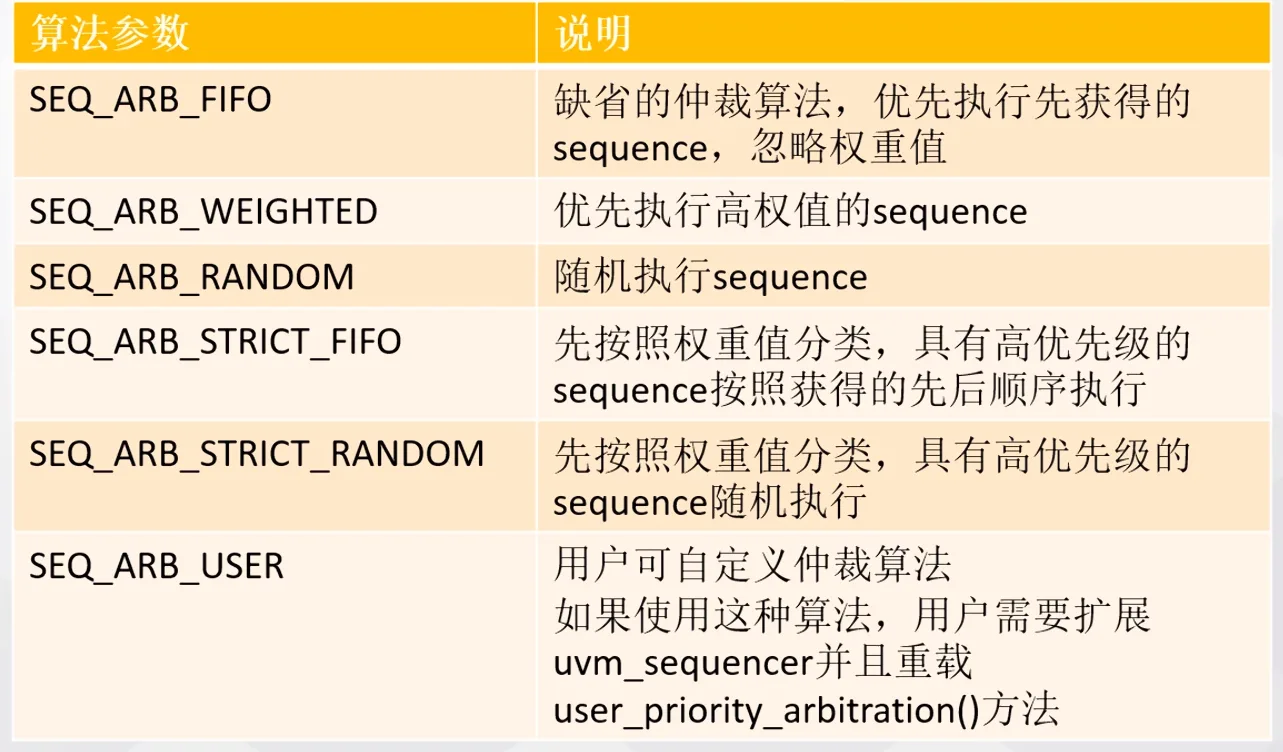
6.sequence仲裁机制
注意:只有对同一个sequencer同时启动多个并行的sequence时,才需要仲裁 若有多个sequence,但他们都对应不同的sequencer则不需要仲裁
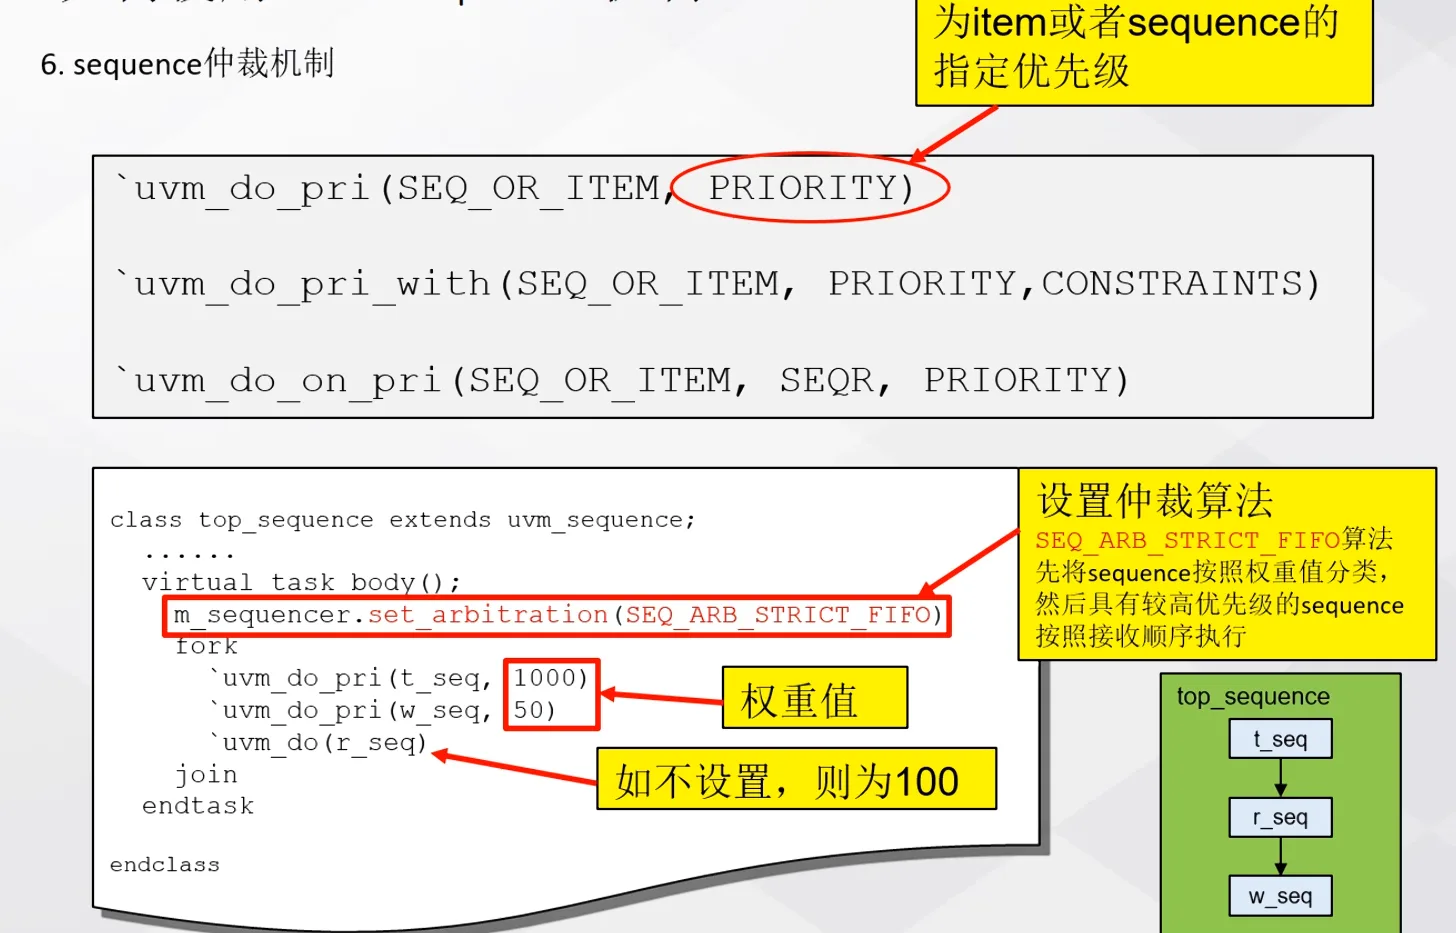
对sequence进行仲裁的场景较少,了解即可
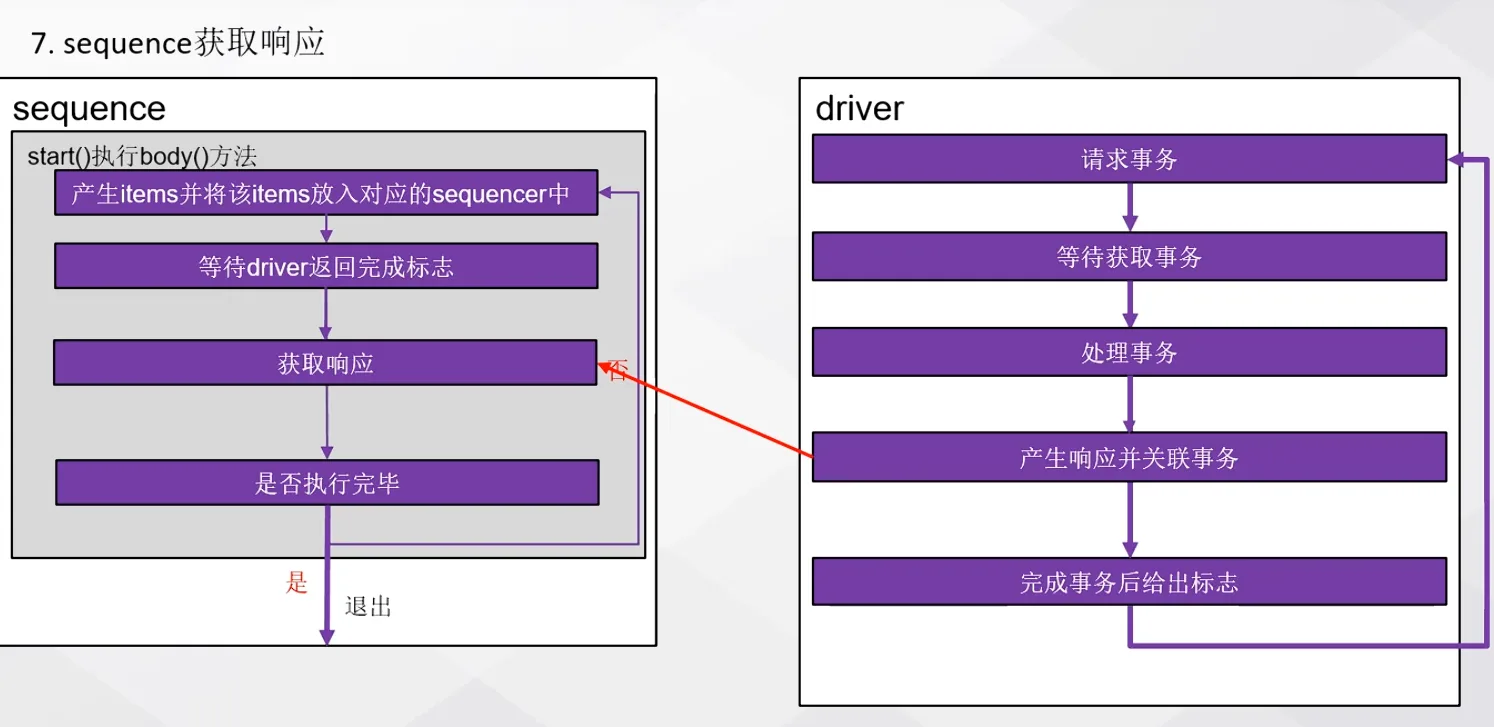
7.sequence获取响应
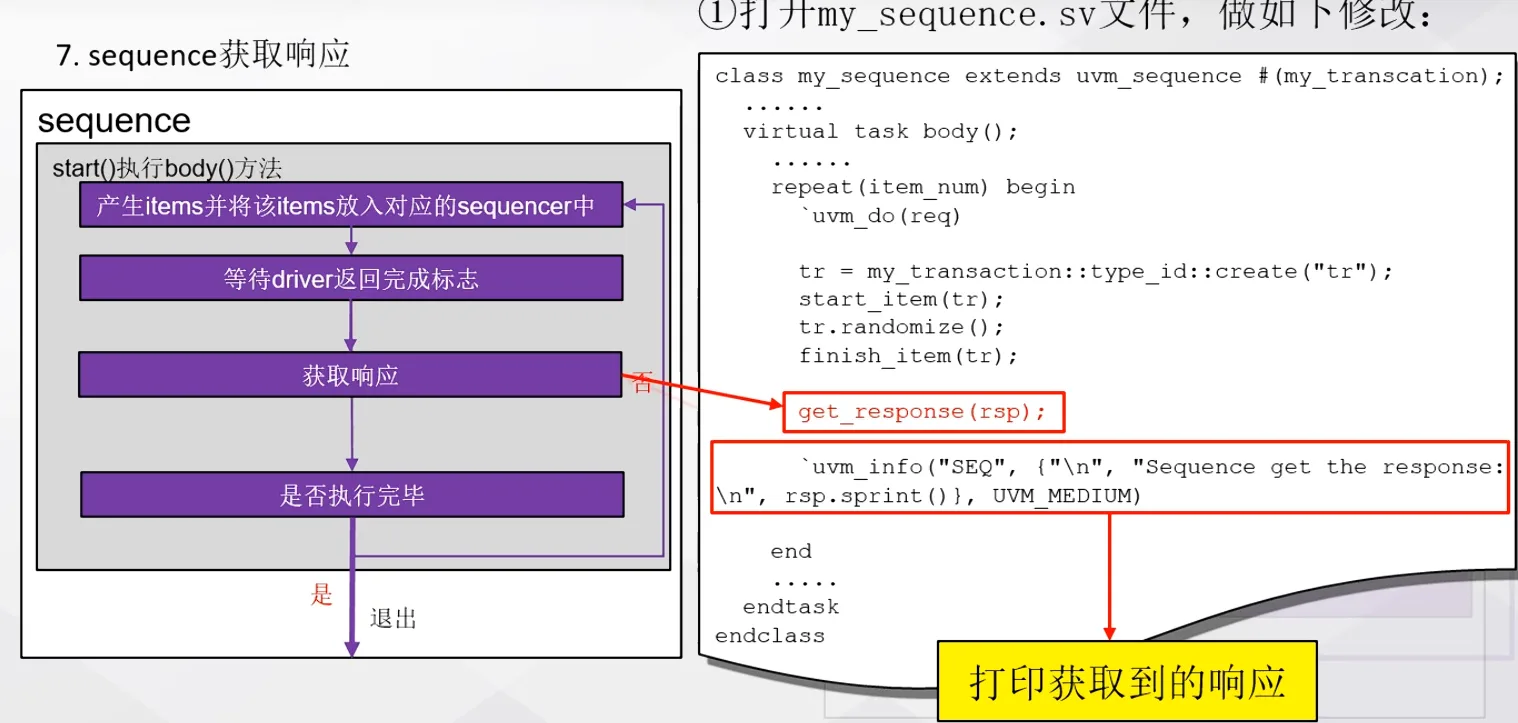
get_response(rsp); // 作用:从driver处获取响应driver需要在返回标志发送之前,发送响应,从而保证sequence获取返回标志之后,响应已经被发送过来
get_response(rsp); —— 该方法的功能是从driver获取响应
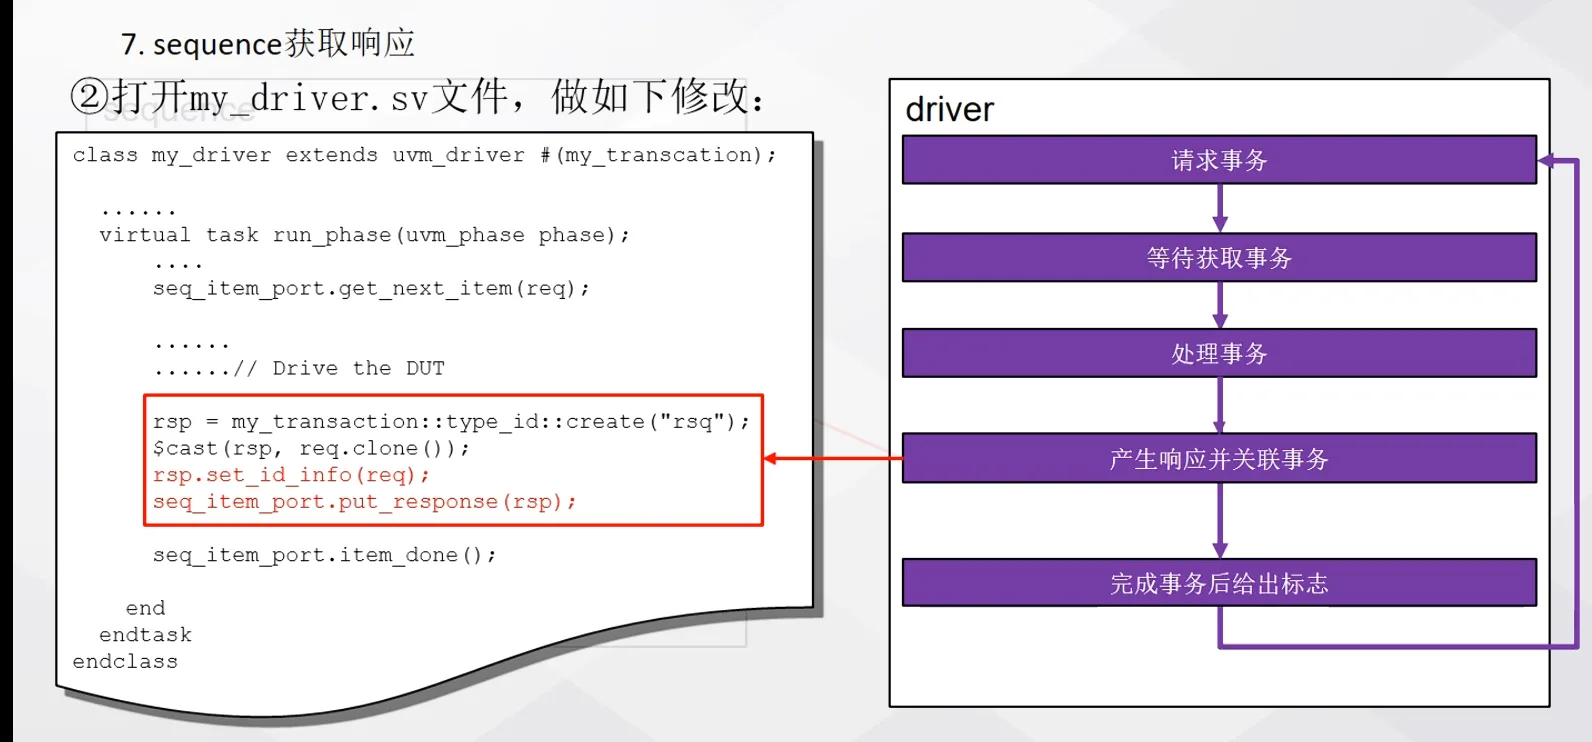
rsp.set_id_info(req); //调用响应对象的set_id_info函数,将响应与对应的事物相关联(响应与事物应该一一对应),注意:函数的参数(rep)就是该响应对应的事物
.put_response(rsp); // 发送响应

注意:以上代码要放在get_next_item和item_done之间
Driver代码
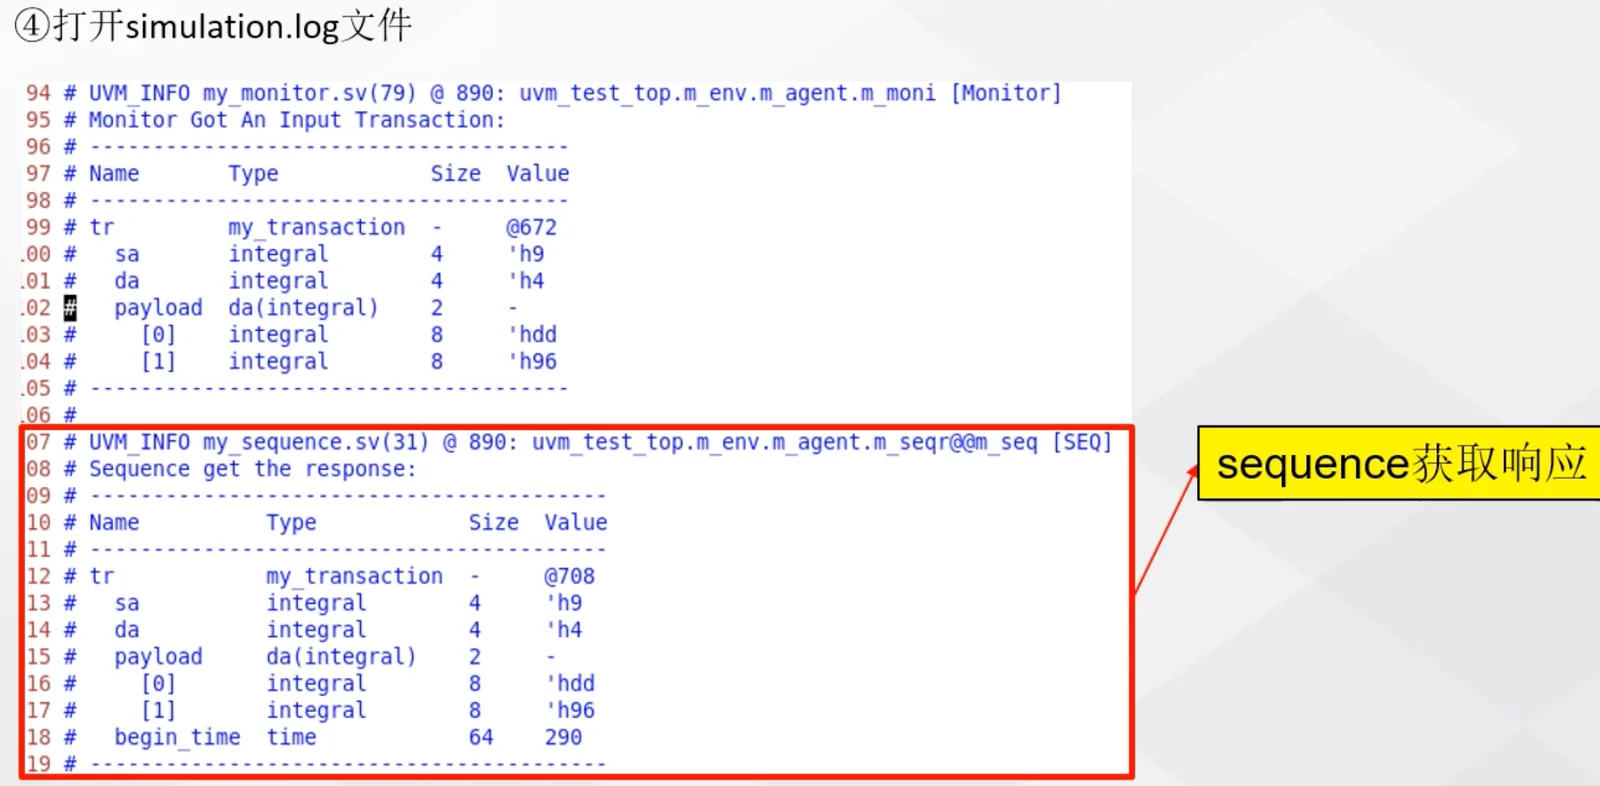
8.sequence总结
- 了解什么是UVM sequence机制
- 了解UVM sequence机制的原理
- 学会构建较为复杂的sequence
- 会使用两种方法产生items
- uvm_do_* 宏
- ①start_item(tr) , ②tr.randomize(), ③finish_item(tr)
- 会使用两种方法启动sequence
- default_sequence
- ①声明sequence句柄,②指定该sequence启动使用哪个sequencer,③m_seq.start(m_env.m_agent.m_seqr);
- 注意:所有 sequence 启动的前提是顶层已调用 run_test(“xxx”),它负责拉起整个 UVM 环境;
start只是在这个环境里跑某条 sequence
- 注意:所有 sequence 启动的前提是顶层已调用 run_test(“xxx”),它负责拉起整个 UVM 环境;
- 在必要的时候,sequence可以从driver处获取响应
run_test()只调用 一次(在initial里);.start()可以多次调用,每次启动一段 sequence。
仿真时间 ─────────────────────────────────────────────────►  t=0
              │
              ▼
       run_test("test_top")
              │
              │   ① UVM phase 机制自动启动
              │      ├─ build_phase       → 创建 env / agent / sequencer / driver
              │      ├─ connect_phase     → 连线
              │      ├─ end_of_elaboration
              │      ├─ start_of_simulation
              │      └─ run_phase (task)  ──┐
              │                              │ ② 在这里,sequence 才登场
              │                              │    ├─ 如果用 default_sequence:
              │                              │    │   sequencer 自动启动 phase 里指定的 seq
              │                              │    └─ 如果手动 start:
              │                              │       my_seq.start(m_seqr);  ◄━━ 在此发生
              ▼                              ▼
③ driver 拿到 item,驱动 DUT| 调用 | 一句话作用 |
|---|---|
run_test("xxx") | 启动整个仿真(让 UV 环境”活过来”) |
seq.start(seqr) | 启动一条具体的 sequence(让 driver 去跑激励) |
| run_test(“xxx”) |
- 它是uvm_pkg导出的全局task,不属于任何class
- 它是仿真入口——被调用之前一个UVM对象都不存在,只能由静态的module世界点火
- 它负责创建uvm_test_top(这个实例名是UVM硬编码的),然后驱动全部phase跑完
8 TLM
名词解释:port(主动方),import(被动方)
概念
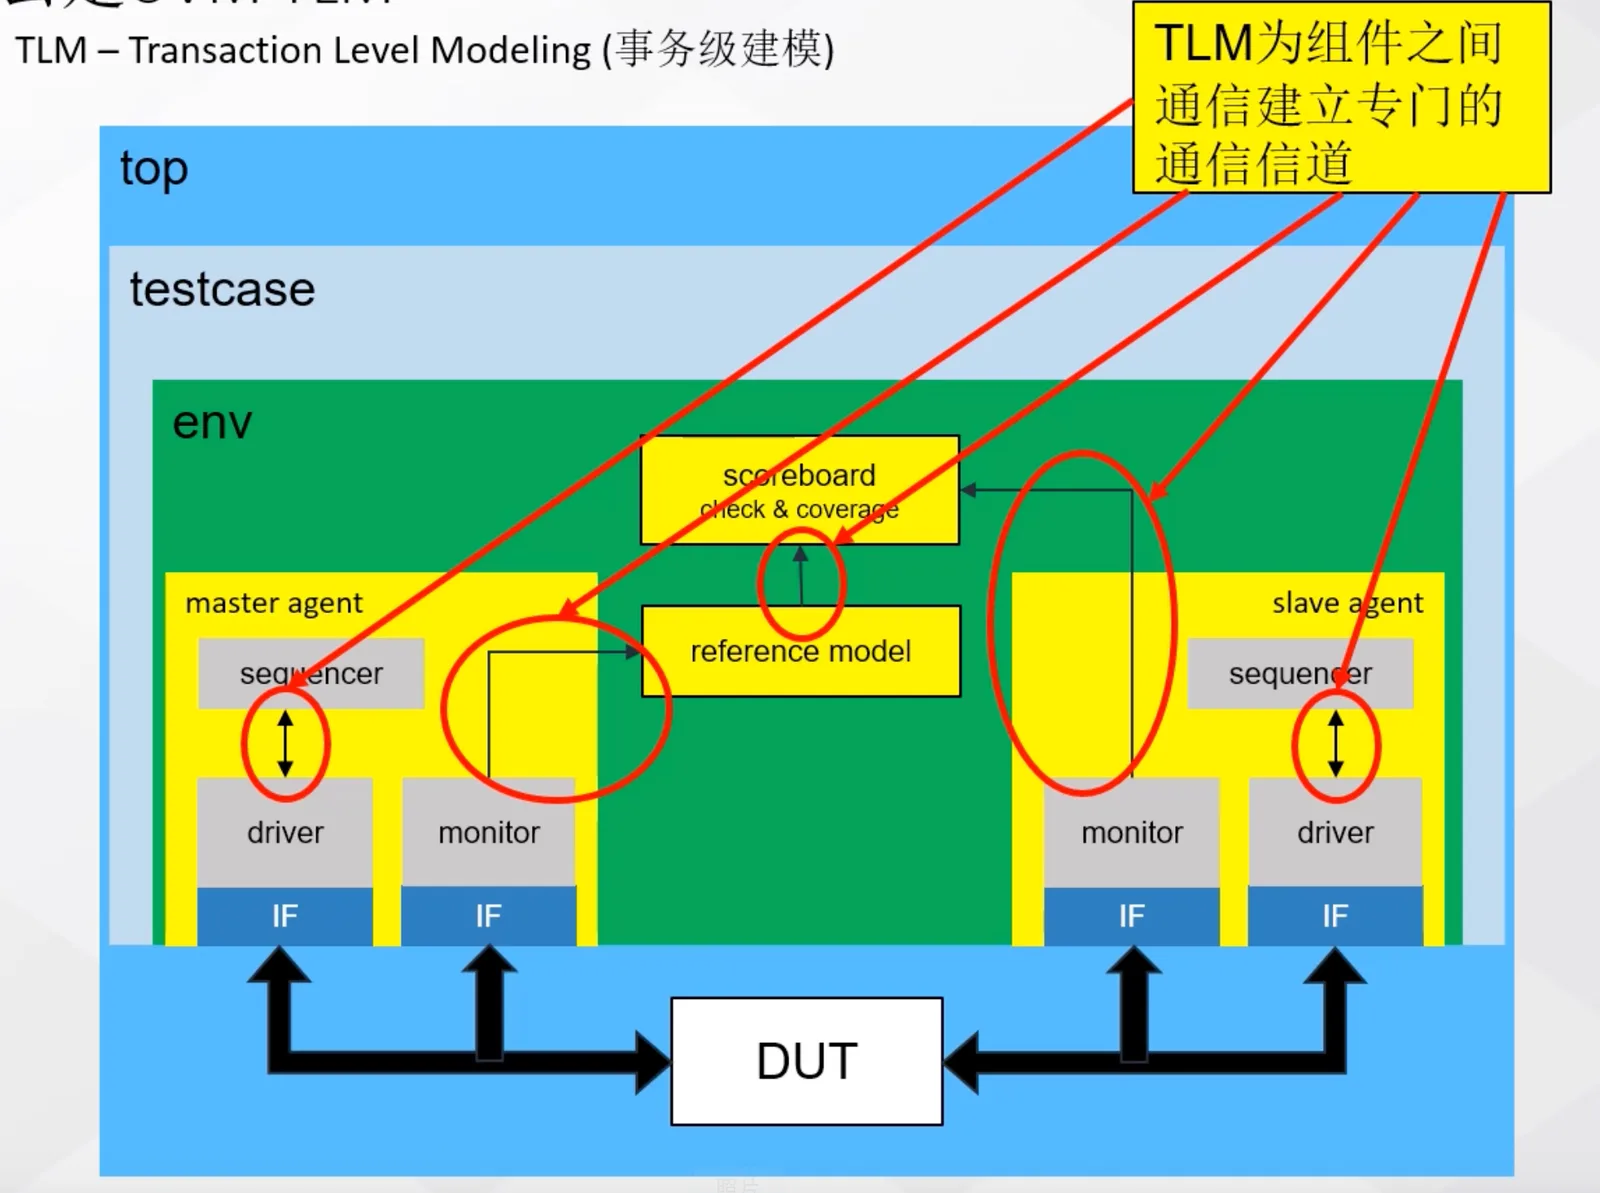
实现uvm组件间互联(如monitor将dut的响应发送给scb)
TLM优点:
- 为单独两个组件间建立专门的通信通道,避免出现混乱
- 使得每个信道单独独立,互不影响
在哪里connect两个组件?一般在env或agent中的connect_phase中连接
原理
- put/get模式(一对一)
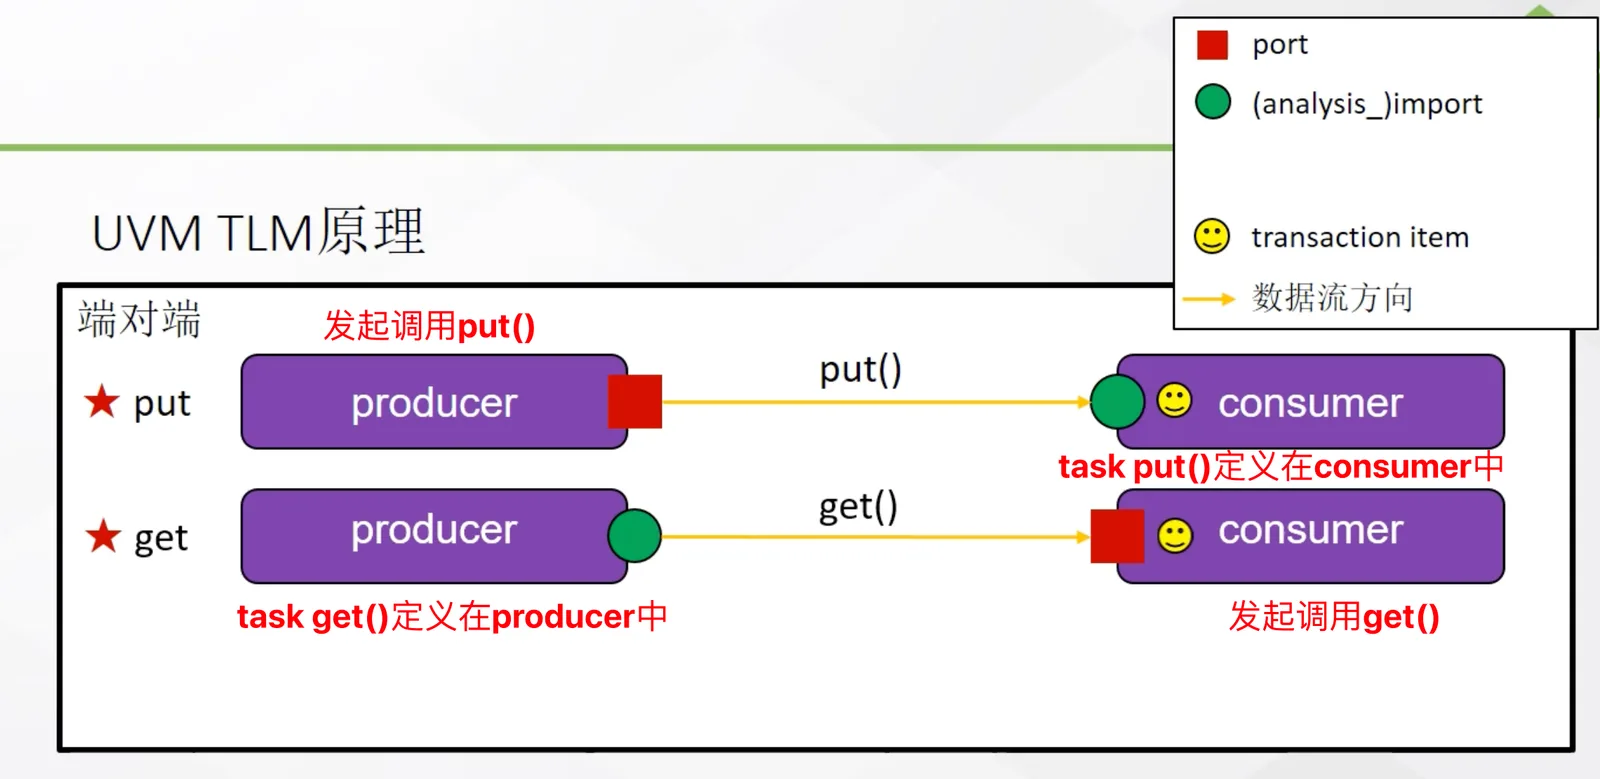
在TLM机制中,拥有port类型端口(比如发起调用put()或get() )的一方为发起方,拥有import类型端口的组件是被动方 比如: 在get模式情景下,get任务定义在consumer一端的组件中,而调用这个任务是在producer组件中调用的。
FIFO模式
- 无论是port.put()还是port.get(),都不知道对手组件的准备情况如何(当下是否能接收数据)。所以在其中间引入 FIFO,
此时,producer和consumer都是操作的主动方(port),而FIFO就作为两者的被动方(import)
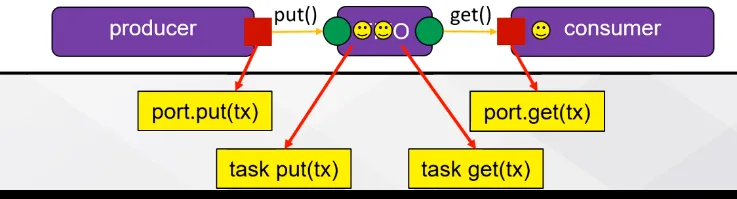
write模式
-
write模式(广播模式——使用analysis端口):一对多的情况(一个事物同时发送给多个组件的情况。如monitor给reference model和覆盖率收集的其他组件) 注意:write模式可以一对一的连接,不一定要一连多,并且也不一定要在对手组件中重载write函数(fifo中内置写好了write函数)
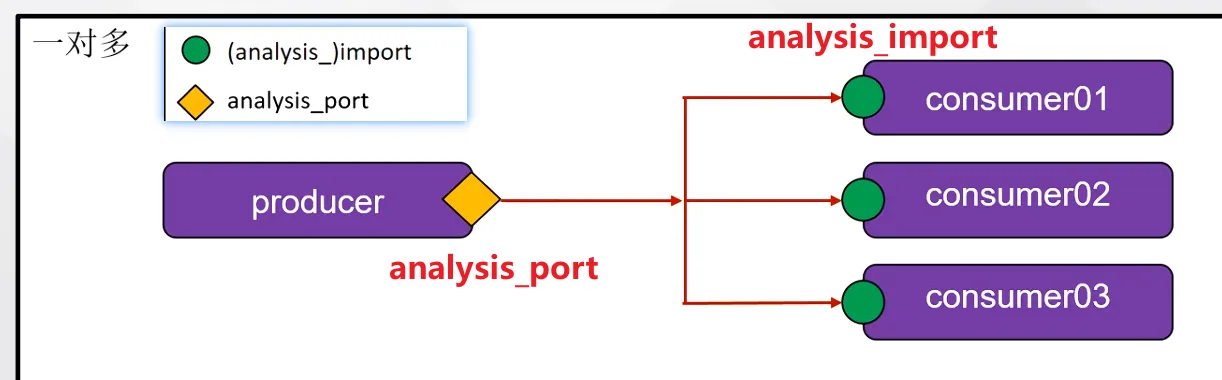
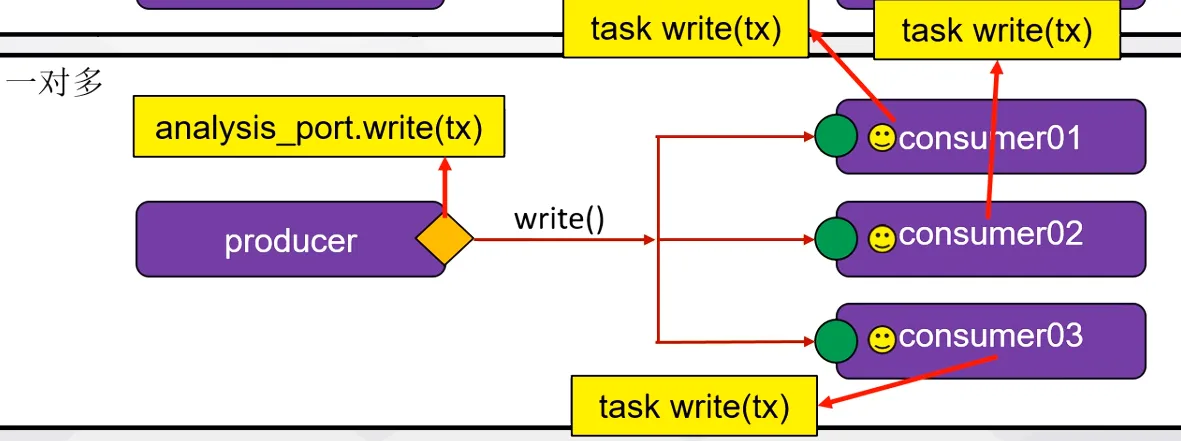
发送的过程是同时进行,并且发送的事务是一样的。
对应组件中的write函数需要工程师自己在对应的consumer组件中完成,以实现想要的功能
TLM port/imp/export
port/imp
每一种port都要和import一一对应使用;put或get任务都定义在import一端的组件中。
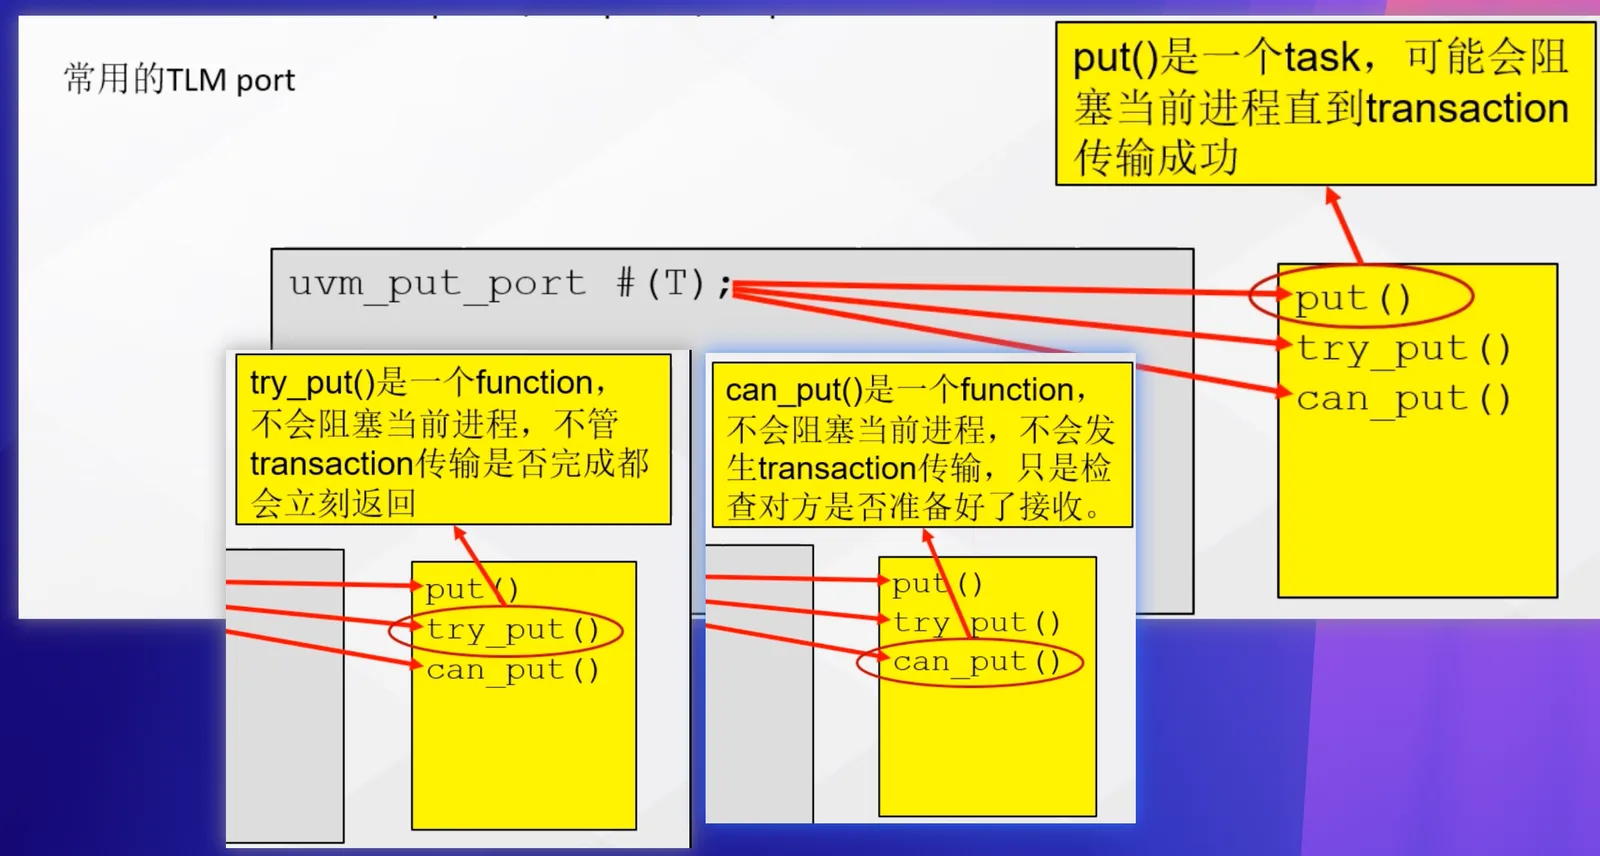
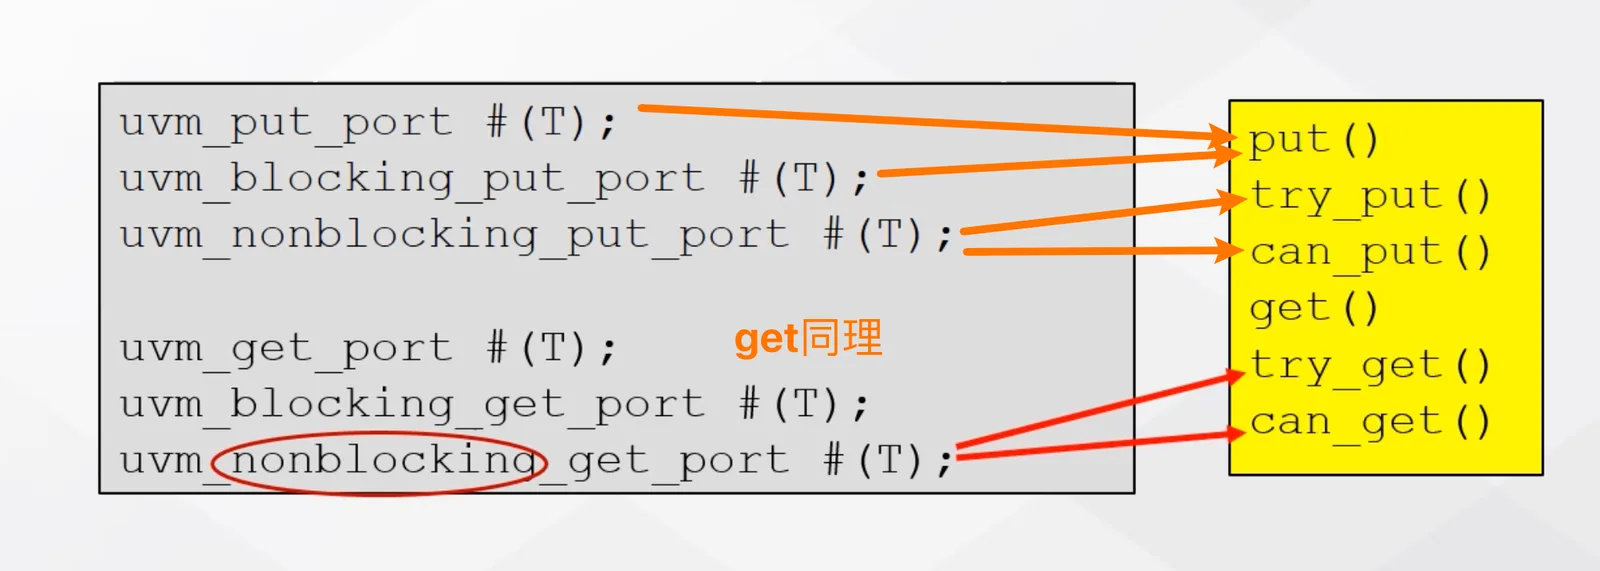
这些方法都需要工程重载才可使用。
port与imp一一对应
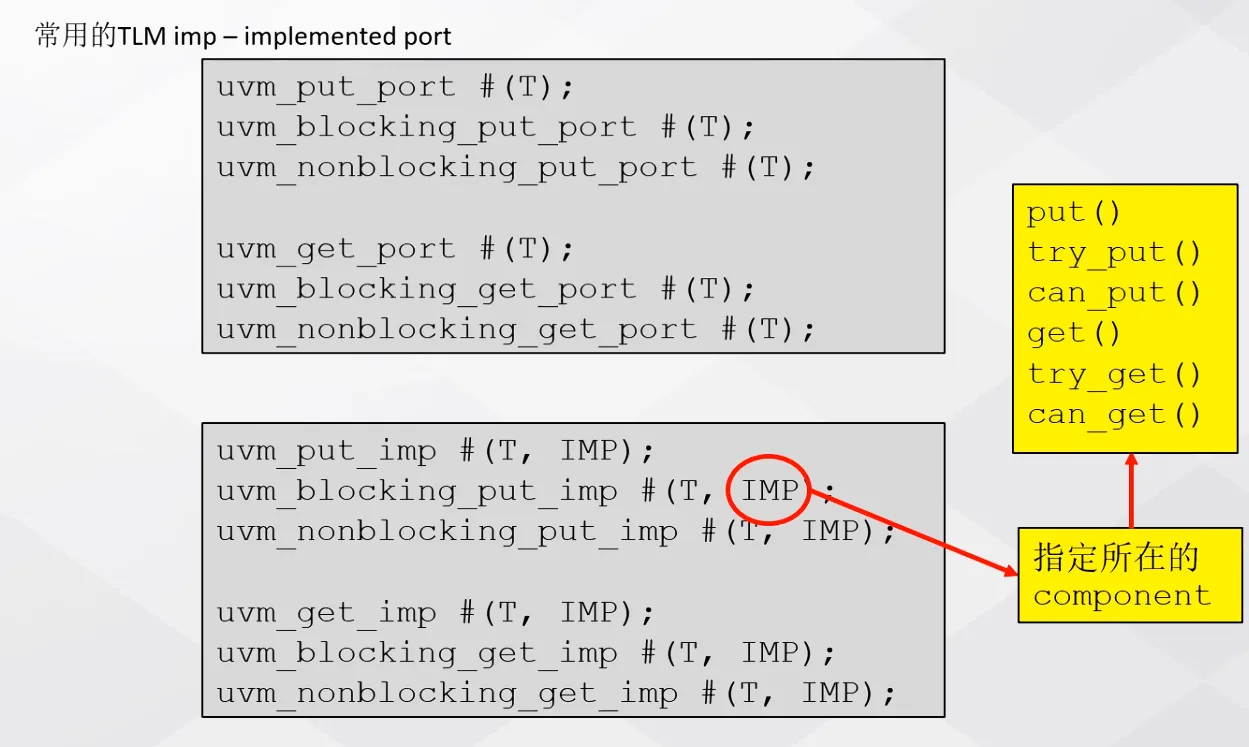
第一个参数是将要传输的transaction,第二个就是实现接口的uvm_component
port方法源码
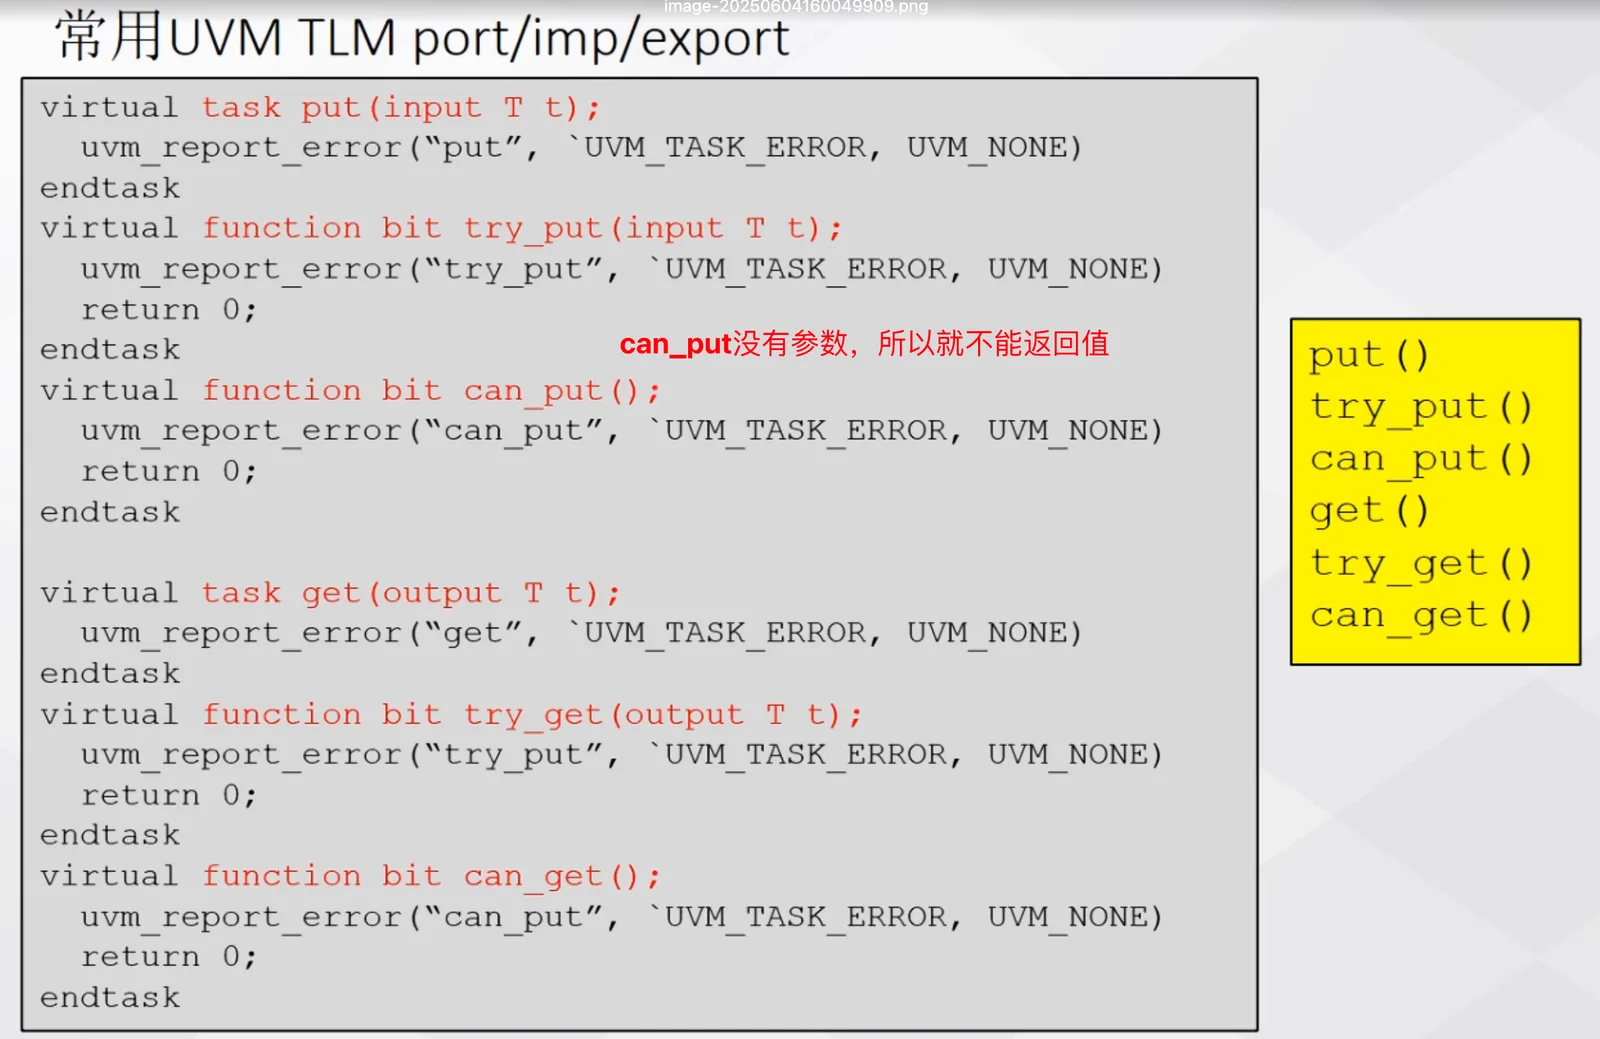
上图是TLM端口6个方法的默认版本:put / get是会阻塞的task,try_put / try_get / can_put / can_get是立即返回bit的function。默认版本只调用uvm_report_error报错,function再返回0,所以真正的行为要在imp所在的组件里实现。图中红字「不能返回值」不准确:can_put / can_get同样返回bit,只是不带transaction参数,返回的是现在能不能put / get。图里的代码是课件的示意,不是逐字的UVM源码。
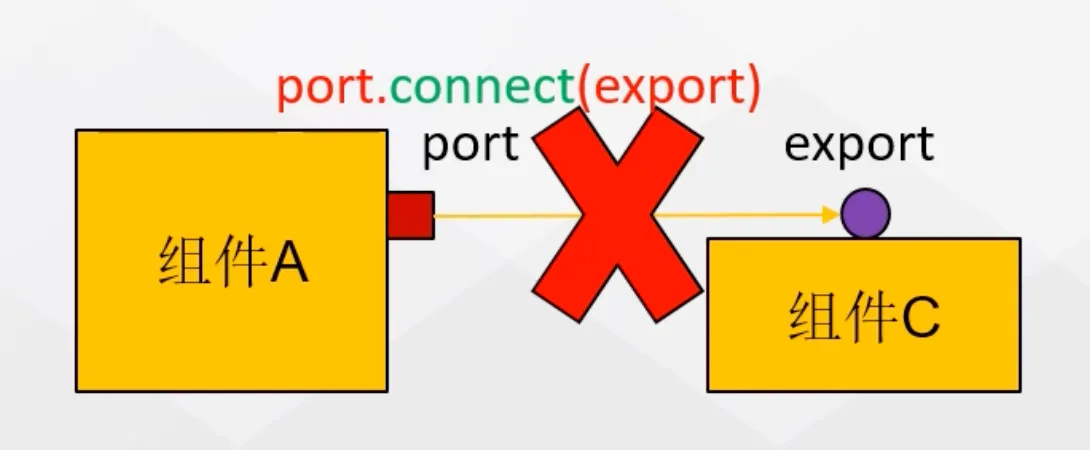
export
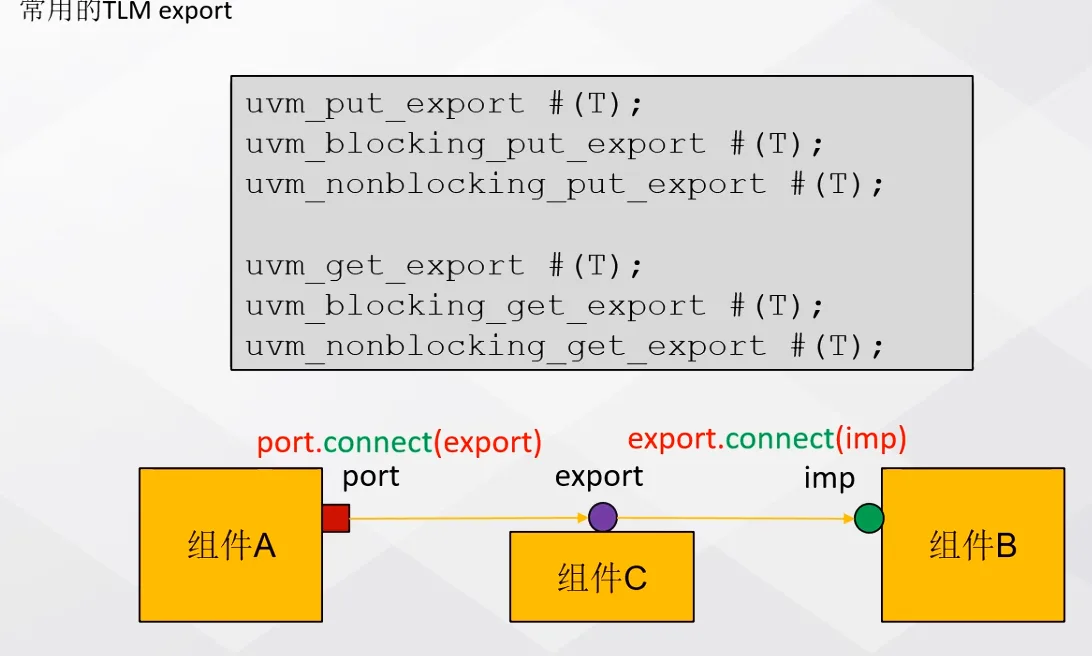
函数名字与import类似,通常export作为中间端口使用
对比:只能用于组件A与组件B之间的通信。
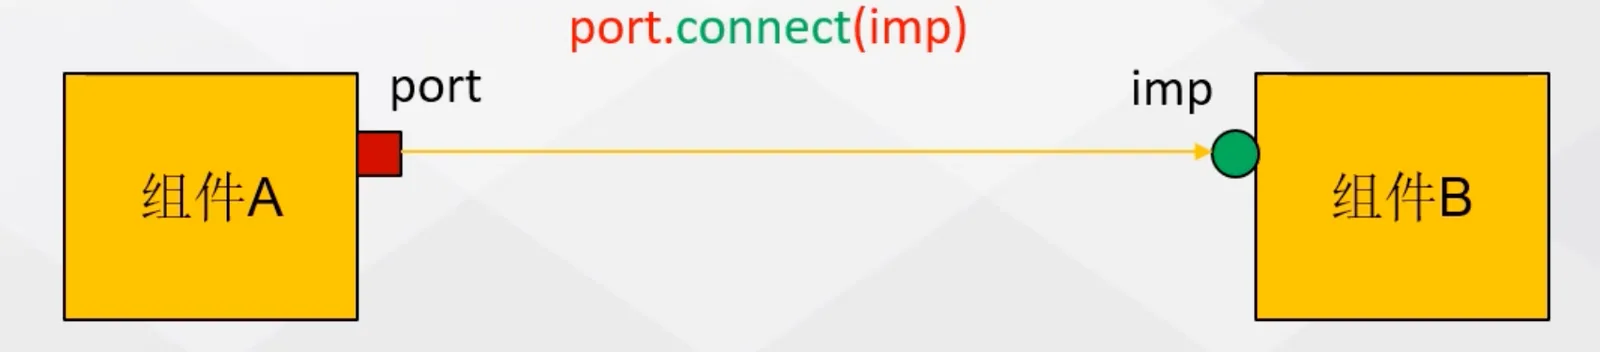
报错原因:方法实现在imp中,而export又没有连接import
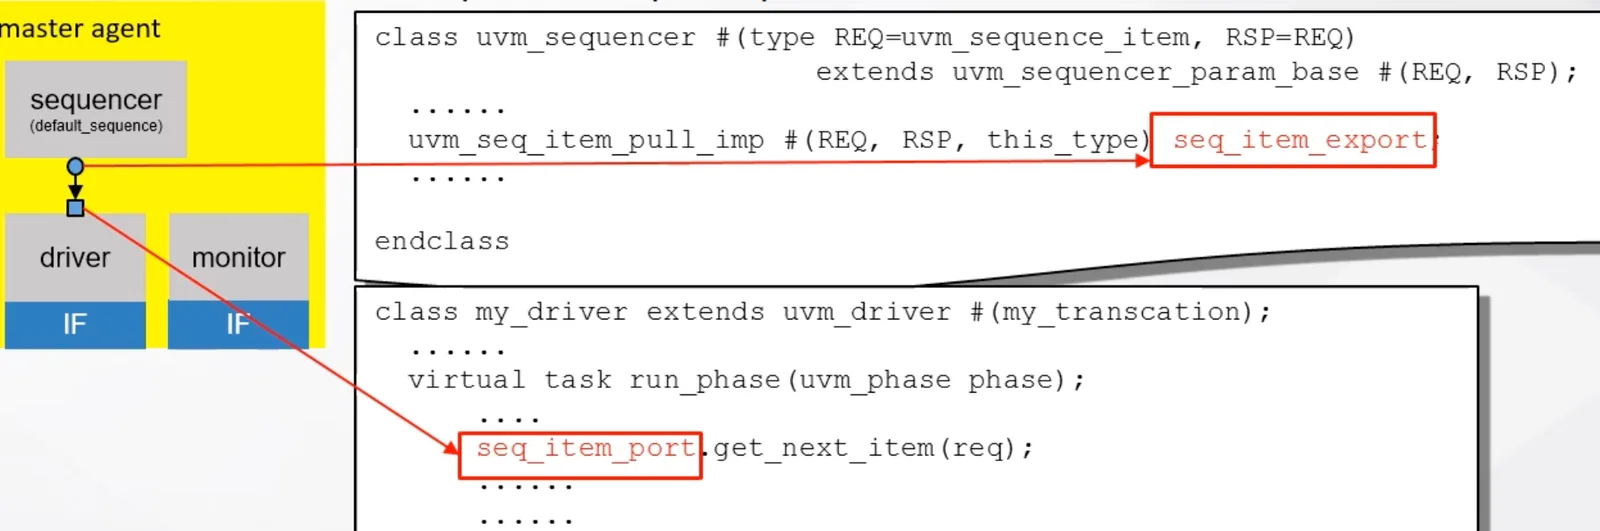
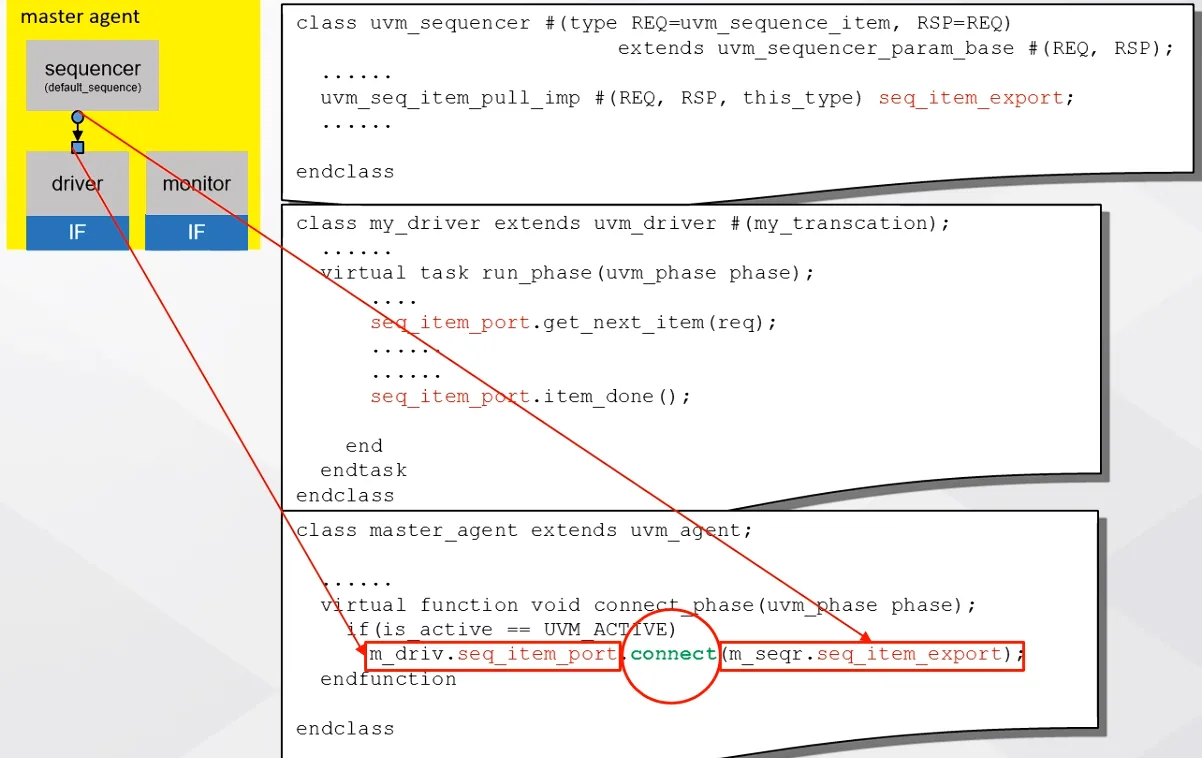
- 注意:其中seq_item_export是sequencer中的默认参数(无需自己定义),在agent中,将driver的seq_item_port连接上了sequencer的seq_item_export(import)
(以下为UVM sequencer源代码)
端对端连接的三种方法
TLM机制端对端连接的三种方法:
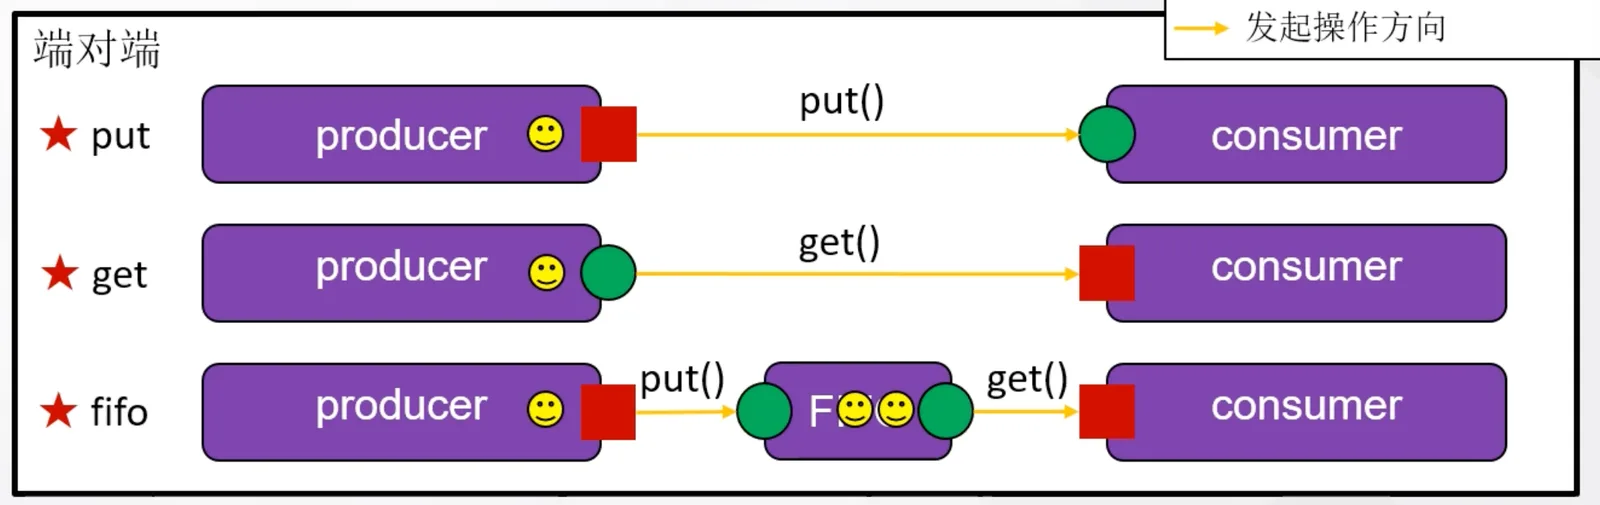
1.put
特点:
- port类型的端口位于产生事务的producer组件中
- import类型端口位于事务发送目标的consumer组件中
- 发送时需要调用port方法,该方法定义在consumer组件中
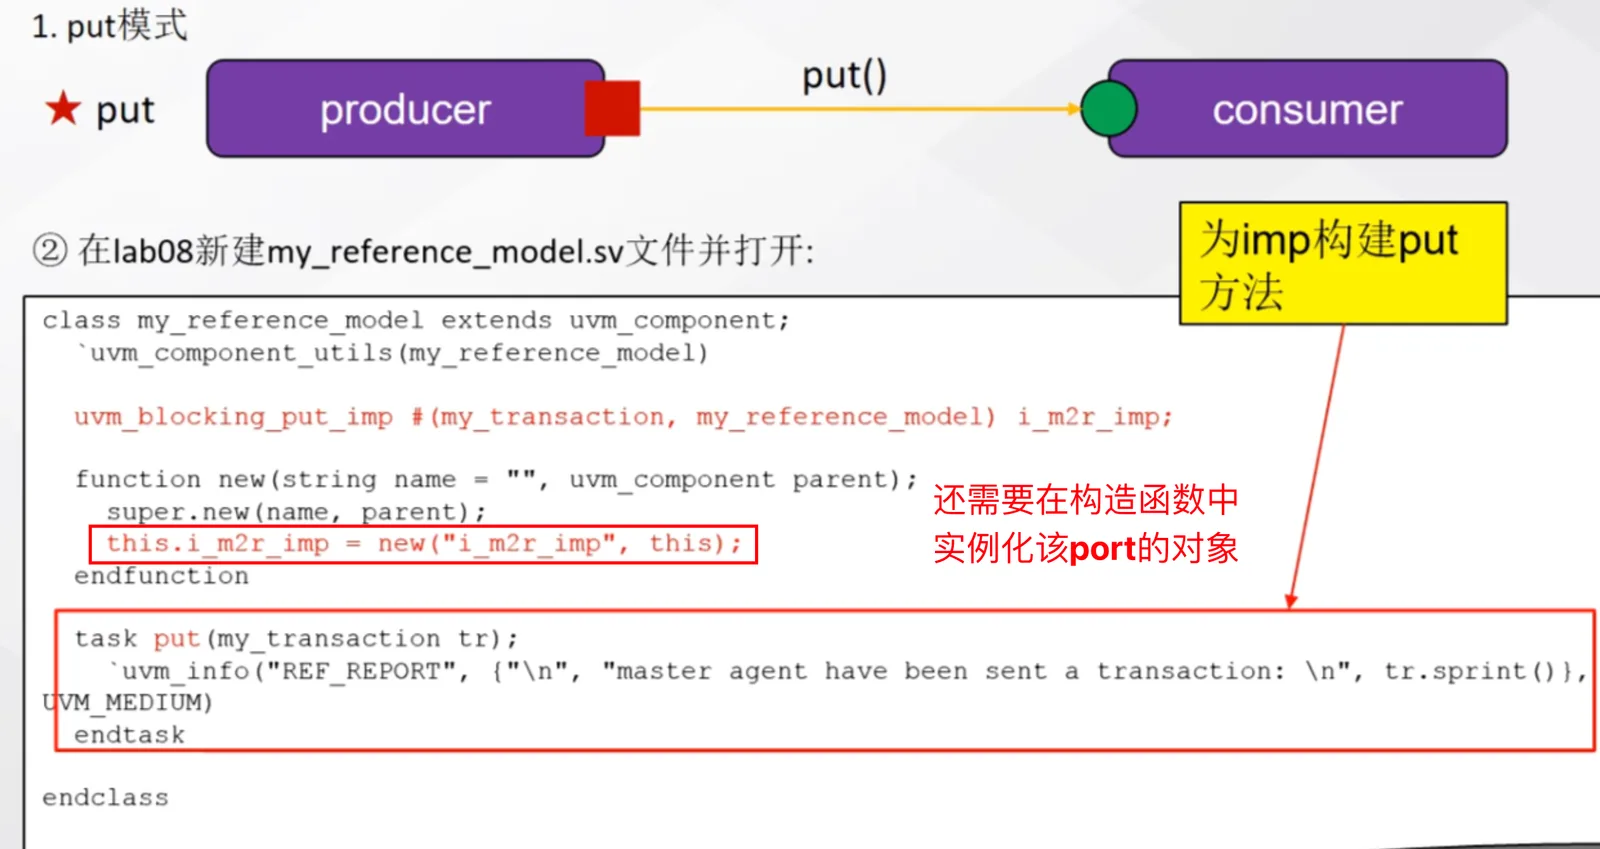
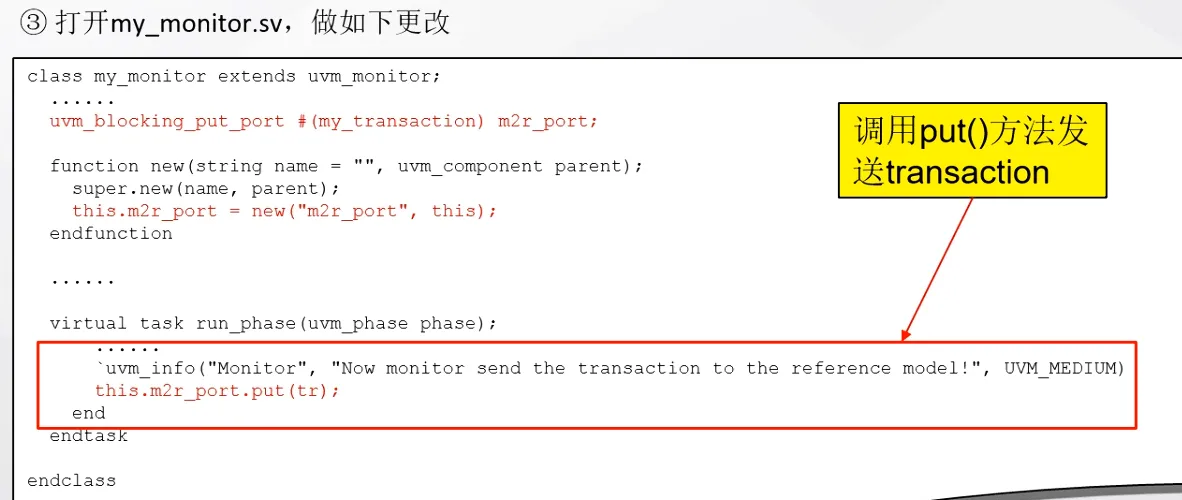
对于agent,monitor和reference model中间还有一层agent,所以中间加上一个export中转
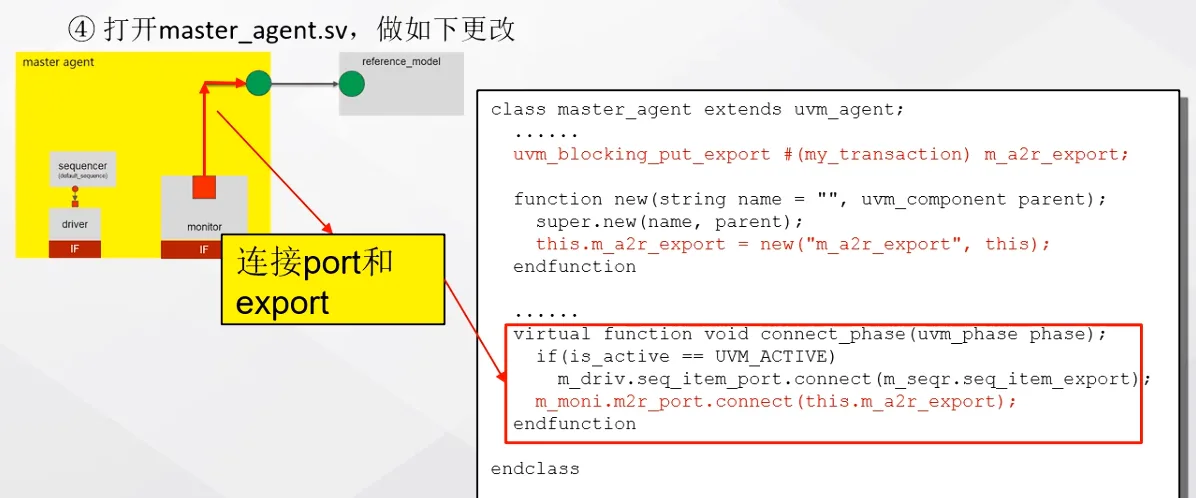
回顾:各种端口的实例化都是在对应组件的构造函数中创建的,而不是使用factory的create创建(组件创建方法)
注意:export的连接实现分别在两处: 1.一个是agent中连接monitor和export 2.一个是在env中连接agent和ref
在env中实例化ref,并连接
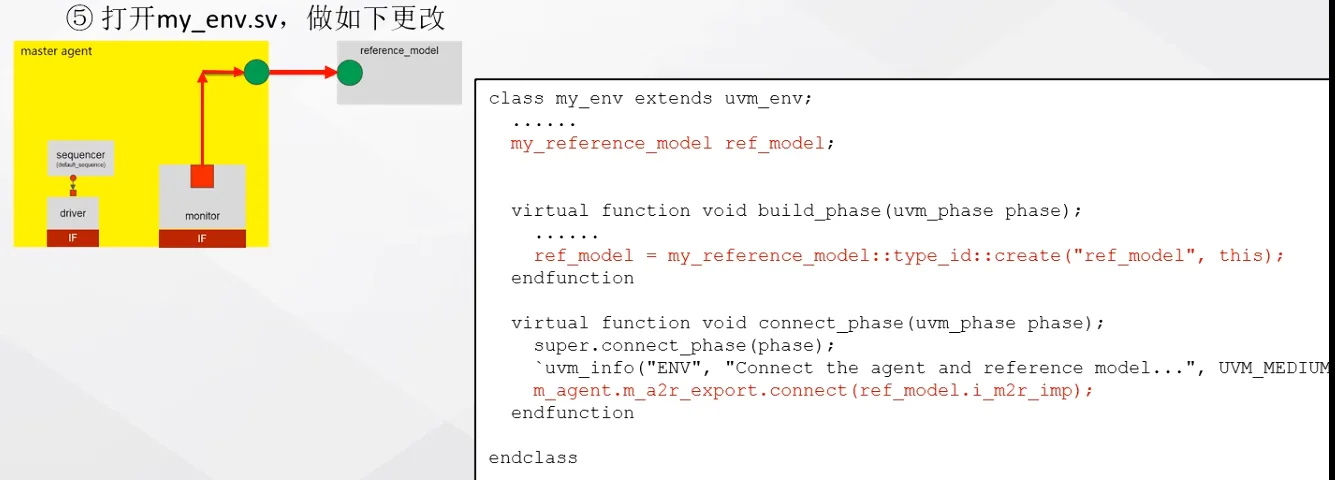
最终平台结构
2.get
其实就是put模式反过来,只不过需要例化FIFO暂存一些在Monitor中收集到的数据
- 因为monitor发送数据需等待对方发起get操作,不能主动发送事物,所以需将已检测到的事物存储到FIFO中避免数据丢失
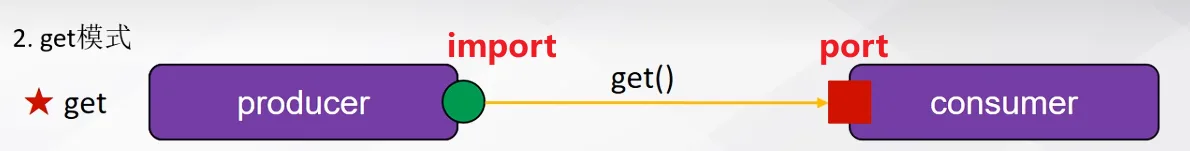
reference model来向monitor实施get的动作 ;
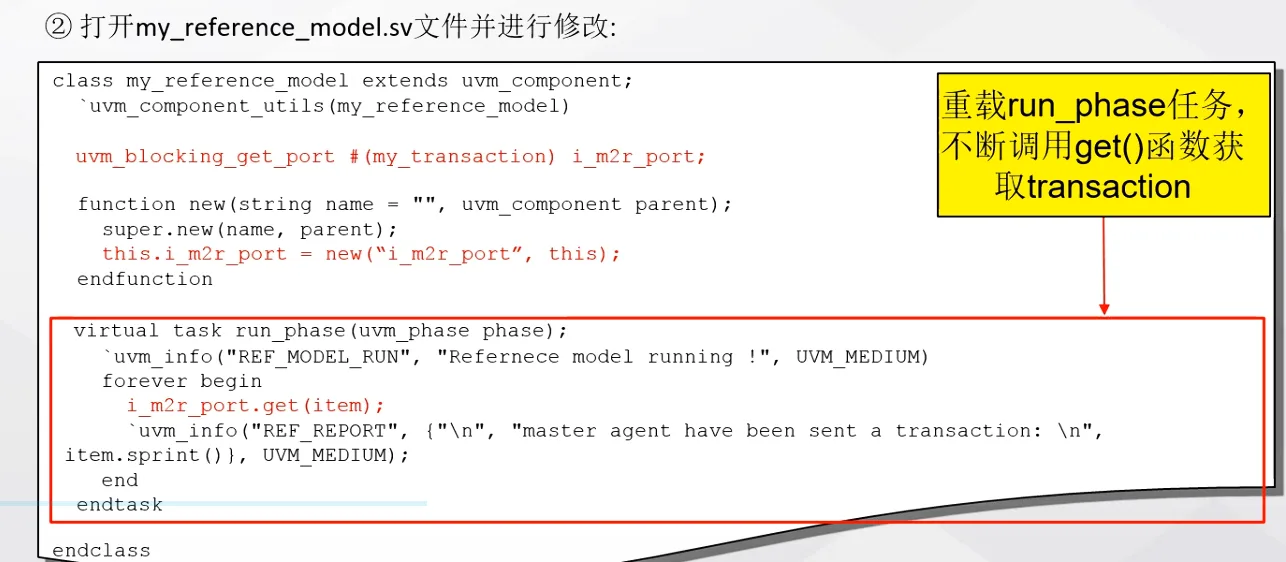
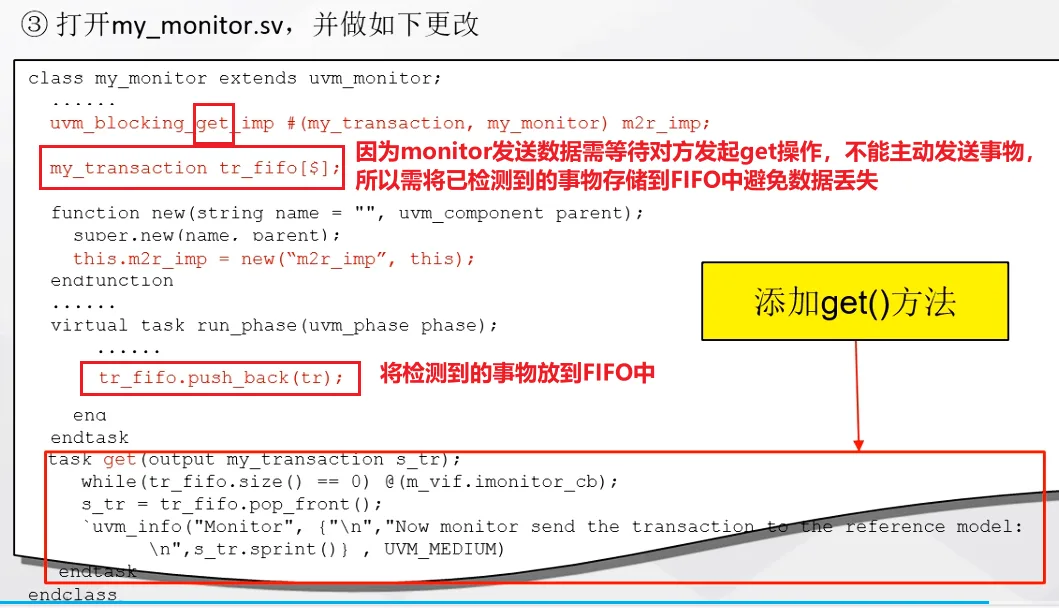
注意:这里get方法agent内部的连接也反过来了,由export去连接monitor
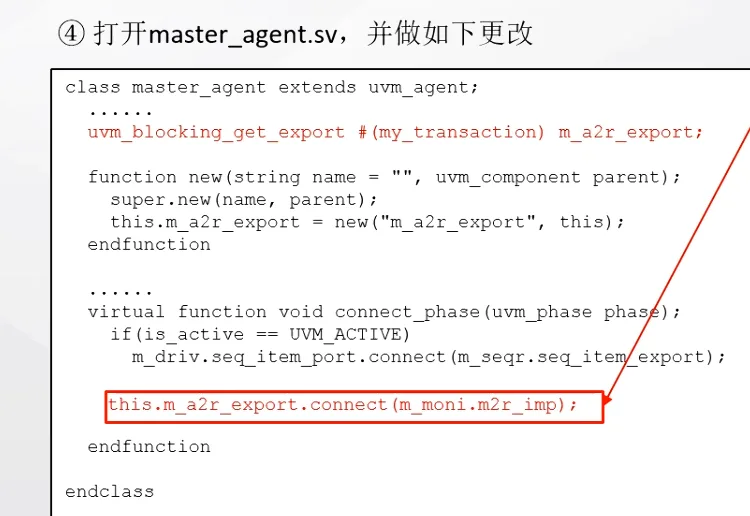
同样的,和put反过来,refe去连接export
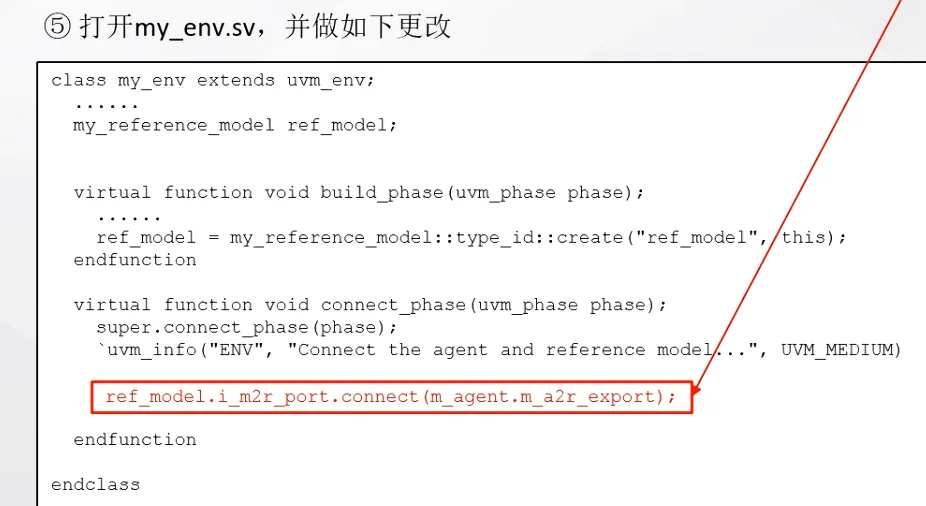
总结规律:连接时尽量将imp、export放在connect后面
3.FIFO模式
TLM里X.connect(Y):
- 调用方(X.connect(…)):X是port或export都行——imp不行(imp是终点,不发起连接)
- 参数/被连接方:export或imp都行——port不行
- export可以在前面,也可以在后面
用于处理producer和consumer处理数据速度差异问题而存在。需结合put和get模式一起使用
producer和consumer都是操作的主动方(port),而FIFO就作为两者的被动方(import)
- producer主动put事务,consumer主动get事务
- fifo中对put import和get import进行连接
这里的FIFO在UVM环境中已定义,直接例化使用即可
使用FIFO模式的好处:UVM已对put和get函数进行了重载,所以无需手动重载
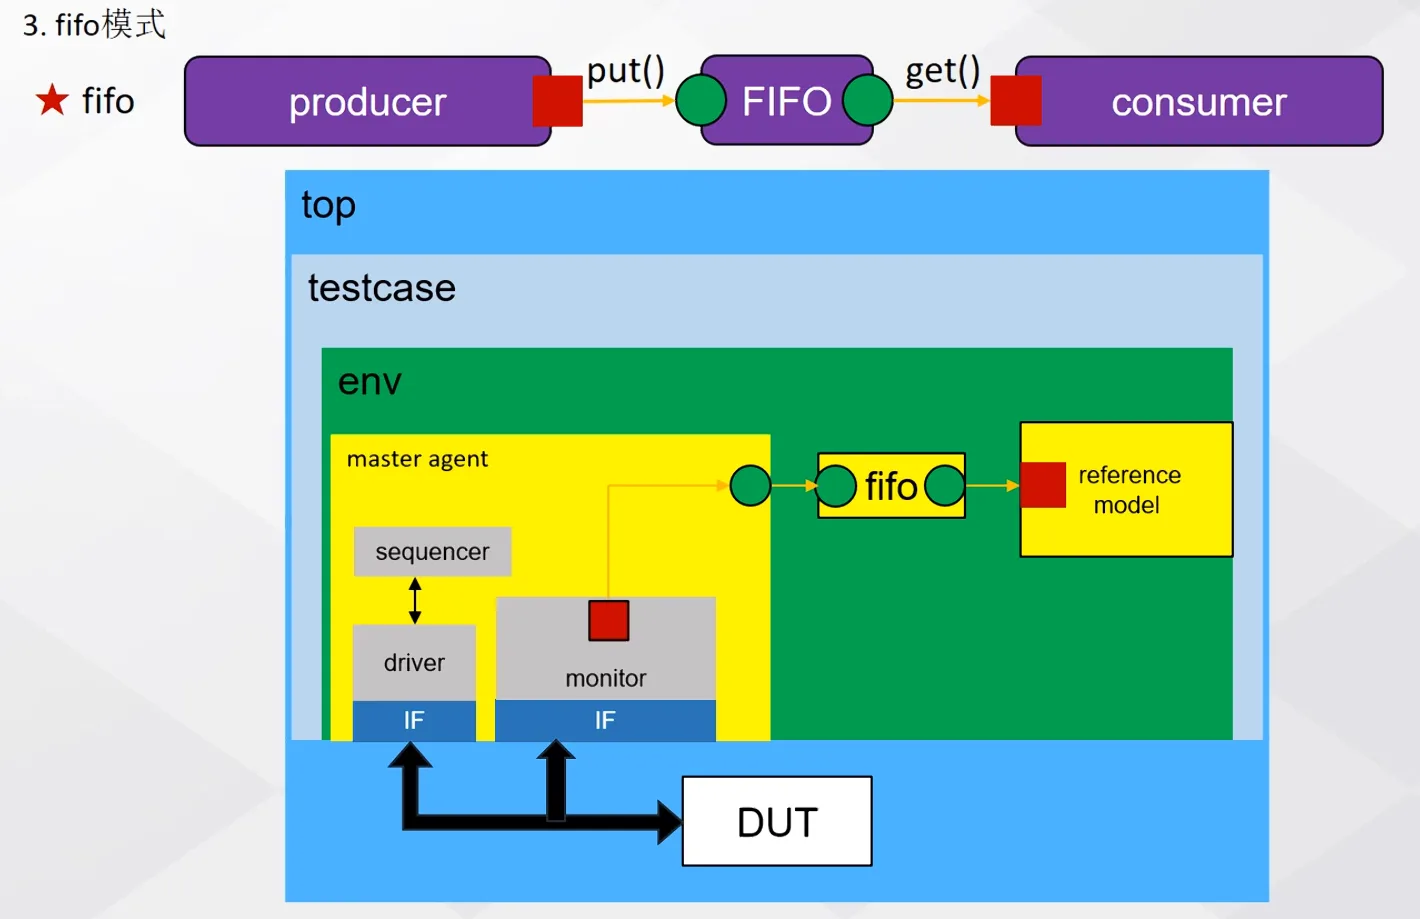
reference model层级连接
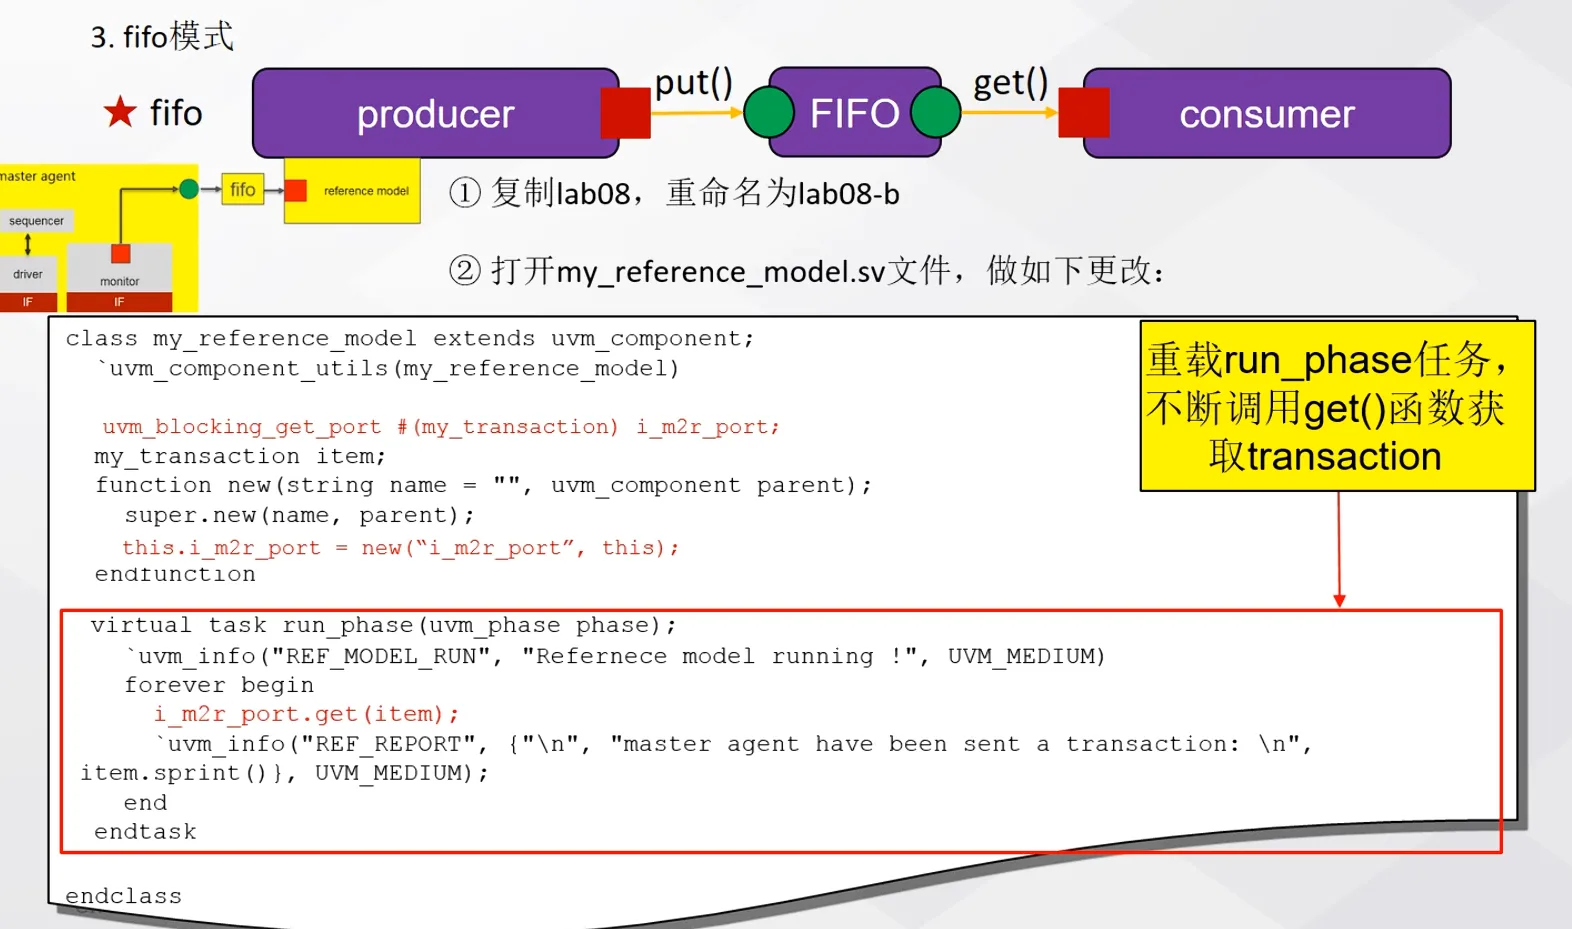
ENV层级连接
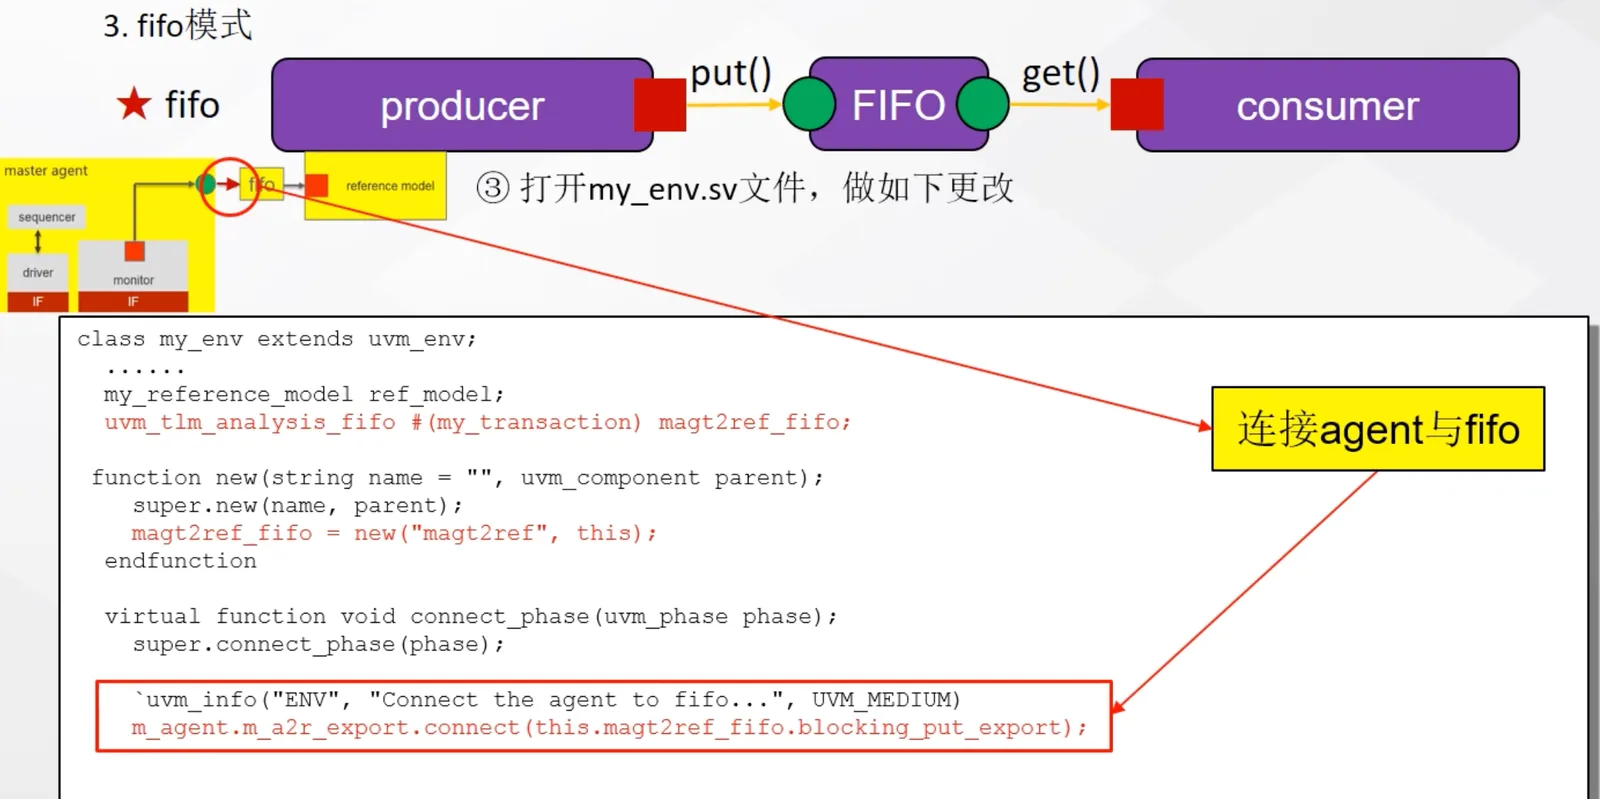
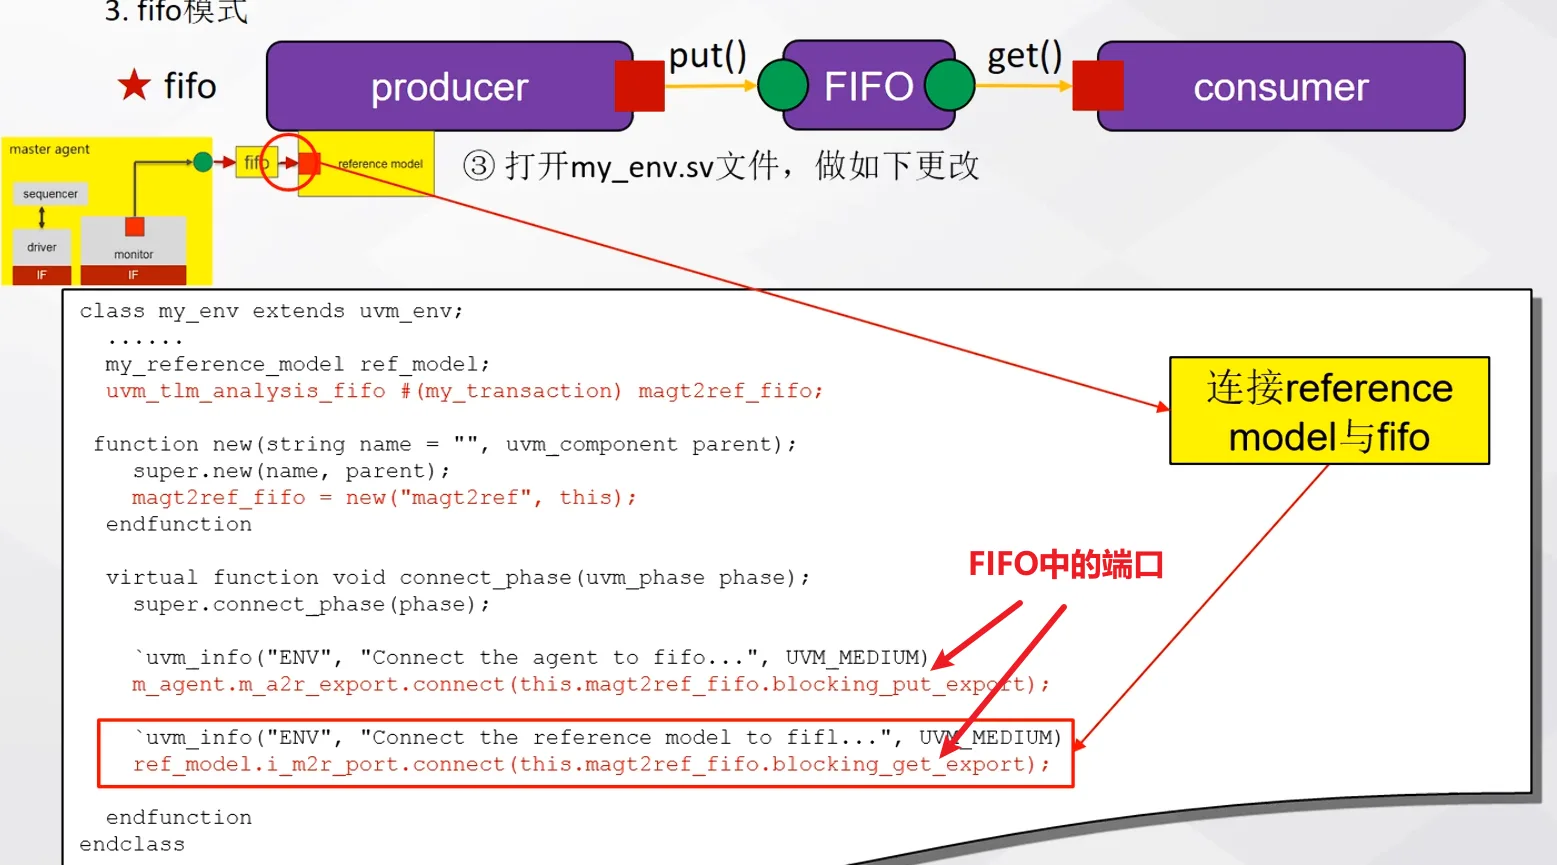
注意:
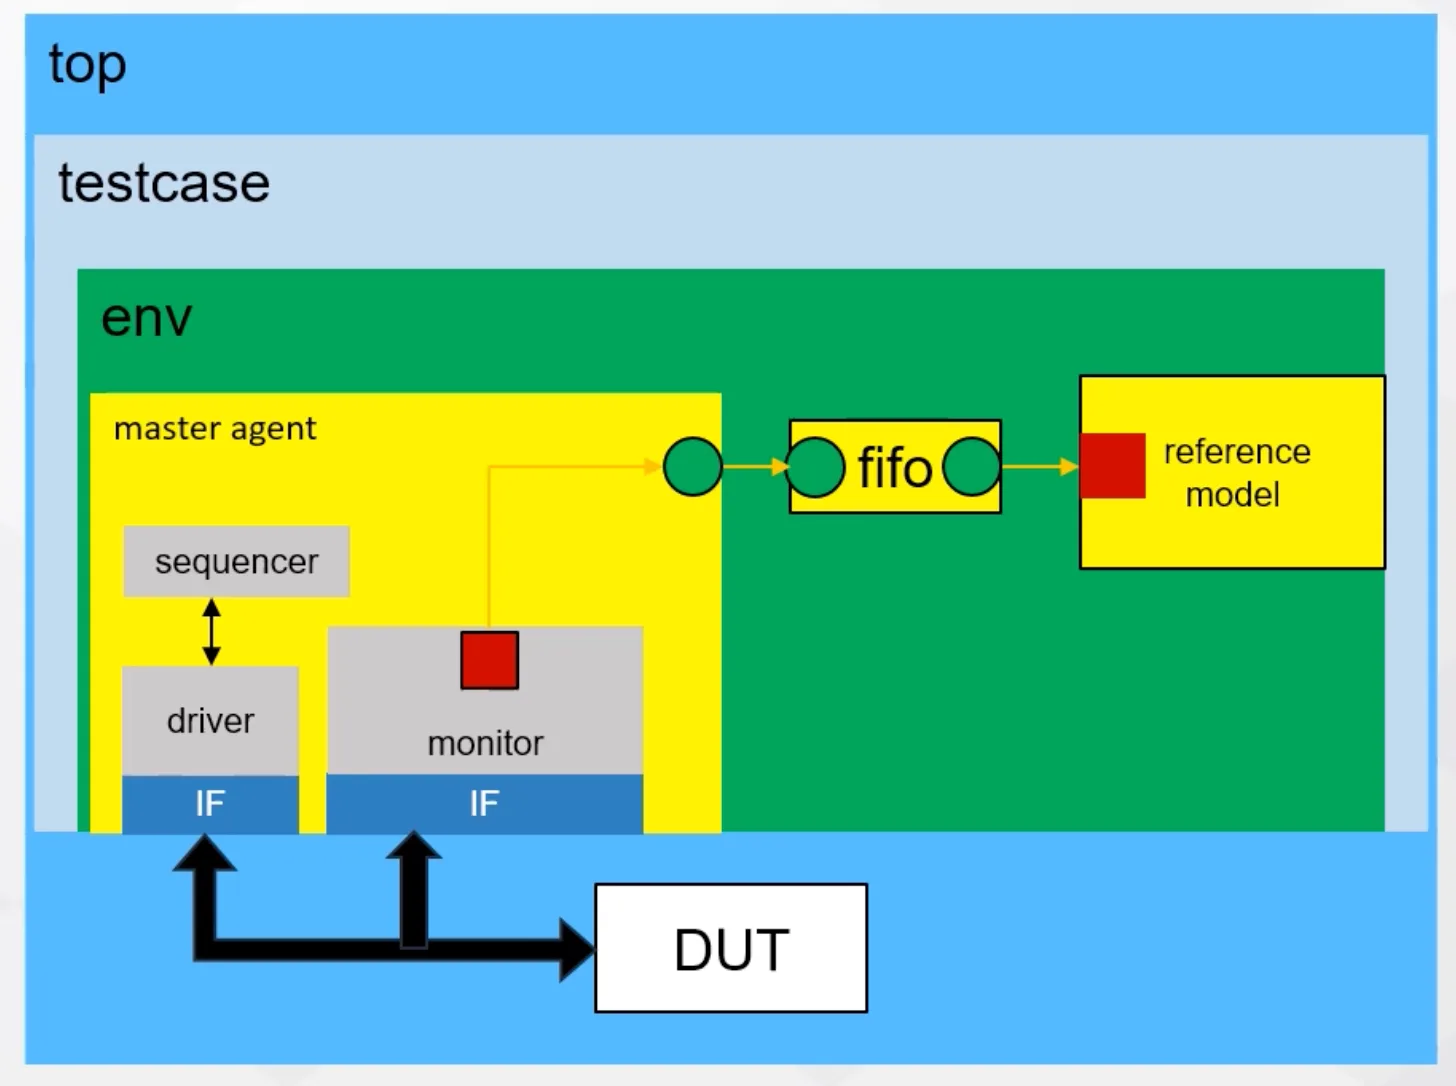
- agt是使用的export,而ref_model是使用的port(就像monitor也使用的port一样)(原因:agt是盒子,作为中转)
- fifo的端口都是使用的export(与agent一样起到中转作用,故使用export)
fifo中除了blocking_put_export,blocking_get_export,还有其他端口,详情可查看UVM源码库
TLM的一对多连接
真正的”一对多”广播靠uvm_analysis_port(一个port能connect多个uvm_analysis_imp,write()时循环发给每一个),下面②③两节代码里没有用到——用的是uvm_tlm_analysis_fifo的普通blocking_put_export/blocking_get_export,跟前面”3.FIFO模式”是同一套点对点机制,每条连接都是1个producer对1个consumer。uvm_tlm_analysis_fifo本身虽然内部带一个analysis_export(真正能接广播的口),但下面的接法从没碰过它。
ref_model/scoreboard在UVM里习惯上统称”analysis component”,这是术语上的叫法,不代表接线方式就是广播——两者不是一回事。
两种Analysis Component
-
reference model:模拟dut行为,根据输入计算出输出,数据来源:monitor
-
scoreboard:将dut的输出与ref对比,数据来源:1.总线上传递至monitor的dut输出; 2.参考模型的期望值
-
一般情况下会在scb中嵌入functional coverage,用于收集功能覆盖率
为平台添加Analysis Component(scb)
步骤: 1.构建salve agent中的monitor; - 添加put port类型的端口 2.构建slave agent; - put export端口,将其与monitor连接 3.构建scoreboard;
- 创建两个port类型端口(get port),一个来自ref,一个来自slave agent 4.在reference model添加一个新的port端口; 5.创建两个用于通信的fifo; 6.将组件与fifo相连接
① slave agent中的monitor(out_monitor)——加put port
class out_monitor extends uvm_monitor;
    uvm_blocking_put_port #(my_transaction) m2s_port; // producer持有port,主动调put()

    function new(string name="", uvm_component parent);
        super.new(name, parent);
        this.m2s_port = new("m2s_port", this); // 创建port句柄对象
    endfunction

    virtual task run_phase(uvm_phase phase);
        // ... 采集DUT输出信号,拼成tr ...
        this.m2s_port.put(tr); // 采集完直接push给下家
    endtask
endclass
② slave agent——put export,接monitor的port
class slave_agent extends uvm_agent;
    out_monitor m_moni;
    uvm_blocking_put_export #(my_transaction) s_a2s_export; // agent边界导出口,透传monitor的port

    function new(string name="", uvm_component parent);
        super.new(name, parent);
        this.s_a2s_export = new("s_a2s_export", this); // 创建export句柄对象
    endfunction

    virtual function void connect_phase(uvm_phase phase);
        m_moni.m2s_port.connect(this.s_a2s_export); // monitor的port连到agent的export
    endfunction
endclass
③ scoreboard——两个get port,分别拉期望值和实际值
class my_scoreboard extends uvm_scoreboard;
    uvm_blocking_get_port #(my_transaction) r2s_port;   // 主动去ref_model那拉(expected)
    uvm_blocking_get_port #(my_transaction) s_a2s_port; // 主动去slave agent那拉(actual)

    function new(string name = "", uvm_component parent);
        super.new(name, parent);
        r2s_port = new("r2s_port", this);     // 创建port句柄对象
        s_a2s_port = new("s_a2s_port", this); // 创建port句柄对象
    endfunction

    virtual task run_phase(uvm_phase phase);
        my_transaction expected_tr, dut_output_tr;
        forever begin
            fork
                r2s_port.get(expected_tr);     // 拉ref_model算出的期望值
                s_a2s_port.get(dut_output_tr); // 拉DUT的实际输出
            join
            if(expected_tr.compare(dut_output_tr)) begin
                // ... 比对结果打印 ...
            end
        end
    endtask
endclass
④ reference model——新增一个port,往scoreboard推期望值
class my_reference_model extends uvm_component;
    uvm_blocking_get_port #(my_transaction) m2r_get_port; // 原有:从monitor那拉
    uvm_blocking_put_port #(my_transaction) r2s_port;      // 新增:往scoreboard推期望值

    function new(string name="", uvm_component parent);
        super.new(name,parent);
        this.r2s_port = new("r2s_port", this); // 创建port句柄对象
    endfunction

    virtual task run_phase(uvm_phase phase);
        my_transaction tr;
        forever begin
            m2r_get_port.get(tr);
            this.r2s_port.put(tr); // 新增这行:算完直接推给scoreboard
        end
    endtask
endclass
⑤ env——创建两个fifo
class my_env extends uvm_env;
    uvm_tlm_analysis_fifo #(my_transaction) r2s_fifo;   // ref_model→scoreboard之间的缓冲
    uvm_tlm_analysis_fifo #(my_transaction) s_a2s_fifo; // slave agent→scoreboard之间的缓冲

    function new(string name="", uvm_component parent);
        super.new(name, parent);
        r2s_fifo = new("r2s_fifo", this);     // 创建fifo句柄对象
        s_a2s_fifo = new("s_a2s_fifo", this); // 创建fifo句柄对象
    endfunction
endclass
⑥ env——connect_phase里把组件和fifo连起来
virtual function void connect_phase(uvm_phase phase);
    // producer接fifo的put端,consumer接fifo的get端,两边互不知道对方
    ref_model.r2s_port.connect(this.r2s_fifo.blocking_put_export);
    sb.r2s_port.connect(this.r2s_fifo.blocking_get_export);

    s_agent.s_a2s_export.connect(this.s_a2s_fifo.blocking_put_export);
    sb.s_a2s_port.connect(this.s_a2s_fifo.blocking_get_export);
endfunction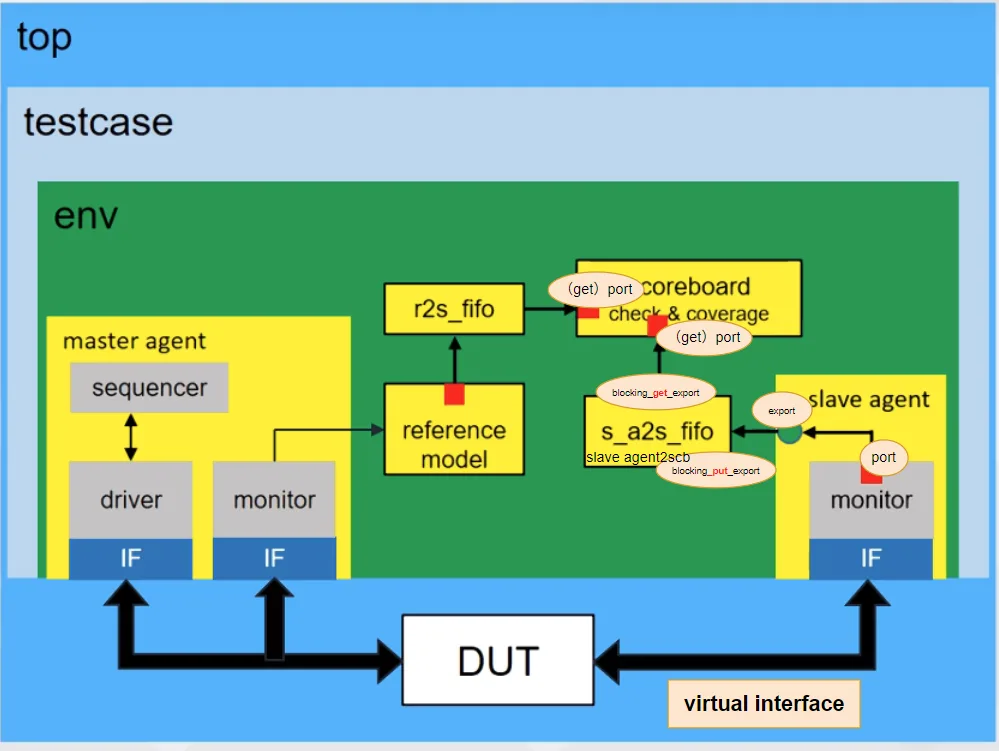
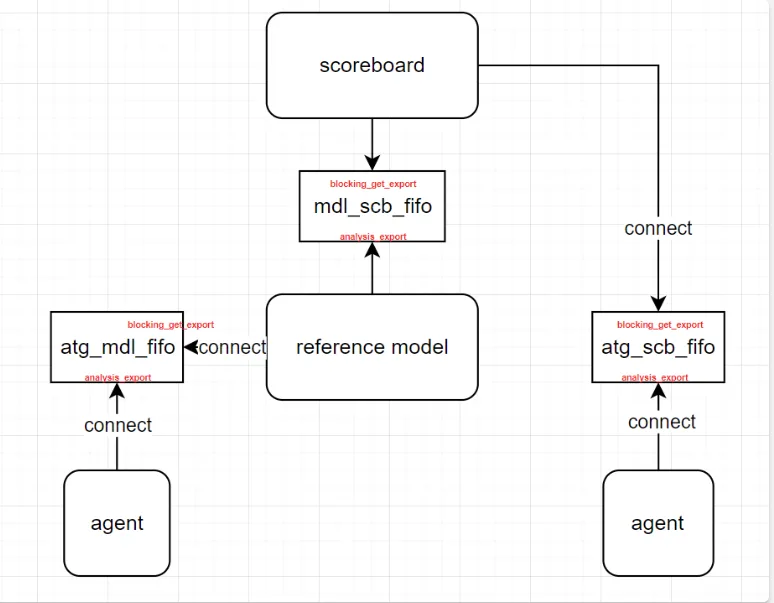
注意:FIFO作为被动接收方,其端口永远带有export字样(相当于imp)
当端口数量众多时,使用FIFO优由于IMP,如ref_mdl需要连接多个scb端口的情况(书P128页)
TLM总结:
- 学会创建scb
- 学会连接平台中各个组件
9.Callback
概念:
Callback是替换某组件中某一段的功能来实现该组件不同的行为
具体:callback 机制的目的是让用户可以灵活地在运行时“插入”不同的功能实现,这些功能会在原组件的执行流程中执行,而不需要修改原组件的源代码(但是需要为原组件添加 callback 接口)。通过 callback,可以替换或扩展组件的行为
如何根据不同需求改变driver的行为?
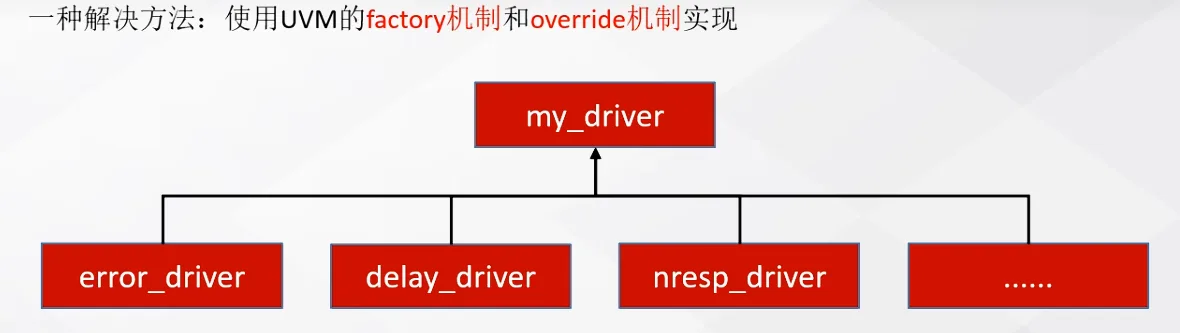
实现driver的不同功能,如错误注入driver,延迟driver等等
在testcase的build_phase中对要替换的对象进行override(第二个参数是targe_class)
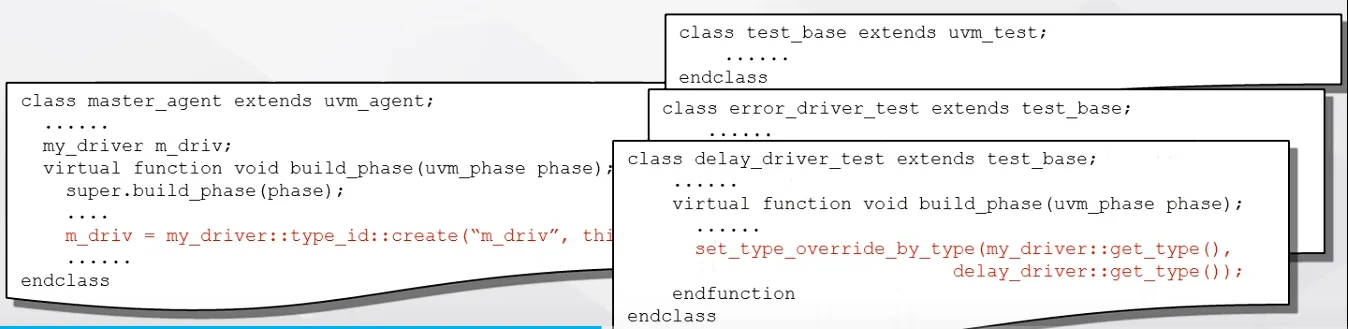
但有时候为了验证需要,可能出现多个层次的拓展。可能出现(紫色)混乱的情况
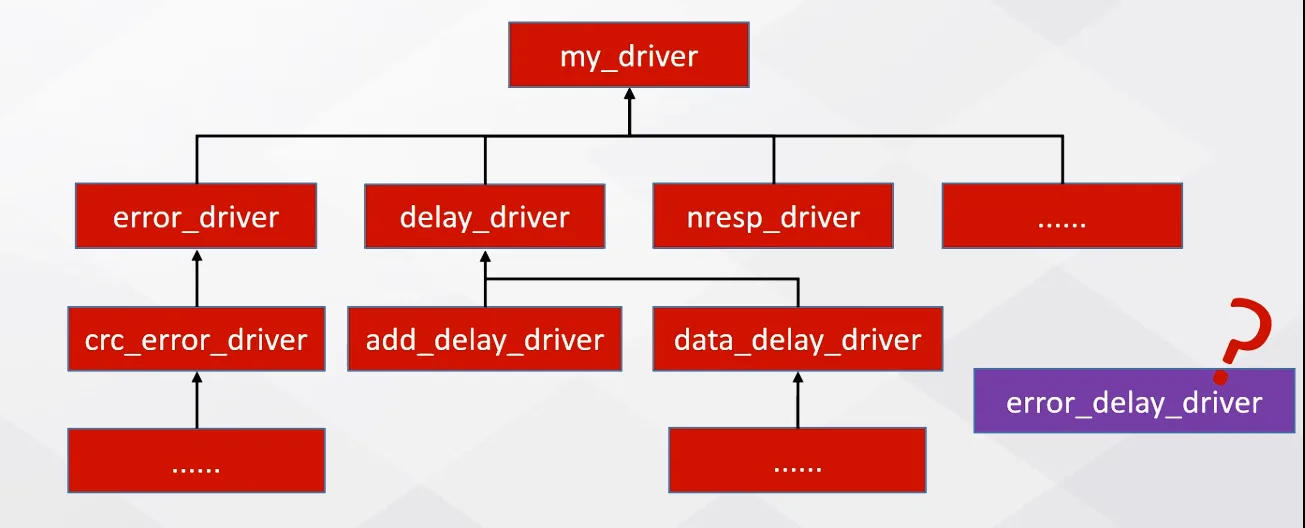
不需要替换driver的对象,即可实现driver的不同行为,比override方便很多
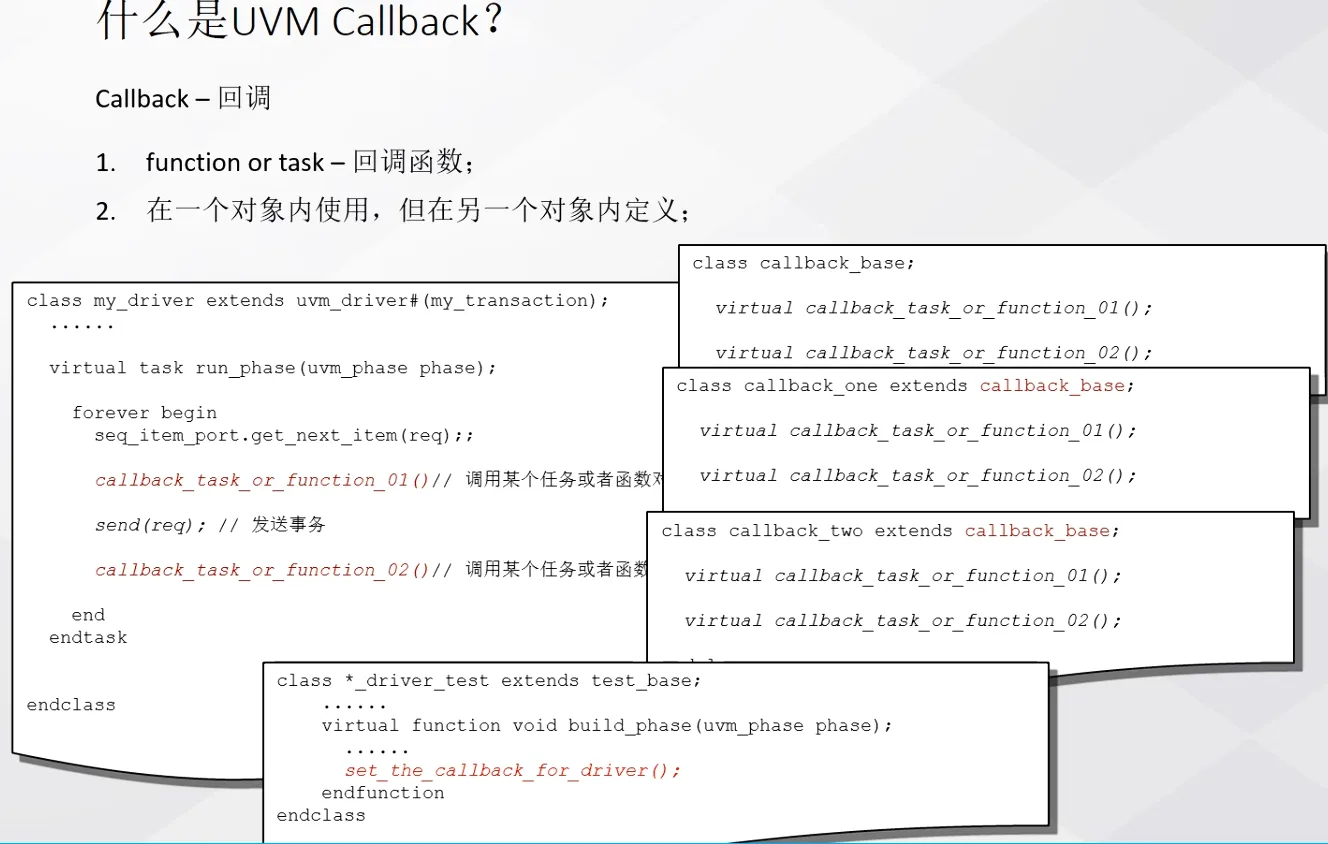
使用
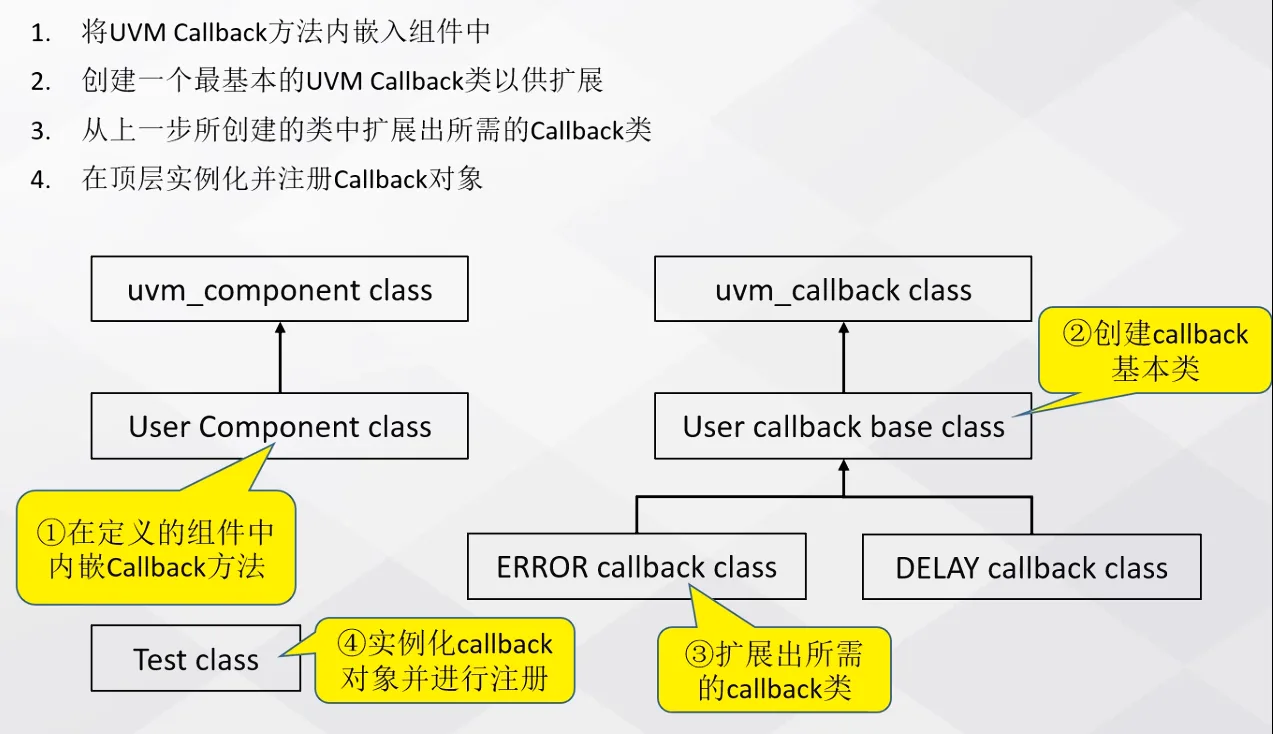
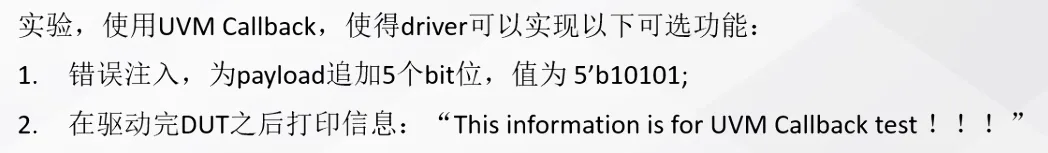
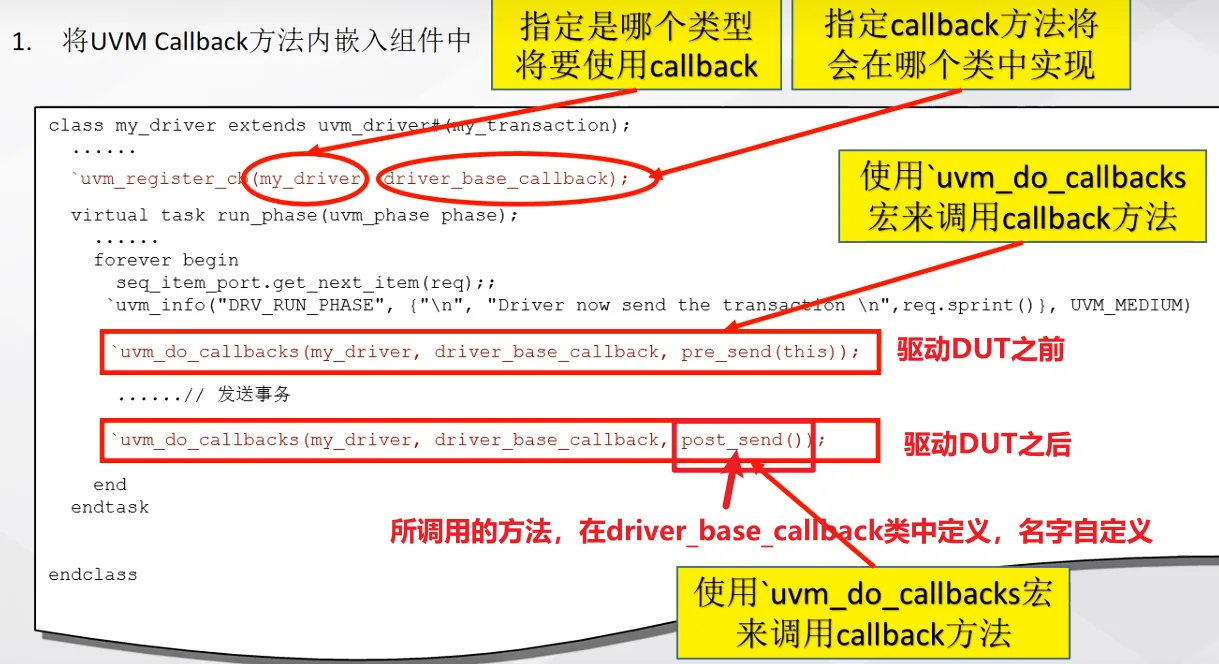
如上图,接口或者说是方法就接入了driver中
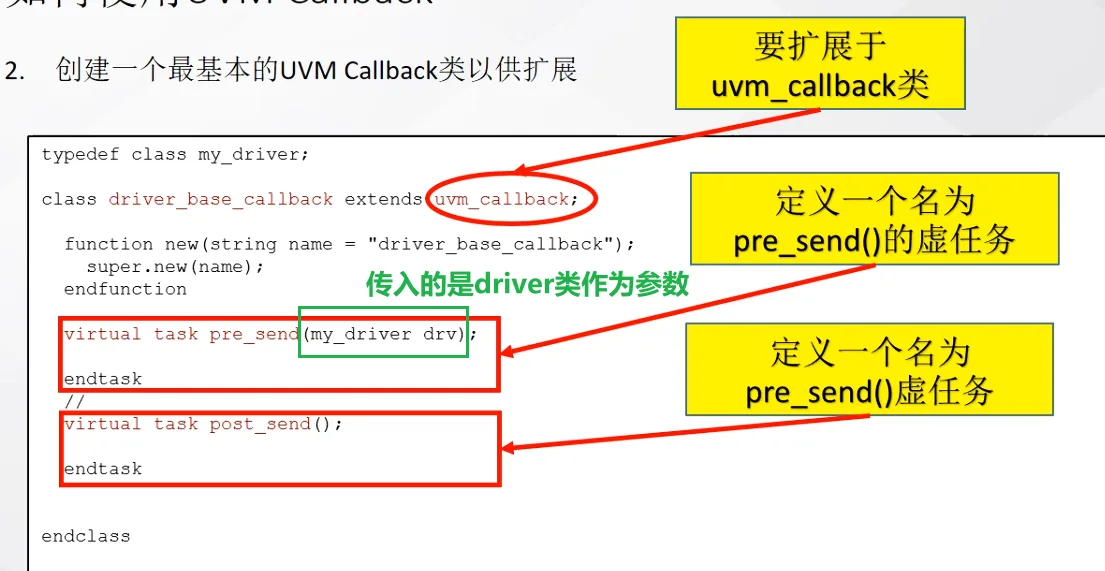
注意:typedef class my_driver; // 定义 my_driver 为 class my_driver 的类型别名,方便下面使用这个类以免报错
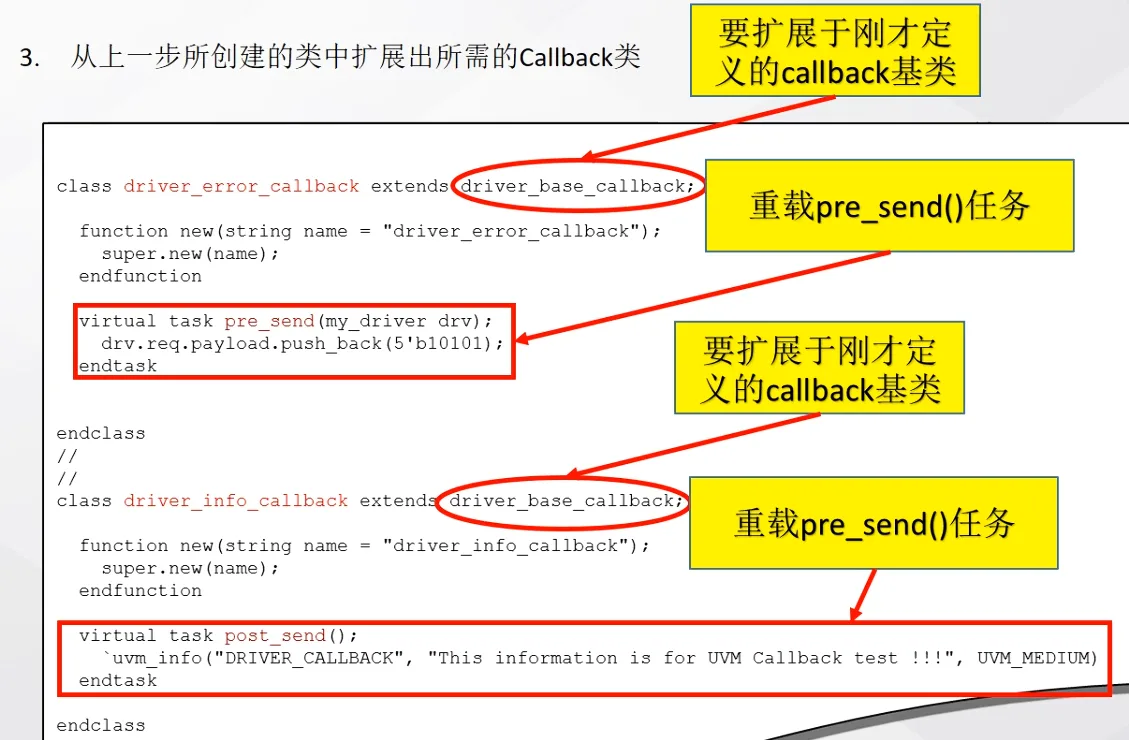
图中第二个黄框应为「重载post_send()任务」:它指向的是post_send()。
uvm_callbacks #(组件类, callback基类)::add(为哪个组件指定callback对象,指定的callback对象);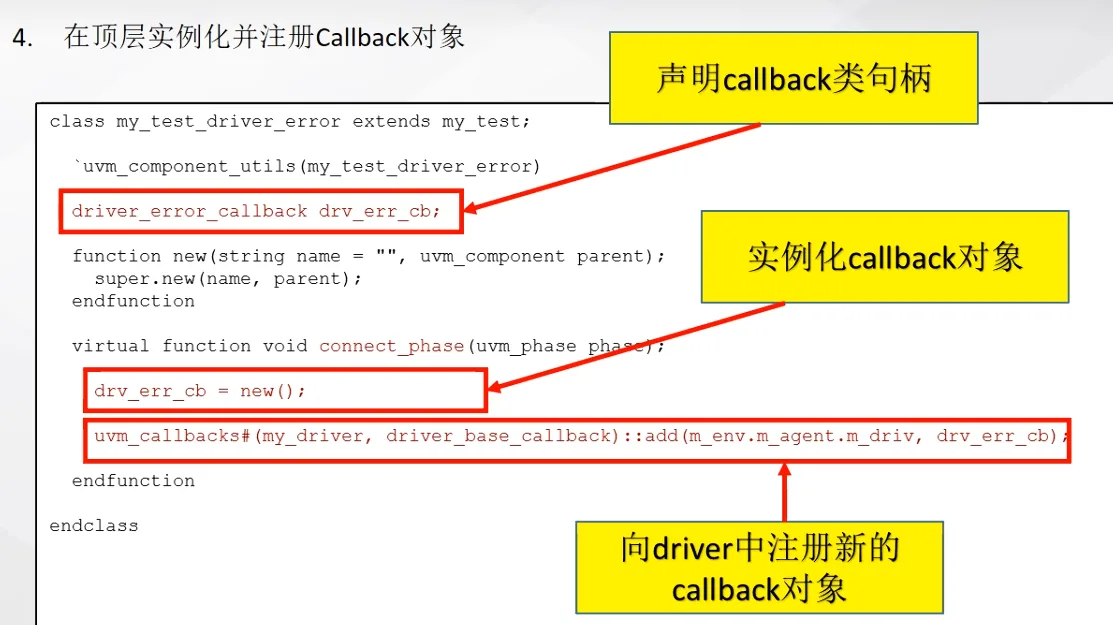
或是例化另一个功能的driver
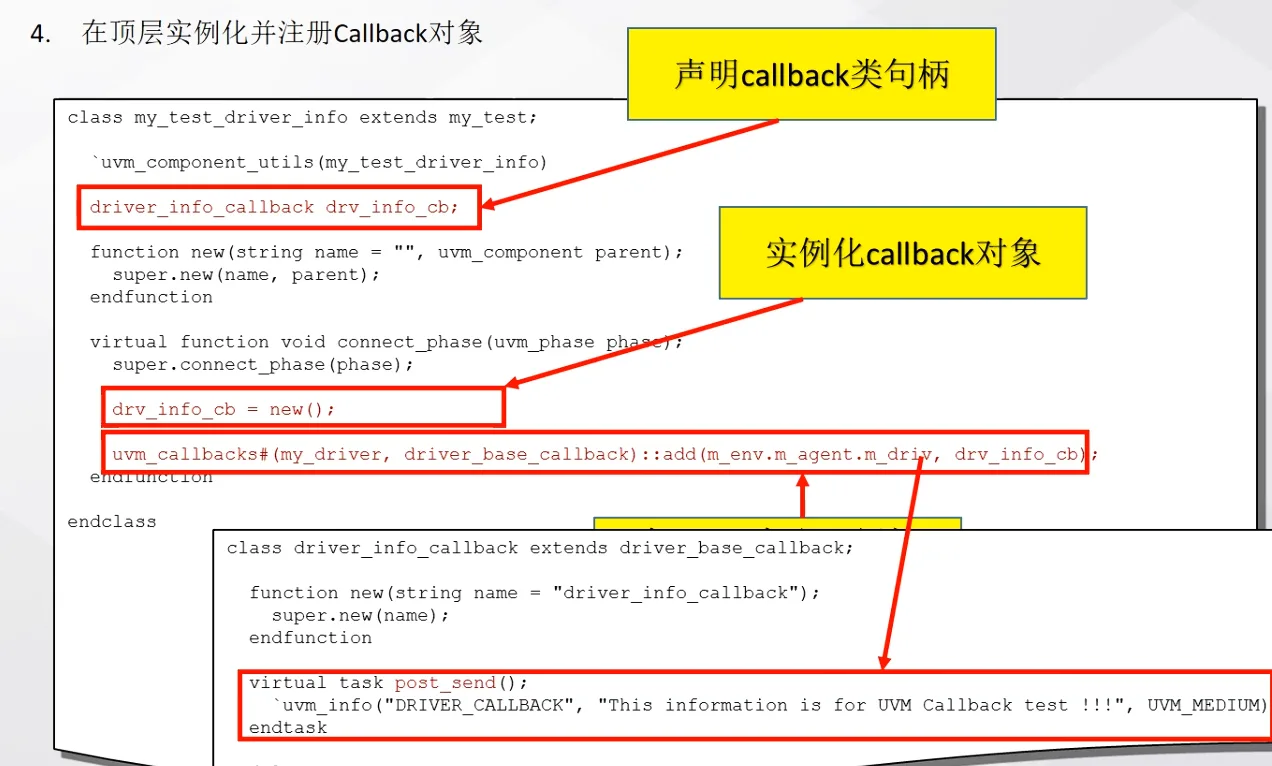
1.在定义的组件中内嵌callback方法
class my_driver extends uvm_driver#(my_transaction)

     ...
    `uvm_register_cb(my_driver, driver_base_callback); //callback接口

    virtual task run_phase(uvm_phase phase);
    ...
    forever begin
        seq_item_port.get_next_item(req);

        `uvm_do_callbacks(my_driver, driver_base_callback, pre_sent(this));//callback接口
        ...
        `uvm_do_callbacks(my_driver, driver_base_callback, post_sent());//callback接口

endclass // uvm_driver #(my_transactio) extends superClass
--------------------------------------------------------
2.创建callback基本类

typedef class my_driver;
class driver_base_callback extends uvm_callback; //###

    // Callback methods
    virtual task pre_sent(my_driver drv);
        // Default implementation does nothing
    endtask


    virtual task post_sent();
        // Default implementation does nothing
    endtask
endclass
--------------------------------------------------------
3.拓展出所需的callback类
class driver_error_callback extends driver_base_callback; //###
   ...
    virtual task pre_sent(my_driver drv);
        `uvm_info("driver_error_callback", "Pre-sent callback executed", UVM_MEDIUM)
        drv.req.payload.push_back(5'b10101);
    endtask
endclass

class driver_info_callback extends driver_base_callback; //###
   virtual task post_sent();
        `uvm_info("driver_error_callback", "Post-sent callback executed", UVM_MEDIUM)
        // Add additional logic after sending the item
    endtask
endclass

--------------------------------------------------------
4.在顶层实例化callback对象并注册
class my_test_driver_error extends uvm_test;

    driver_error_callback error_cb; //###

    function new(string name = "my_test", uvm_component parent = null);
        super.new(name, parent);
        error_cb = new();
    endfunction

    virtual function void connect_phase(uvm_phase phase);

        error_cb = new();//###

        //### 相当于连接
        uvm_callbacks#(my_driver,driver_base_callback)::add(m_env.m_agt.m_drv, error_cb);
    endfunction
endclass

5.另外功能的driver在testcase中如下:
class my_test_driver_error extends uvm_test;
     driver_info_callback info_cb;
    ...
对于以上例子,若下次想要拓展driver功能时,需创建callback基本类然后拓展,并在driver和testcase中创建接口即可
10.Advanced sequence
此章节开始为UVM高级应用
一.概念
sequence library其本质是一个sequence,相对于普通的sequence,sequence library有以下功能:
- 其他seq可以向seq lib注册
- 可根据配置产生并执行 已经在其内部注册过的sequence
- 具有多种内嵌选择执行哪一个seq
- 也支持用户自定义的sequence选择算法
- 注册方式多样化
举例:若在仿真中想产生随机以下三种之一的事务对象。
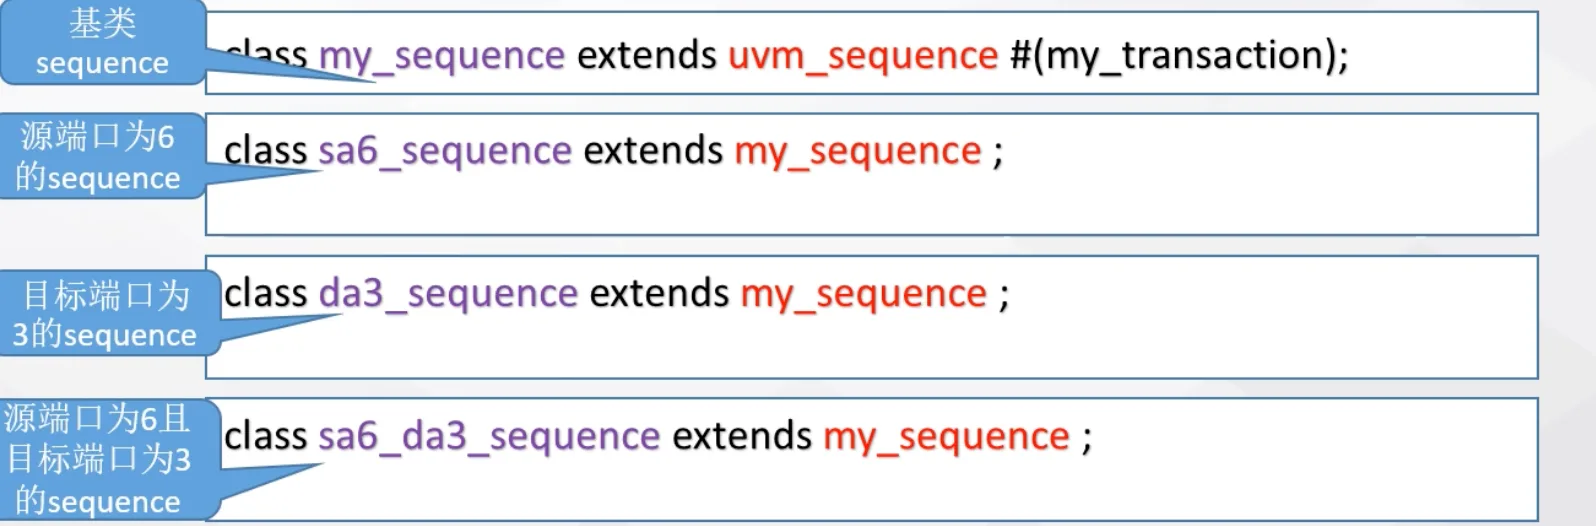
实现方法:调用uvm_add_to_seq_lib宏
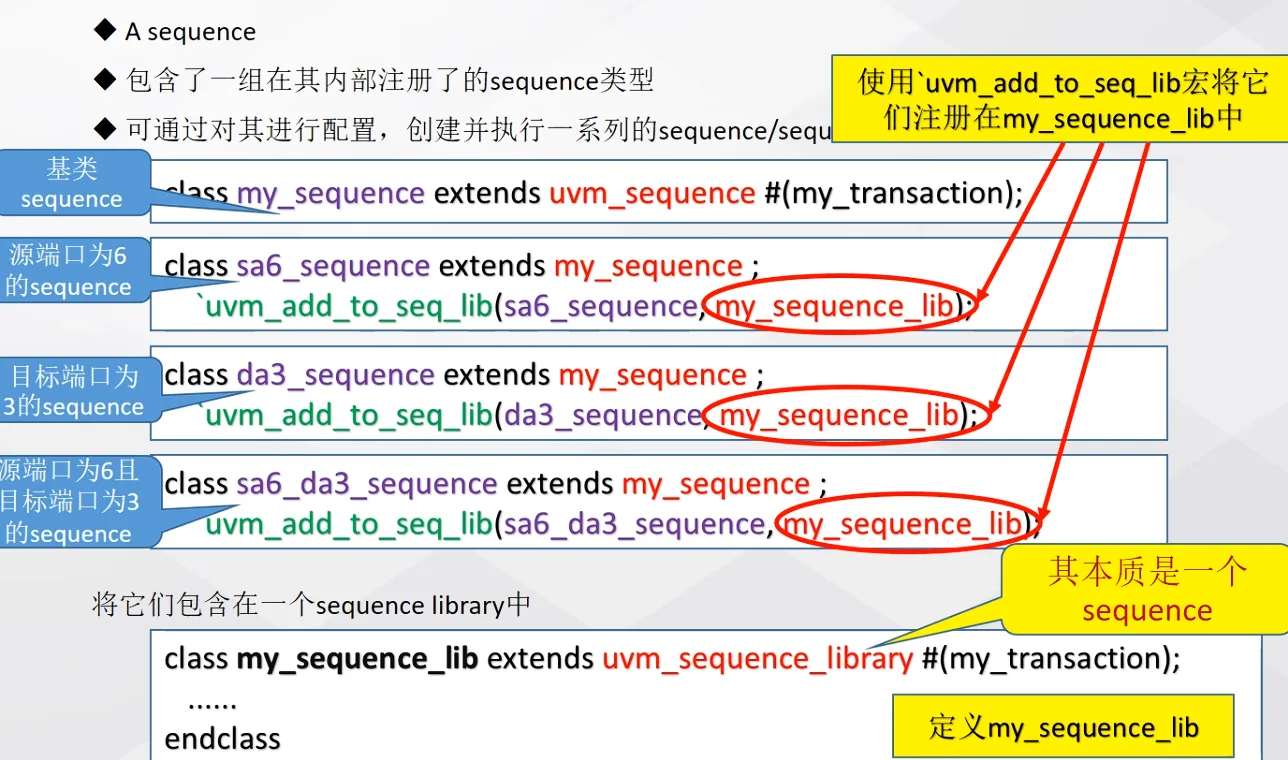
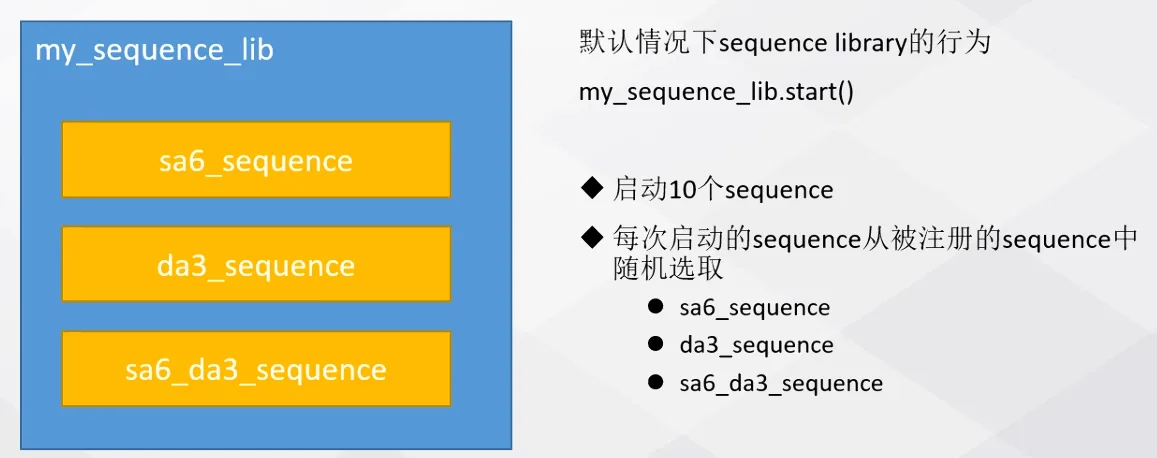 注意这里是启动10个sequence,而不是产生10个事务对象
二.永久注册seq
三.seq library相关变量
四.seq library配置对象
五.临时添加seq到library
六.使用seq library对象
sequence library相关变量
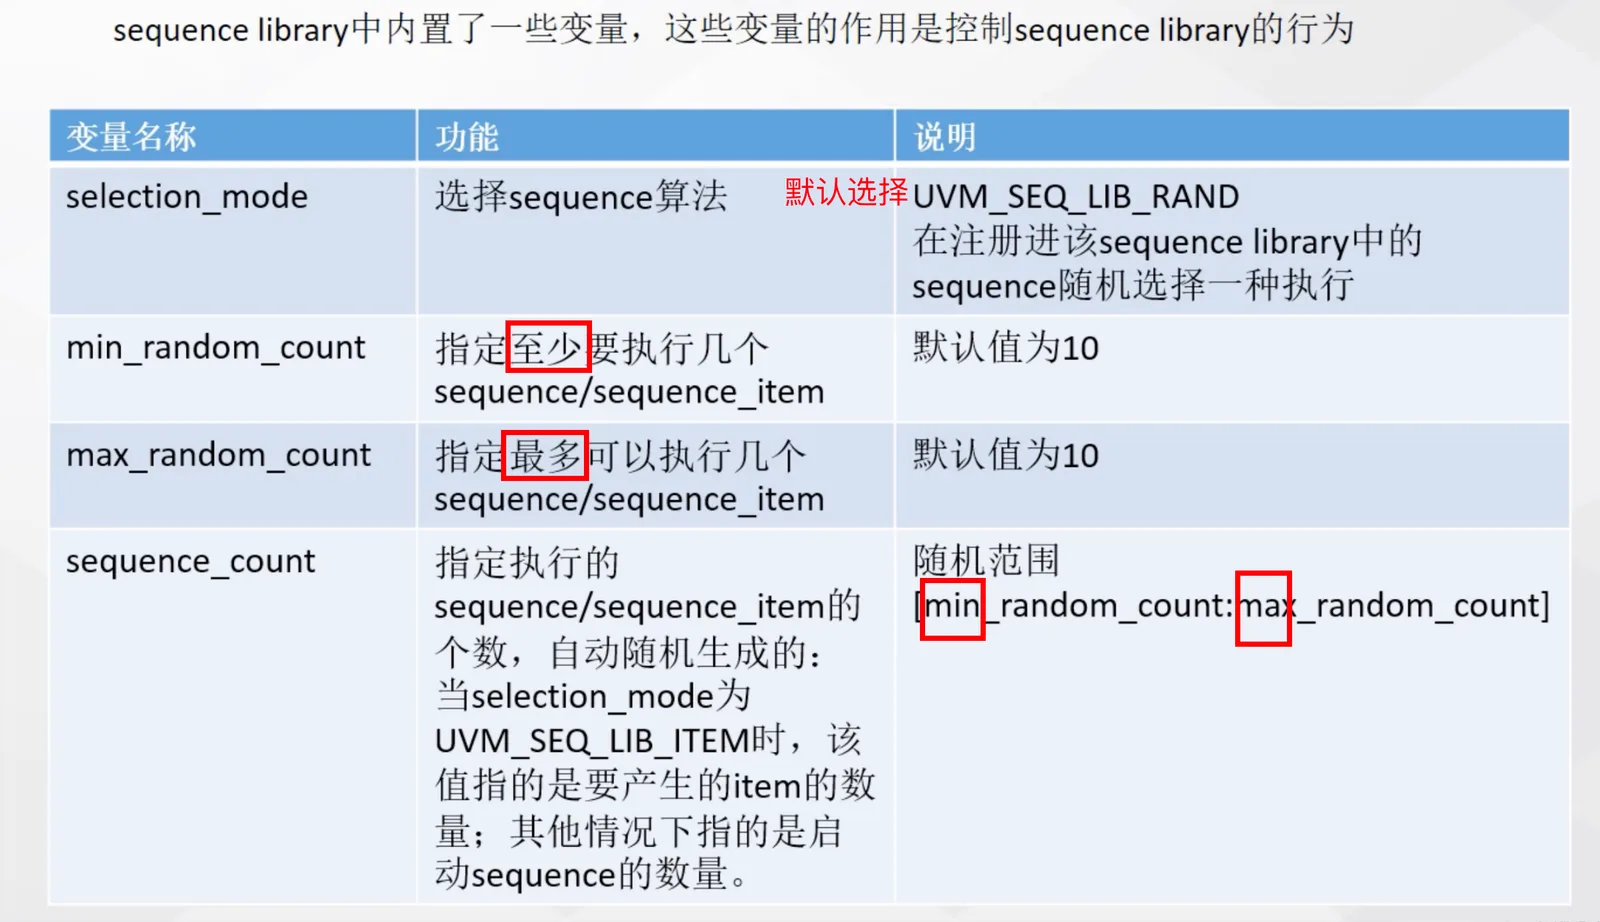
selection_mode
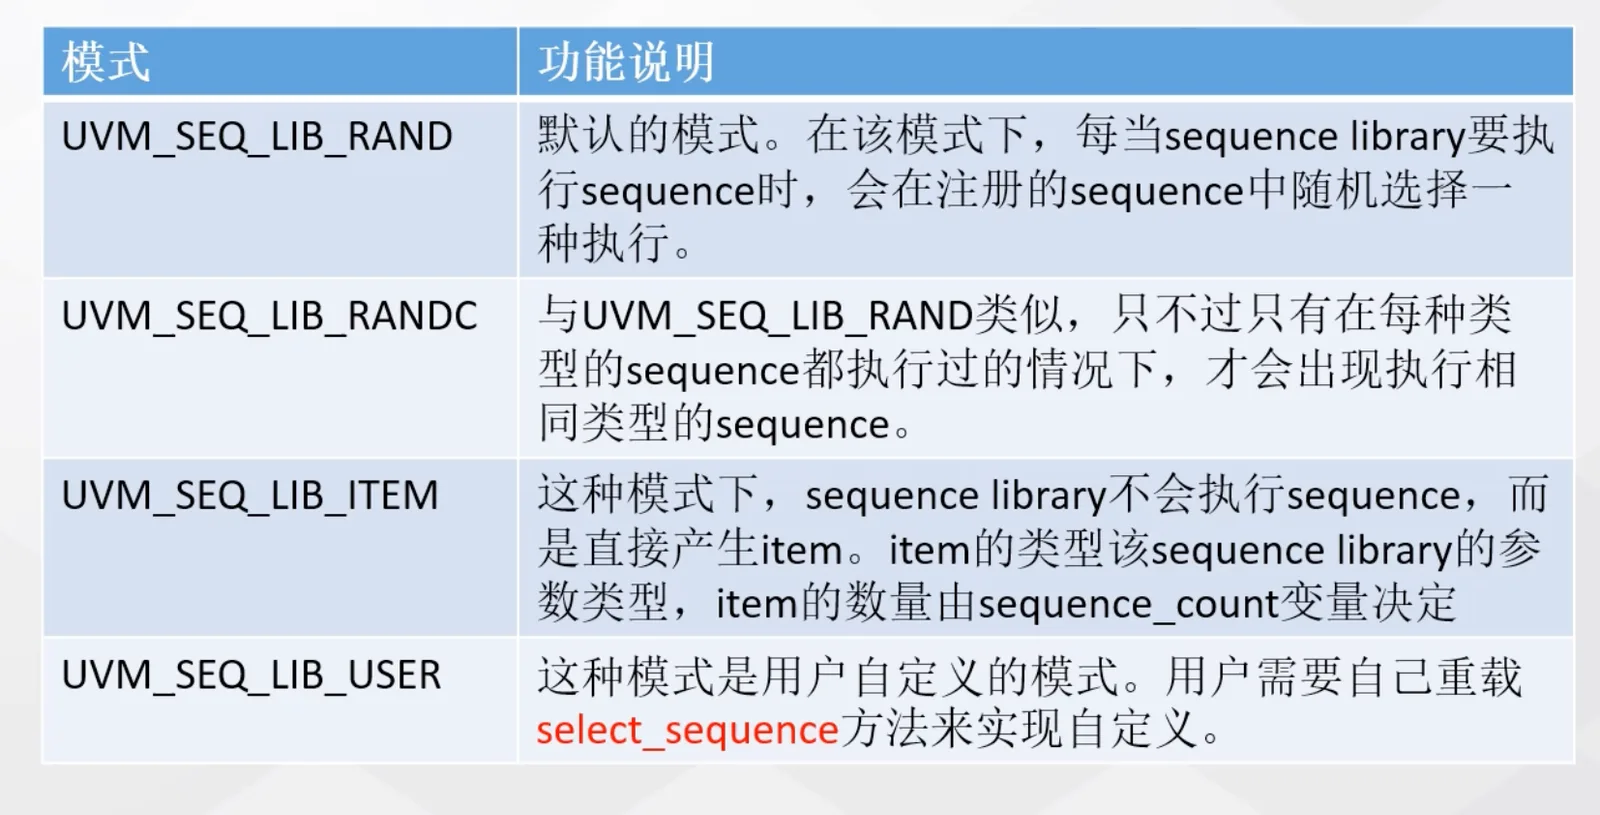
…待补齐
八.Virtual Seq/Sqr
8.1 普通 Sequence
先回顾一下普通sequence,继承 uvm_sequence#(my_transaction) — 产生自己的 transaction,通过 sequencer 发给 driver。
限制:只能驱动一个 sequencer。
class my_seq extends uvm_sequence#(my_transaction);
    virtual task body();
        repeat(10) `uvm_do(req);  // 自己生产
    endtask
endclass
待解决问题:DUT中存在多个接口(APB接口,AXI接口等)
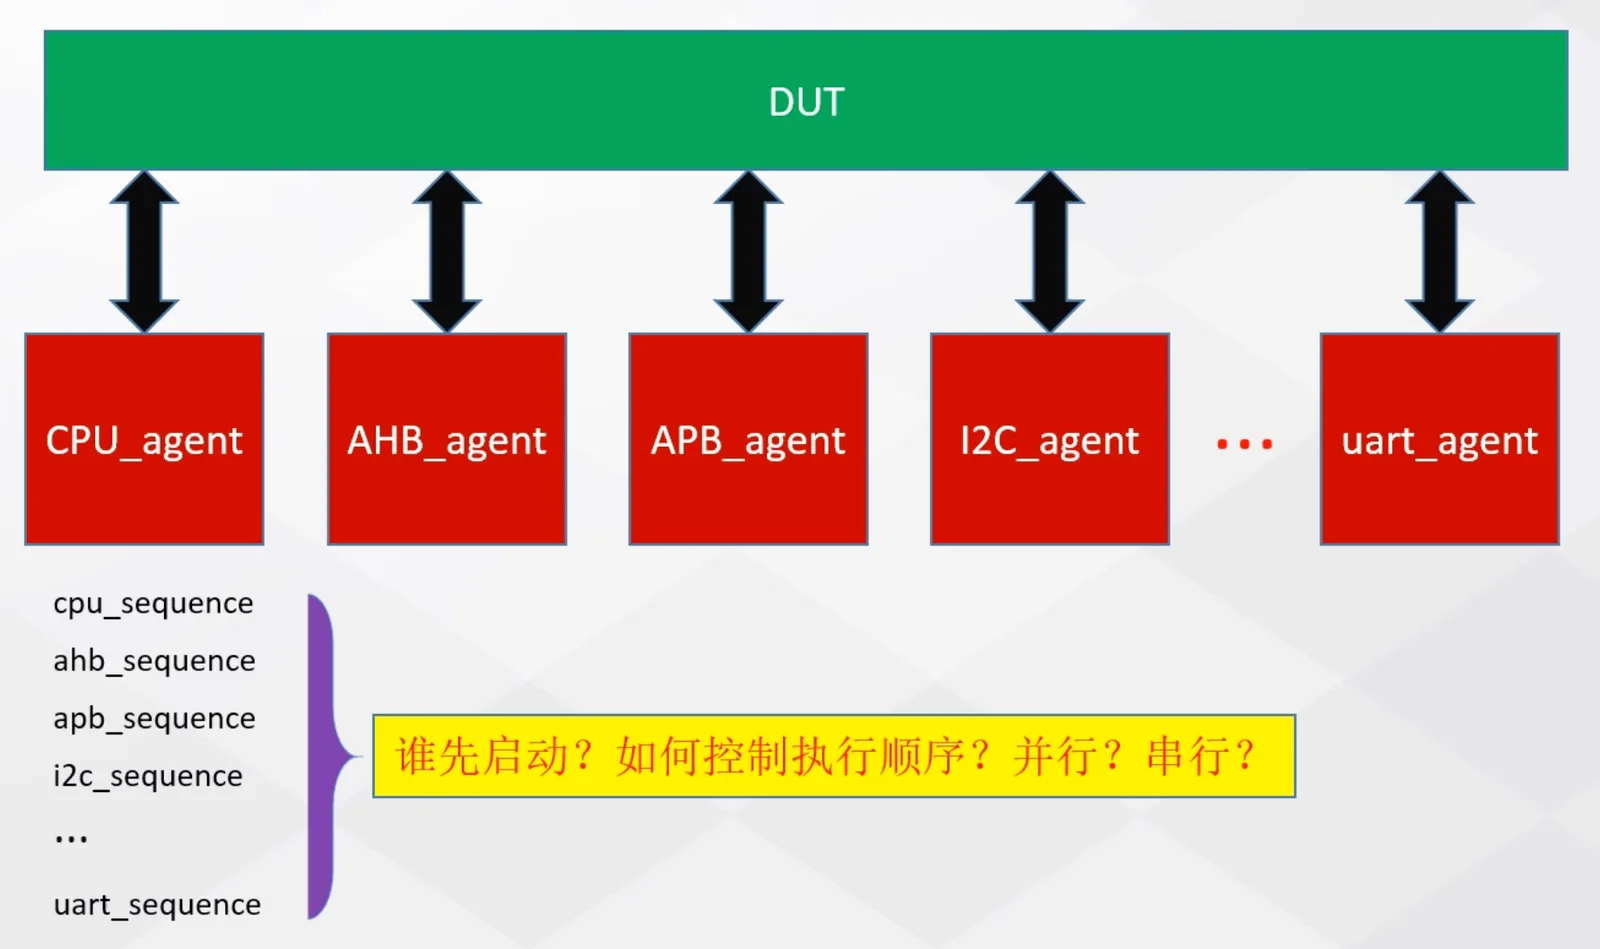
什么是virtual sequence?
具有管理多个sequence,并控制他们的关系功能的sequence virtual sequence的功能上来看,其目的并不是产生事务,而是用来控制子sequence之间的行为,所以称之为“virtual”
一般的,使用一个virtual sequencer来配合virtual sequence使用
因为一个sequence不能对应多个sequencer,所以需要借助virtual sequence
virtual sequencer属于env的子对象
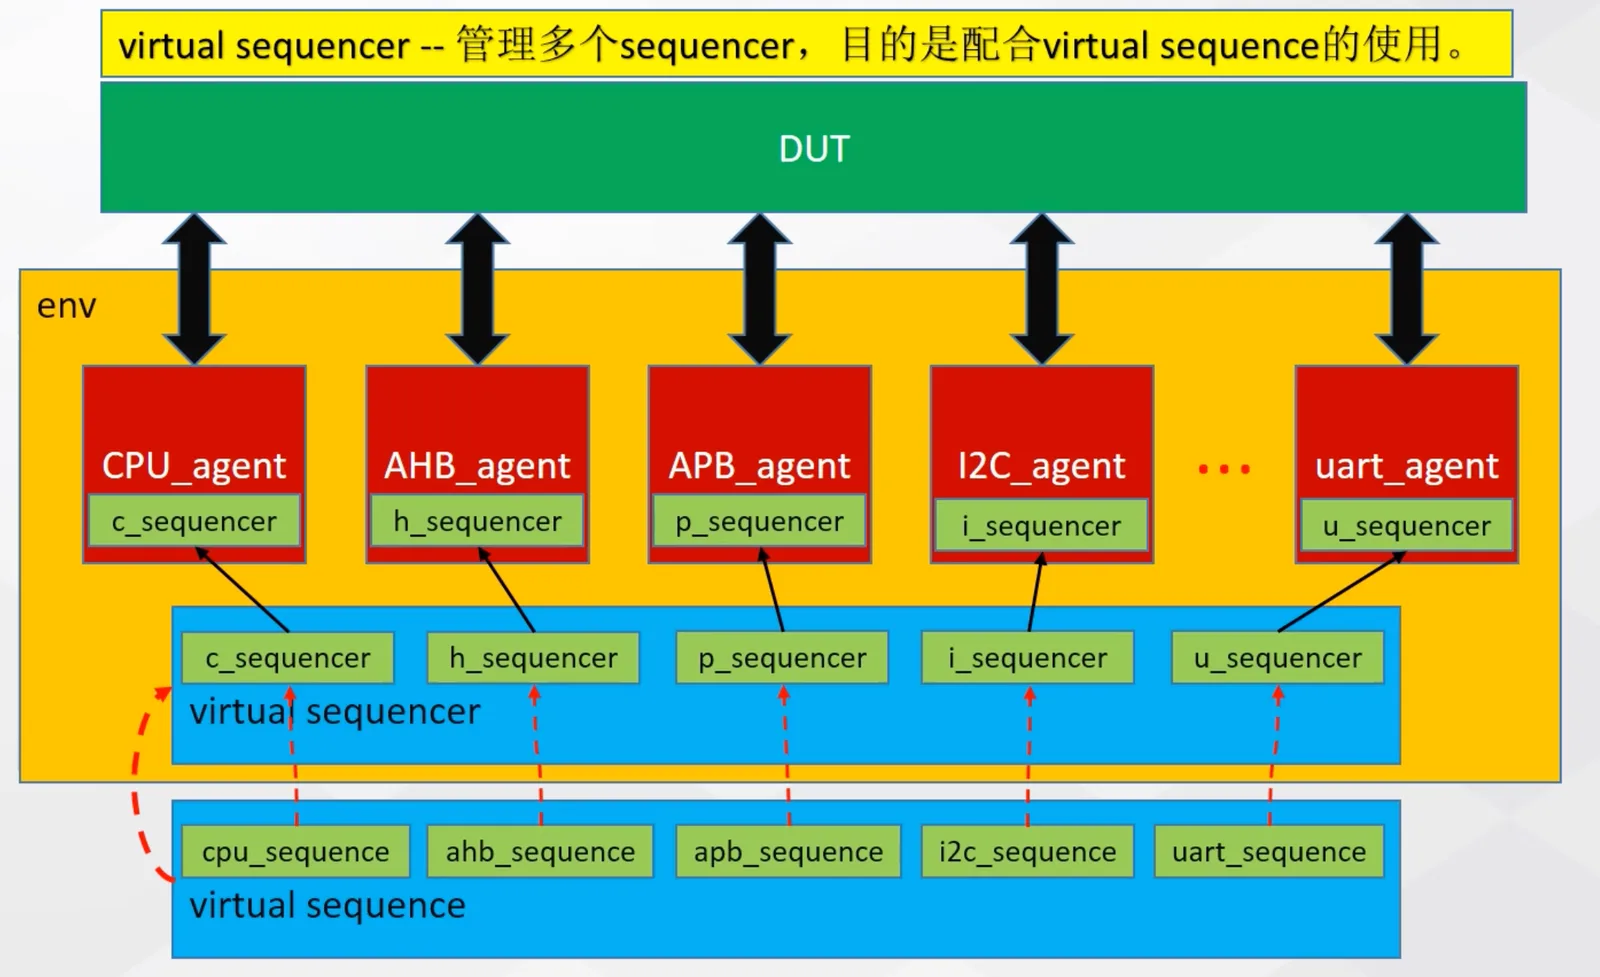
virtual seq/sqr代码
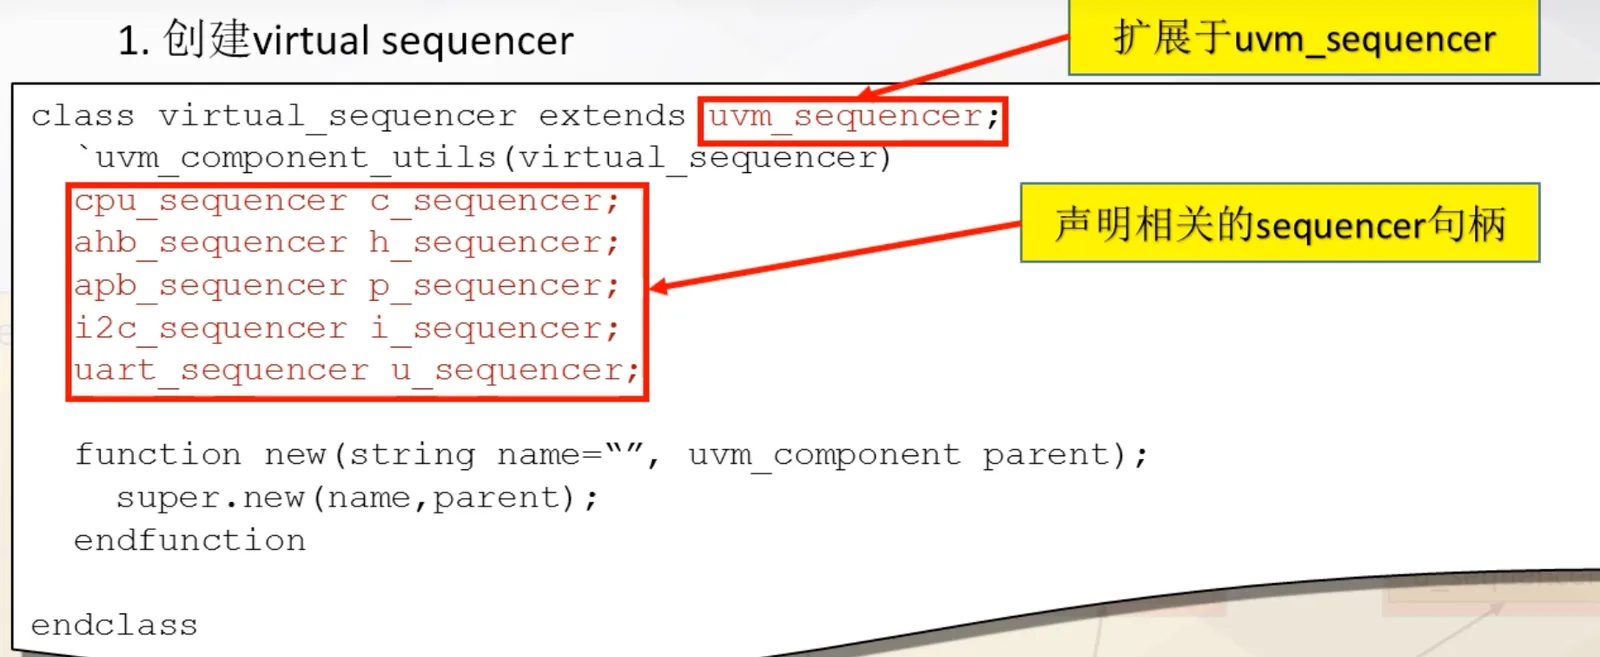
1.创建virtual sequencer
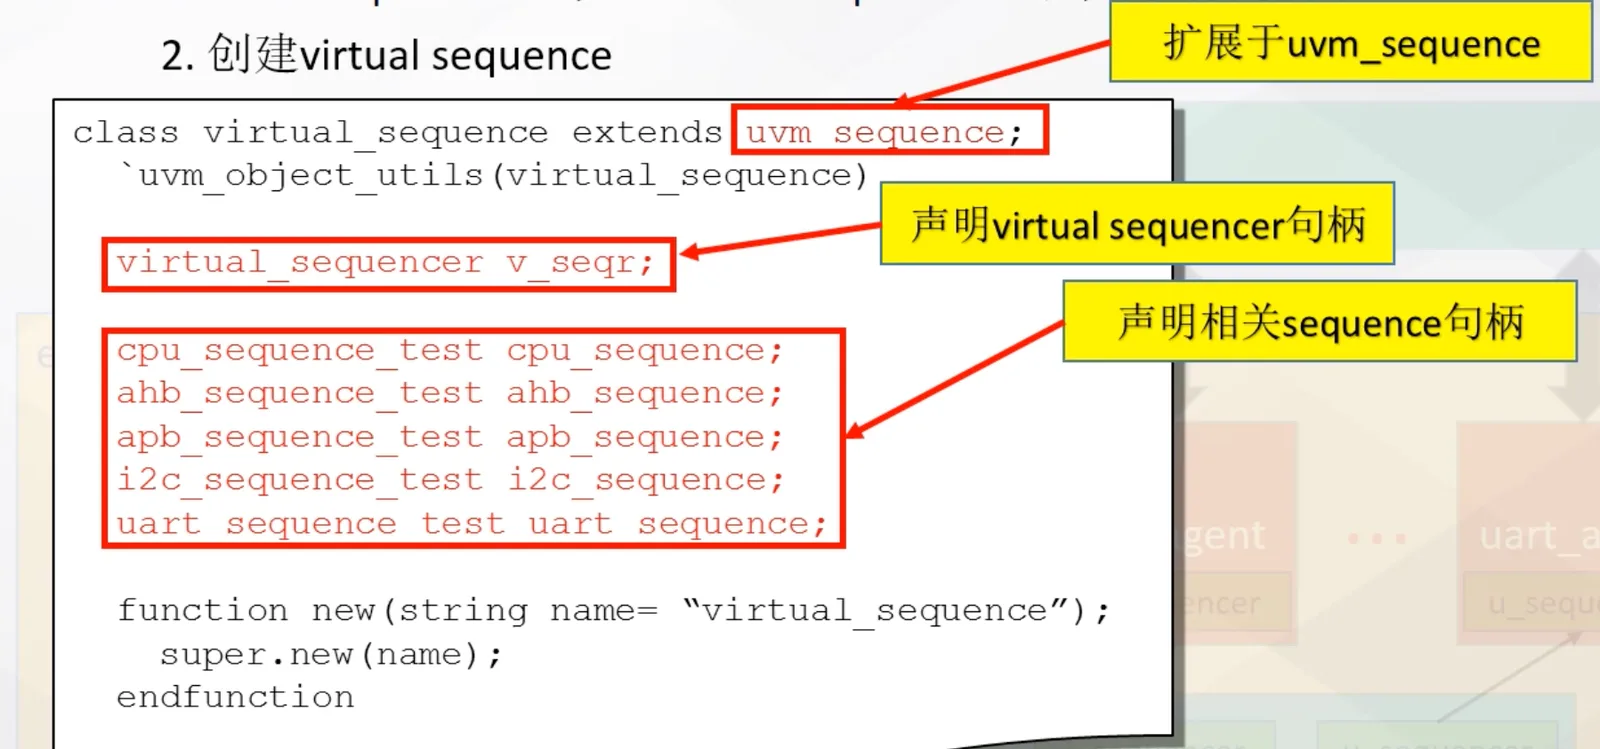
2.创建virtual sequence
virtual sequence要调用virtual sequencer中的sequencer句柄,
所以需要声明virtual sequencer的句柄来方便后续引用
注意:m_sequencer是所有sequence都有的一个内置成员变量。
将m_sequencer复制给v_seqr
在virtual sequence被启动时,与之相关联的sequencer就会赋值给m_sequencer
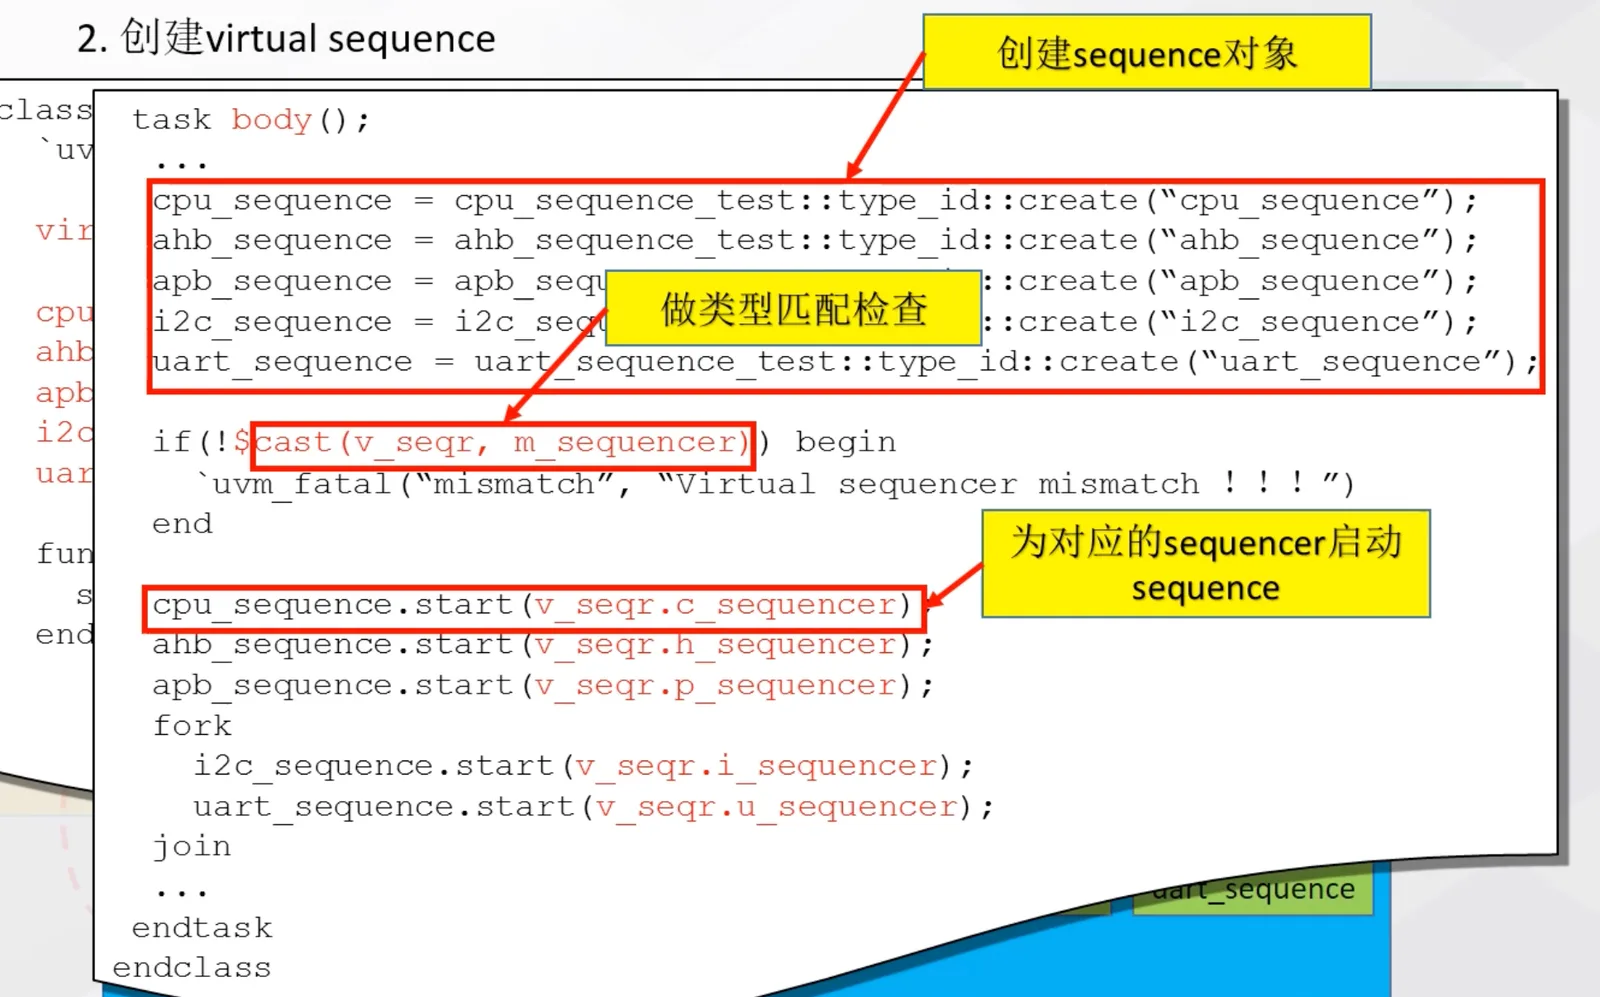 注意:uvm_declare_p_sequencer宏可以代替$cast
在env中实例化virtual sequencer
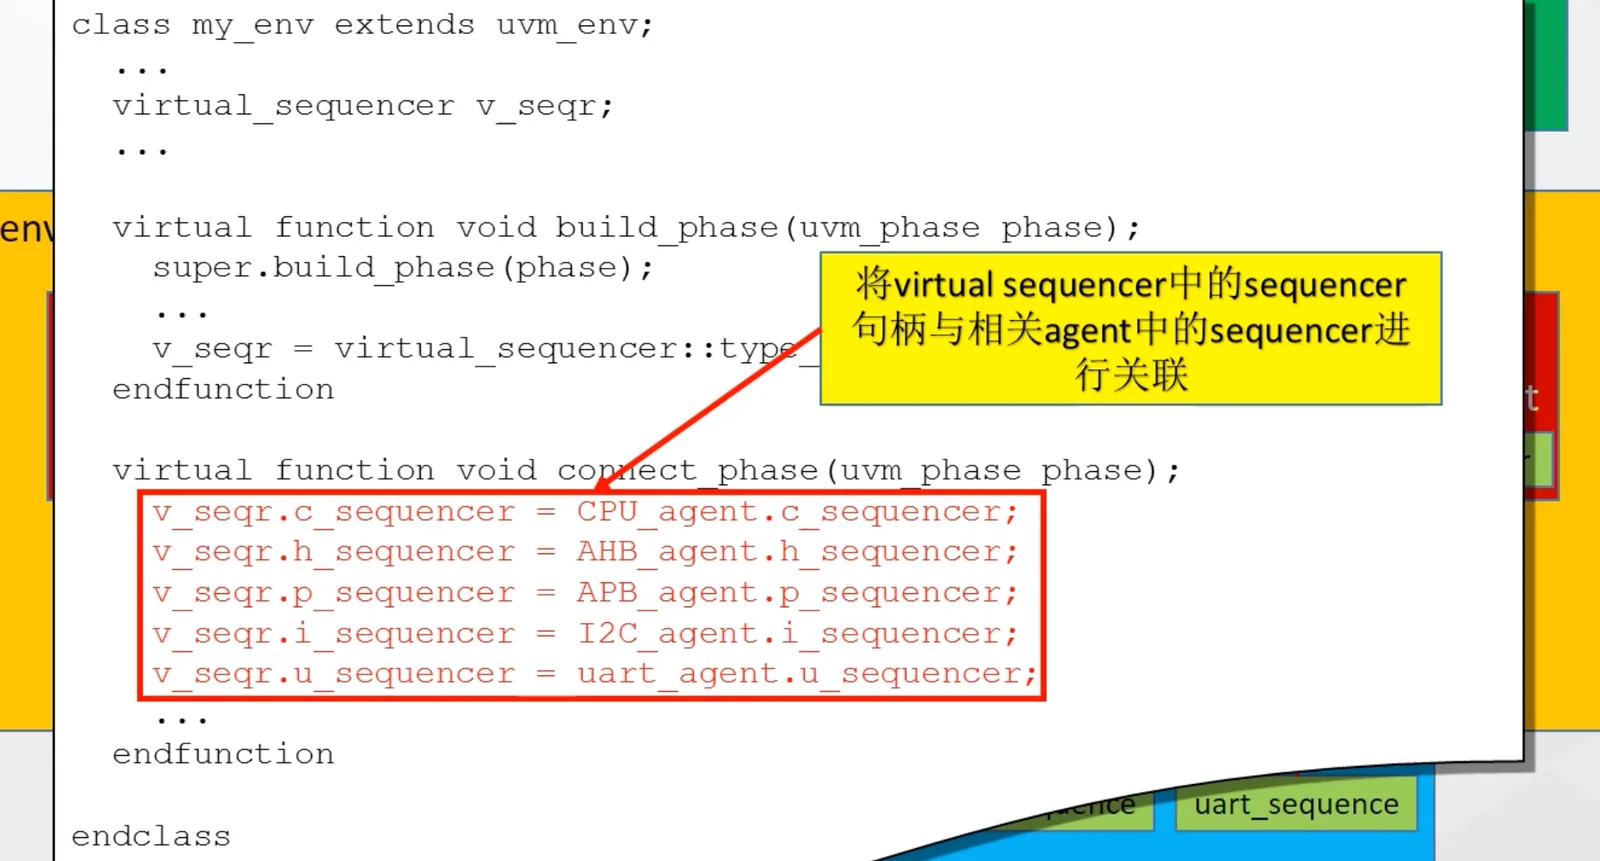
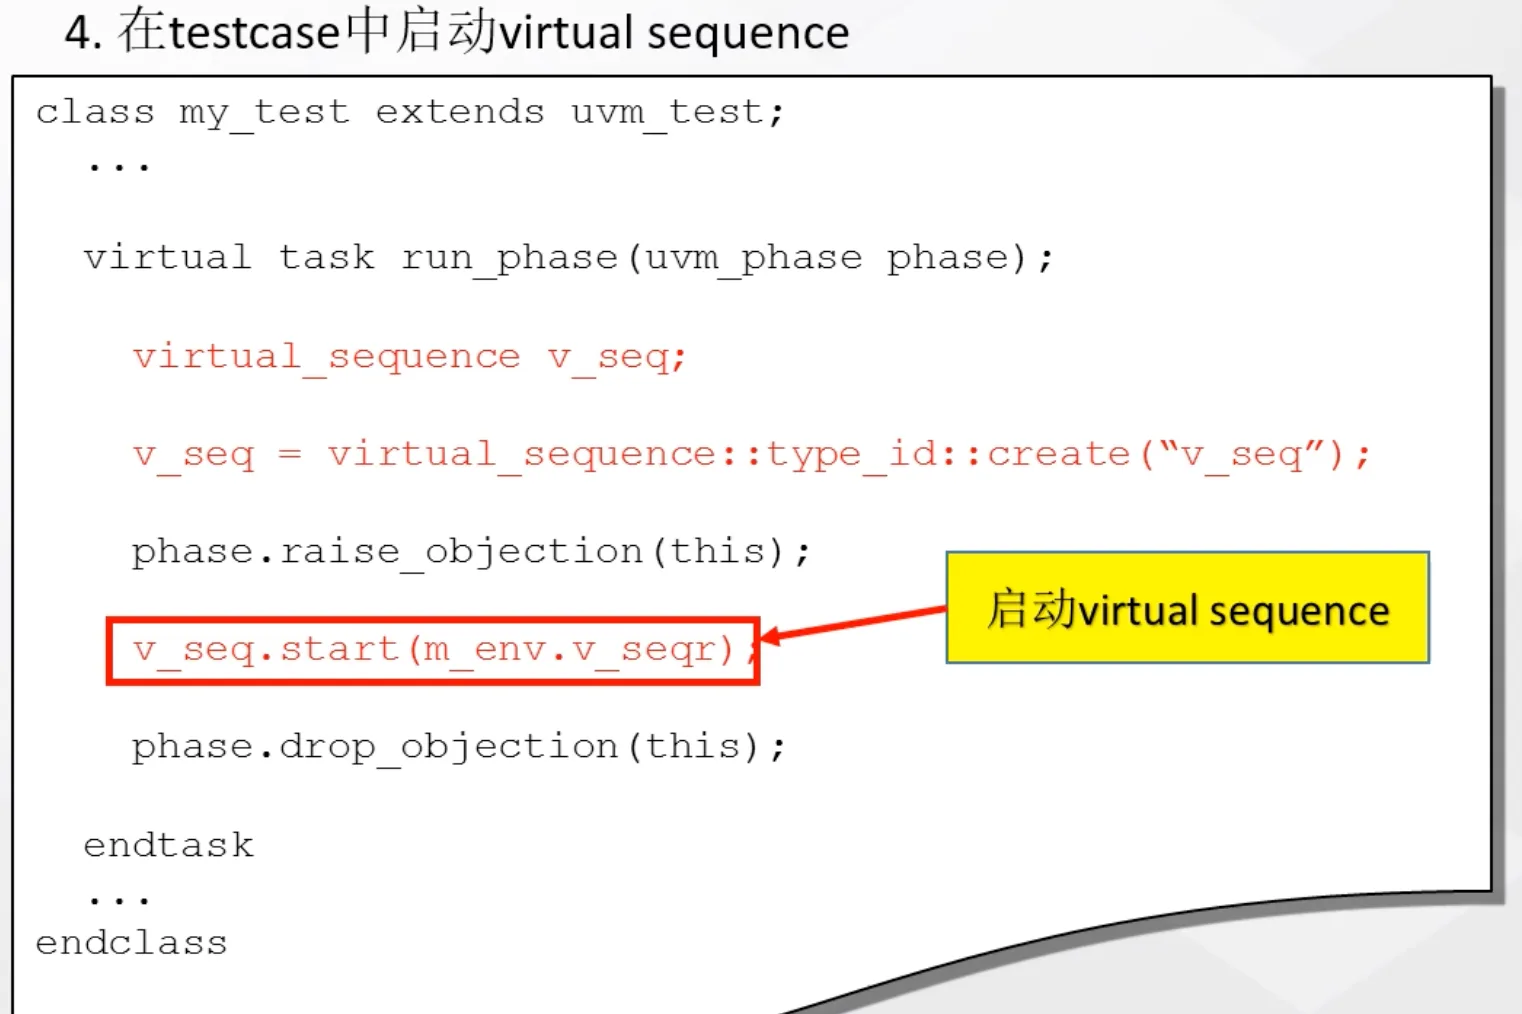
使用virtual sequence的关键 1.建立sequence与sequencer的关联 2.如何在virtual sequence的body任务中协调各个sequence的关系
8.3 Virtual Sequencer
Virtual sequencer = 句柄容器,由于使用了virtual sequence即存在多个sequencer,使用Virtual sequencer 就可以方便访问所需要的sequencer,而不是使用config_db去传参。
继承 uvm_sequencer — 虚拟组件,不产生任何 transaction,只握多个真实 sequencer 句柄。给 virtual sequence 提供挂钩点。
// Virtual Sequencer
class virtual_sequencer extends uvm_sequencer;
    my_master_sequencer m_mseqr;  // 握句柄
    my_slave_sequencer  s_sseqr;
endclass

// Env build_phase
v_seqr = virtual_sequencer::type_id::create("v_seqr", this);

// Env connect_phase
v_seqr.m_mseqr = m_agent.m_seqr;
v_seqr.s_sseqr = s_agent.m_seqr;

// Test run_phase
axi_vseq vseq = new();
vseq.start(v_seqr); // virtual seq 挂在虚拟 sequencer 上不用虚拟 sequencer 也能跑(vseq 直接挂 master_seqr),但虚拟 sequencer 清晰语义:这个 sequencer 只做协调,不处理真实激励。
小结
| 普通 Seq | Virtual Seq | Virtual Seqr | |
|---|---|---|---|
| 继承 | uvm_sequence#(tx) | uvm_sequence | uvm_sequencer |
| 产生 | ✓ transaction | ✗ 启动子 seq | ✗ 握句柄 |
| 层级 | 激励 | 激励 | 组件 |
| 创建 | run_phase | run_phase | build_phase |
| 控制 | 1 个 sequencer | fork N 个 sequencer | 容器 |
11.RAL
Register Abstraction Layer
一.寄存器与存储器
在验证中,工程师不但要对DUT的功能进行验证,还要对DUT中所包含的所有的寄存器和存储器进行验证
- 寄存器用于存储对芯片的配置信息和状态信息
- 存储器用于存储芯片处理时所需的中间数据
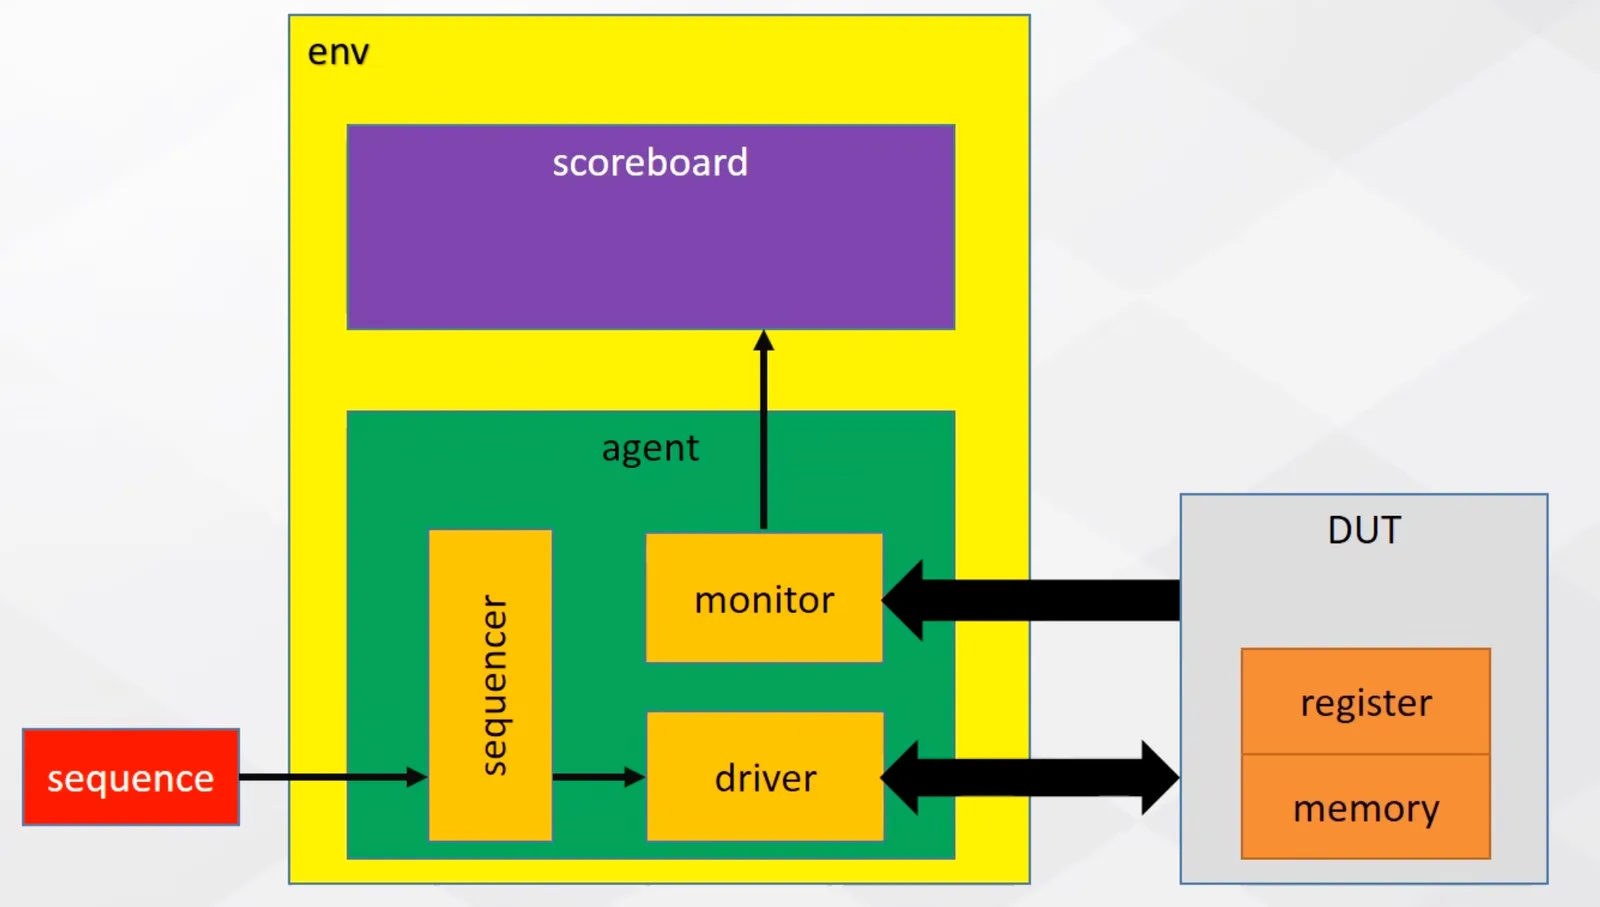
上图为最简单配置寄存器的流程,
RAL的引入:
因为对寄存器的读写操作需要启动一个sequence来完成,若在某一情况下,scoreboard希望去查看DUT中某些寄存器状态或值,则需要在sequence中插入对dut寄存器的读写命令,但是sequence不知道scb什么时候需要读写寄存器
- 解决办法:在scb中插入一个事件,然在sequence中等待这个事件触发,一旦触发,monitor将其捕获发送给scb(可以看出解决办法繁琐)
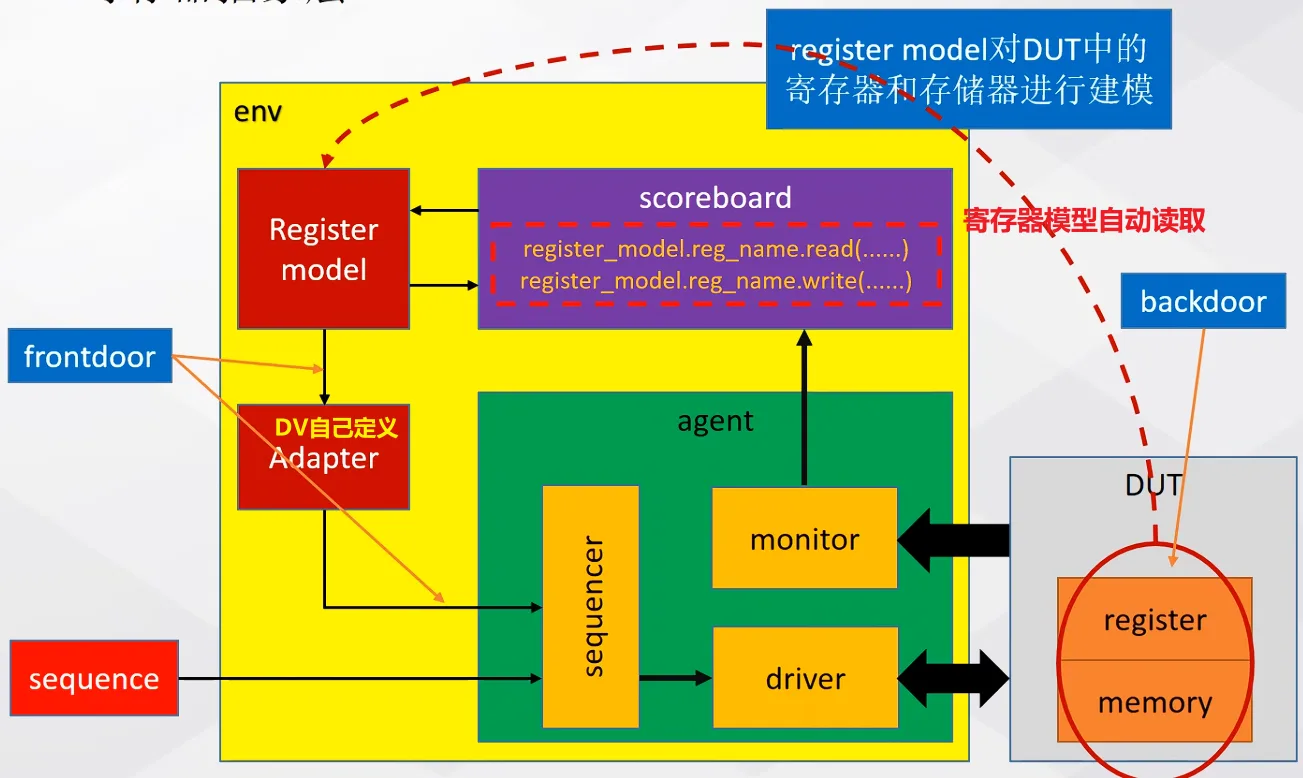
UVM为方便验证工程师对DUT中的寄存器和存储器进行操作,即建立了RAL机制
- register model是一套数据结构,亦在对DUT中的寄存器和存储器进行建模
- 一旦建立好了寄存器模型,就可将其实例化在env中作为平台组件的一部分。
- 有了env中register model这个平台组件,scb就可以访问这个组件来而间接的访问DUT中的寄存器和存储器
- 这样,scb就可以与sequence完全分开了
- scb使用reg model提供的API来访问,可使用read或write来操作
model想要访问DUT中的寄存器还需要一个adapter,因为reg model产生的事务类型可能与sequencer能接受的事务类型可能有所不同。
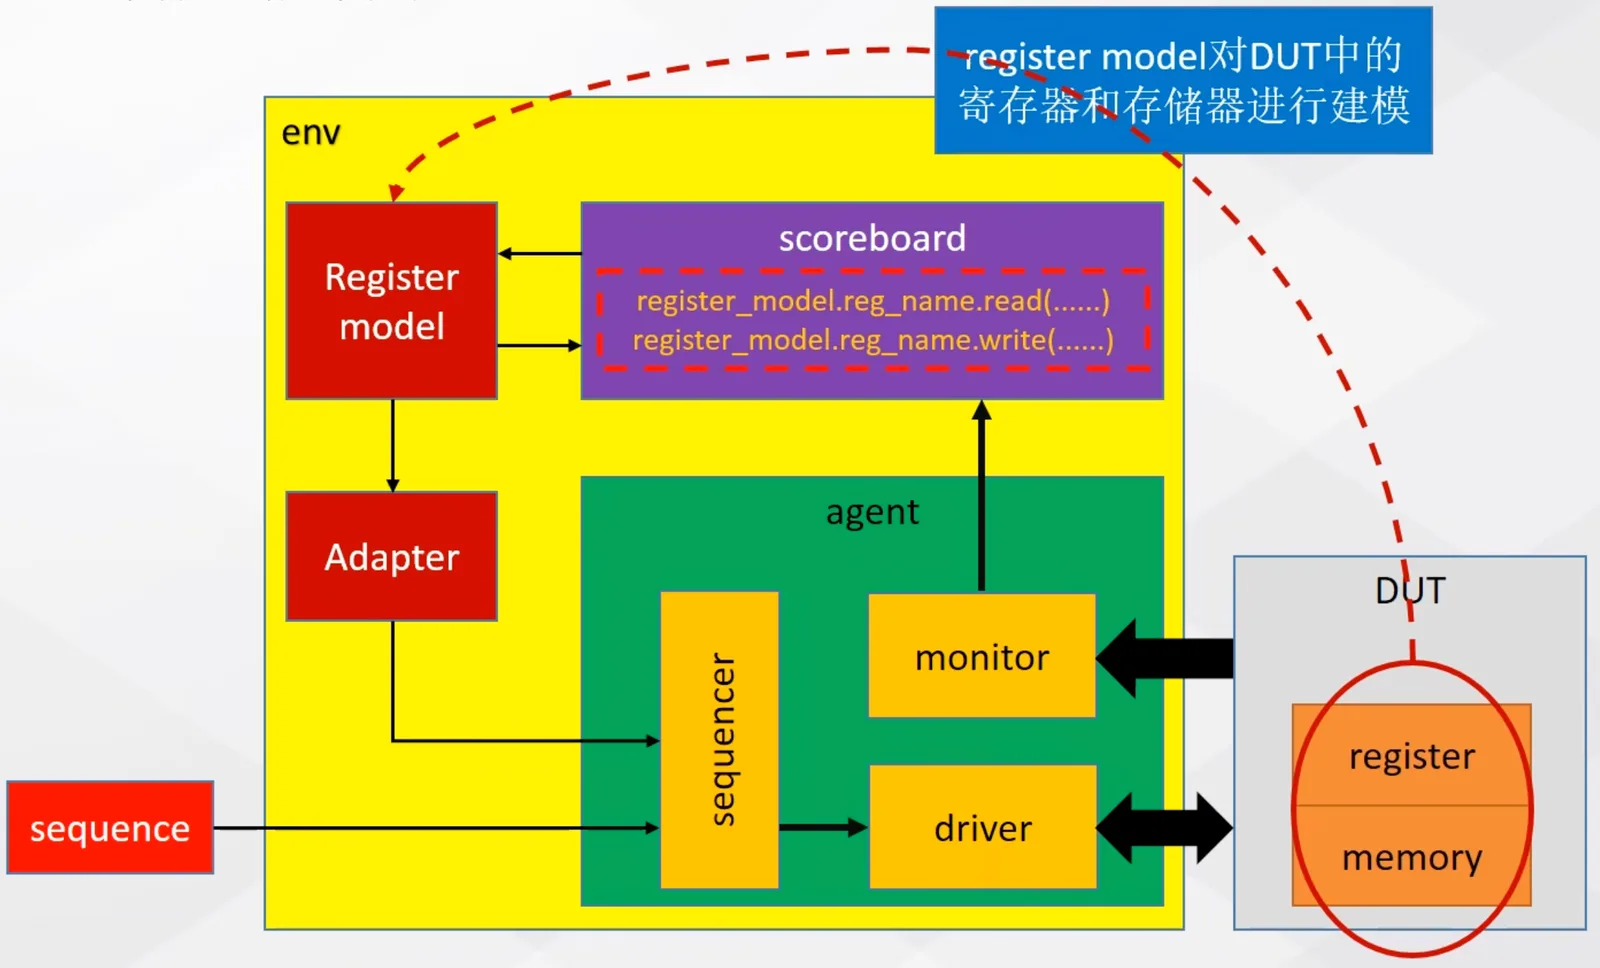
两种访问模式:
frontdoor模式:寄存器模型通过产生事物,并借助agent来访问dut中的存储器 backdoor模式:寄存器模型直接层次访问dut中的存储器(通过dut的设计层次路径)
二.工作原理
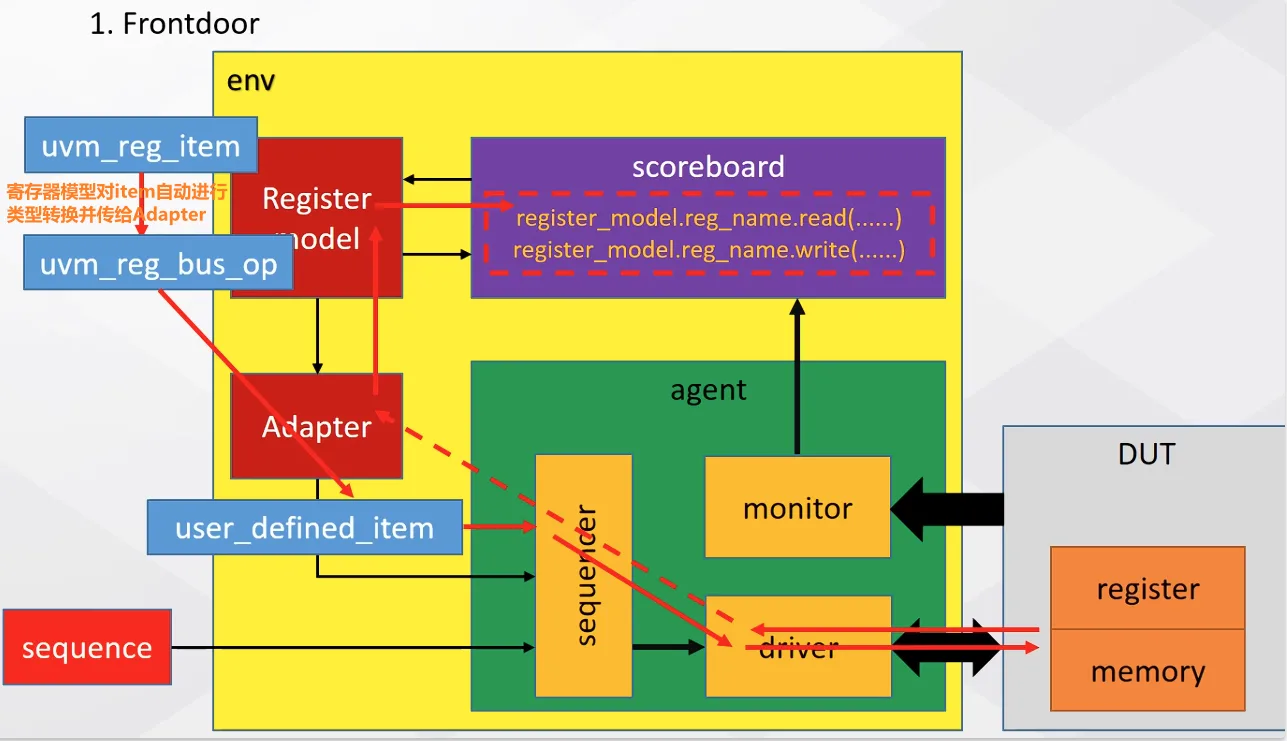
frontdoor: 当在scb / 其他组件中调用寄存器模型的API进行寄存器访问时
-
触发 API: 在任何组件(如 Sequence, Scoreboard)中调用寄存器模型的 API(如
read()/write())时,寄存器模型会自动产生一个包含了该操作信息的uvm_reg_item对象。- (
uvm_reg_item是一个“重负载”的复杂类对象。 它里面不仅有地址和数据,还包含了极多 RAL 专属的后台信息)
- (
-
中间信息提取: 寄存器模型内部的
uvm_reg_map(地址映射组件)会将uvm_reg_item提取并转换为uvm_reg_bus_op结构体(注意:它是一个 struct,包含读写类型、地址、数据等核心要素)。- 这一步,相当于
uvm_reg_map充当了“大管家”,它把 UVM 复杂的内部文件(item)提取出最核心的摘要信息(bus_op),再递给底层干活的 Adapter,让 Adapter 只专注于总线协议转换这一件事。
- 这一步,相当于
-
Adapter 桥接转换:
uvm_reg_map调用 Adapter 的reg2bus()方法,把uvm_reg_bus_op传入,转换成 Sequencer 认识的用户自定义总线事务(Bus Transaction)。- 自定义原因: 因为不同项目的底层协议(如 AXI, APB, SPI 等)长得完全不一样,UVM 无法预知,所以 Adapter 必须由用户根据具体总线类型自行编写。
虽然前门访问机制比较复杂,但使用时不必关心访问流程,scb中只需要一条读写语句即可实现操作。
注意:只有frontdoor才存在Adapter
后访:寄存器模型直接对DUT层次引用,无需像前访一样寄存器模型产生item
两者区别:frontdoor消耗仿真时间,后访不需要消耗。
三.寄存器模型构成
1.uvm_reg_block
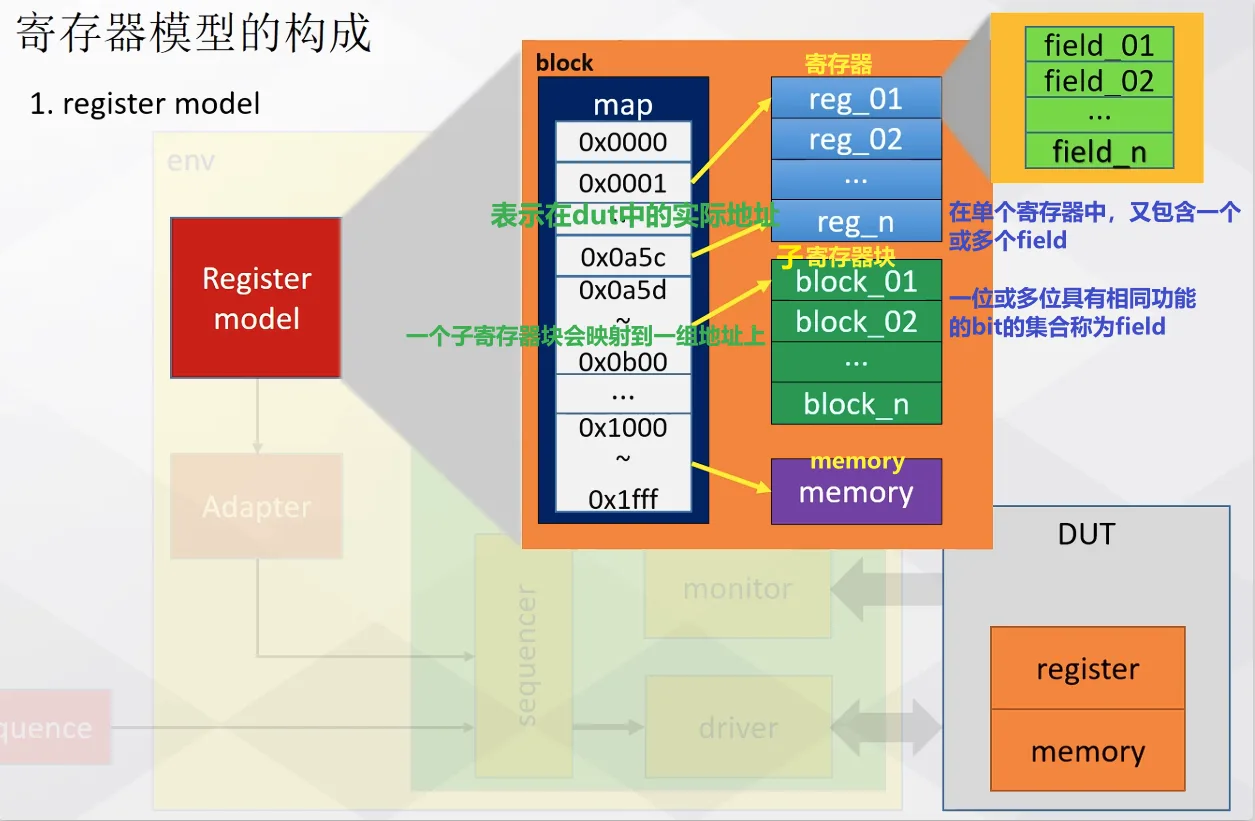
整个寄存器模型由一个叫做uvm_reg_block的类构成。
- 这个模块中包含多个寄存器
- 单个寄存器中包含一个或多个filed,(一位或多位具有相同功能的bit称之为field)
- 也可包含子寄存器模块(映射到一个地址范围上)
- 对 存储器 建模的memory
- 一张map,其中存储着地址映射关系,用于表示在dut中实际地址
其中包含以下内容
2.adapter
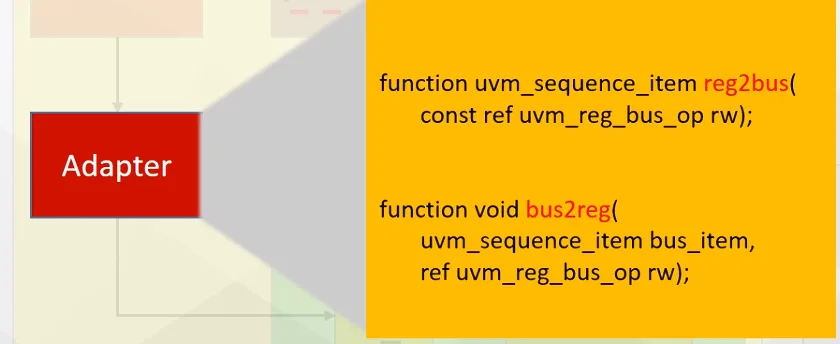
需要自己编写,但也不是从0开始,重载其中两个关键的函数:
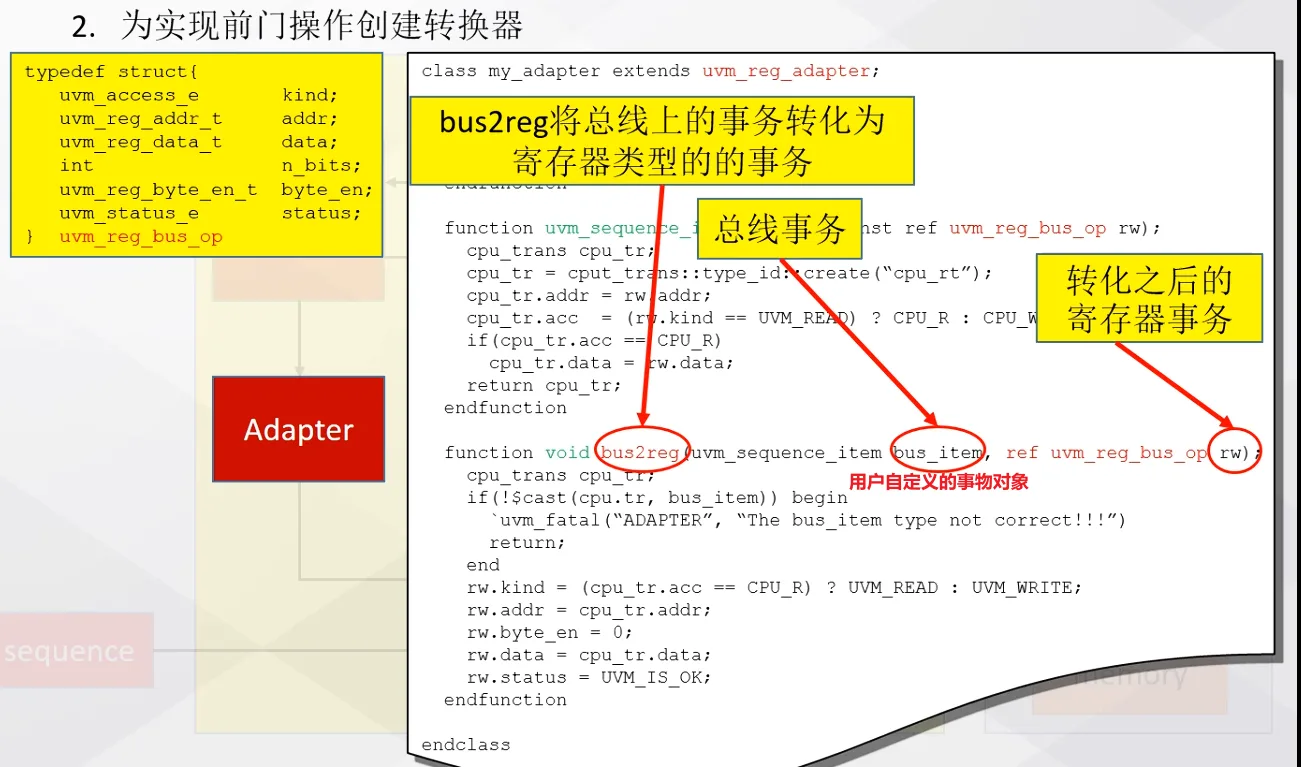
- reg2bus:将寄存器模型产生的
uvm_reg_bus_op类型的对象转换成用户自定义类型(user_define_item)的对象,转换之后的事物对象会自动发往sequencer中 - bus2reg:和上述相反,将user_define_item转成uvm_reg_bus_op。
- 转换之后的事物对象会被寄存器模型分析,然后更新模型中的对应值
只需重载这两个函数即可,其会在仿真时被UVM平台自动调用
3.连接register model
句柄赋值:连接的过程,借助寄存器模型中的map来完成: map中不止包含dut中寄存器映射关系,还包含了与adapter连接的adapter句柄,也包含了sequencer句柄,还有一些function和task,
- 将env中的Adapter赋值给map中的Adapter句柄 即可完成连接
- 将agent中的sequencer赋值给map中的sequencer句柄 即可完成连接
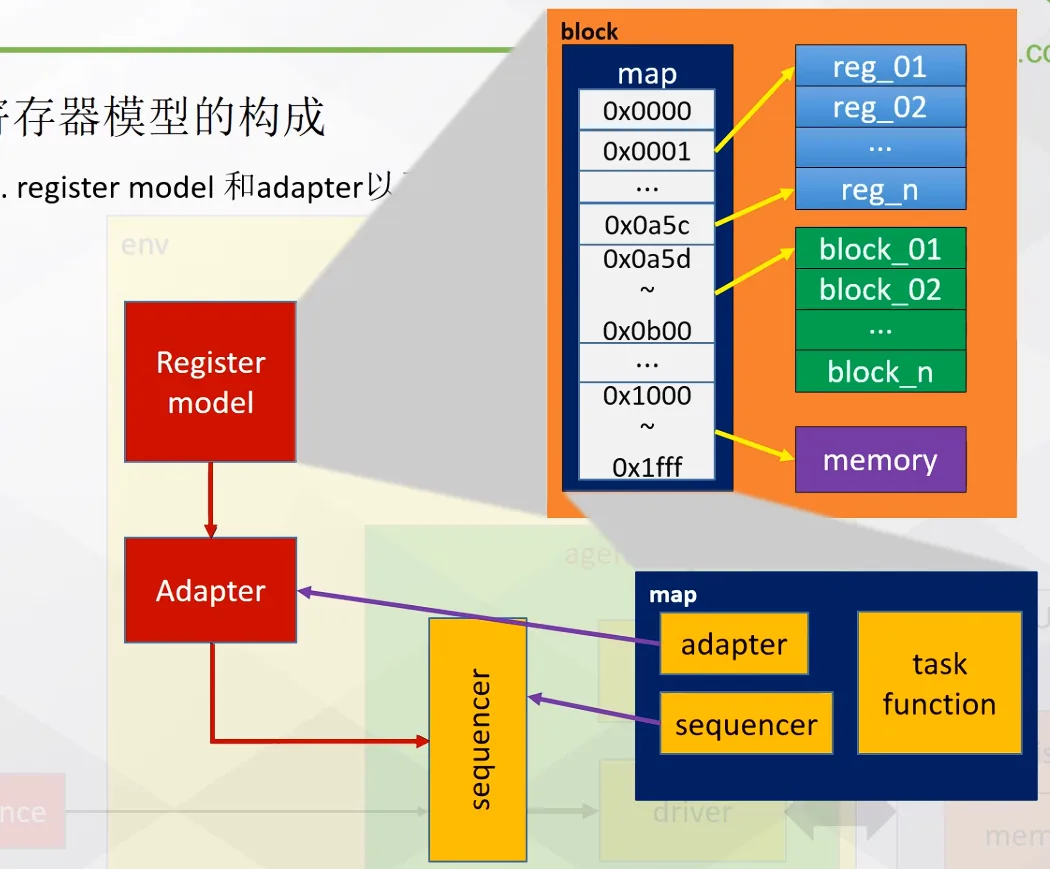
四.测试平台加入reg_model
步骤:
- 为DUT创建寄存器模型 ,其中包含DUT的每一个寄存器和存储器
- 为创建实现前门操作的Adapter
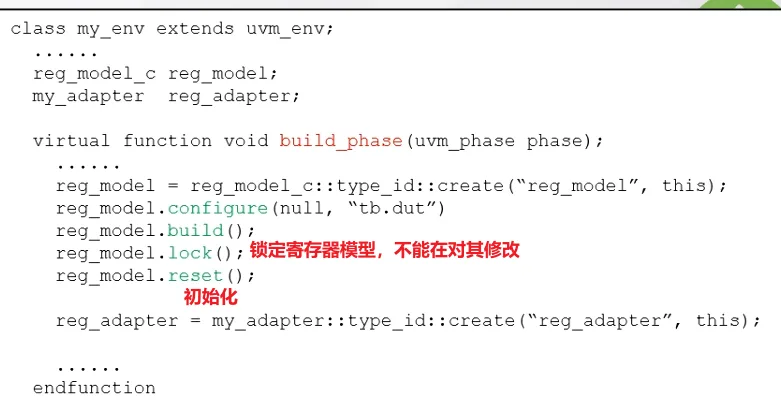
- 在env中实例化两者
- 在env中将Adapter、sequencer与寄存器模型的map建立关联
- 在其他组件中使用API访问寄存器
- 运行测试
举例:
假设在DUT中包含名为config_reg的寄存器…
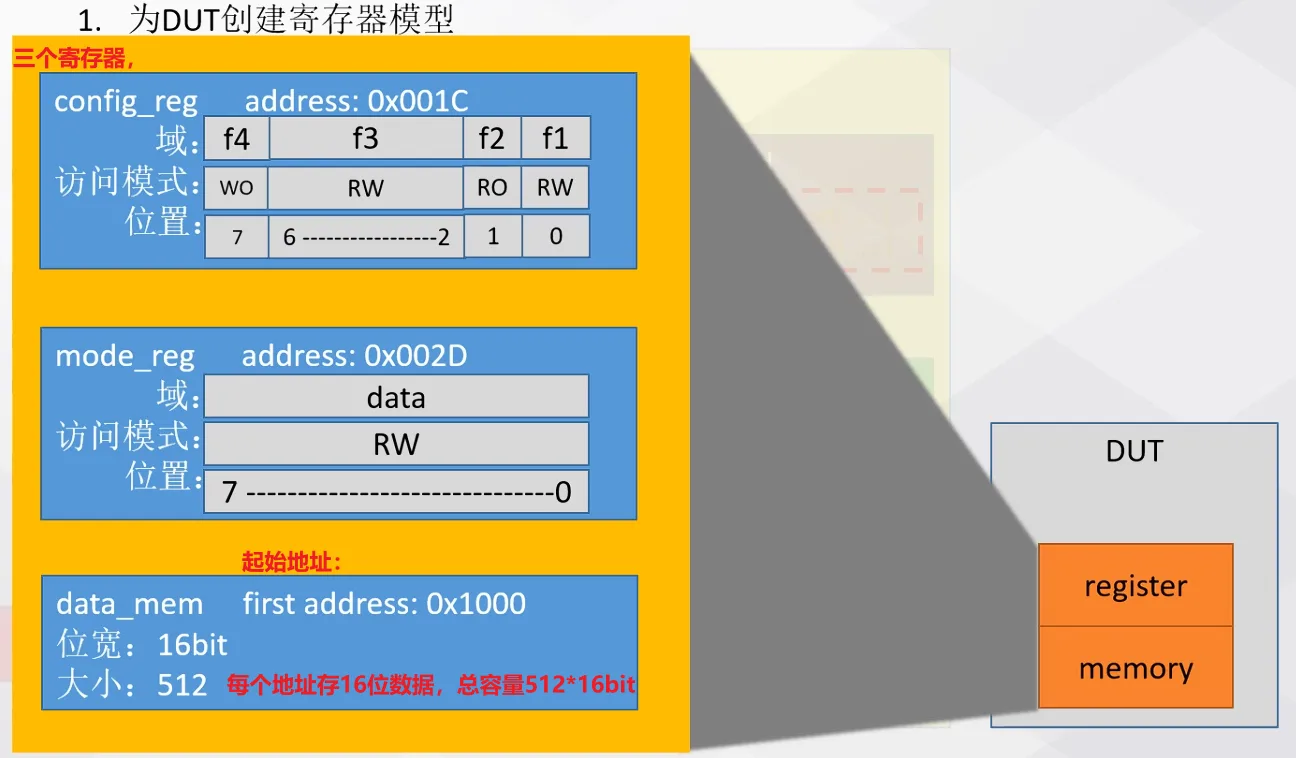
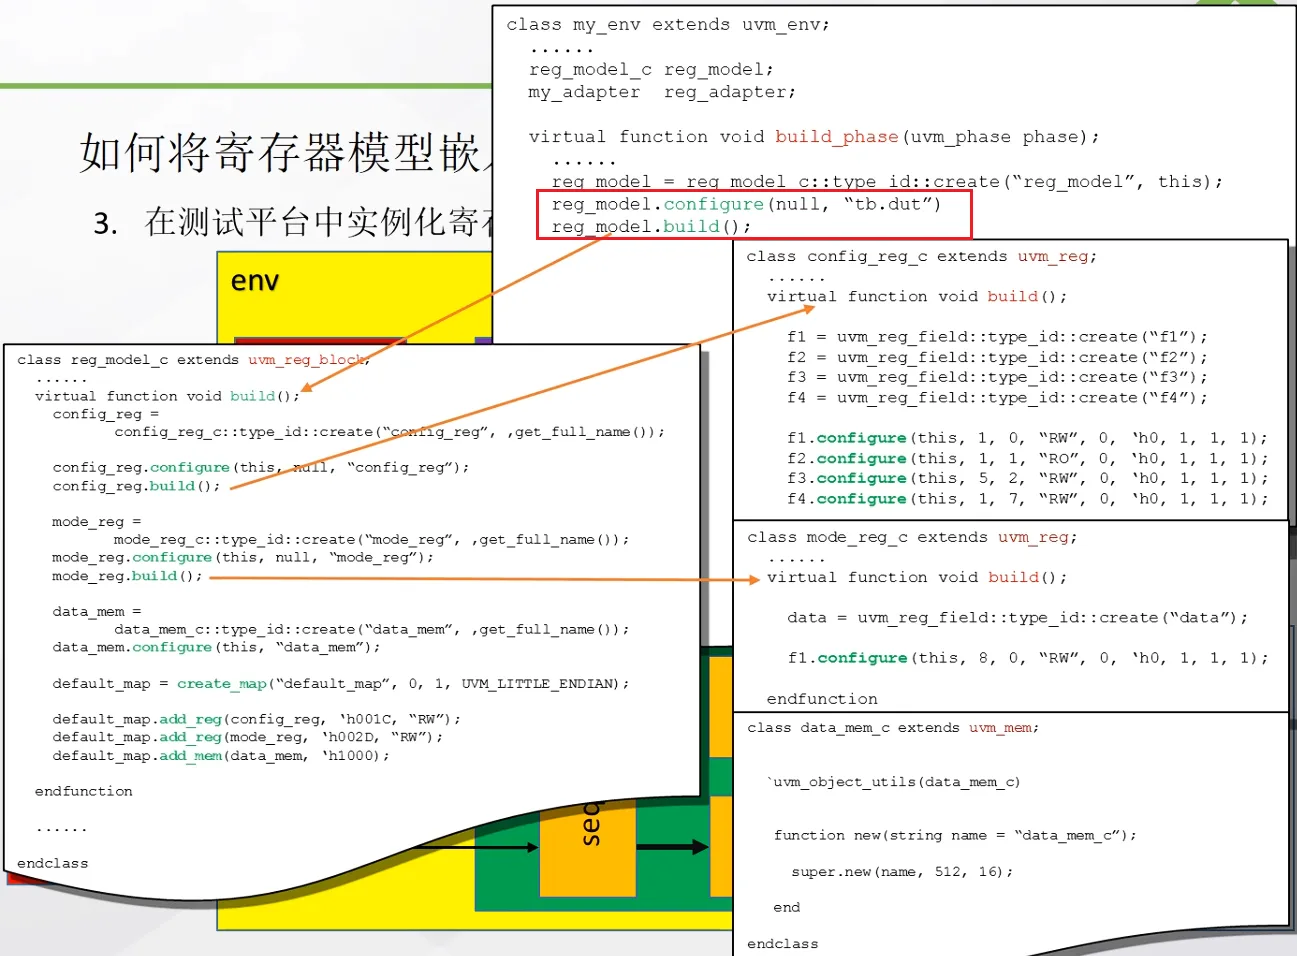
1.创建寄存器模型并map
(寄存器基类uvm_reg)
1.uvm_reg寄存建模
1.configure配置寄存器filed属性
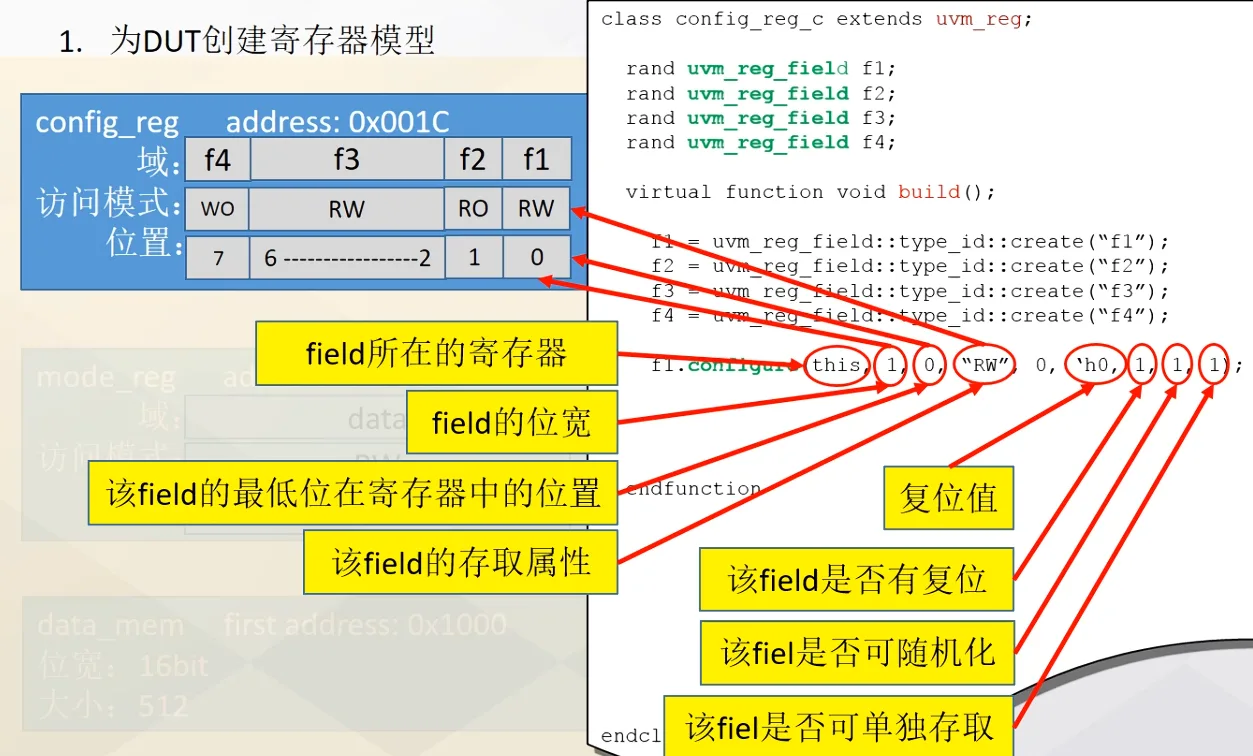
2.super.new
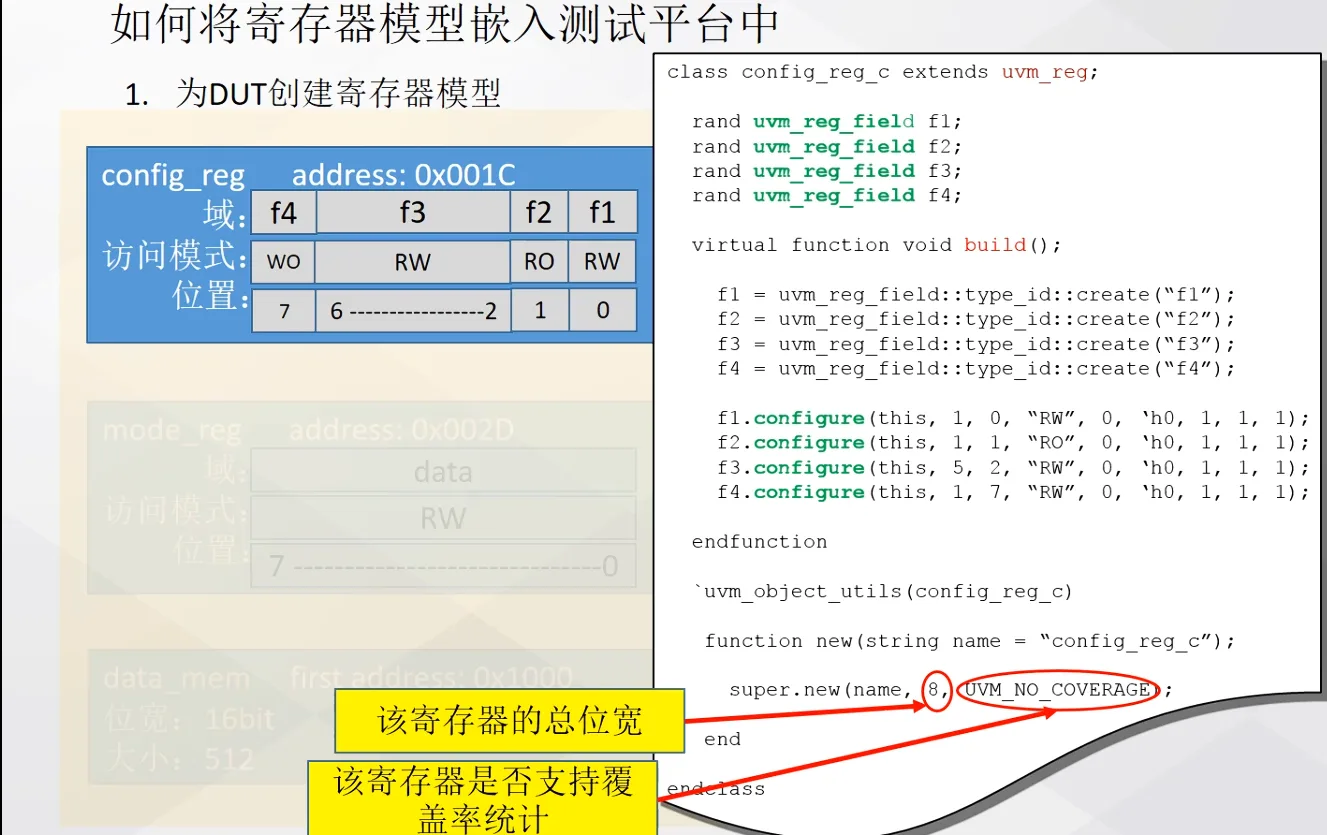
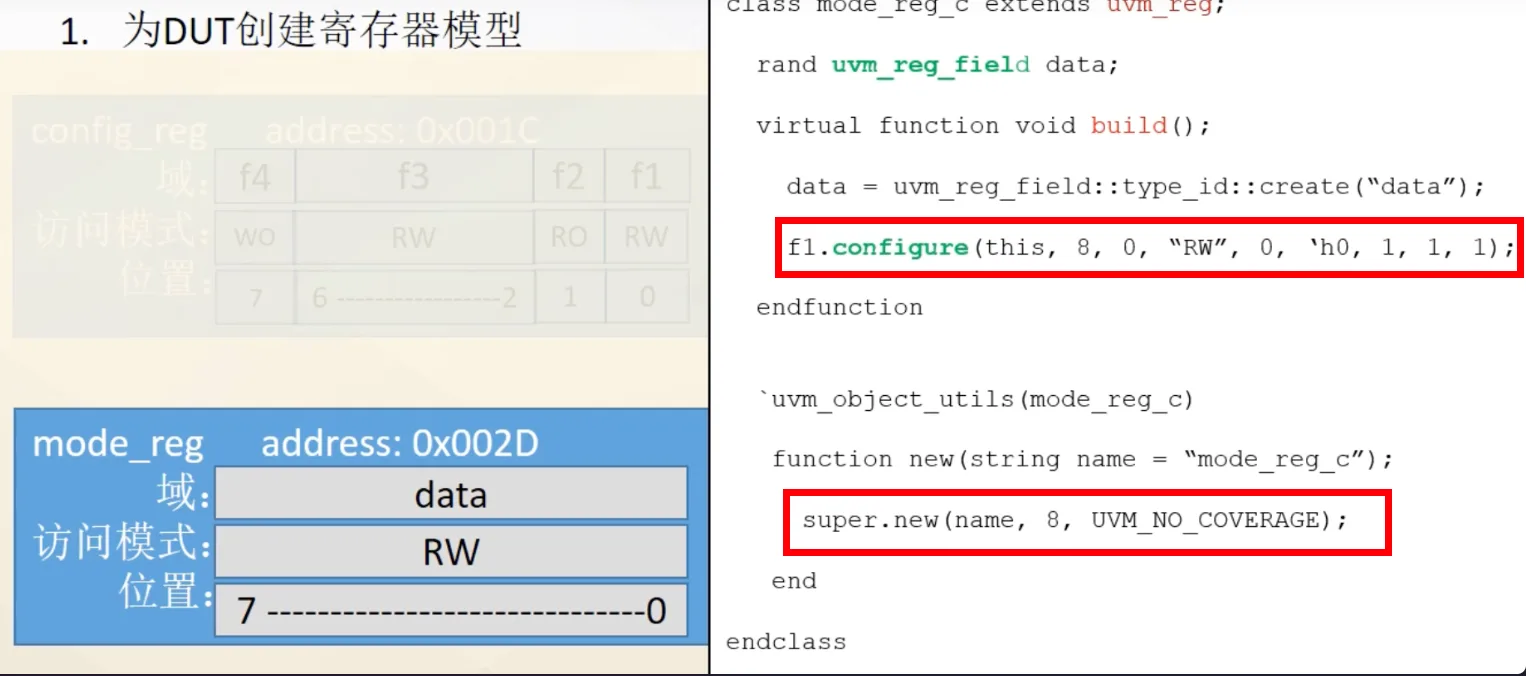
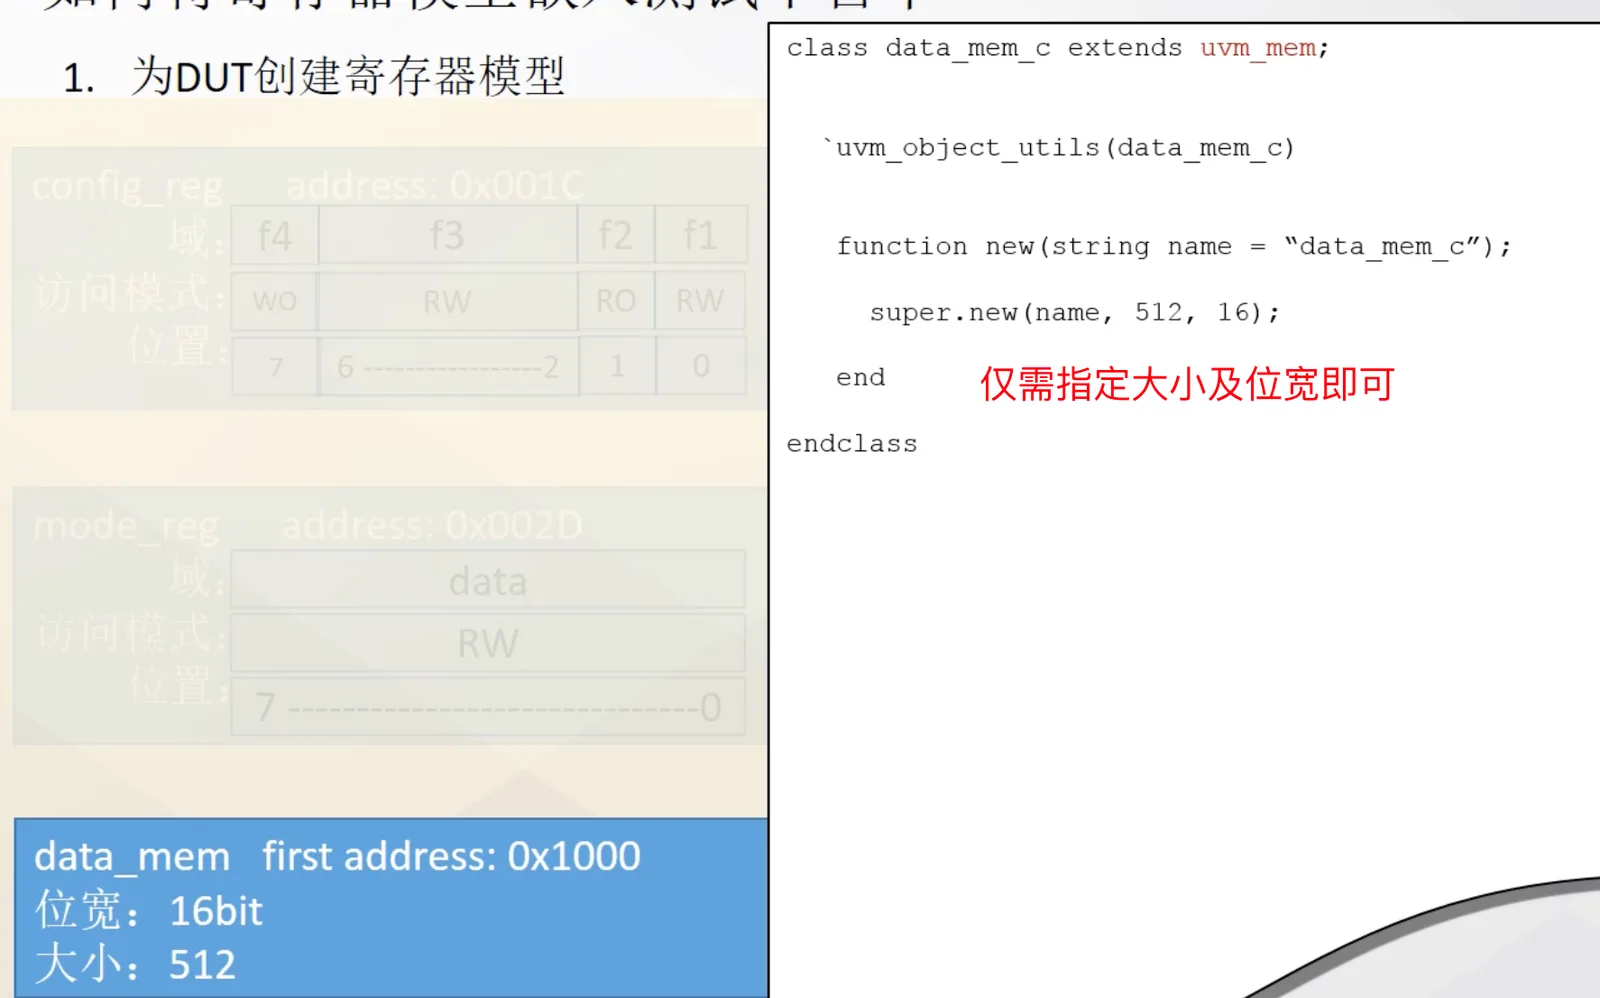
存储器模型需要从uvm_mem类拓展(与寄存器不同)
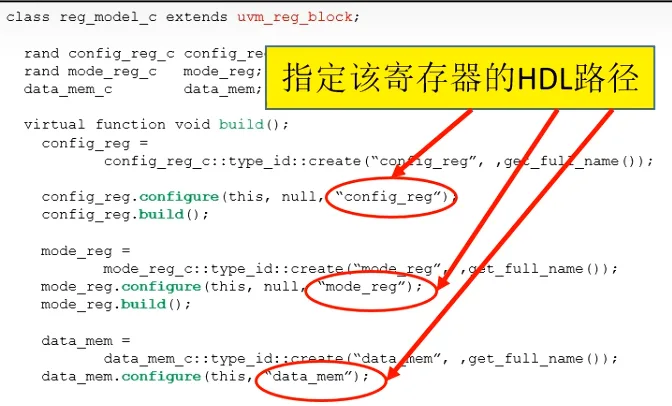
2.uvm_reg_block封装
将三个寄存器封装到一起作为整个寄存器模型(寄存器顶层uvm_reg_block),其中应包含dut中所有寄存器与存储器
1.创建寄存器的对象(factory机制)
2.用configure配置该寄存器属性
- 三个参数(所处寄存器块,寄存器页,寄存器的HDL路径【用于该寄存器的backdoor访问】)
3.调用该寄存器的build函数
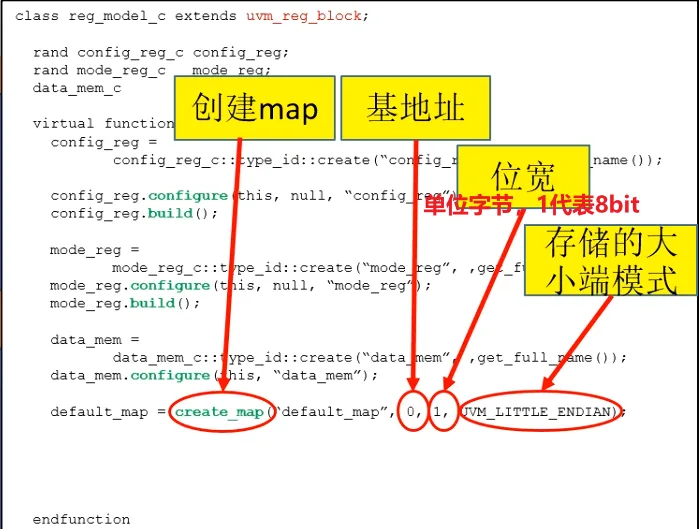
4.create_map函数创建映射
为该寄存器模型创建default_map,使用create_map函数
第一个参数为该map的名字。第三个参数代表系统总线位宽
5.add_reg添加映射
为各个寄存器添加地址映射:
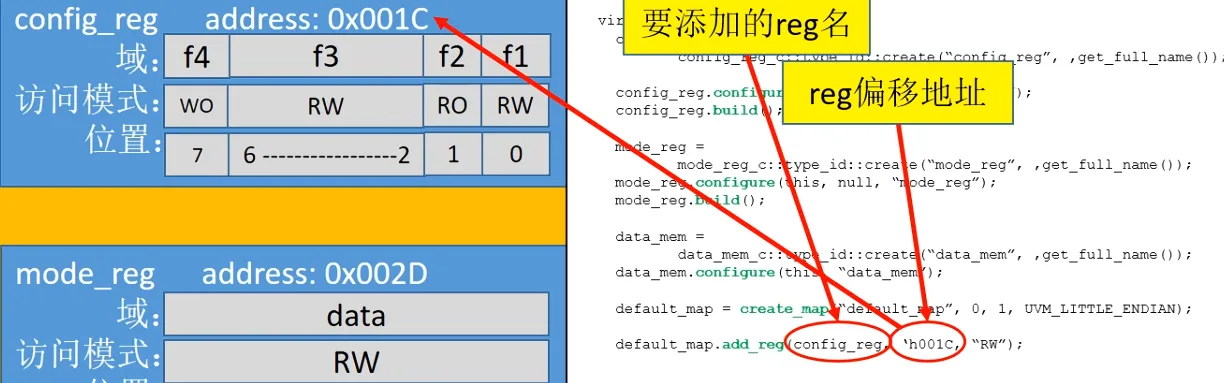
对存储器使用add_mem
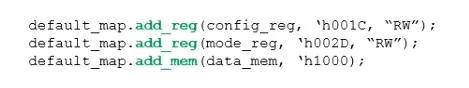
寄存器建模总结:
1.uvm_reg/mem寄存建模
2.uvm_reg_block封装
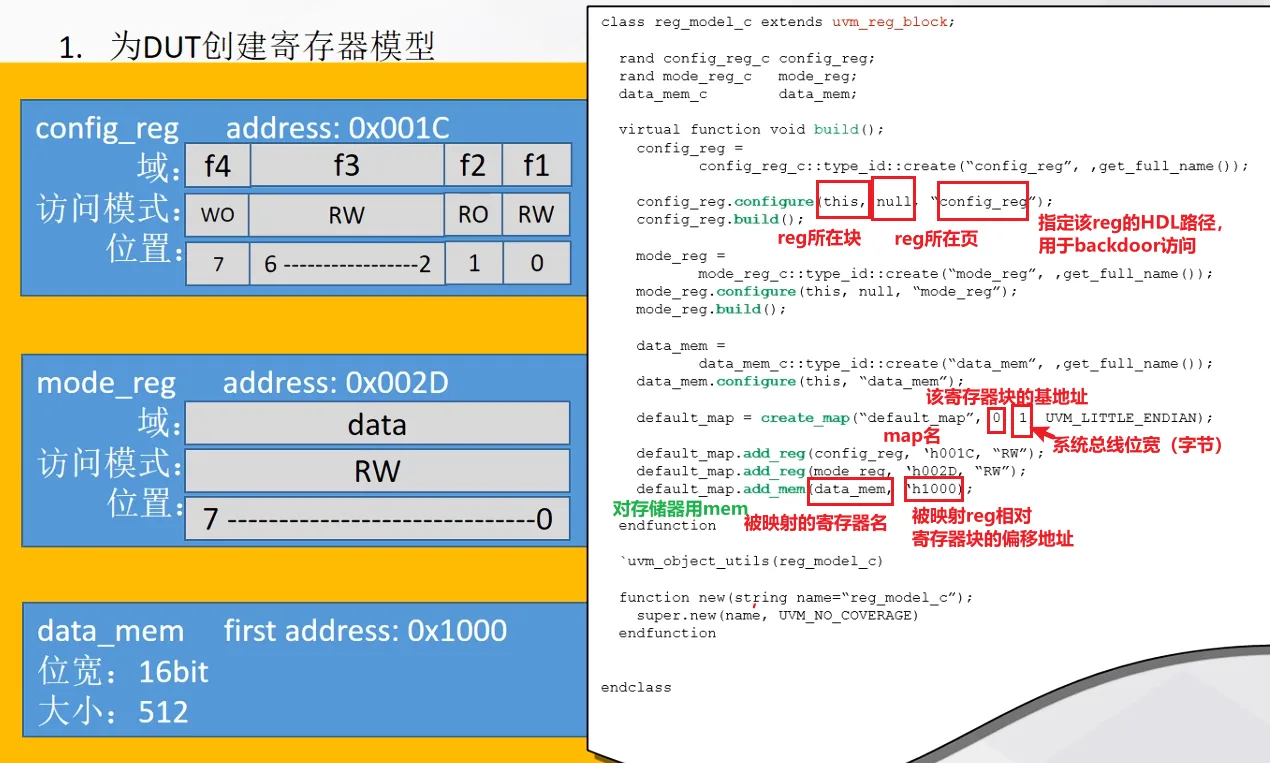
这些地址为以后backdoor操作提供了信息
class reg_model_c extends uvm_reg_block;
    `uvm_object_utils(reg_model_c)

    // Declare registers
    rand config_reg_c config_reg;
    rand mode_reg_c mode_reg;
    data_mem_c data_mem;

    virtual function void build();
        // Create registers
        config_reg = config_reg_c::type_id::create("config_reg");
        mode_reg = mode_reg_c::type_id::create("mode_reg");
        data_mem = data_mem_c::type_id::create("data_mem");

        config_reg.configure(this, null, "config_reg");
        mode_reg.configure(this, null, "mode_reg");
        data_mem.configure(this, "data_mem");

        // Configure registers
        config_reg.build();
        mode_reg.build();
        data_mem.build();

        // Add registers to the block
        this.add_reg(config_reg,'h001C, "RW");
        this.add_reg(mode_reg, 'h002D, "RW");
        this.add_mem(data_mem, 'h1000);

        // Set the address map
        this.create_map("default_map", 0, 1, UVM_LITTLE_ENDIAN);

        function new(string name = "reg_model_c");
            super.new(name, UVM_NO_COVERAGE);
        endfunction
endclass
2.创建Adapter
uvm提供uvm_reg_adapter基类可供拓展
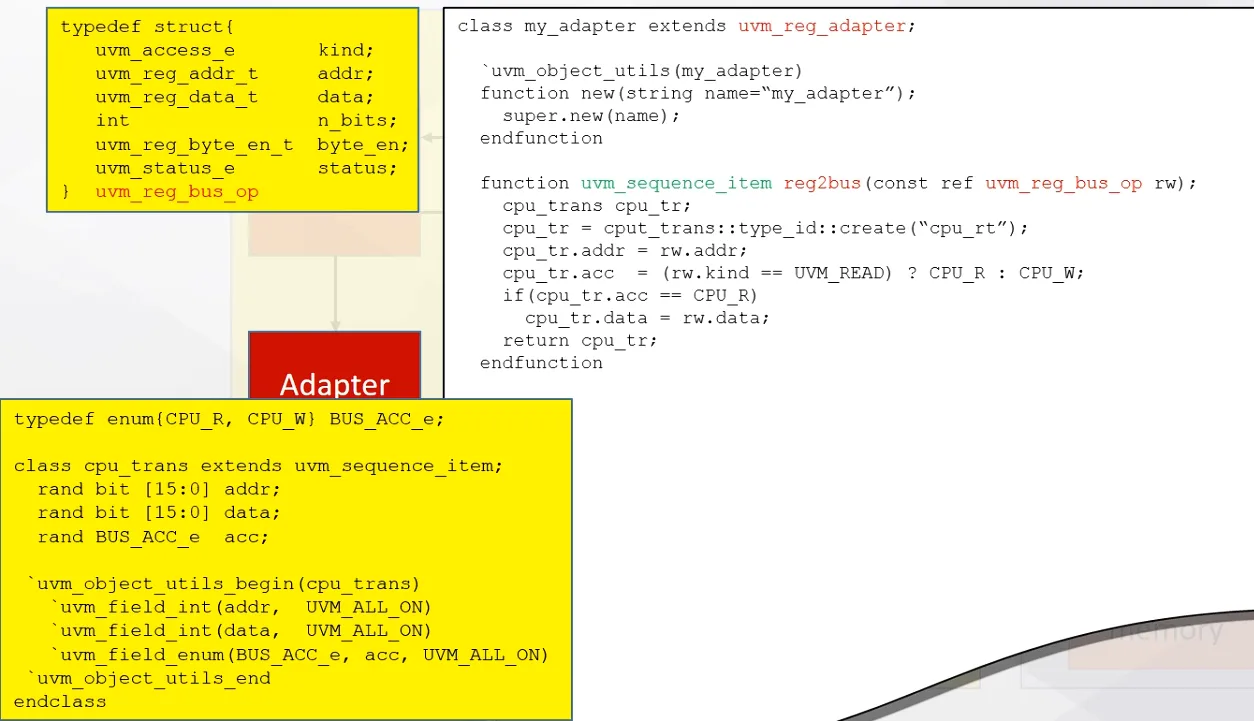
reg2bus函数
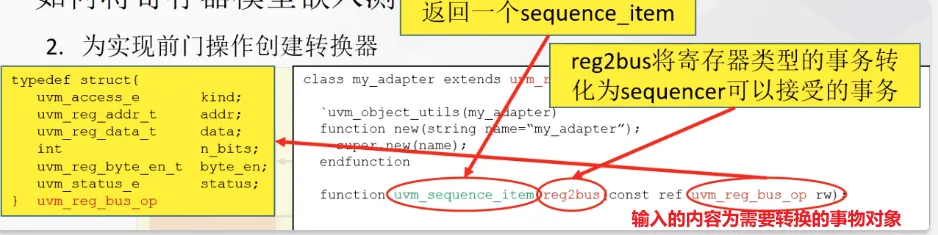
假设自定义的事务类名为 cpu_trans,其中包含了地址,数据,读写控制等 转换的过程就是对cpu_trans类中变量赋值的过程。
注意是function uvm_seuquence_item,返回类型为用户自定义类型
bus2reg函数
注意是function void,没有返回类型(只是翻译一下)
3.在测试平台中实例化两者并连接
调用build函数的过程就是层层创建寄存器模型中各个寄存器和存储器对象的过程
在env中连接
reg model连接sqr和adapter(set_sequencer静态函数)
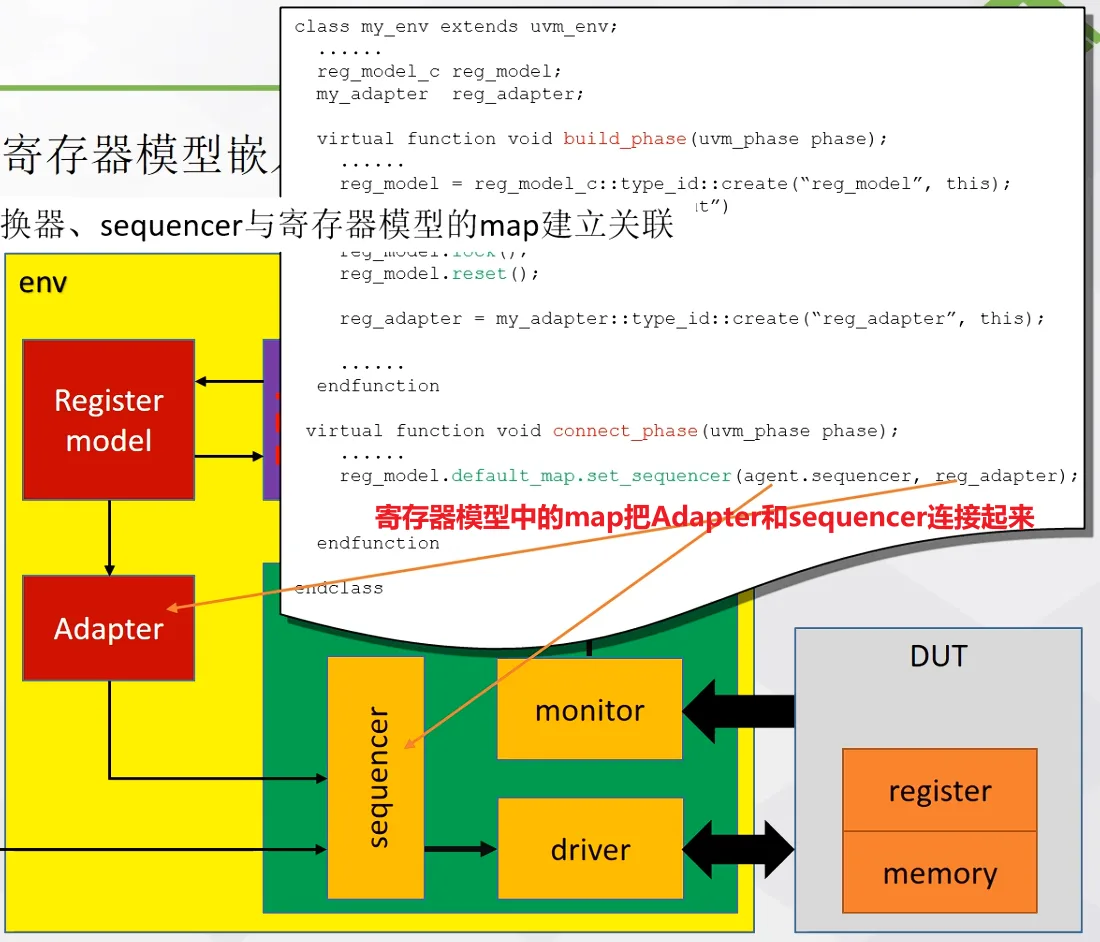
把 RAL map 接到 SPI sequencer 和 adapter:
m_reg_mdl.default_map.set_sequencer(spi_agent.transaction_seqr, reg_adpt);set_auto_predict
最后,开启寄存器模型自动预测功能
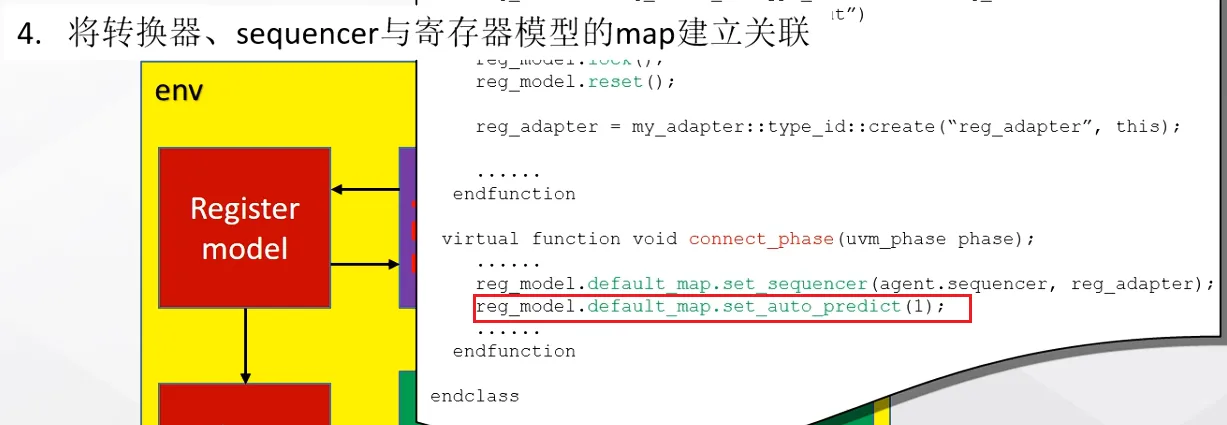
4.访问
在scb中访问寄存器 需要在scb中也例化寄存器模型,使用这个句柄来引用env中的寄存器模型
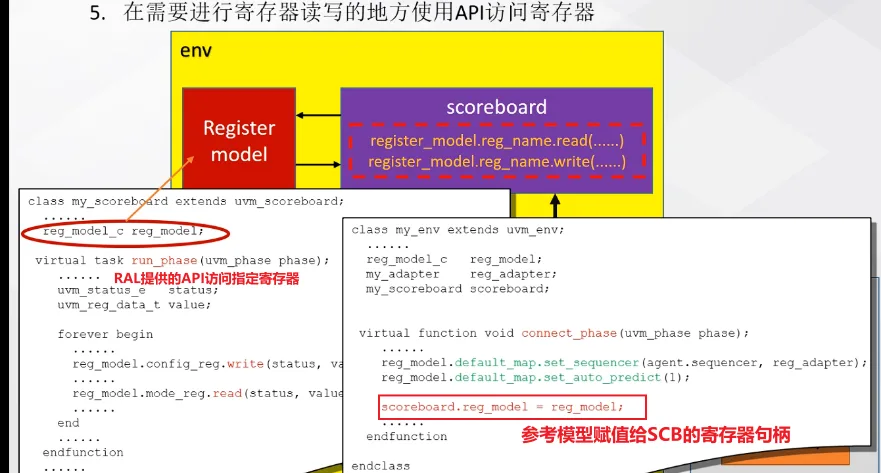
scb中创建寄存器模型句柄,env中将寄存器模型句柄赋值给scb中的句柄
五.模型的基本数据结构
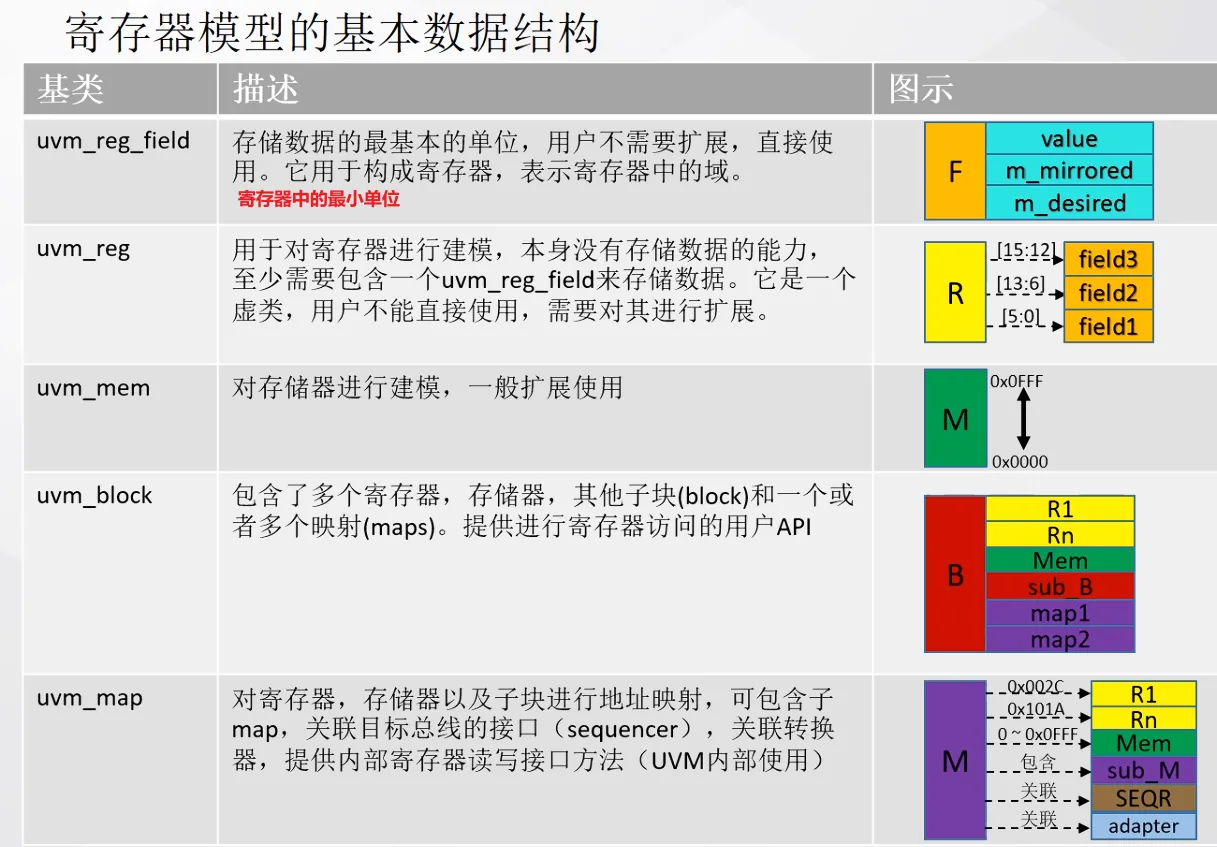 uvm_map:在env层级reg_model.defalut_map.ser_sequencer(agent.sequencer, reg_adapter)
- 在uvm_reg_block封装层级赋值的defalut_map
uvm_reg_field中,有三个用于存储数据的变量:
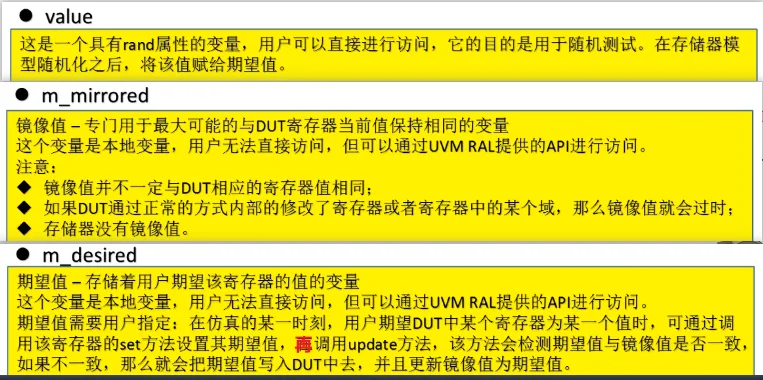
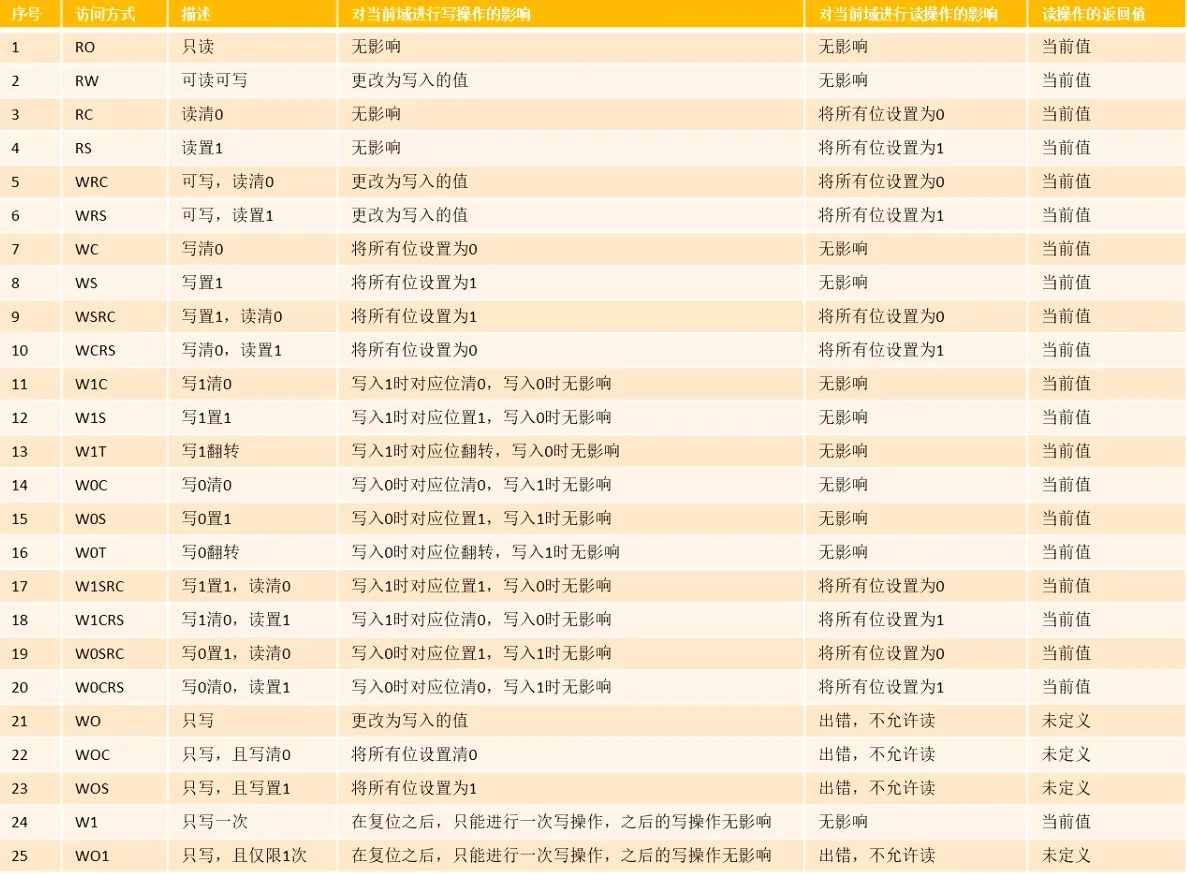
寄存器的访问模式
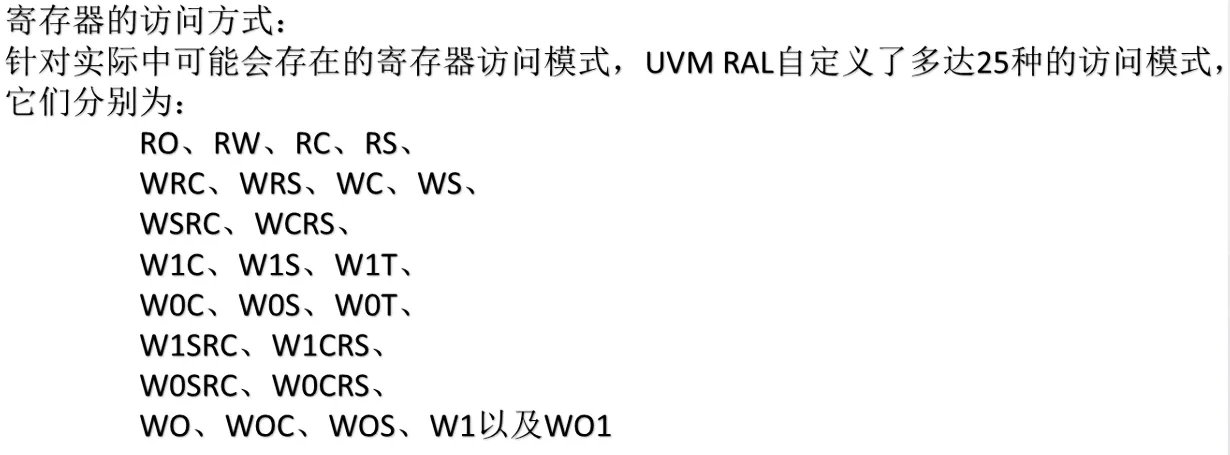
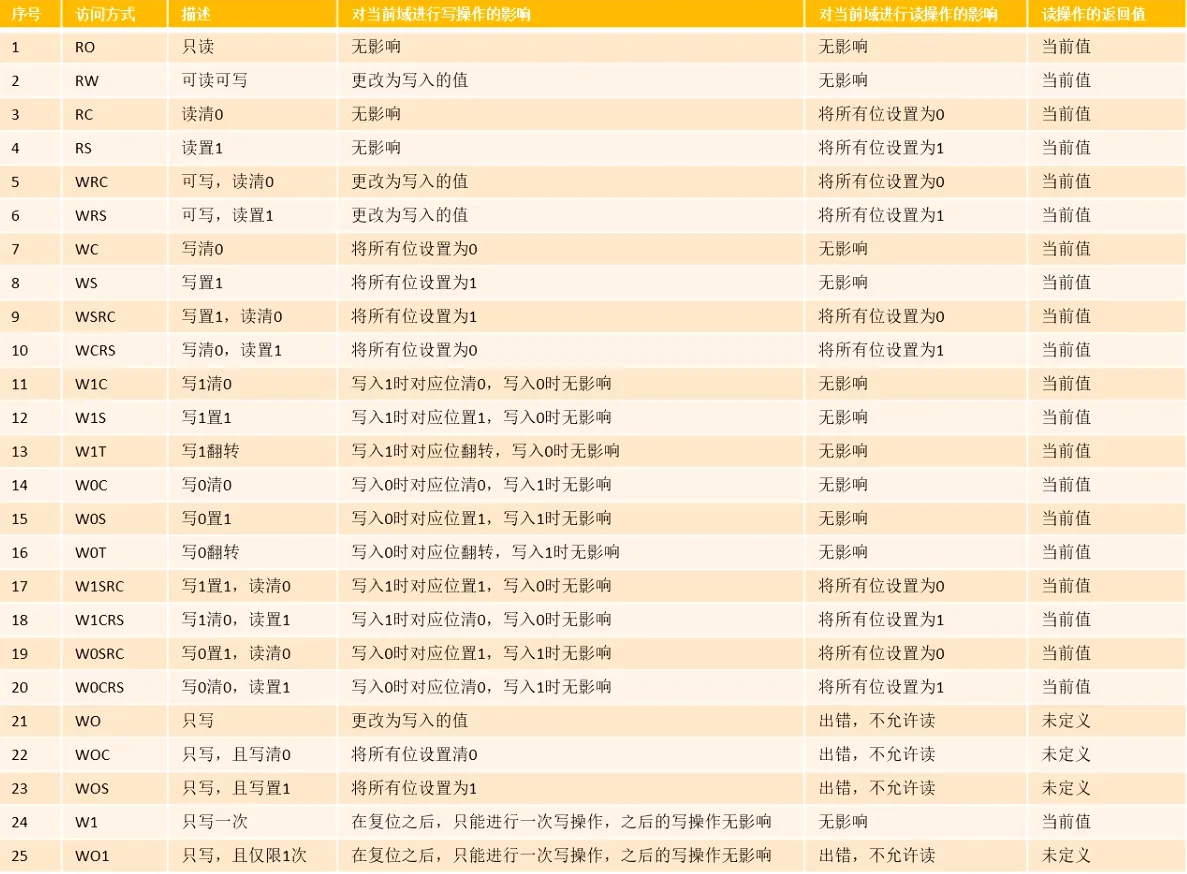
六.寄存器模型API
1.read & write
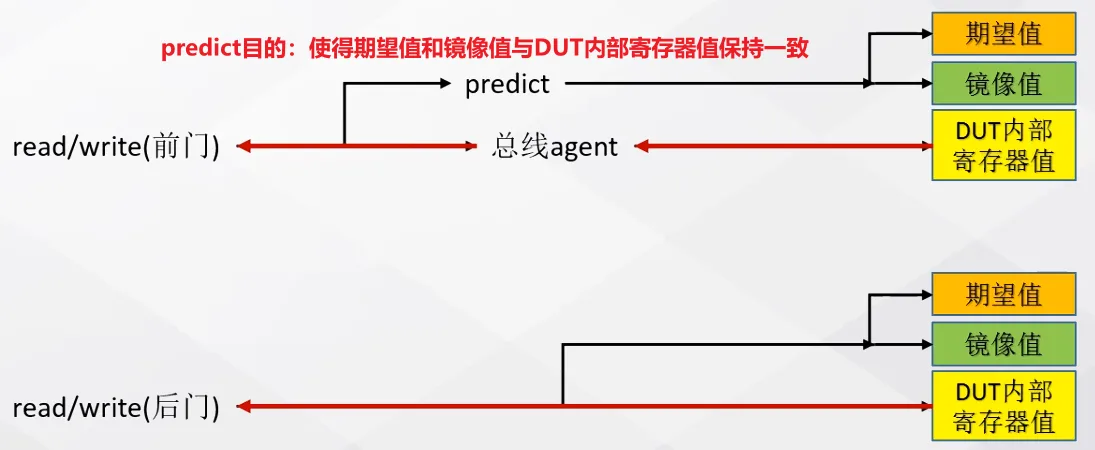
上半部分是前门访问:read/write经过总线agent读写DUT里的寄存器,并由predict更新寄存器模型里的期望值和镜像值。下半部分是后门访问:不经过总线agent,直接读写DUT寄存器,期望值和镜像值也跟着更新。
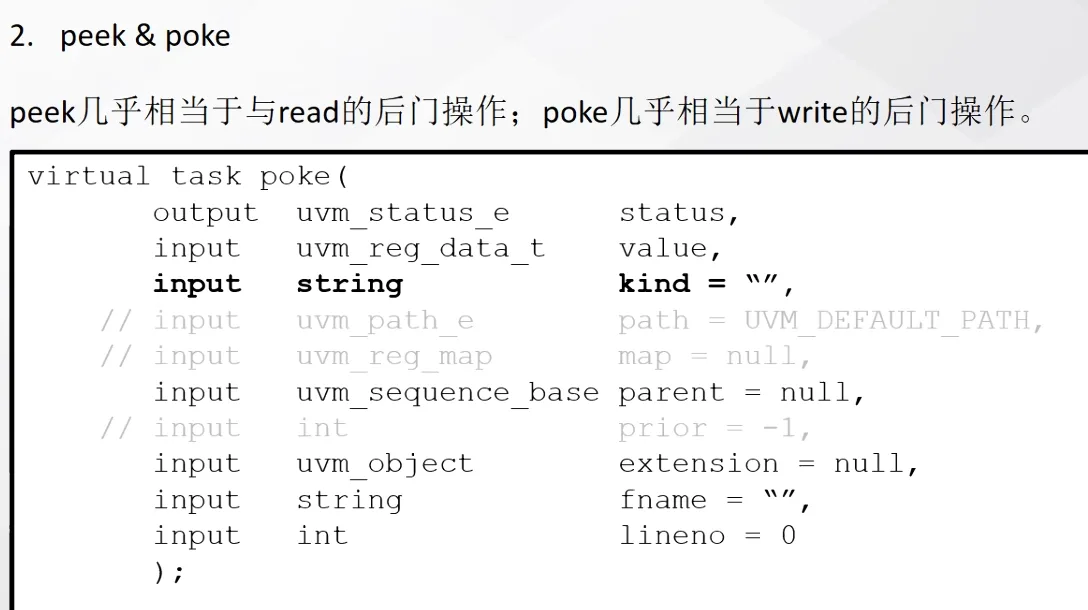
2.peek & poke
几乎等价于read & write backdoor模式
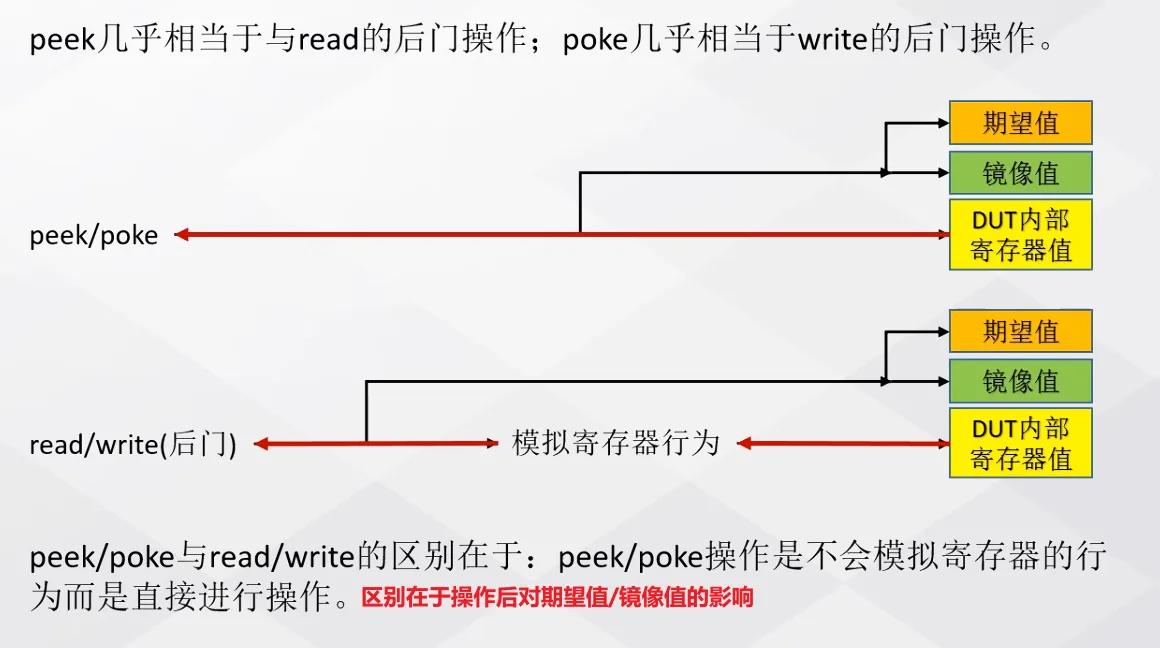
举例:若进行WC写(写入5)清零操作(对DUT写后,寄存器值清零)
- write进行WC写dut值、写5之后,期望值和镜像值均为0
- poke的dut值为0,但期望值和镜像值均为5(poke没有模仿寄存器行为,所以两者均为写入的值)
write操作模拟了该寄存器的写清除属性,而poke没有
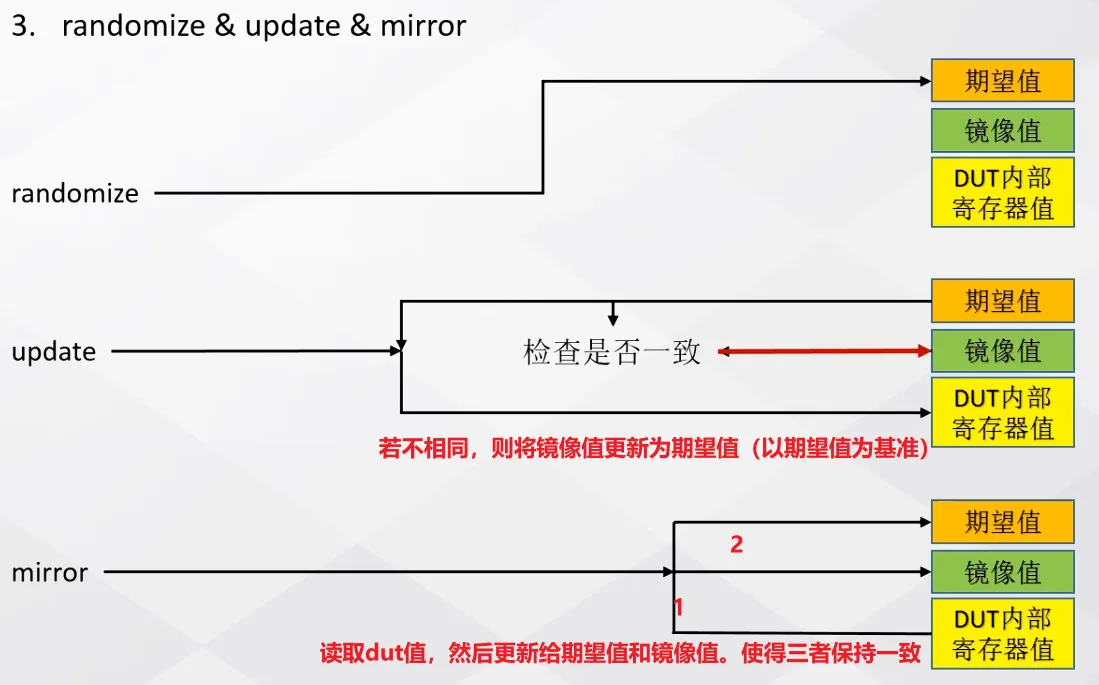
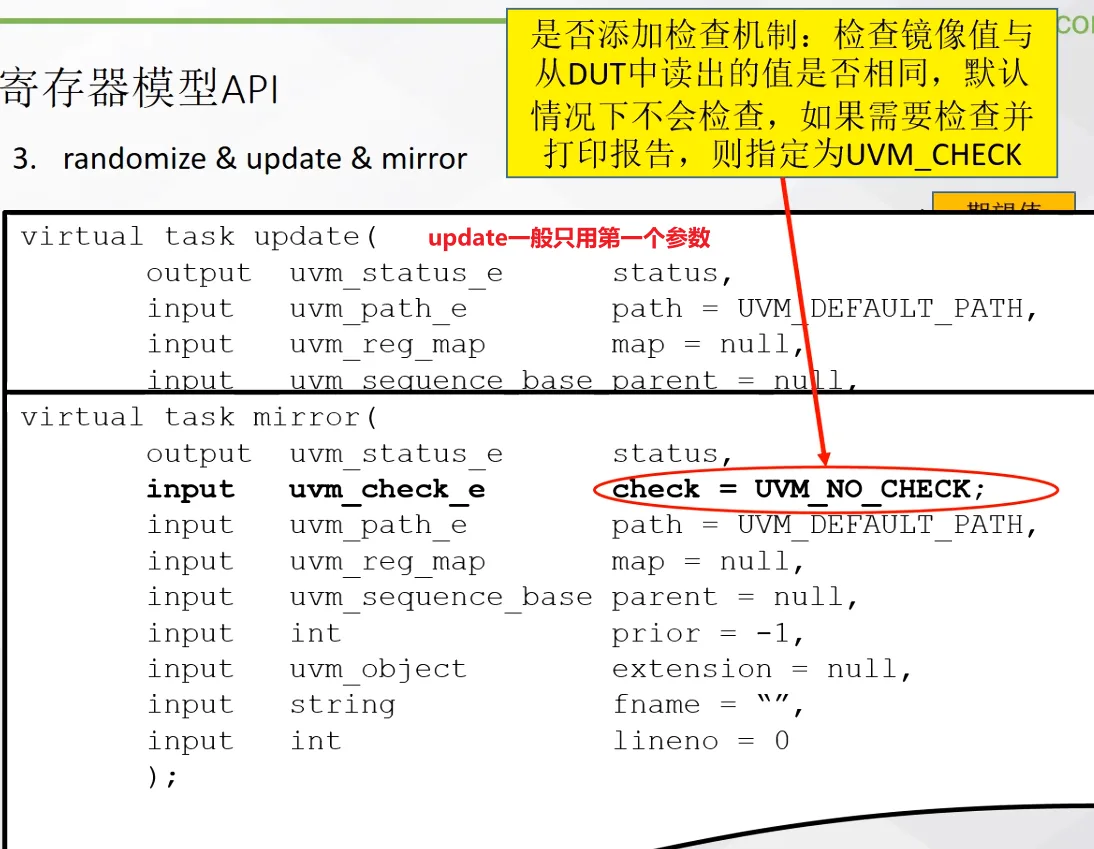
3.randomize & update & mirror
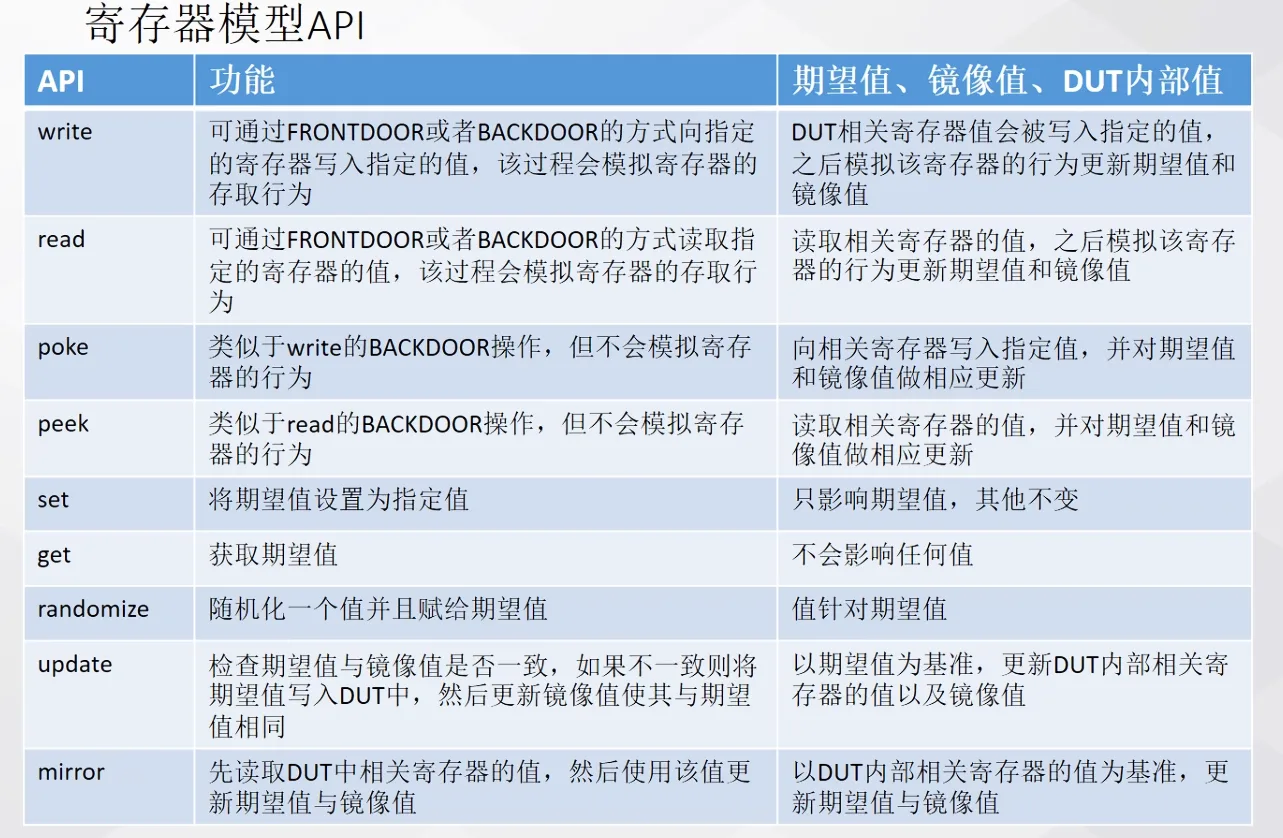
4.RAL 常用API
write函数参数
第三个参数指定:frontdoor or backdoor模式
第五个参数指定句柄:发送item时,指定该ietm所在sequence的句柄,一般情况下,如果在某一sequence中调用该函数,指定该参数为this
7-9参数极少使用
read的参数列表和write完全相同
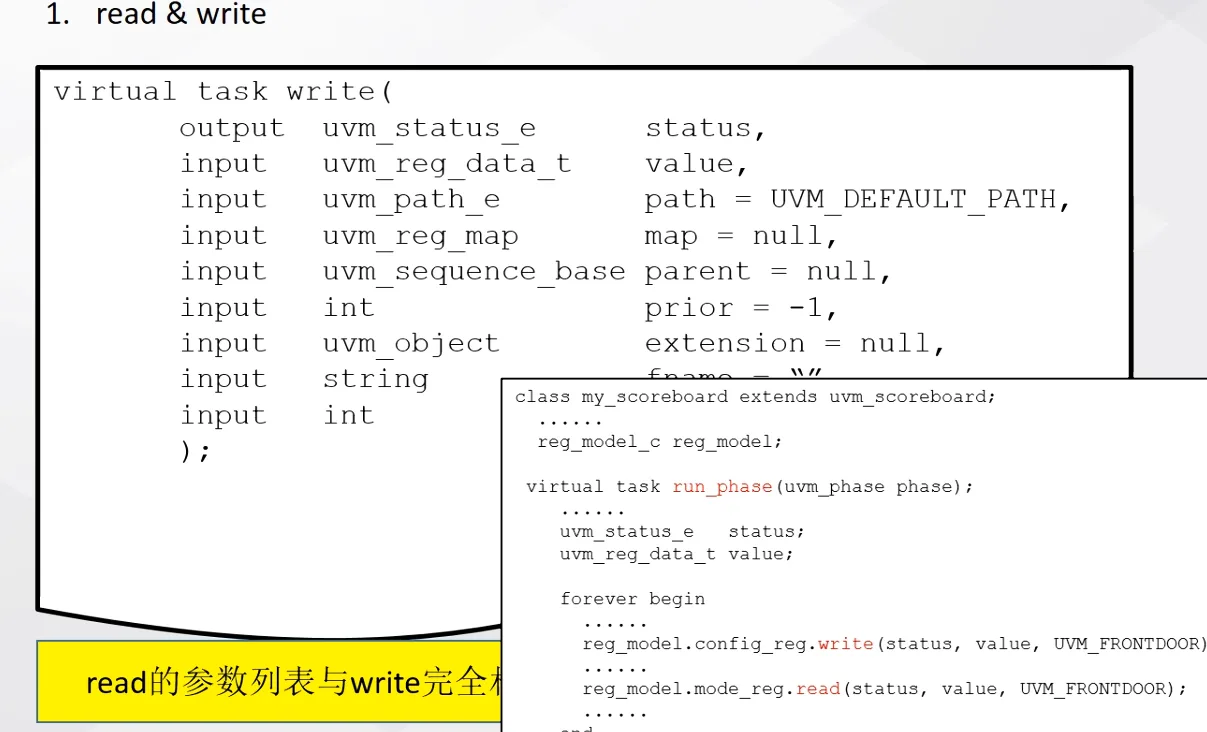 一般只使用前三个参数
update及mirror参数列表
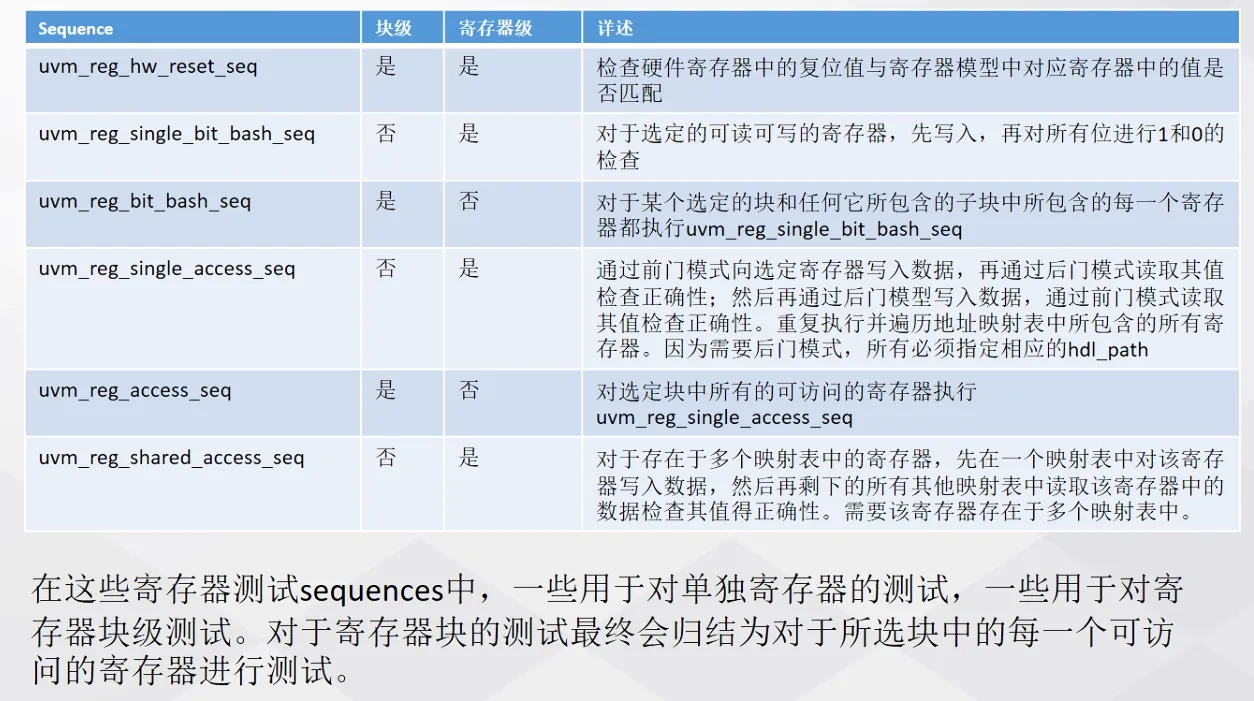
七.内建寄存器测试sequences
- 基于寄存器模型的自动测试的sequences库
- 这些sequences可以对DUT中的寄存器和存储器进行基本的测试
- 自动测试主要是针对基本功能的测试,包括检查寄存器的复位值是否正确、读写数据路径是否正常工作等等(转换/检查每一位/前门和后门访问模式/存储器活动)
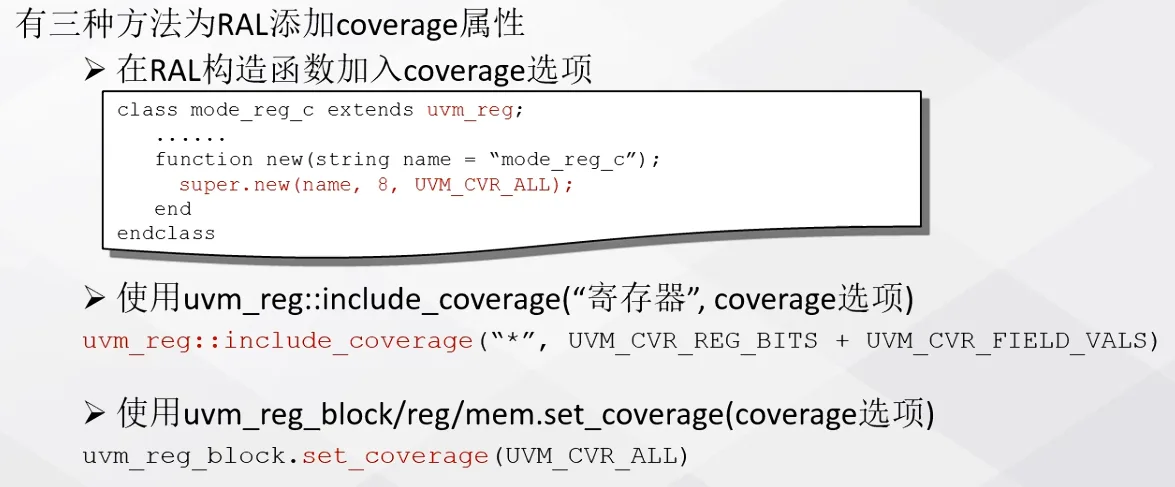
八.内建coverage
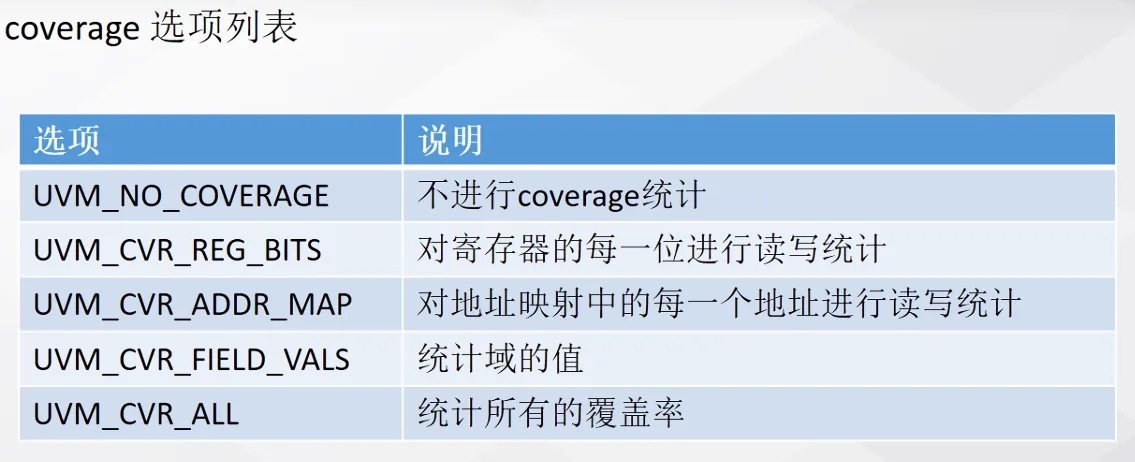
RAL具有内建的coverage来帮助用户实现寄存器测试的覆盖率统计。
三种方法打开RAL coverage属性
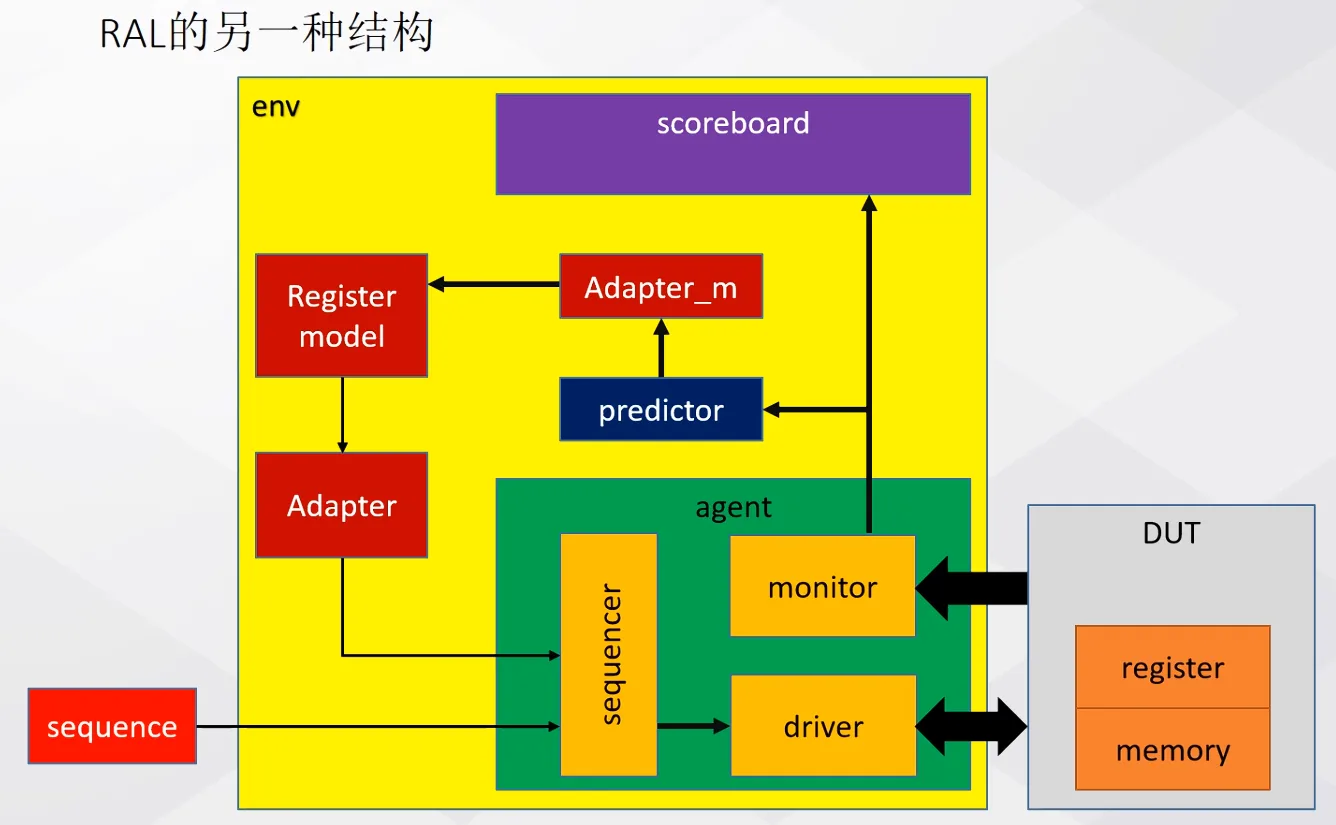
九.RAL的另一种结构(补充)
当driver只能单向 向dut传输数据,而不能接收数据时,则需要predictor来接收monitor读取的dut输出寄存器相关数据。中间同样需要Adapter_m来转换数据
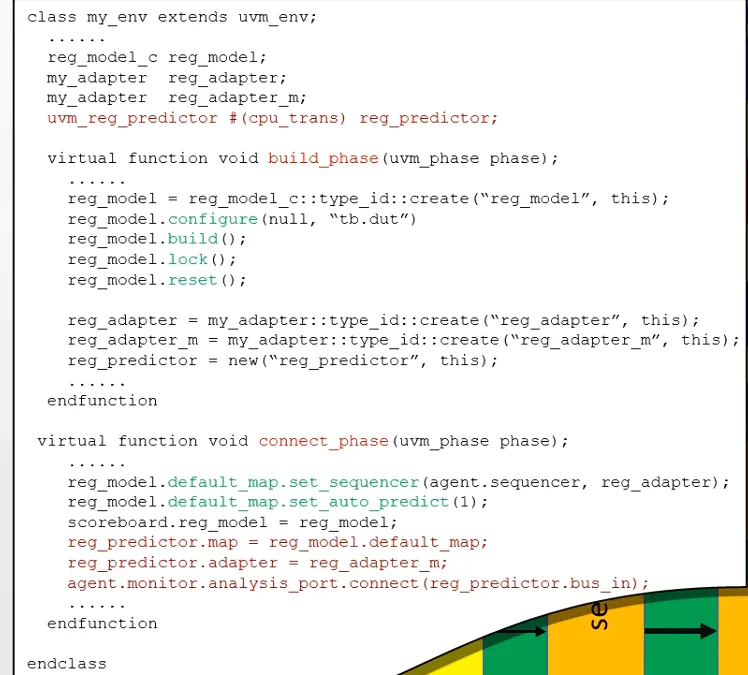
图中同时打开了set_auto_predict(1)和显式的uvm_reg_predictor。用了predictor(显式预测)时一般保持auto predict关闭(默认值),否则每次前门访问会被预测两次。
总结
- 什么是RAL?
- RAL的工作原理
- 如何构建RAL模型
- 如何嵌入RAL到UVM
- 使用RAL API对DUT模型进行访问
2. 覆盖率
以下内容参考0329
代码覆盖率
代码覆盖率最终的结果用于 衡量所有testcase执行了设计中的多少代码。关注点在设计代码的分析上,而不是测试平台。
功能覆盖率
验证的目的: 确保设计在实际环境中的行为正确。
功能描述文档详细说明了设计应该如何运行,而验证计划则列出了相应的功能应该如何激励、验证和测量。
若某个功能在设计中被遗漏,代码覆盖率不能发现这个错误,但是功能覆盖率可以
Covergroup触发方式:
sample直接触发
covergroup ck;
    ...
endgroup

ck.sample();
使用事件触发
event  trans_ready;

covergroup CovPort @(trans_ready);
	coverpoint ifc.cb.port;
endgroup
covergroup cg_dut_reg_ap;
cp_xxx_dut_blcg: coverpoint blcg_enable{
option.auto_bin_max=2;}功能覆盖率详解:
bins 是把信号可能的取值范围分成的“桶/分类”,用于统计哪些值(或值区间)被命中
所有的covergroup的覆盖率构成了整体的功能覆盖率。
bin是衡量功能覆盖率的基本单位,bin的数量就是覆盖率统计的分母
SV会默认自动为某个coverpoint创建bin,用户也可以自己定义bin的采样域。用户可以通过covergroup的选项auto_bin_max来指定自动创建bin的最大数目。实际操作中,自动创建bin的方法不实用,建议用户自行定义bin,或者减小auto_bin_max的数值。
covergroup covport;
	option.auto_bin_max = 8; // // 为整个covergroup设置自动生成bin的最大数量
	coverpoint tr.port {
		option.auto_bin_max = 2; // 为特定coverpoint设置自动生成bin的最大数量
	}
endgroup注意:option是SystemVerilog 预定义在 covergroup 或 coverpoint 中的一个特殊配置接口,不是变量名
常用的option设置:
1.option.auto_bin_max:设置自动生成的bin的最大数量。 2.goal:设置覆盖率目标,默认是100%。 3.weight:设置covergroup的权重,用于综合覆盖率计算。 4.option.at_least —— 单个bin的数值最少的采样次数
- 可以在covergroup中声明来影响所有的coverpoint,也可以在coverpoint中声明来只影响该coverpoint下所有的bin。 5.option.per_instance = 1;
翻转覆盖率
左边是起始值,右边是目标值。每当port; 信号发生从左边的值到右边的值的变化时,相关的bin就会被命中。
bins t1 = {(0 => 1), (0 => 2), (0 => 3)}; // = > 符号


//wildcard统计翻转覆盖率
wildcard bins even = {3'b??0};
wildcard bins odd = {3'b??1};
忽略 / 非法 bin
对于那些不计算功能的域值可以使用ignore_bins来排除,最终它们并不会计入coverpoint的覆盖率。
bit [2:0] low_ports_0_5; // 只使用数值0-5
covergroup CoverPort;
	coverpoint low_ports_0_5 {
		ignore_bins hi = {[6,7]}; // 忽略数值6-7
	}
endgroup


或者 illegal_bins hi = {[6,7]}; // 如果出现6-7便报错
交叉覆盖率
coverpoint是记录单个变量或者表达式的观 测值。如果像记录在某一时刻,多个变量之间值的组合情况,需要使用交叉(cross)覆盖率。
-
cross语句只允许带coverpoint或者简单的变量名。
covergroup CovPort; kind: coverpoint tr.kind; port: coverpoint tr.port; cross kind, port; endgroup -
排除部分 cross bin
忽略的是组合,而不是单个值
cross kind, port {
    ignore_bins hi = binsof(port) intersect {7}; //忽略当 port == 7 的组合。
    ignore_bins md = binsof(port) intersect {0} && binsof(kind) intersect {[9:11]}; //且kind在[9:11]范围内
    ignore_bins lo = binsof(kind.lo); //忽略 kind 中名为 lo 的 bin。表示之前在 kind 这个 coverpoint 里定义过一个 bin 叫 lo,现在在 cross 中选择忽略它。
}
endgroup-
binsof(port)表示portcoverpoint 中所有的 bin -
intersect {7}表示从中选出值为 7 的 bin
精细化的交叉覆盖率
class Transaction;
	rand bit a, b;
endclass

covergroup CrossBinsofIntersect;
	a: coverpoint tr.a
		{ type_option.weight=0; } // Don’t count this coverpoint
	b: coverpoint tr.b
		{ type_option.weight=0; } // Don’t count this coverpoint
	ab: cross a,b
		{ bins a0b0 = binsof(a) intersect {0} && binsof(b) intersect {0};
			bins a1b0 = binsof(a) intersect {1} && binsof(b) intersect {0};
			bins b1 = binsof(b) intersect {1};
       }
endgroup
单个实例的覆盖率
如果对一个covergroup例化多次,那么默认情况下SV会将所有实例的覆盖率合并到一起。如果需要单独列出每个covergroup实例的覆盖率,则需要设置覆盖选项。
covergroup CoverLength;
	coverpoint tr.length;
	option.per_instance = 1;
endgroup
覆盖次数限定
• 默认情况下,数值采样了1次就可以计入有效的bin。可以通过修改at_least来修改每个bin的数值最少的采样次数,如果低于at_least数值,则不会被计入bin中。
• option.at_least可以在covergroup中声明来影响所有的coverpoint,也可以在coverpoint中声明来只影响该coverpoint下所有的bin。
也可以设置覆盖率目标option.goal = 90;
表格查询:
uvm_info安全等级
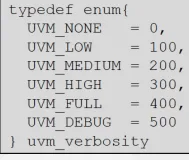
uvm_info的verbosity设置
1. 在base_test中设置
src/ch3/section3.4/3.4.1/base_test.sv

virtual function void connect phase(uvm phase phase);
    	env.i_agt.drv.set_report_verbosity_level (UVM_HIGH) ;
endfunction
2. 设定单个组件的verbosity
set_report_verbosity_level只对某个特定的component起作用
env.i_agt.set_report_verbosity_level_hier(UVM_HIGH)

+uvm_set_verbosity=component_name,id,verbosity,phase_name,optional_time
将设置特定的component下指定ID的verbosity

example:
+uvm_set_verbosity=*,my_dut_cmn_func,UVM_HIGH,time,0
3. 在命令行中设置verbosity
<sim command> +UVM_VERBOSITY=UVM_HIGH


---
举例:
+UVM_VERBOSITY=UVM_NONE  +UVM_TESTNAME=my_dut_base_test  +UVM_MAX_QUIT_COUNT=10  -ucli -i $VERIF_HOME/test/dump.do

设置日志详细级别为 UVM_NONE,即不输出任何信息(除非是致命错误或错误)。

指定运行的 UVM 测试为 my_dut_base_test。

设置最大退出次数为 10 次,即允许最多 10 次退出条件。

启用 UCLI 模式,允许通过命令行与仿真交互。

执行位于 $VERIF_HOME/test/dump.do 的仿真脚本,该脚本包含一系列仿真命令
重载所有组件/ID的severity
<sim command> +uvm_set_severity=<comp>,
<id>,
<current severity>,
<new severity>

+uvm_set_severity=*,
register_fail:AMBA:AXI3:araddr_4k_boundary_cross_active_check,
UVM_ERROR,
UVM_WARNING + uvm_set_severity=*,
register_fail:AMBA:AXI3:awaddr_4k_boundary_cross_active_check,
UVM_ERROR,
UVM_WARNING

若araddr id触发,则设置其UVM_ERROR提高为UVM_WARNING,且awaddr ID一并设置
uvm继承关系
UVM phase
task phase(黄色)会消耗仿真时间,橙色为function phase不消耗仿真时间
Sequence仲裁机制
UVM RAL 寄存器访问权限
UVM常见函数:
$urandom_range
tmp0_addr = $urandom_range**(`min , max`)指定tmp0_addr的数值范围
$test$plusargs
- 检查命令行参数中是否包含指定的参数名,而不关心参数的值
if($test$plusargs("REG_INCR_RANDOM"))...$test$plusargs 会检查仿真时传入的参数中是否包含 REG_INCR_RANDOM 这个标志。一般配合if条件使用
if(uvm_hdl_check_path(pathA))
检查检查仿真层次中,是否存在名为pathA的信号或实例路径。如果存在 → uvm_hdl_check_path() 返回1,否则0。
$value$plusargs
- 与
$test$plusargs类似,但它不仅检查参数是否存在,还可以获取并赋值该参数的值。
$value$plusargs("RUN_TIMES=%0d", run_times)%0d表示占位符,十进制整数的格式; 比如:查找到命令行参数 RUN_TIMES=123,并将值 123 赋给 run_times 变量。
访问类型
ro (Read Only): 只读字段,写入操作不会改变其值
ru (Read Only, Unsigned): 只读无符号字段
rw (Read Write): 可读可写字段
w1c (Write 1 to Clear): 写1清零字段,向该字段写入1会清除相应位
wo (Write Only): 只写字段,无法读取其值
rw1c (Read Write, Write 1 to Clear): 可读可写,但写1会清零
rc (Read to Clear): 读取即清零字段
$cast
$cast 是 SystemVerilog 中的一个内置操作符,用于安全地将对象指针转换为目标类型。它不是 UVM 定义的方法,而是普普通SV语法。$cast 操作符用于对象指针类型的转换
$cast(destination, expression); //expression:源变量$cast(rsp,req.clone());req.clone()克隆了req事务,产生一个新的事务对象。
$cast(rsp, req.clone())将克隆的事务对象req.clone()赋值给rsp,并且进行类型转换/检查,确保rsp能够接收req.clone()。
try_next_item和get_next_item的区别
try_next_item(req):这是一个非阻塞操作。作用是从sequencer中获取transaction
get_next_item(req):这是一个阻塞操作。~
try_next_item一般用于@(posedge hst_drv_if.clk);耗时语句中配合使用,后者则组合逻辑
文件操作
$fopen
file_descriptor = $fopen("filename", "mode");file_descriptor:返回的文件描述符,存储该文件的句柄,用于后续操作
-
“mode”:指定文件打开的模式。常用的模式包括:
-
“r”:以只读模式打开文件。
-
“w”:以写入模式打开文件(如果文件已存在,会清空内容)。
-
“a”:以追加模式打开文件。
$feof
$feof(file_descriptor);
系统任务,用于检查文件是否已经到达末尾。通常与文件操作任务(如 $fopen 和 $fclose)一起使用。
$fgets
$status = $fgets(line, file_descriptor);$fgets 会从文件中读取一行文本,并将其存储在 line 变量中,包括换行符(行末的换行符会被包含在读取的内容中)。
UVM
uvm_is_match
uvm_is_match(pattern, string);

if(uvm_is_match("*M_CLIENT_*",split_line_s[i+1])) begin检查第一个参数(模式)是否与第二个参数(目标字符串)匹配。可以将其理解为一种类似正则表达式的模式匹配工具。
uvm_hdl_read
uvm_hdl_read(string path, output type variable);
uvm_hdl_read 是 UVM 验证环境提供的 DPI 接口调用函数,在仿真过程中,可以跨层次、跨模块访问 DUT 里的任意信号,就像“动态观察”一样。这个函数用于从硬件设计中读取信号或寄存器值的函数。
- 举例
uvm_hdl_read({"tb_top.u_my_dut",".","DUT_APERTURE_NUM"}, aperture_num);通过 uvm_hdl_read() 从硬件设计中读取 tb_top.u_my_dut 中的 DUT_APERTURE_NUM 信号的值,并将该值存储到 aperture_num 变量中
uvm_hdl_force
//将信号 **`tb_top.rstn_df`** 强制为 **`0`**
uvm_hdl_force("tb_top.rstn_df", 1'b0);


//将rstn_df强制赋值为1,即使设计中的其他逻辑尝试修改它。10个延迟周期后,release它
uvm_hdl_force("tb_top.rstn_df", 1'b1);
p_sequencer.delay_clocks(10);
uvm_hdl_release("tb_top.rstn_df");
uvm_send
等价于以下两个函数的结合版
start_item(tr) - 向sequencer申请发送transaction的权限
finish_item(tr) - 完成transaction的发送,并等待driver处理完成
uvm_info
uvm_info(“label”, $sformatf(“...”), UVM_LOW);
普通的 uvm_info 语句通常是直接传递字符串作为 message,并且没有额外的格式化操作.
- 使用了
$sformatf函数来格式化message,允许根据变量的值动态生成消息内容
uvm_report_fatal
用于报告 致命错误,即在 UVM 仿真中,遇到此方法时会生成一个错误报告并终止仿真
uvm_report_fatal(string id, string message, uvm_report_object reporter = null);

inst.uvm_report_fatal("my_dut_regmodel", "Can not create inst twice");

reporter(可选):指定报告的发出者,通常是一个对象。在大多数情况下,可以使用 null,表示没有特定的报告发出者。
type_id::create()两个参数
my_component = my_component_type::type_id::create(“my_component”, parent_component);
uvm_callbacks
uvm_report_fatal
uvm_fatal 是 uvm_report_fatal 的简化版本,通常用于简单的致命错误报告,而 uvm_report_fatal 提供了多一个verbosity选项,而uvm_fatal省略了这个选项
peek()与poke()
一般用于寄存器reset check
peek()与poke()是后门访问的函数,peek几乎相当于与read的后门操作;poke几乎相当于write的后门操作。
peek()原理是从一个mailbox中拷贝一个消息但不会将其从队列中删除。如果mailbox是空的,那么当前的进程会阻塞直到一个消息被放置到mailbox中。如果在消息变量和mailbox中的消息间存在类型不匹配,那么会产生一个运行时错误。
这两个后访函数完全不管DUT的行为。如对一个只读的寄存器进行写操作,不会模拟DUT的行为,使用该类函数可以写进去
foreach(all_regs[i]) begin
				all_regs[i].peek(status,act_data);//status 和 act_data 是 peek 操作的输出参数,表示从寄存器中读取的值。
    exp_data = all_regs[i].get_reset();//获取 all_regs[i] 寄存器的复位值,并将其存储在 exp_data 变量中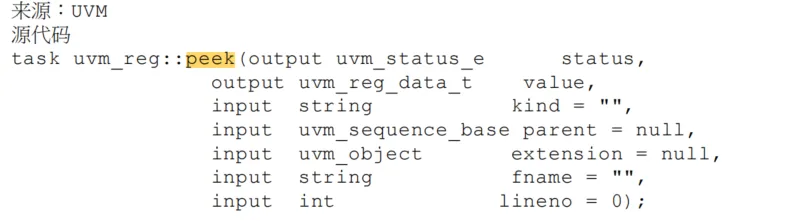
get_reset()
获取某种reset类型(kind参数)的reset值,如果不存在该reset类型,则返回m_desired(期望值)
exp_data = all_regs[i].get_reset();//获取 all_regs[i] 寄存器的复位值,并将其存储在 exp_data 变量中constraint约束
dist
 constraint constraint_name {
     constraint_target dist {1:=B_RATE, 0:=100-B_RATE};
    };
假设 B_RATE 设置为 70,那么:
constraint_target = 1的概率为 70%constraint_target = 0的概率为 30%
dist2
wvalid_delay[idx] dist {
            0 := ZERO_DELAY_wt,
            [1:(VM_CLIENY_AXI_MAX_WVALID_DELAY >> 3)] :/ SHORT_DELAY_wt, //1/8 of maximum delay
            [((VM_CLIENY_AXI_MAX_WVALID_DELAY >> 3)+1):VM_CLIENY_AXI_MAX_WVALID_DELAY] :/ LONG_DELAY_wt
};-
[1:(VM_CLIENY_AXI_MAX_WVALID_DELAY >> 3)] :/ SHORT_DELAY_wt,: 这一行定义了 短延迟范围:从 1 到VM_CLIENY_AXI_MAX_WVALID_DELAY >> 3(最大延迟的 1/8)。 -
:/表示 范围内共享同一个权重,即这个范围内的值出现的概率总权重为SHORT_DELAY_wt,在区间中均匀分布。
solve … before
主要用于 控制约束的求解顺序
constraint c_window {
    solve aperture_size_r before win_addr_r;
}
aperture_size_r 的值会在 win_addr_r 之前被确定(即在约束求解时,aperture_size_r 会首先被随机化)。
makefile
总览
这个 makefile 做四件事:
编译 comp -> 仿真 sim -> 覆盖率 merge/cov -> 清理 clean/cleanallmake all 负责编译和仿真。
make cov 负责合并并打开覆盖率报告。
但覆盖率数据必须先通过 COV=1 的仿真生成。
1. testcase 与覆盖率开关
TESTNAME ?= order_data_add_test

COV?=0
ifeq (${COV},1)
  COV_COMP_OPT= -cm line+cond+fsm+branch+tgl -cm_dir ./coverage/sim_${TESTNAME}.vdb -cm_hier ./cov.cfg
  COV_SIM_OPT= -cm line+cond+fsm+branch+tgl -cm_dir ./coverage/sim_${TESTNAME}.vdb -cm_name ${TESTNAME}
else
  COV_COMP_OPT=
  COV_SIM_OPT=
endifTESTNAME:当前运行的 UVM testcase,默认是order_data_add_test。COV:覆盖率开关,默认0,即不生成覆盖率。COV=1时,编译和仿真都会加上覆盖率选项。
覆盖率类型:
line    行覆盖率
cond    条件覆盖率
fsm     状态机覆盖率
branch  分支覆盖率
tgl     toggle 翻转覆盖率
覆盖率数据库路径:
./coverage/sim_${TESTNAME}.vdbmake cov 不会跑 testcase。
它只 merge 已经存在的 coverage/*.vdb。
如果没有先用 COV=1 跑仿真,就会报 No source data。
2. include 路径与随机种子
INC_DIR =  +incdir+../tb/interface
INC_DIR += +incdir+../tb/env
INC_DIR += +incdir+../tb/seq
INC_DIR += +incdir+../tb/tests
INC_DIR += +incdir+../tb/top

seed = $(shell date +%H%M%S)INC_DIR:告诉 VCS 去哪些目录找`include "xxx.sv"文件。seed:用当前时间生成随机种子,后面传给+ntb_random_seed。
+incdir+ 只影响 include 文件搜索路径。
真正参与编译的源文件仍然来自 -f ../tb/top/rtl.f 和命令行里的 ../tb/top/tb_top.sv。
3. all:默认流程
all:comp simall 依赖 comp 和 sim。
所以执行 make all 时,流程是:
先编译 -> 再仿真4. comp:编译
comp:
	-mkdir -m 777 ${TESTNAME}_sim_dir
	vcs -full64 -sverilog -kdb -q -debug_access+all -ntb_opts uvm -timescale=1ns/1ns \
	${COV_COMP_OPT} ${INC_DIR} +define+DUMP_FSDB=1 \
	-l ${TESTNAME}_sim_dir/comp_${TESTNAME}.log \
	-f ../tb/top/rtl.f \
	-top tb_top ../tb/top/tb_top.sv
这一段调用 VCS 编译 testbench 和 DUT。
关键选项:
-sverilog          使用 SystemVerilog
-ntb_opts uvm      打开 UVM 支持
-debug_access+all  保留调试信息
-kdb               生成 Verdi 调试数据库
-timescale=1ns/1ns 设置时间单位/精度
${COV_COMP_OPT}    COV=1 时加入覆盖率编译选项
${INC_DIR}         include 搜索路径
+define+DUMP_FSDB  打开 FSDB dump 的宏
-l                 编译 log
-f                 文件列表
-top tb_top 指定顶层 module-mkdir 前面的 - 表示:即使命令失败也继续往下执行。
常用于目录已存在的情况。
5. sim:仿真
sim:
	-mkdir ${TESTNAME}_sim_dir
	./simv ${COV_SIM_OPT} -l ${TESTNAME}_sim_dir/sim_${TESTNAME}.log +ntb_random_seed=${seed} \
	+TESTNAME=${TESTNAME} +UVM_TESTNAME=${TESTNAME}
这一段运行编译生成的仿真可执行文件 simv。
关键点:
./simv              启动仿真
${COV_SIM_OPT}      COV=1 时加入覆盖率仿真选项
-l                  仿真 log
+ntb_random_seed    随机种子
+UVM_TESTNAME       指定 UVM testcase
+TESTNAME 给 testbench/report 使用的普通 plusarg真正决定跑哪个 test 的是 +UVM_TESTNAME=${TESTNAME}。
例如 TESTNAME=burst_nodelay_add_test 时,UVM factory 会创建这个 test。
6. verdi:看波形
verdi:
	verdi -ssf tb.fsdb -simflow -simBin ./simv &
作用:打开 Verdi,加载 tb.fsdb 波形和 simv 仿真信息。
-ssf tb.fsdb    加载 FSDB 波形
-simBin ./simv  关联仿真可执行文件
&               后台运行
7. 覆盖率 merge 与查看
merge.vdb:
	urg -full64 -format both -dir ./coverage/*.vdb -dbname merge.vdb

cov: merge.vdb
	firefox urgReport/dashboard.html &
	verdi -cov -covdir merge.vdb &
merge.vdb target:
读取 ./coverage/*.vdb
用 urg 合并成 merge.vdb
同时生成 urgReport 覆盖率报告
cov target:
先确保 merge.vdb 已生成
再打开 HTML 报告
再用 Verdi 打开覆盖率数据库每个 testcase 先生成自己的 sim_${TESTNAME}.vdb。
urg 再把多个 .vdb 合并成 merge.vdb。
项目签核通常看 merge 后的总覆盖率。
7.1 跑testcase 后生成什么
例如执行:
make all COV=1 TESTNAME=order_data_add_test
make all COV=1 TESTNAME=random_data_add_test
会重点生成这些文件/目录:
sim/run/
├── simv
├── simv.daidir/
├── result_sim.log
├── order_data_add_test_sim_dir/
│   ├── comp_order_data_add_test.log
│   ├── sim_order_data_add_test.log
│   └── order_data_add_test.fsdb
├── random_data_add_test_sim_dir/
│   ├── comp_random_data_add_test.log
│   ├── sim_random_data_add_test.log
│   └── random_data_add_test.fsdb
└── coverage/
    ├── sim_order_data_add_test.vdb/
    └── sim_random_data_add_test.vdb/
路径来自 makefile:
-cm_dir ./coverage/sim_${TESTNAME}.vdb
-l ${TESTNAME}_sim_dir/comp_${TESTNAME}.log
./simv ... -l ${TESTNAME}_sim_dir/sim_${TESTNAME}.log编译是否成功:${TESTNAME}_sim_dir/comp_${TESTNAME}.log
仿真是否通过:${TESTNAME}_sim_dir/sim_${TESTNAME}.log 和 result_sim.log
波形:${TESTNAME}_sim_dir/${TESTNAME}.fsdb
单个 testcase 覆盖率库:coverage/sim_${TESTNAME}.vdb/
此时还没有总覆盖率报告。还需要执行:
make cov之后才会生成:
merge.vdb/
urgReport/dashboard.html
对应 makefile:
urg -full64 -format both -dir ./coverage/*.vdb -dbname merge.vdb
firefox urgReport/dashboard.html &
verdi -cov -covdir merge.vdb &coverage/sim_${TESTNAME}.vdb/ 是单个 testcase 的覆盖率数据库。
merge.vdb/ 是多个 testcase merge 后的总覆盖率数据库。
urgReport/dashboard.html 是总覆盖率 HTML 入口。
8. 清理规则
clean:
	rm -rf csrc simv simv.* *.fsdb .**solver_cache**
	rm -rf novas* ucli.key vc_hdrs.h

cleanall:clean
	rm -rf coverage merge.vdb urgReport vdCovLog
rm -rf verdiLog *.log *_sim_dirclean:清掉编译产物、仿真可执行文件、波形、临时文件。cleanall:在clean基础上,再清覆盖率、报告、log、各 testcase 目录。
cleanall 会删除 coverage/、merge.vdb、urgReport/。
如果还没保存覆盖率结果,不要随手执行。
9. mg:只 merge 覆盖率
.PHONY: mg
mg: merge.vdb
mg 只触发 merge.vdb,不会打开 firefox 或 Verdi。
适合只想重新合并覆盖率、不想打开 GUI 的时候。
常用执行流程
不看覆盖率,只跑一个 test
make cleanall
make all TESTNAME=order_data_add_test
跑一个 test 并看覆盖率
make cleanall
make all COV=1 TESTNAME=order_data_add_test
make covmake cov 报 coverage/*.vdb could not be found,说明还没有生成覆盖率数据库。
先用 COV=1 跑至少一个 testcase。
assert断言
一.作用域由所在位置决定
SVA的作用域不是整个UVM验证环境,而是它被放进的那个静态容器。
以NPU项目的assert_check.sv为例,它自己不是独立作用域——被`include进testtop.sv:196,等于文本原样粘进module testtop:
testtop.sv:25    module testtop;
testtop.sv:196       `include "assert_check.sv"   // ← 粘在这
testtop.sv:235 endmodule : testtop证据是文件里裸写的信号,如dbg_out/ex_clk/dbg_if都不带任何路径,而这三个正是testtop自己声明的(testtop.sv:40 / 35 / 79)。换个module粘贴就编不过。
位置决定的是名字解析,不是能查的范围。同一行里可以两种混用:
dbg_if.db_sel == 'h0 |-> (dbg_out === testtop.DUT.sys_clk)
//  ↑ 本层裸写                ↑ 绝对层次路径,伸进DUT内部
二.并发断言能放在哪
assert property(并发断言)只能待在静态、被elaborate出来的容器里。
| 容器 | 能放并发SVA | 说明 |
|---|---|---|
module | ✅ | NPU项目的testtop走的这条 |
interface | ✅ | 最常用,协议断言跟着接口走 |
checker | ✅ | 专为断言设计的容器,可带形参 |
program | ✅ | 罕见 |
class | ❌ | UVM component全在这,见第三节 |
package | ❌ |
这几种容器的共同特征:编译期就确定了实例数量和层次路径。
写在interface里的样子:
interface apb_if (input logic pclk);
    logic psel, penable, pready;
    // psel拉起后,penable必须在下一拍跟上
    a_setup: assert property (@(posedge pclk) $rose(psel) |=> penable);
endinterface
三.为什么UVM component里不能写
根因一句话:并发断言是elaboration期展开的静态结构,class对象是运行期new出来的动态数据。
断言必须能回答的三个问题,class都答不上来:
| 并发SVA的要求 | class的现实 | |
|---|---|---|
| 何时开始采样 | time 0起常驻,每个时钟沿在preponed region采样 | new()之后才存在,可能第500ns才建 |
| 叫什么名字 | 固定层次路径testtop.dbg_check1 | 只有UVM字符串名,不在设计层次树里 |
| 有几个 | elaboration时确定 | 0个/1个/1000个都可能,还能被回收 |
四.class里做检查用什么
class里放不了并发断言,但能放立即断言(immediate assertion)——没有property、没有时钟,执行到那一行时求一次值:
class npu_scoreboard extends uvm_scoreboard;
    task compare(npu_txn t);
        assert (t != null) else `uvm_fatal("SB", "null txn");   // ✓ 合法
        if (t.result !== golden)
            `uvm_error("SB", $sformatf("got %0d exp %0d", t.result, golden))
    endtask
endclass

assert (req.randomize() with { addr inside {[0:1023]}; });      // ✓ 最常见用法
1.三类检查的分工
| 要查什么 | 放哪 | 工具 |
|---|---|---|
| 跨周期时序/协议关系(req拉起后3拍内必须gnt) | interface / module | 并发SVA |
| transaction级数据正确性(算出来的数对不对) | scoreboard(class) | uvm_error + 比对 |
| 单点前提(句柄非空、randomize成功) | 任意class方法 | 立即assert() |
2.立即断言和if的区别
功能上if能替代,但工具看它们完全不同:
assert(e) else ... | if (!e) ... | |
|---|---|---|
| 不写else时 | 自动报$error,带文件名+行号+时间 | 什么都不发生 |
| 运行时批量开关 | $assertoff/$assertkill/VCS -assert disable一键关全部 | 关不掉,只能改代码 |
| 覆盖率 | 被当成断言对象统计,进assertion coverage和收尾summary | 普通代码,工具看不见 |
| formal工具 | VC Formal / JasperGold认它,当proof target | 忽略 |
语义差别:assert声明”这里必须成立,不成立就是bug”;if声明”这里可能不成立,需要处理”。
3.坑:裸assert不进UVM_ERROR计数
assert (t.result == golden);              // 失败 → 只走$error,UVM_ERROR计数不变!
assert (t.result == golden)
else `uvm_error("SB", "mismatch"); // 失败 → UVM_ERROR +1回归脚本判PASS/FAIL靠的是grep日志里的UVM_ERROR :计数。裸assert失败不进这个计数器,那条用例会被判成PASS。
实践结论:UVM里做检查用uvm_error;立即assert基本只在一个地方是标配——assert(req.randomize() with {...});
五.工程上怎么摆
优先级从高到低:
- 写进
interface—— 主流。协议断言跟着接口走,接口复用到哪断言跟到哪(APB/AXI/SPI都这么做) bind注入 —— 要查DUT内部信号又不能改RTL时用。签核flow和formal都靠它- 直接写在testtop —— NPU项目现在这样。快,但最脆
bind的最小例子,RTL一个字不改:
// 断言写在独立module里,端口对着要查的信号
module fifo_sva (input clk, push, full);
    a_no_overflow: assert property (@(posedge clk) full |-> !push);
endmodule

// 一行挂到DUT的每个实例上
bind npu_fifo_512to16 fifo_sva u_sva (.clk(clk), .push(wr_en), .full(full));为什么说第3种脆:testtop.DUT.xxx这种绝对层次路径写错了不报错,只是静默永假。NPU项目就踩过——断言查的dbg_sel1全库零赋值恒为X,前提永假,16条全程空过还显示”通过”。换成bind的具名端口,信号不存在在elaboration阶段就直接编译失败。
六.怎么看断言有没有真的跑
FAILURES = 0不等于断言查过了。真正要看的是REAL SUCCESSES。
VCS要在-cm里带assert才收集:-cm tgl+branch+line+cond+fsm+assert,报告在cov_report_all/asserts.txt。
NPU项目的实测数据:
Total Number      18   100.00
Success           16    88.89
Failure            0     0.00
Without Attempts   2    11.11      ← uvm_reg_map内部那2条,没跑到

testtop.dbg_check0 ATTEMPTS 29,462,172 REAL SUCCESSES 128,2642946万次尝试里只有12.8万次是真的查了,其余99.56%是前提不成立、空过(vacuous)。dashboard上那个ASSERT 100.00不会告诉你这件事。
用cover property覆盖前提本身——同一套SVA语法,不报错而是采集功能覆盖率。NPU项目现在cover property数量为0,这是个缺口。
七.并发SVA语法
以NPU项目fifo_check.sv的FIFO计数守恒断言为例,一条语句用到的全部语法:
a_fifo_cnt_track : assert property (
    @(posedge `RGB_FIFO.clk) disable iff (!`RGB_FIFO.rst_n)
    ##1 `RGB_FIFO.count == $past(`RGB_FIFO.count)
                         + $past(`RGB_FIFO.wr_en && !`RGB_FIFO.full)
                         - $past(`RGB_FIFO.rd_en && !`RGB_FIFO.empty))
    else `uvm_error("SVA_FIFO", $sformatf("计数失配: count=%0d 上拍=%0d",
                    `RGB_FIFO.count, $past(`RGB_FIFO.count)))
1.五个组成部分
| 部分 | 写法 | 作用 |
|---|---|---|
| 标签 | a_fifo_cnt_track : | 不是装饰。覆盖率报告靠它认人,不写就是一串自动生成的乱名 |
| 采样时钟 | @(posedge clk) | 每个上升沿检查一次,所有信号取这一刻的值 |
| 复位屏蔽 | disable iff (!rst_n) | 复位期间不检查。不写的话复位时信号为X会满屏报错 |
| 属性表达式 | ##1 count == ... | 要成立的事 |
| 失败动作 | else uvm_error(…)` | 见第四节坑3,不能用\$error |
disable iff是固定关键字组合,不能写成disable if——编译报错。iff在SV里是独立关键字,还出现在@(posedge clk iff en)和coverpoint x iff (valid),这几处也都只能iff。
2.$past 与 ##1
$past(x)取上一个采样沿的x值,是断言表达跨周期关系的基础##1放在开头 = 从第二拍才开始检查。因为第一拍没有”上一拍”,$past取不到有效值
计数守恒这条读作:这一拍的count,必须等于上一拍的count,加上上一拍真正写进去的个数,减去上一拍真正读出来的个数。就是一条库存等式:
这次库存 = 上次库存 + 进货 - 出货关键在”真正”两个字——wr_en只是”想写”,不是”写成功了”。看npu_sync_fifo.v的指针逻辑:
:40   end else if (wr_en && !full)  begin ... wr_ptr <= ... end   // 满了就不动
:51 end else if (rd_en && !empty) begin ... rd_ptr <= ... end // 空了就不动所以断言里必须用同样的条件当加减项,否则满时对方发了wr_en、指针没动,断言却期望+1,就会误报:
| 表达式 | 含义 | 值 |
|---|---|---|
$past(wr_en && !full) | 上一拍写成功了吗 | 成功=1,被满挡住=0 |
$past(rd_en && !empty) | 上一拍读成功了吗 | 成功=1,被空挡住=0 |
布尔表达式在算术上下文里自动当0/1用,所以直接拿来加减。
举个数:
       上一拍                        这一拍
$past(count)             = 5
$past(wr_en && !full)    = 1    →   count 必须是 5 + 1 - 0 = 6
$past(rd_en && !empty)   = 0

同时读写、且都成功        + 1 - 1 = 0   →   count 不变
满时想写、同时读成功 + 0 - 1 = -1 → count 必须减13.|-> 与 |=>
full |-> (count == FIFO_DEPTH)          // 同一拍:full为真时,count必须已经等于DEPTH
(full && wr_en) |=> $stable(wr_ptr) // 下一拍:这拍满且要写,下拍wr_ptr不许动| 符号 | 何时查结论 | 用在哪 |
|---|---|---|
|-> | 同一拍 | 组合逻辑(full是assign出来的,与count同拍成立) |
|=> | 下一拍 | 时序逻辑(wr_ptr是寄存器,这拍的写下一拍才看得出动没动) |
4.蕴含式会空过,裸布尔不会
full |-> (count == FIFO_DEPTH)      // 前提为假 → 这拍算通过,但没真查(vacuous)
!(push_full && !push_req_n) // 裸布尔 → 每拍都真查,REAL SUCCESSES = ATTEMPTS写|->就要做好”可能全程空过”的准备,必须去asserts.txt核对REAL SUCCESSES(见第六节)。
NPU项目实测对照,同一个文件里两种写法的差别一眼可见:
a_fifo_full_cnt    (|-> 形式)   ATTEMPTS 674,663   REAL SUCCESSES        0   ← 全程空过
a_fifo_cnt_track   (裸表达式)   ATTEMPTS 674,663   REAL SUCCESSES  674,661
a_ir_async_no_ovf (裸布尔) ATTEMPTS 338,168 REAL SUCCESSES 337,331能写成”任何时候都不许发生”的,优先裸布尔——天然不空过。
只有”某条件下才成立”的规则才用|->,然后盯住REAL SUCCESSES。
前提结构上不可达时(如上例a_fifo_full_cnt),断言保留当守卫、覆盖率里exclude并注明推导,别硬凑激励。
5.层次路径用宏收口
`define RGB_FIFO testtop.DUT.u_npu_top.u_npu_L1_Cache.U_NPU_RGB_RAM_WRAP.u_rgb_fifo一长串路径写十几遍不现实,改层次也只改一处。断言可以引用例化时空接的输出端口——它们仍是实例内部的输出,层次引用取得到。NPU项目的ir_async就是这样:push_full在npu_data_cache_ctrl.v:52空接,断言照样能监控它。把设计者没接出来的信号拿来监控,是断言的一个典型用法。
Discussion
Loading comments…
Checking sign-in…