三条定律分别回答三个问题:
- 一个程序最多能被加速多少(阿姆达尔定律,Amdahl’s Law)
- 晶体管缩小时功耗怎样变化(登纳德缩放,Dennard Scaling)
- 一块芯片上能放多少晶体管(摩尔定律,Moore’s Law)
2005年前后单核性能的增长明显放缓,正是这三条规律共同作用的结果。
三条定律一览
| 定律 | 说明了什么 | 对现代芯片的意义 |
|---|---|---|
| Amdahl’s Law | 加速比受不能并行的部分限制,上限 | 多核收益很快饱和;先优化占时间最多的部分 |
| Dennard Scaling | 尺寸和电压等比例缩小时,功率密度不变 | 约2005年失效:功耗墙,主频停在3–4 GHz,转向多核和专用加速器 |
| Moore’s Law | 单芯片晶体管数约两年翻一番(集成度,不是性能) | 晶体管不再自动换来单线程性能,用于更多核、cache和专用单元 |
Amdahl’s Law
推导
把程序原来的执行时间记为1。其中比例为的部分可以改进,改进后这部分快倍:
- 不能改进的部分照旧,用时;
- 能改进的部分用时从缩短为。
加速比等于改进前的时间除以改进后的时间:
用个处理器并行时,能并行的部分最多快倍,把公式里的换成即可。处理器再多,能并行部分的用时也只能趋近0,分母里始终剩下,所以加速比有上限:
加速比的上限只由不能并行的部分决定:能并行的部分占95%时,处理器再多,加速比也不超过20倍。公式没有计入通信和同步的开销,实测只会更低。
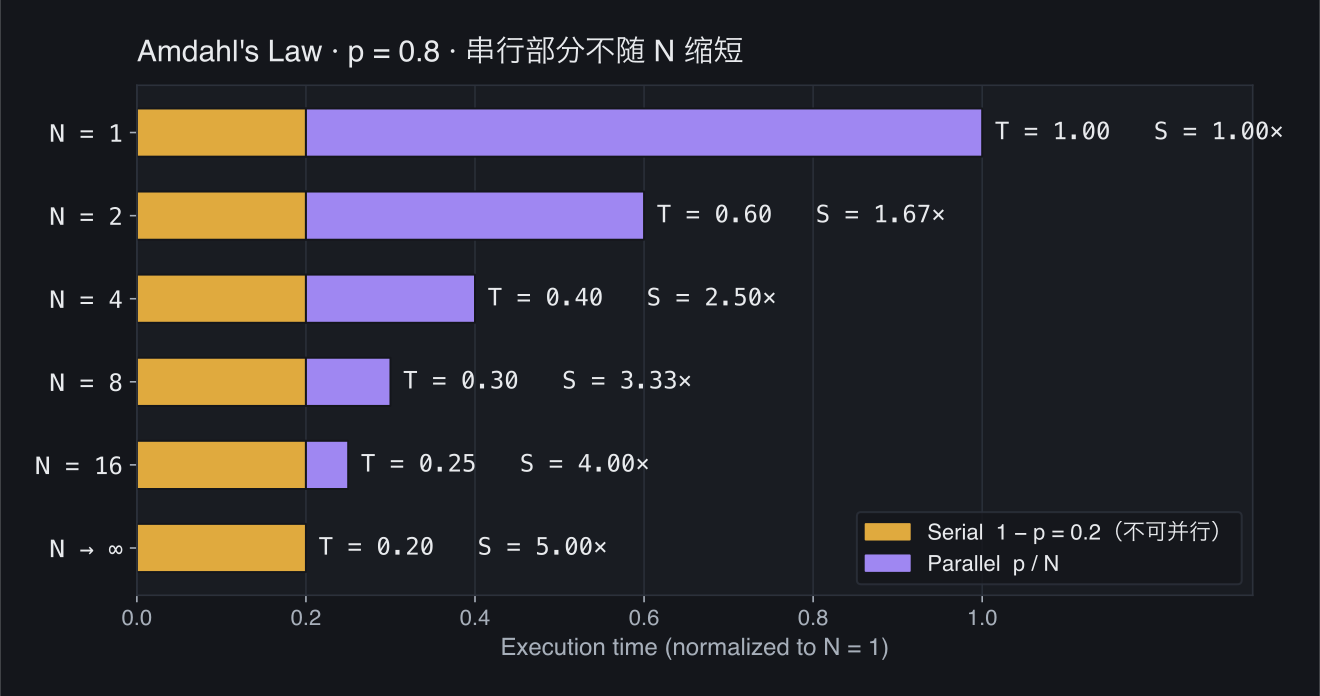
上图按可并行部分占80%计算,每一行是一种处理器数N下的总执行时间(单核为1)。橙色是不能并行的0.2,处理器再多也不变;紫色是能并行的0.8,被N个处理器平分。N从1增加到16,总时间从1降到0.25;再增加处理器,总时间也只能逼近0.2,加速比停在5倍。
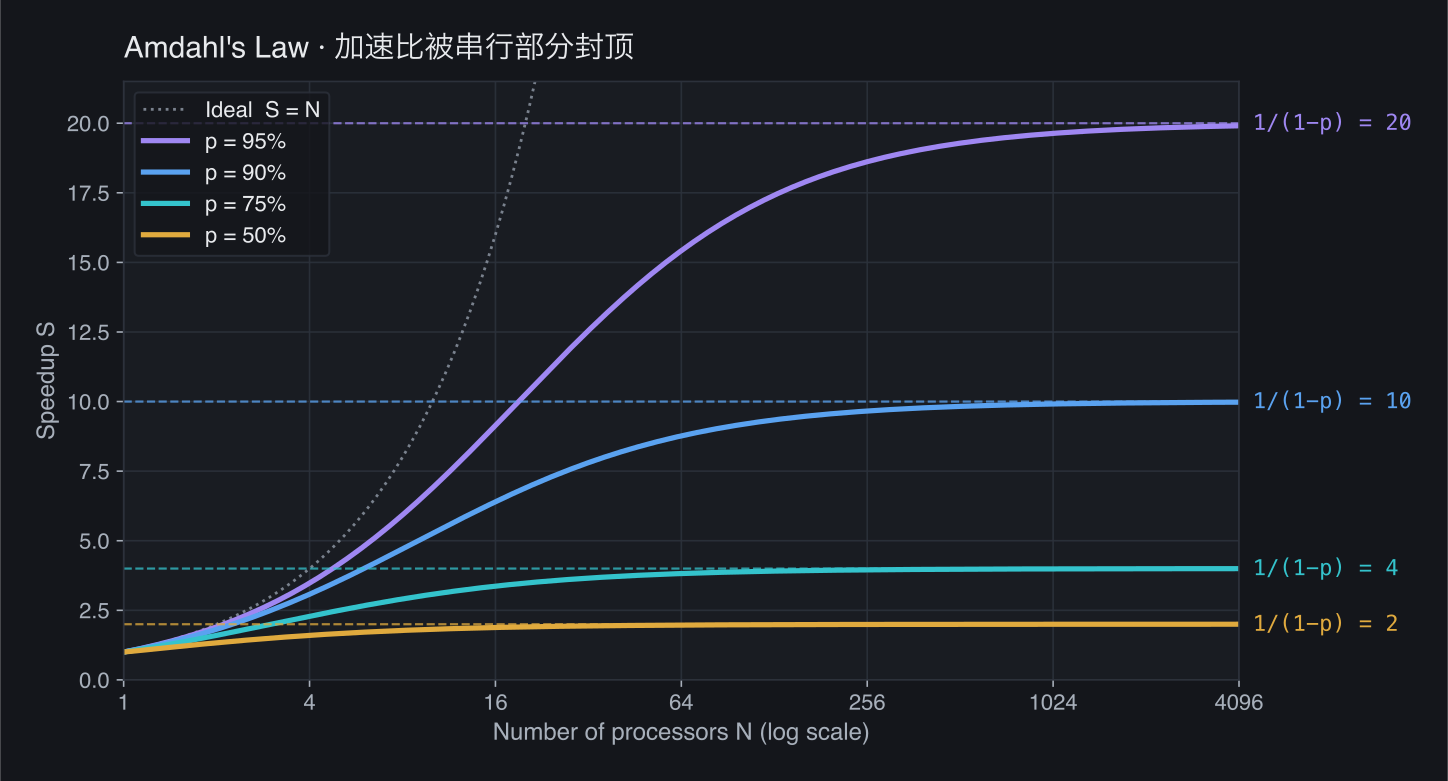
上图横轴是处理器数(对数刻度,每格乘4),纵轴是加速比。四条曲线对应四种可并行比例,同色虚线是各自的上限,灰色点线是理想的线性加速。曲线开始贴着点线上升,很快就弯平:可并行95%的程序用256个处理器约18.6倍,已接近上限20;可并行50%的程序用16个处理器也只有约1.9倍。
计算加速比
- 多核并行。能并行的部分占90%,用8个核:。换成1024个核也只有约9.9倍,已经贴近上限10:核数多了128倍,加速比只多了约一倍。
- 两种方案比较。方案A把占20%时间的部分加速10倍:;方案B把占60%时间的部分加速2倍:。B的单项加速倍数小,整体收益反而更大:优先优化占时间最多的部分(make the common case fast)。
Dennard Scaling
功耗公式
CMOS电路的功耗分为两部分:
- 动态功耗:电路翻转时给负载电容充电、放电消耗的功率。电容充电再放电一次,消耗的能量是;时钟频率是,每个周期有比例为的电容发生翻转,所以每秒消耗。
- :activity factor,每个周期发生翻转的电容所占的比例;
- :负载电容,晶体管越小,电容越小;
- :电源电压,按平方计入功耗,降电压是省功耗最有效的办法;
- :时钟频率。
- 静态功耗:晶体管关断时仍有漏电流流过,功耗等于电压乘电流。阈值电压越低,漏电流越大。
缩放规则
1974年Robert Dennard等人在论文中提出:每一代工艺把晶体管的尺寸和电压同时缩小到原来的0.7倍(线宽缩小约30%,图中把每代的缩小倍数记作 κ ≈ 1.4),器件内部的电场强度不变。代入功耗公式,每一代的变化是:
| 物理量 | 每一代 | 原因 |
|---|---|---|
| 尺寸、电压、电容 | × 0.7 | 按比例缩小 |
| 频率 | × 1.4 | 晶体管变小,翻转变快 |
| 单个晶体管的功耗 | × 0.5 | 0.7 × 0.7² × 1.4 ≈ 0.5 |
| 单位面积的晶体管数 | × 2 | 每个晶体管的面积减半 |
| 功率密度 | × 1 | 2 × 0.5 = 1 |
每过一代:
- 晶体管数翻倍;
- 主频提高约40%;
- 单位面积的功耗不变。
1990年代主频从几十MHz涨到GHz,靠的就是这条规律。实际中电压降得比0.7倍慢,主频又借更深的流水线涨得更快,处理器功耗一路上升,2004年3.8 GHz的Pentium 4已经超过100 W。
为什么失效
2005年前后(90 nm到65 nm节点),电压不再随尺寸一起下降,原因有三个:
- 阈值电压降不下去。晶体管关断时仍有subthreshold漏电流,阈值电压越低漏得越多:室温下每降低60–100 mV,漏电流就增大约10倍。这个比例由温度决定,不会随尺寸缩小而改善。
- 电源电压跟着停住。晶体管的速度取决于电源电压比高出多少(见alpha-power law)。降不下去时,再降会让晶体管明显变慢。电源电压从1990年代初的5 V降到约1 V后基本停住。
- 栅氧化层不能再薄。栅氧化层缩到约1.2 nm(只有几层原子)后,栅极隧穿漏电明显增加。45 nm节点引入的high-k metal gate缓解了这一项,但电压仍然没有恢复缩放。
电压停住以后,再看上表:单个晶体管的功耗只剩电容和频率的变化,0.7 × 1.4 ≈ 1,基本不再下降;单位面积的晶体管数却照样翻倍。
电压停住以后,功率密度每代约翻一倍(即使主频不再提高,也每代增长约1.4倍),很快超过散热能力,这就是功耗墙。
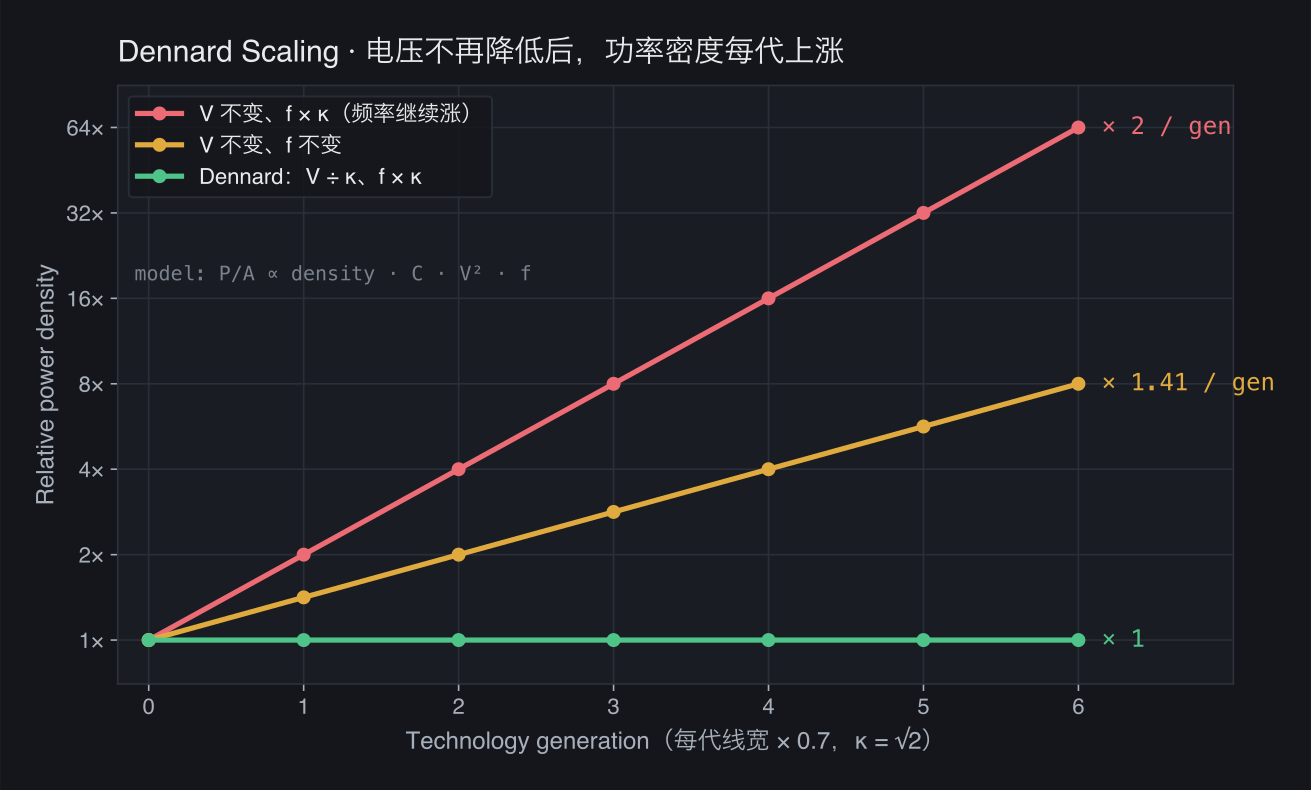
这张图不是实测数据,是用上表的缩放倍数逐代推算的:横轴是工艺代数,纵轴是相对功率密度(对数刻度)。绿线是理想的Dennard Scaling,电压随尺寸一起降低,功率密度不变;红线是电压不变、主频仍每代提高1.4倍,功率密度每代翻倍,6代后是64倍;黄线是电压和主频都不变,功率密度仍每代涨1.4倍,6代后约8倍。2005年以后的处理器接近黄线的情况:要把功耗压在散热能力以内,就不能让所有晶体管同时全速工作。
散热能力有上限,结果是:
- 主频停在3–4 GHz。2004年Intel取消了下一代高频NetBurst(Pentium 4的微架构)处理器Tejas,转向多核。
- 新增的晶体管不能同时全速工作(dark silicon),只能轮流开启或降频运行。
- 性能提升转向多核和专用加速器(GPU、NPU),而多核的收益受Amdahl’s Law限制。
Moore’s Law
说的是集成度
- 1965年,Gordon Moore在Electronics杂志的文章”Cramming more components onto integrated circuits”中指出:在成本最低的集成度下,单块芯片上的元件数每年翻一番。1975年他在IEDM的报告中把速度修正为约每两年翻一番。
- 它描述的是集成度(单芯片晶体管数)和背后的经济性(每个晶体管的成本),不是性能。
- 常见的「每18个月性能翻一番」出自Intel的David House(见Wikipedia):他把晶体管更多、晶体管更快两个因素合在一起估算性能。Moore的原始表述只关于元件数。
集成度增长不等于性能增长
处理器执行一个程序所用的时间(Iron Law):
- IC(instruction count):程序要执行的指令条数;
- CPI:平均每条指令花几个时钟周期;
- :一个时钟周期的长度。
晶体管数不在公式里:集成度只能通过主频和CPI间接变成性能。
两条路分别是:
- 更快的晶体管 → 更高的主频。这条路依赖Dennard Scaling,2005年前后走到尽头。
- 更多的晶体管 → 更复杂的微架构 → 更低的CPI。流水线、超标量、乱序执行、分支预测、更大的cache都靠更多的晶体管实现。这条路收益递减:Intel的Fred Pollack总结的经验(Pollack’s Rule)是,单核性能大约只与投入的晶体管数的平方根成正比。
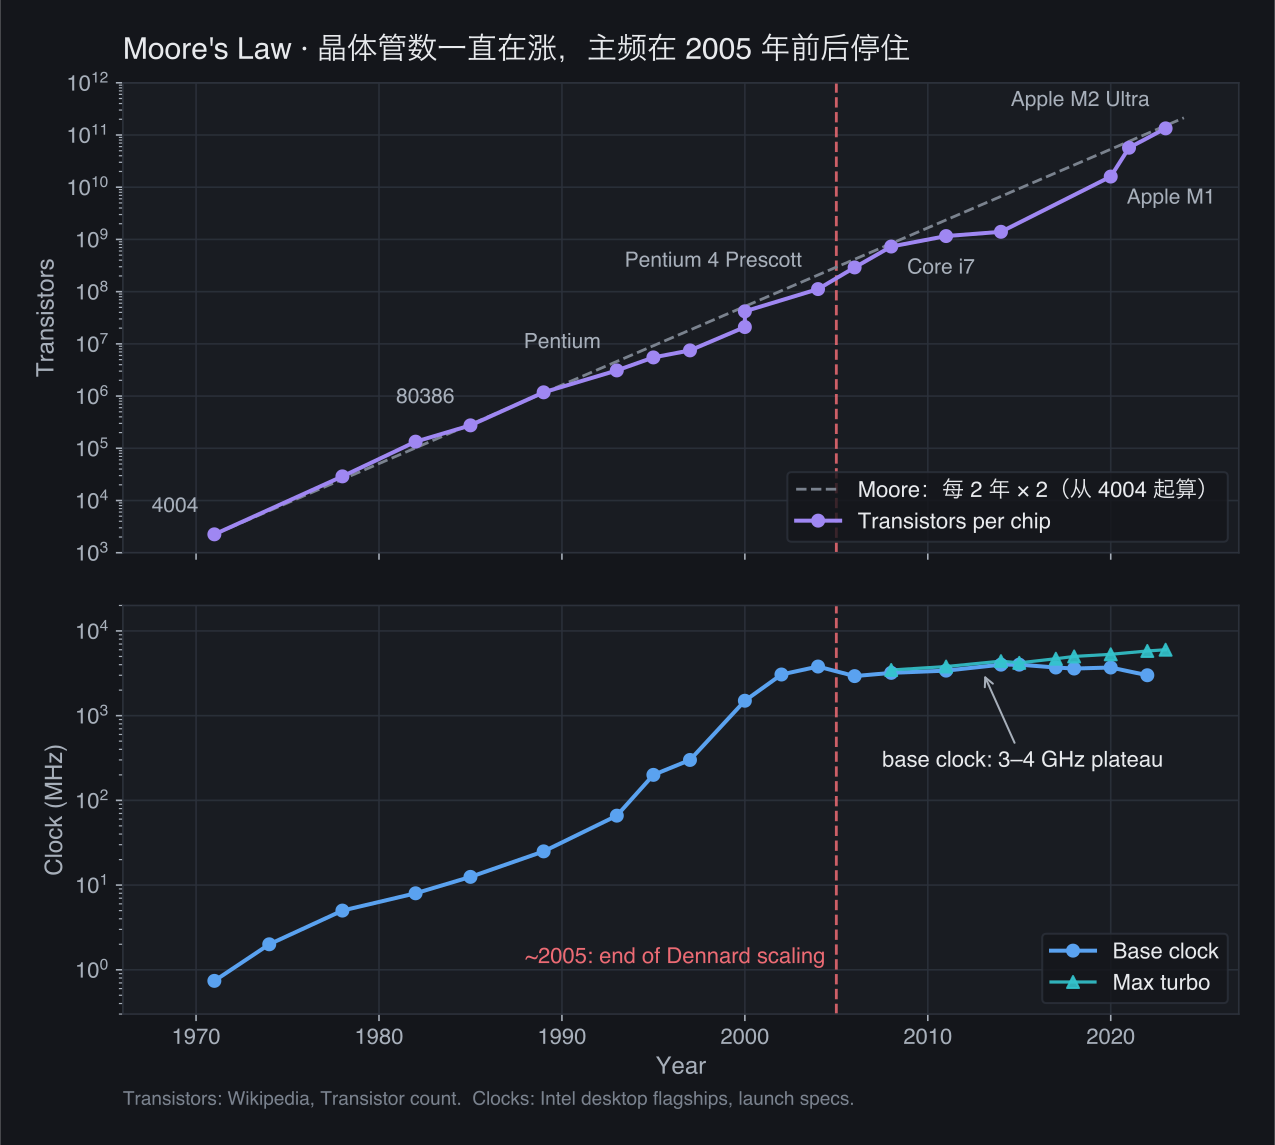
上半张图是单芯片晶体管数(对数刻度),灰色虚线是从4004起按每两年翻一番画的趋势线;下半张是Intel桌面旗舰处理器发布时的主频,蓝色是基础频率,青色是2008年起才有的最高turbo频率;红色竖线标出2005年前后。
- 集成度:从Intel 4004的2,250个晶体管按每两年翻一番推算,2023年约为1500亿个,与Apple M2 Ultra(两颗die,即两块裸片拼接,共1340亿个)相当,大致按Moore’s Law增长。
- 主频:1971–2004年间涨了约5000倍,之后近20年基础频率一直在3–4 GHz,最高turbo频率(负载允许时的短时提频)到2023年也只有6 GHz。
单处理器性能的年增长率(Hennessy & Patterson,Computer Architecture: A Quantitative Approach第6版图1.1):
| 时期 | 年增长 | 主要原因 |
|---|---|---|
| 1978–1986 | 约22% | 主要来自工艺进步 |
| 1986–2003 | 约52% | RISC体系结构创新,加上Dennard Scaling下的主频提升 |
| 2003–2011 | 约23% | 功耗墙,指令级并行接近极限 |
| 2011–2015 | 约12% | 多核的并行收益受Amdahl’s Law限制 |
| 2015–2018 | 约3.5% | 增长接近停滞,约20年才翻一番 |
同一时期晶体管数一直按约每两年翻一番增长(年增长约41%)。2005年之后多出来的晶体管主要用于更多的核、更大的cache、集成GPU和各类专用加速器:芯片的总吞吐量继续提升,单线程性能却只缓慢增长。
| 集成度 | 性能 | |
|---|---|---|
| 衡量什么 | 单芯片晶体管数、每个晶体管的成本 | 程序的执行时间(指令数 × CPI ÷ 主频) |
| 增长来源 | 光刻和工艺进步、更大的die、多die封装 | 主频(Dennard Scaling)、微架构(CPI)、并行度 |
| 2005年之后 | 仍在增长,大致保持两年翻一番 | 单线程增速从每年52%降到个位数;多核吞吐量受Amdahl’s Law限制 |
三者的关系
现代处理器的发展可以归纳为一条逻辑链:
%%{init: {"flowchart": {"wrappingWidth": 320}}}%%
flowchart TB
  M["摩尔定律<br/>晶体管数量持续增加"]
  D["登纳德缩放失效<br/>主频难以继续提高,出现功耗墙"]
  P["转向多核与并行架构<br/>用更多晶体管提升整体算力"]
  A["阿姆达尔定律<br/>固定规模的任务,加速受串行部分限制"]
  G["古斯塔夫森定律<br/>核数增加时,可以处理更大的问题"]
  O["现代架构优化<br/>Pollack:单核面积收益递减<br/>Little:隐藏延迟需要足够的并发<br/>Roofline:性能受算力或带宽封顶"]
  M --> D --> P
  P --> A --> O
  P --> G --> O
- 摩尔定律 → 登纳德缩放失效。晶体管数量仍按约两年翻一番增长,但电压降不下去以后,这些晶体管不能再换成更高的主频:功率密度会超出散热能力,即功耗墙。
- 转向多核与并行架构。多出来的晶体管用来放更多的核、更宽的向量单元和专用加速器,靠并行提升整体算力。
- 并行收益的两种算法。问题规模固定时看阿姆达尔定律,加速比被串行部分封顶。问题规模随核数一起扩大时看古斯塔夫森定律:。串行部分照旧,并行部分在个核上同时做份工作,所以相同时间内完成的工作量随核数近似线性增长。两者并不矛盾,区别只在问题规模是否固定。
- 现代架构优化。在多核和并行之上,设计还要同时考虑三条经验规律:
- Pollack’s Rule(见上文Moore’s Law一节):大核收益递减,面积更多地花在多核和专用单元上。
- Little’s Law:。是每秒完成的请求数(吞吐),是每个请求的延迟,是同时在途的请求数。用在访存上:要持续跑满带宽,在途的数据量必须达到「带宽 × 延迟」。例如访存延迟100 ns、带宽50 GB/s时,需要约5 KB,即约78个64 B的cache line(cache与内存之间搬运数据的单位)同时在途,这要靠多个同时未完成的访存请求(outstanding miss)、多线程或预取来提供。
- Roofline模型:。程序能跑到的性能,取「峰值算力」和「带宽 × 运算强度」中较小的那个;运算强度是每读写1字节数据做几次运算。例如峰值1 TFLOP/s、带宽100 GB/s的处理器,运算强度只有2 FLOP/B的程序最多跑到200 GFLOP/s,这时增加运算单元没有用,要提高带宽或改善数据复用。
参考
- G. M. Amdahl, “Validity of the single processor approach to achieving large scale computing capabilities,” AFIPS Spring Joint Computer Conference, 1967.
- J. L. Gustafson, “Reevaluating Amdahl’s law,” Communications of the ACM, 1988.
- R. H. Dennard et al., “Design of ion-implanted MOSFET’s with very small physical dimensions,” IEEE Journal of Solid-State Circuits, 1974.
- T. Sakurai, A. R. Newton, “Alpha-power law MOSFET model and its applications to CMOS inverter delay and other formulas,” IEEE Journal of Solid-State Circuits, 1990.
- H. Esmaeilzadeh et al., “Dark silicon and the end of multicore scaling,” ISCA, 2011.
- J. D. C. Little, “A proof for the queuing formula: L = λW,” Operations Research, 1961.
- S. Williams, A. Waterman, D. Patterson, “Roofline: an insightful visual performance model for multicore architectures,” Communications of the ACM, 2009.
- G. E. Moore, “Cramming more components onto integrated circuits,” Electronics, 1965(链接为Proceedings of the IEEE 1998年的重印版).
- G. E. Moore, “Progress in digital integrated electronics,” IEDM, 1975(链接为IEEE SSCS Newsletter 2006年的重印版).
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed., Figure 1.1.
- 图中晶体管数:Wikipedia, “Transistor count”;主频:Intel桌面处理器发布时的标称值,见Wikipedia, “List of Intel processors”。
Discussion
Loading comments…
Checking sign-in…