有了流水线和cache,下一步是让CPU每个周期完成不止一条指令。Intel在1985~1995年的路线正好是这条路:
- 1985 i386:multi-cycle
- 1989 i486:5级流水线
- 1993 Pentium:superscalar(超标量)
- 1995 P6:out-of-order execution(乱序执行)
一、为什么要超标量
1. 性能的三个因素
Performance = IPC × 频率 / 指令数
- 频率:靠更深的流水线、更快的晶体管
- 指令数:ISA和编译器定了就基本不变
- IPC(每个周期完成的指令数):靠更好的微架构
2. 流水线的上限:IPC = 1
流水线把一条指令拆成几段,几条指令错开重叠执行,这是时间上的并行(temporal parallelism)。理想情况下每个周期完成一条,IPC = 1。
- 流水线加深:IPC还是1,只是频率能做得更高
- 想让IPC > 1,还要空间上的并行(spatial parallelism):同一个周期里同时处理好几条指令,这就是superscalar
二、顺序流水线的局限
5级流水线是顺序的:指令一级一级往下走,前面一条卡住,后面的全得停。
i2 = lw a0, 0(a2) 在MEM级cache miss,要去内存取,等上百个cycle。i3跟在它后面:
- i3 =
add a4, a2, a3:不用a0,和i2无关,但MEM级被i2占着,i3只能停在EX —— structural hazard - i3 =
add a4, a2, a0:要用i2读回来的a0,必须等i2取完 —— RAW hazard
说明同样是停,前一种是被堵住,后一种是真的要等数据。
没有依赖的i3指令其实可以先走,只是固定的5级流水线不允许它越过前面卡住的指令(课件里把这种越过叫bypass,和forwarding不是一回事)。有RAW依赖的指令不管怎样都得等。
三、多个functional unit
取指、译码每条指令都要走,但执行时不同指令用的部件不一样(add不用经过MEM)。所以执行阶段按opcode分到不同的functional unit:INT ALU、地址计算 + MEM、branch、多级的FP。乘除、浮点这类要好几个cycle的运算分出去以后,不会再挡住别的指令。
decode和execute之间加一级issue,发射前查两种冒险:
- structural hazard:要用的functional unit被占着吗
- data hazard:操作数准备好了吗
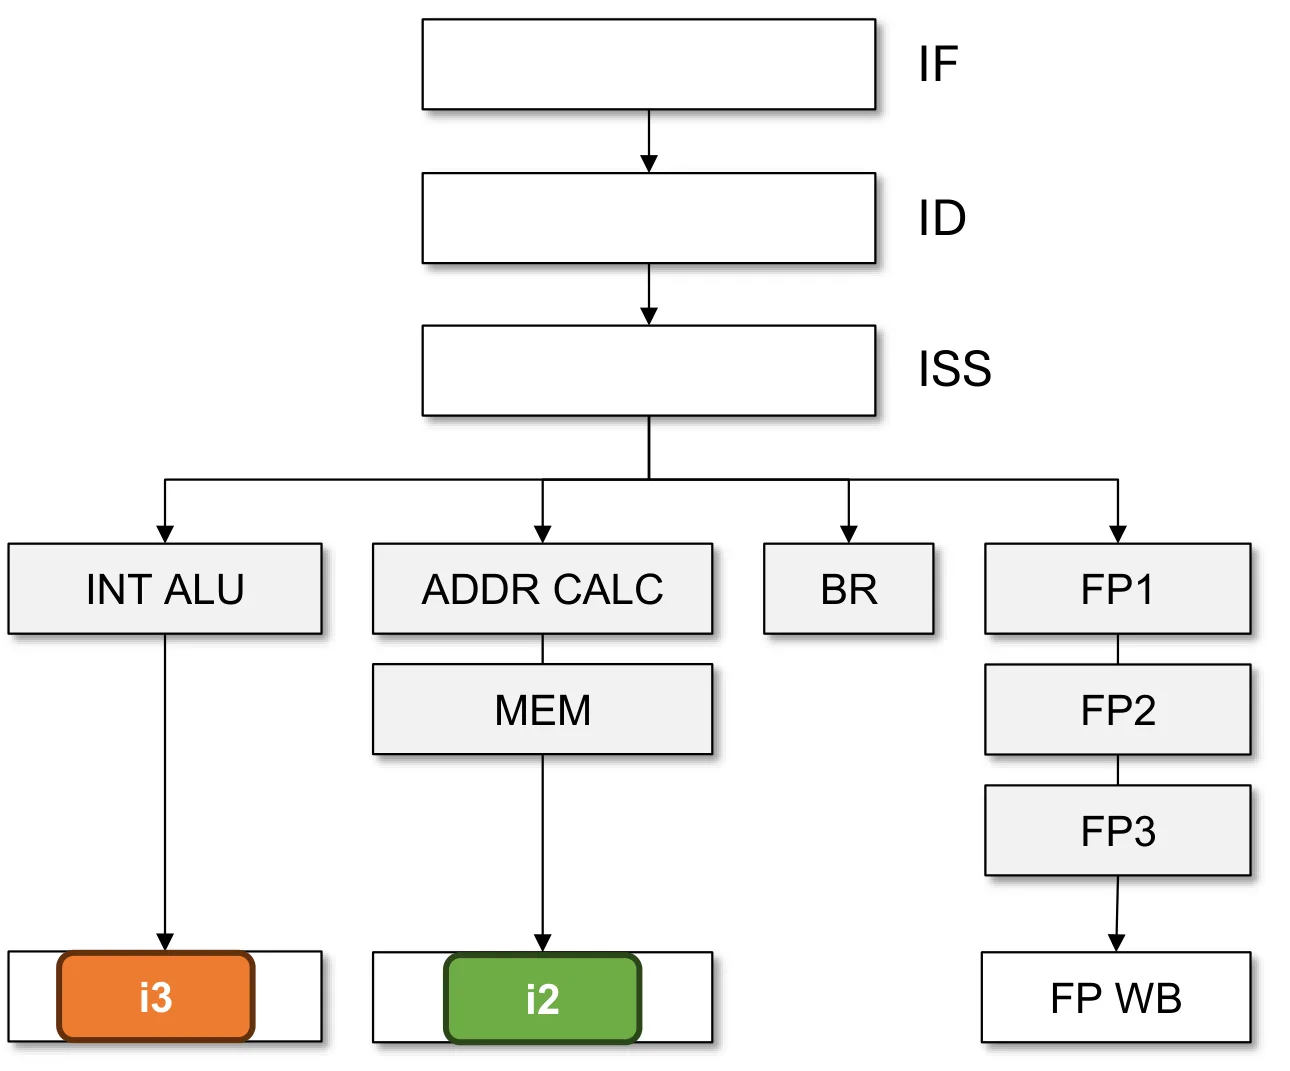
图里每个functional unit下面都有自己的写回口(最底下一排)。i3(add)走INT ALU、i2(lw)走MEM,两条没有依赖,可以同时执行,再各自从自己的写回口写回(图里两条正在写回)。
但写回还是要按程序顺序:
- WAW(两条指令写同一个寄存器):顺序乱了,最后留在寄存器里的值就错了
- 精确异常:某条指令出异常时,它前面的都已写回、后面的都没写,寄存器状态才说得清(见下篇「分支预测错误的恢复」)
另外,同一拍能写回几条,受RegFile写口数量的限制。
IPC的上限由最窄的那一级决定:fetch、decode、issue还是一次一条,IPC最多还是1。要再往上,就得把整条流水线加宽,也就是superscalar。
四、Superscalar:加宽流水线
把流水线的每一级都加宽,同一拍处理好几条指令。2-wide(dual-issue)就是每拍取2条、译码2条、执行2条、做2次访存、写回2个寄存器,IPC最多到2。
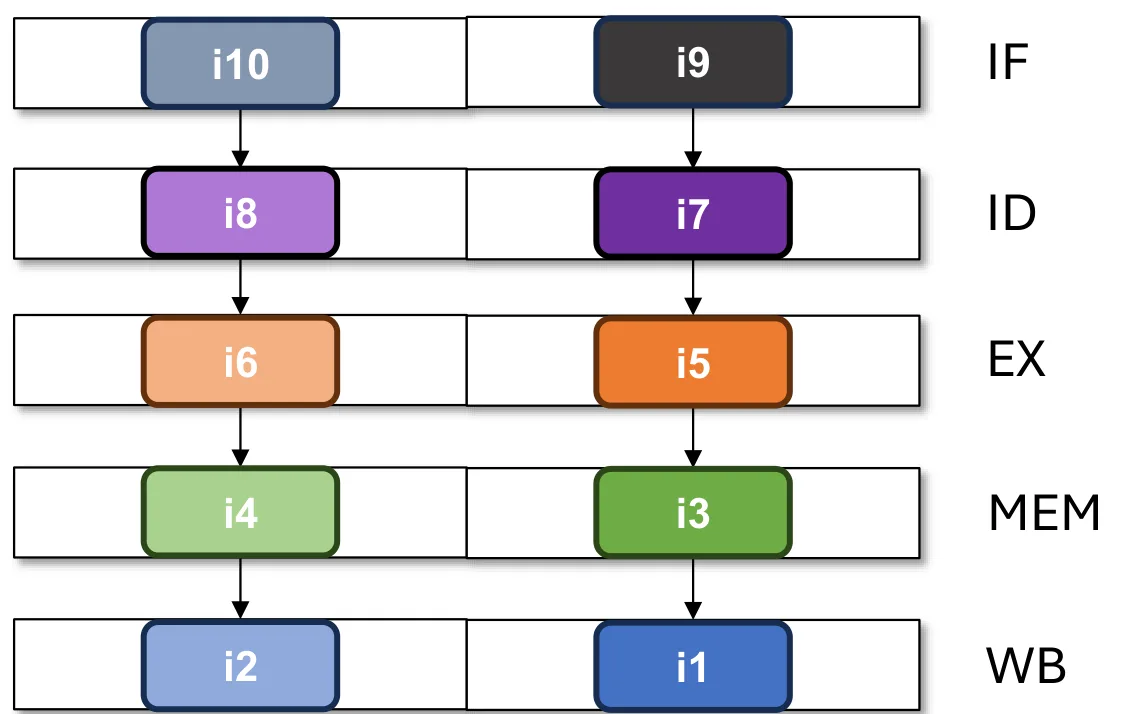
图里每一级并排放着两条指令:i1、i2同一拍写回,i9、i10同一拍取指。
- 同一拍的两条也要查依赖:后一条要用前一条的结果,后一条就停下,插一个bubble
- 还是顺序的(in-order):只能把相邻的几条凑在同一拍;下一条有依赖就只能等,不会往后找没有依赖的指令(乱序执行解决的就是这个)
- 硬件代价:面积和功耗都会涨,有几块比宽度涨得快
- cache和RegFile要支持同一拍多次访问(multi-ported,多端口)。RegFile每多一个端口,每个存储单元的长和宽都要变大,面积大约按端口数的平方涨
- forwarding通路、同一拍几条指令之间的依赖检查,也大约按宽度的平方涨
- 所以顺序的超标量一般只做2~3路宽:手机里的小核ARM Cortex-A53、A55是2-wide,A510是3-wide
Pentium(1993)基本就是把i486(1989)的5级流水线复制了一份:取指(PF)和第一拍译码(D1)共用,从第二拍译码(D2)起分成U、V两条pipe(x86译码要两拍)。data cache分成两个bank,两个bank可以同一拍各访问一次。
说明加宽流水线不只是多放几个执行单元,取指、译码、访存、写回都得跟着变宽。
顺序的超标量还剩三类冒险限制IPC:
- data hazard:寄存器之间的依赖,是最主要的问题
- control hazard:程序里分支很多
- structural hazard:访存、cache要很多拍
五、乱序执行
1. 为什么要乱序
- 顺序处理器(in-order):严格按程序顺序执行,后面的指令不能越过前面的,一条停下,后面全停(见第二章)。单周期、多周期、5级流水线都是
- 乱序处理器(out-of-order):后面的指令只要和前面没有依赖,就可以越过前面停住的指令,先开始执行
2. 顺序进、乱序做、顺序出
第三章那种分出多个functional unit的流水线,执行这一段其实已经是部分乱序了。把它补完整,就是乱序处理器的骨架:
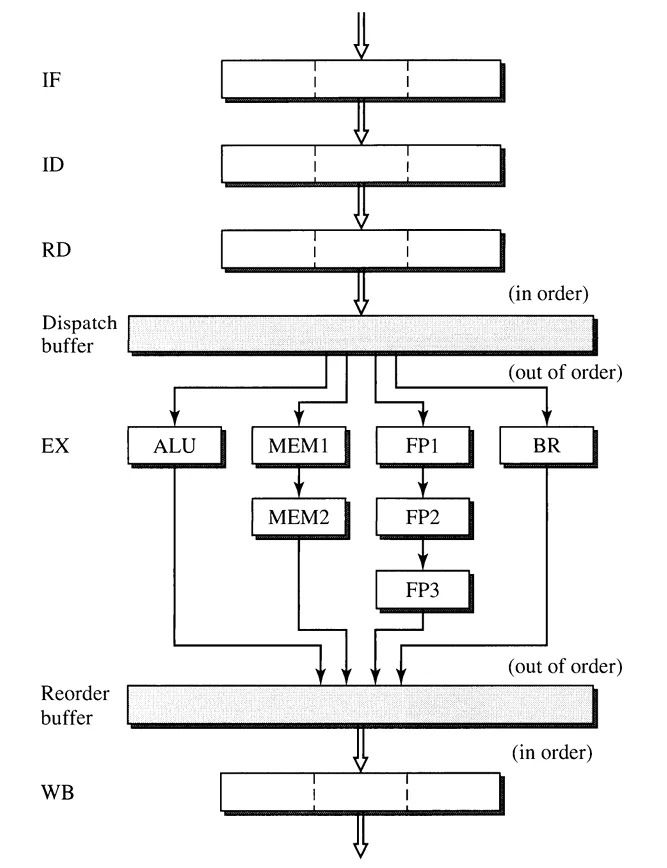
图里EX那一排的ALU、MEM1/MEM2、FP1~FP3、BR,就是第三章说的functional unit(这张图按类型标名字,没写functional unit)。
- 顺序进:IF、ID、RD(读寄存器)按程序顺序走,指令放进dispatch buffer等着(第7节的reservation station就是在做这件事)
- 乱序做:哪条的操作数齐了,就先发到对应的functional unit。没有依赖的可以先做完,有RAW依赖的还要等
- 顺序出:做完的先放进reorder buffer,再按程序顺序写进RegFile(有ROB的处理器里这一步叫commit,见下篇「Commit」)。结果一旦写进RegFile就撤不回,前面某条出了异常,后面做完的也不能先写(见第三章)
- 每个functional unit的结果都要forward给所有functional unit,等这个结果的指令才能马上开始
3. ILP和dataflow graph
不管硬件做得多宽,IPC都超不过程序本身的ILP(instruction-level parallelism):程序里有多少指令真正互相独立。
- 算法:在一段指令里,指令条数 ÷ 把它们全部排完要几拍(假设每条都是1拍)
- dataflow graph(DFG):把程序画成有向图,节点是指令,边是寄存器依赖,从一条指令的rd指向用到它的rs1 / rs2。每条指令的输入一到齐就执行(生产者 → 消费者)
看下面5条指令谁用了谁的结果:
- i1
sub a1, a1, a0 - i2
mul a4, a1, a1:用i1的a1 - i3
sub a3, a3, a2 - i4
mul a5, a3, a3:用i3的a3 - i5
add a6, a4, a5:用i2、i4的结果
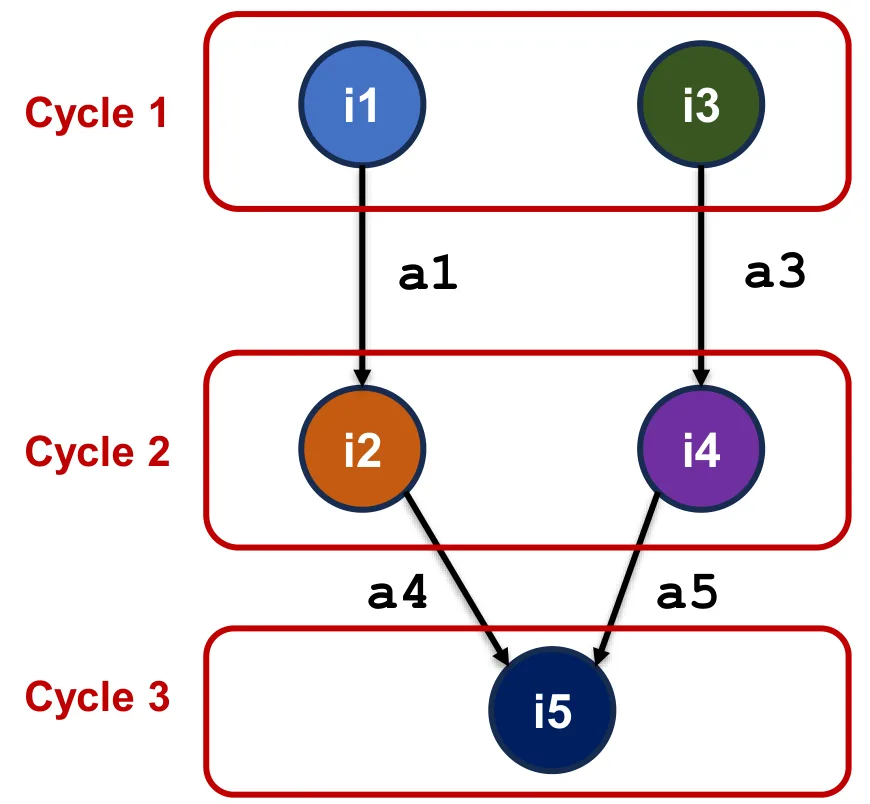
i1、i3互相独立,第1拍一起做;i2、i4在第2拍;i5在第3拍 —— 5条3拍做完,ILP = 5/3 ≈ 1.67。
说明DFG里最长的那条链决定了至少要几拍。
两个极端:5条指令一条接一条地用上一条的结果,排成一条链,ILP = 1;5条各加各的寄存器、互不相关,ILP = 5。指令之间的依赖规定了先后,是限制并行的根本原因。
4. 三种数据冒险
| 冒险 | 例子 | 限制 | 真依赖 |
|---|---|---|---|
| RAW(写后读) | i1写a1 → i2读a1 | i2要等i1算出a1 | ✅ |
| WAR(读后写) | i3读a10 → i4写a10 | i4不能在i3读之前写回 | ❌ 换个寄存器就没了 |
| WAW(写后写) | i5写a20 → i9写a20 | i9不能比i5先写回,否则a20最后的值错 | ❌ 换个寄存器就没了 |
RAR(读后读)不算冒险:读不会改变寄存器的值。
只有RAW是真依赖:后一条真的要用前一条算出来的值。WAR、WAW的两条指令之间并没有传递数据,只是碰巧用了同一个寄存器名,换个名字就能消掉。
5. 寄存器重命名
上一节说WAR、WAW换个寄存器名就能消掉。怎么换、换成什么,就是寄存器重命名研究的东西。
(1) 假依赖从哪来
把第3节的5条指令改成只用a0~a4(假设ISA只有这5个寄存器):
- i1 sub a1, a1, a0
- i2 mul a4, a1, a1 :用i1的a1
- i3 sub a1, a3, a2 :结果也放进a1
- i4 mul a2, a1, a1 :用i3的a1
- i5 add a4, a4, a2 :用i2、i4的结果
谁用了谁的结果没有变,DFG还是同一张图。但a1被i1、i3重复使用,多出了假依赖:
- WAR:i2读a1,之后i3写a1
- WAW:i1、i3都写a1
说明本来和i1、i2无关的i3,现在要等i1写完a1、i2读完a1,才能写a1。
寄存器越少,同一个名字就得反复用,假依赖也就越多。
(2) 架构寄存器和物理寄存器
寄存器多了,同一个名字就不用反复用,大部分假依赖就没了。那为什么不让ISA直接规定256个寄存器?
因为ISA规定了多少个寄存器,每个支持这个ISA的CPU都得做出这么多个(少做一个,用到它的程序就跑不了),低功耗的小核也不例外。所以RV32I只规定32个,大核想要更多寄存器,就在CPU内部自己加。
这样CPU里就有两种寄存器:
- 架构寄存器:ISA规定、程序里写的寄存器,就是a0、a1这些,RV32I共32个。这32个合起来叫ARF(architectural register file)
- 物理寄存器:CPU内部自己加的寄存器,程序看不见,记作p0、p1……,个数由CPU决定(如128个)。这些合起来叫PRF(physical register file)
寄存器本来就只是临时值的名字(C、Python程序里没有寄存器,是编译器分配的),换个名字不影响算出来的结果。寄存器重命名(register renaming)就是程序运行时由硬件把指令里的架构寄存器换成物理寄存器。两条指令写同一个架构寄存器,会分到不同的物理寄存器,假依赖就没了。
(3) 用RAT重命名
RAT(Register Alias Table)是一张表:每个架构寄存器占一行,记着它现在对应哪个物理寄存器。每条指令按顺序做两步:
- 换源寄存器:rs1、rs2是架构寄存器,查RAT换成表里记的物理寄存器;表里没有记录的不换,直接用架构寄存器里的值
- 给rd分新的物理寄存器:只要写rd,就给rd分一个新的物理寄存器,tail指向哪个就分哪个(tail见(4)),不检查依赖。正因为每次都换新的,假依赖自然就没了,硬件不用专门去找。
- RAT里rd那一行改成这个物理寄存器
- 这个物理寄存器刚分配时标成invalid(值还没算出来),等这条指令算完写进去才有效
已知RAT里只有一条记录 a1 → p3,其他架构寄存器都还没换过名;下一个空闲的物理寄存器是p6。重命名 add a1, a1, a5:
换源寄存器:rs1 = a1,查到p3;rs2 = a5,表里没有记录,不换 —— add a1, p3, a5
给rd分新的物理寄存器:rd = a1分到p6,RAT里a1马上改成p6(这时add还没执行,p6是invalid) —— add p6, p3, a5
说明rd和源都是a1时,源先查到旧的p3(上一条写a1的指令的结果),之后rd才换成新的p6。
给(1)里只用5个寄存器的5条指令重命名,物理寄存器从p1开始分配,RAT一开始是空的(所有架构寄存器都还没换过名):
| 指令 | 重命名前 | 重命名后 | RAT更新 |
|---|---|---|---|
| i1 | sub a1, a1, a0 | sub p1, a1, a0 | a1 → p1 |
| i2 | mul a4, a1, a1 | mul p2, p1, p1 | a4 → p2 |
| i3 | sub a1, a3, a2 | sub p3, a3, a2 | a1 → p3 |
| i4 | mul a2, a1, a1 | mul p4, p3, p3 | a2 → p4 |
| i5 | add a4, a4, a2 | add p5, p2, p4 | a4 → p5 |
- WAR、WAW没了:i1、i3原来都写a1,现在分别写p1、p3;i2读的是p1,i3写p3不影响它
- RAW照样对:i4读a1时,RAT里的a1已经被i3改成p3,读到的就是i3的结果
说明重命名后只剩RAW,又能按第3节的DFG并行,5条3拍做完。
(4) 硬件实现
Rename可以单独占一级流水线,也可以并进decode或dispatch(dispatch见第7节)。实现方式不止一种,课件用的是两张表:
- RAT + ARF:合成一张表,每个架构寄存器一行(RV32I共32行)
- renamed?:换过名没有
- paddr:换过名的话,对应哪个物理寄存器
- value:没换过名的话,值就在这里(这一列就是ARF)
- PRF:每个物理寄存器一项,存data和valid位(v)。tail指向下一个要分的物理寄存器,分一个加1,到底绕回p0
查源寄存器,结果记在指令里带着走:
- 没换过名:拿value里的值,ready(准备好了)
- 换过名:记下paddr。那个物理寄存器valid就读出值,ready;invalid就不ready,等写它的指令算完
(3)的前两条指令。开始时都没换过名,PRF都空着,tail = p1:
i1 sub a1, a1, a0 → sub p1, a1, a0:a1 → p1,tail走到p2
i2 mul a4, a1, a1 → mul p2, p1, p1:源a1查到p1,p1还invalid,不ready;a4 → p2,tail走到p3
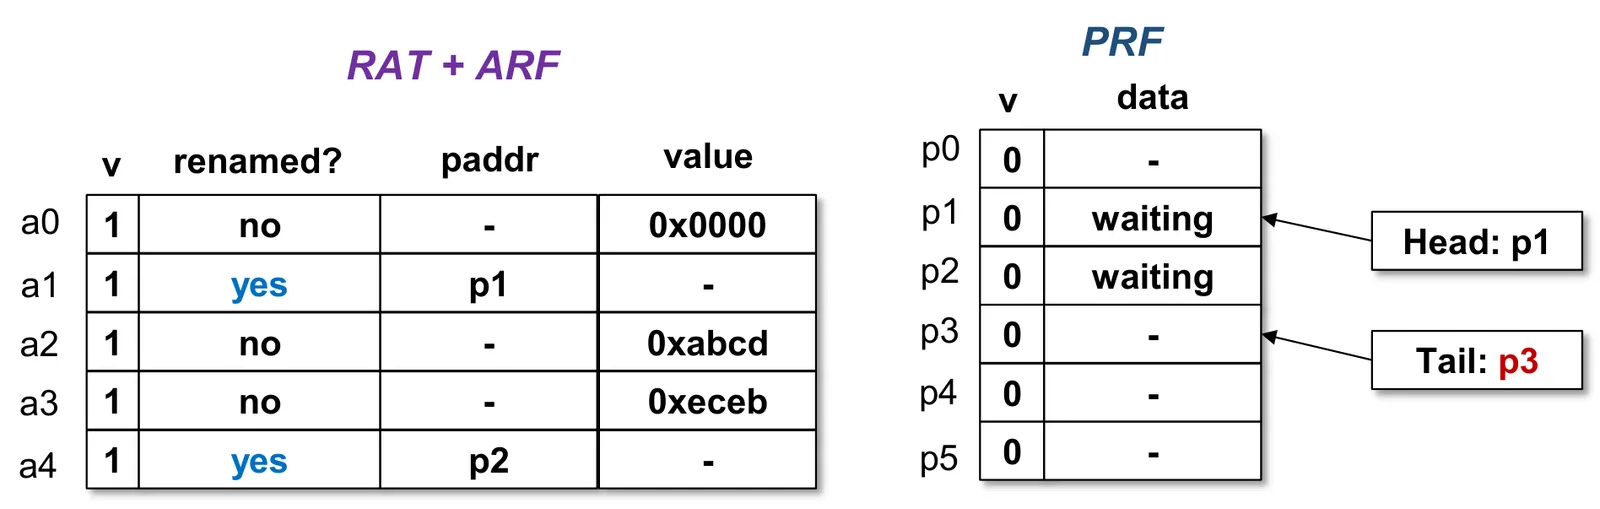
- 左边:a1、a4换过名,指向p1、p2(这时value里的旧值不用,画成-);a0、a2、a3没换过名,值还在value里。v这一列先不管
- 右边:p1、p2分出去了,值还没算出来(waiting);tail指向p3。head在commit时回收物理寄存器用(见下篇「Commit」)
说明值还没算出来的源(i2的a1),只能先记下物理寄存器编号。
- 不写rd的指令不分物理寄存器:store、branch,以及rd是x0的(x0永远是0,不能换名)
- 只查真正用到的源寄存器:addi只有rs1,lui一个都没有
- PRF满了就要停:物理寄存器分完了,后面的指令不能再重命名,要停下来等
6. 前五节小结
- 乱序执行利用ILP:操作数一齐就执行,一拍能做好几条,IPC可以超过1(第3节)
- 先消掉WAR、WAW:用寄存器重命名,每个rd都分一个新的物理寄存器(第5节)
- 重命名后发给空闲的functional unit:操作数齐了、unit不忙就执行;操作数没齐,就等前面的指令算完把结果forward过来(第7节)
- 最后按程序顺序commit:做完的先放进reorder buffer排好,再按顺序写进RegFile(第2节,ROB见下篇「Reorder buffer」)
7. Reservation station
(1) 为什么要RS
重命名之后,指令还不一定能马上执行:
- structural hazard:要用的functional unit正忙
- data hazard:rs1或rs2还没ready(对应的物理寄存器还invalid)
所以先把指令放在functional unit旁边等着,放的地方叫reservation station(RS)。每种functional unit前面有自己的一组RS:
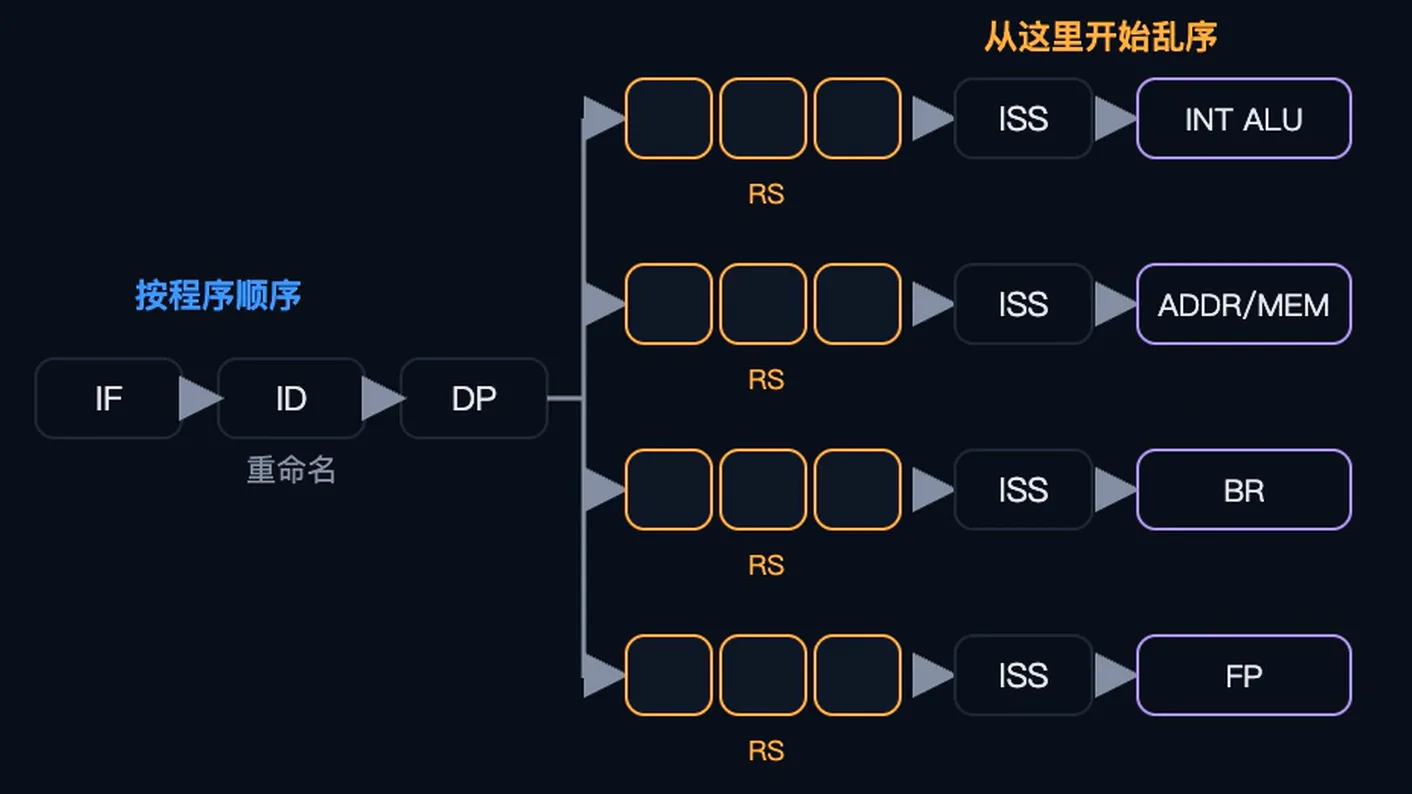
图里从左往右:IF → ID(重命名在这里做,也可以放进DP)→ DP(dispatch,把指令放进RS)→ 每种functional unit前面一组RS(每组三格,能放三条)→ ISS(issue,从RS里挑指令发出去)→ functional unit。到DP为止按程序顺序,从RS往后开始乱序。
RS每一格存一条指令:
- v:这一格有没有放指令
- instr:指令本身(做什么运算)
- rs1、rs2:操作数。ready了存值,没ready存要等的物理寄存器编号
- rdy:rs1、rs2各一个,表示这个操作数ready没有
- rd:结果要写进的物理寄存器
(2) Dispatch:放进RS
每拍把重命名完的指令放进它那种functional unit的RS:
- 这种RS满了:这条指令这一拍不动,下一拍再试
- 有空格:v = 1,填上指令;rs1、rs2、rdy照重命名时查到的填,rd填分到的物理寄存器
(3) Issue:从RS发出去
就是第三章说的issue,每拍对RS里的每条指令检查:
- functional unit正忙:这一拍不动
- 用到的操作数都ready:发给functional unit执行。一个functional unit一拍只收一条,它前面好几条都ready时,挑哪条由设计决定(常见是挑最老的);有几个functional unit,一拍就最多能发几条
- 还有操作数没ready:盯着写回。指令算完写回时,会把结果和自己rd的物理寄存器编号一起广播给所有RS(这就是第2节说的forward),编号和自己等的一样,就存下值,rdy改成1
接着第5节的例子,5条重命名完都放进了RS(乘法器也有自己的一组RS,图里没画):
- i1 sub p1, a1, a0:源都ready
- i2 mul p2, p1, p1:等p1
- i3 sub p3, a3, a2:源都ready
- i4 mul p4, p3, p3:等p3
- i5 add p5, p2, p4:等p2、p4
i1、i3都ready,INT ALU一次只收一条 —— 先发老的i1,下一拍发i3
i1算完写回,广播p1和它的值(记作V1)—— RS里i2、i5的变化见下表
i2发给乘法器,i4、i5继续等
| 时刻 | v | instr | rdy | rs1 | rdy | rs2 | rd |
|---|---|---|---|---|---|---|---|
| 广播前 | 1 | i2 mul | 0 | p1 | 0 | p1 | p2 |
| 1 | i5 add | 0 | p2 | 0 | p4 | p5 | |
| 广播后 | 1 | i2 mul | 1 | V1 | 1 | V1 | p2 |
| 1 | i5 add | 0 | p2 | 0 | p4 | p5 |
- i2被叫醒:等的正是p1,两个操作数都存下V1,rdy变1
- i5不变:等的p2、p4是i2、i4的结果,这次广播的是p1,对不上;要等i2、i4执行完,各自广播p2、p4
说明i3在程序里排在i2后面,却先发出去:RS里谁的操作数先到齐,谁就先走。
参考
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed.
- Wikipedia, Superscalar processor
Discussion
Loading comments…
Checking sign-in…