上篇讲了怎么让指令乱序执行起来:寄存器重命名消掉假依赖,RS里谁的操作数先到齐,谁就先走。这篇讲乱序执行完以后怎么按程序顺序收尾:ROB、commit,以及分支预测错了怎么恢复。
一、Reorder buffer
上篇已经有三个结构:
- RAT:记每个架构寄存器现在对应哪个物理寄存器(见上篇「用RAT重命名」)
- PRF:放重命名后的值(见上篇「架构寄存器和物理寄存器」)
- RS:没ready的指令在functional unit旁边等着(见上篇「Reservation station」)
还缺一个记住指令原来的程序顺序的结构,就是reorder buffer(ROB)。指令进了ROB,到commit才离开。commit(提交)就是按程序顺序让指令的结果正式生效,再把它从ROB里移走(见第三章)。
ROB记录所有在路上(in-flight)的指令,它们处在四种状态之一:
- dispatch了,还没issue(在RS里等)
- issue了,还没开始执行
- 正在functional unit或load-store unit里执行
- 执行完了,还没commit
instruction window:ROB里同时能装多少条在路上的指令(不一定都在执行)。窗口越大,越容易找到互相独立的指令,能挖出的ILP越多。
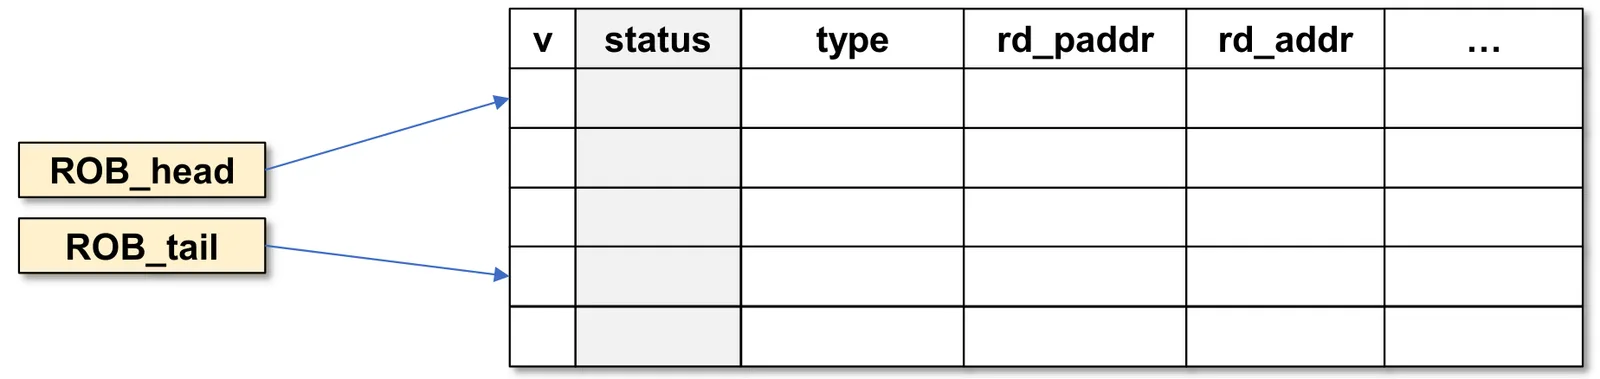
ROB常做成循环队列(circular buffer),每条指令占一格,有时还和PRF并成一个(见第六章「Tomasulo + ROB」):
- head:指向最老的指令,commit从这里开始
- tail:指向下一个空格,新指令从这里进来
- 每格记着:v(这一格有没有指令)、status(执行完了没有)、type(指令类型)、rd_paddr(分到的物理寄存器)、rd_addr(架构寄存器)
commit width:每拍能commit几条,一般和issue的宽度一样。
答案在第二章最后。
二、乱序流水线的六个阶段
乱序处理器里,每条指令依次经过六个阶段:
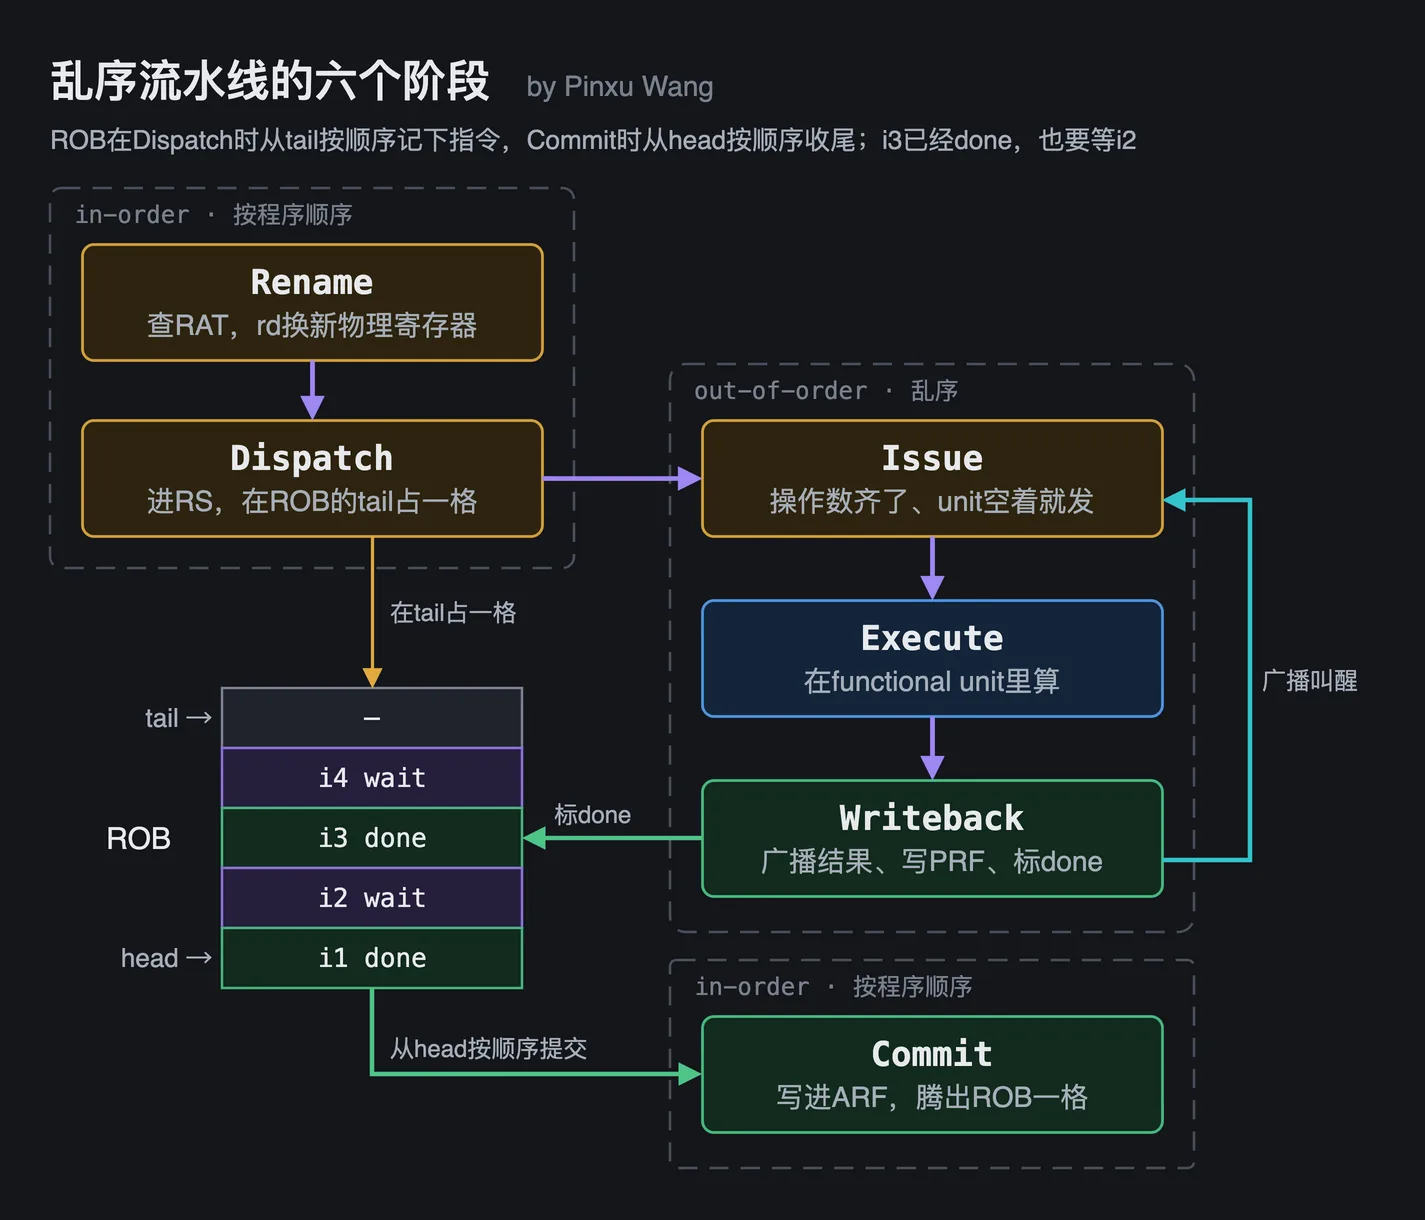
虚线框分出三段:Rename、Dispatch按程序顺序,Issue到Writeback乱序,Commit又按程序顺序 —— 中间乱序,两头按顺序。左下是ROB,新进来的在上(tail),最老的在下(head)。
照着图从上往下:
- Rename:查RAT换名(见上篇「用RAT重命名」)
- Dispatch:图里伸出两个箭头,同时放进RS(见上篇「Dispatch:放进RS」)、在ROB的tail占一格;ROB满了就停
- Issue:操作数齐了、functional unit空着就发出去(见上篇「Issue:从RS发出去」)
- Execute:在functional unit里算
- Writeback:广播结果(图里青色的线),叫醒RS里等它的指令;ROB里标done(图里的i3)。这根线课件叫writeback bus,Tomasulo算法里叫common data bus(CDB)
- Commit:只看head。head done了才提交、腾出这一格(图里的i1);没done,后面done了的也得等(图里i3等i2),细节见第三章
Rename、Writeback、Commit都和寄存器打交道,动的东西不一样:
| 阶段 | 动了什么 | 写不写值 |
|---|---|---|
| Rename | RAT:rd改成指向新分的物理寄存器;这个物理寄存器被占下、标invalid | 不写,值还没算出来 |
| Writeback | PRF:Rename时分到的那个物理寄存器 | 写,填进算出的值,标valid |
| Commit | ARF | 把那个物理寄存器里的值拷进ARF |
- Rename和Writeback:Rename是先占位、改RAT(相当于先订座),Writeback是把算好的值填进这个位子(真正入座)
- Writeback和Commit:writeback谁先做完谁先写,结果只在PRF里,还没正式生效;commit按程序顺序从head一条一条来,写进ARF才算数。上篇「多个functional unit」说的「写回要按程序顺序」,指的是写进RegFile,在有ROB的处理器里就是commit
三、Commit
每拍看ROB的head(最老的指令):done了就commit,没done就等。commit一条指令做四件事:
- 值拷进ARF:PRF里这条指令rd_paddr的值,拷进ARF里rd那一项
- RAT改回「没换过名」:以后读这个架构寄存器,直接读ARF
- 腾出ROB那一格:head加1
- 回收物理寄存器:这个物理寄存器不再用了。PRF也是循环队列,Rename从tail分出去,commit这边从head收回来,腾出来的再分给新指令
课件的伪代码commit时直接把RAT里的renamed清0,这样不对:后面的指令可能又给同一个架构寄存器换了名。
例:i1写a1分到p1,i3也写a1分到p3,RAT里a1已经指向p3。i1 commit时要是把a1改回「没换过名」,后面读a1就会读到ARF里i1的结果,i3的结果丢了。所以只有RAT里a1还指着p1时才改。
ERR没有存值的ARF,值一直留在PRF里,commit时不拷值,只改一张映射表(RRF)、回收旧的物理寄存器,见第六章「ERR」。
四、分支预测错误的恢复
引入ROB最初就是为了这个:分支预测错了要能恢复,异常、中断也要能精确处理。
Speculative execution(推测执行):分支结果出来之前,处理器先按预测的方向继续取指、执行后面的指令。分支大约占指令的20%,预测不准就得频繁停下来等,所以乱序处理器需要好的branch predictor。
预测错了这样处理:
- Writeback时发现:分支算出实际结果,和预测比,对不上就记进ROB
- 等它commit时恢复:
- flush:ROB里它后面的指令全部冲掉,这些是按错误方向取进来的;它前面的都已经commit了
- RAT清空:所有架构寄存器回到「没换过名」,值都在ARF里
- 从正确的地址重新取指
课件的循环(第38~42页):
- i1 mul a5, a5, a4
- i2 div a7, a6, a5
- i3 beq a0, a1, loop
- i4 ret
预测i3会跳回loop,于是又取进了第二遍的i1、i2。前面的i1、i2 commit完以后,ROB里还剩:
| ROB | status | 指令 | 预测 | 实际 | 结果 |
|---|---|---|---|---|---|
| head → | done | i3 beq | 跳 | 不跳 | commit,发现预测错 |
| done | i1 mul(第二遍) | — | — | flush | |
| wait | i2 div(第二遍) | — | — | flush |
i3 commit时发现预测错了:后面两条全部flush,RAT清空,再从i4 ret重新取指。
说明flush掉的指令哪怕已经执行完(第二遍的i1),结果也只在PRF里,没进ARF,丢掉不影响正确性。
异常也一样:出异常的指令先在ROB里记下,等它走到head再处理。这时前面的都commit了、后面的都flush掉,寄存器状态正好停在这条指令之前,这就是精确异常(precise exception)。
这样最简单:分支前面的指令都commit了,ARF就是正确的状态,RAT清空就行。代价是要等分支走到head,这段时间错误方向的指令还在白白占用资源。很多处理器在分支执行完就开始恢复,要靠在每个分支给RAT存一份快照(checkpoint)。
五、Issue逻辑
现代CPU有上百个RS项,issue这一级常常是整个处理器的关键路径(critical path)。它拆成两步:
- Wake-up:writeback广播一个物理寄存器编号,所有在等的RS项同时拿它和自己等的编号比较,对上的标ready。这么多比较一般用CAM(content addressable memory,按内容查找的存储)来做
- Select:从ready的指令里挑一条发出去(上篇「Issue:从RS发出去」说的「常见是挑最老的」就在这一步)
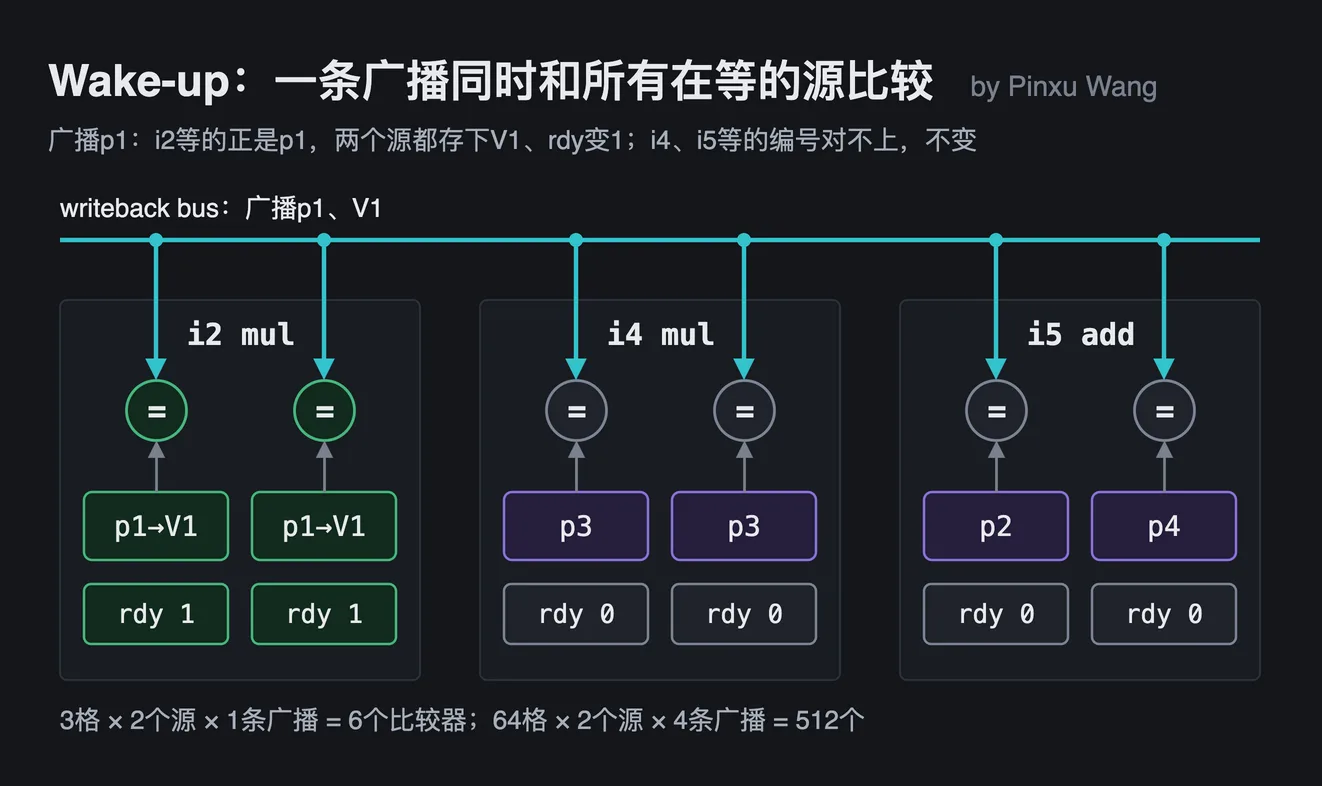
图里这一拍只广播p1:三格RS的6个源各用一个比较器和p1比,只有i2的两个源对上,存下值V1、rdy变1(和上篇「Issue:从RS发出去」的例子是同一拍)。
超标量处理器一拍不止做一条:每个functional unit每拍收一条,几个unit就能一拍issue几条;同一拍也可能有几条一起算完,所以writeback bus也做好几根,几个结果同时广播(bus不够就挑几条,其余等下一拍)。原版Tomasulo只有一根CDB,一拍只能广播一个结果。
慢在两处:
- 比较多:每个在等的源操作数,都要和这一拍的每一条广播各比一次,所以比较器个数 = RS项数 × 每条指令的源操作数个数 × 每拍广播的条数(图最下面一行算了两个例子)
- 时间紧:wake-up和select得在一拍里做完,有依赖的指令才能一拍接一拍地发出去
六、Tomasulo和ERR
乱序处理器常见两种做法:Tomasulo + ROB,和explicit register renaming(ERR)。两种是并列的方案,不是叠加的关系:乱序执行的方式一样,都用RS等操作数、CDB广播叫醒、ROB按顺序commit;区别在于重命名用什么当名字、还没commit的结果放在哪、操作数从哪里读。
下面两张图用同一个例子:add x5, x1, x2,x1已经有值,x2要等ROB第3格那条指令算出来;ROB第2格的x7已经done。存储结构都画成表格,列出每一格存的字段,两张可以逐格对比。
1. Tomasulo + ROB
Tomasulo算法最早用在IBM 360/91上,核心就是上篇「Reservation station」讲的RS和第二章的CDB。原版没有ROB,结果算完就写回寄存器,做不到精确异常;后来加上ROB,才能按程序顺序commit。
这种设计不单独做PRF:结果直接存在ROB那一格里(rd_data),ROB编号(rob_addr)就当物理寄存器编号用,RAT里记的也是ROB编号。
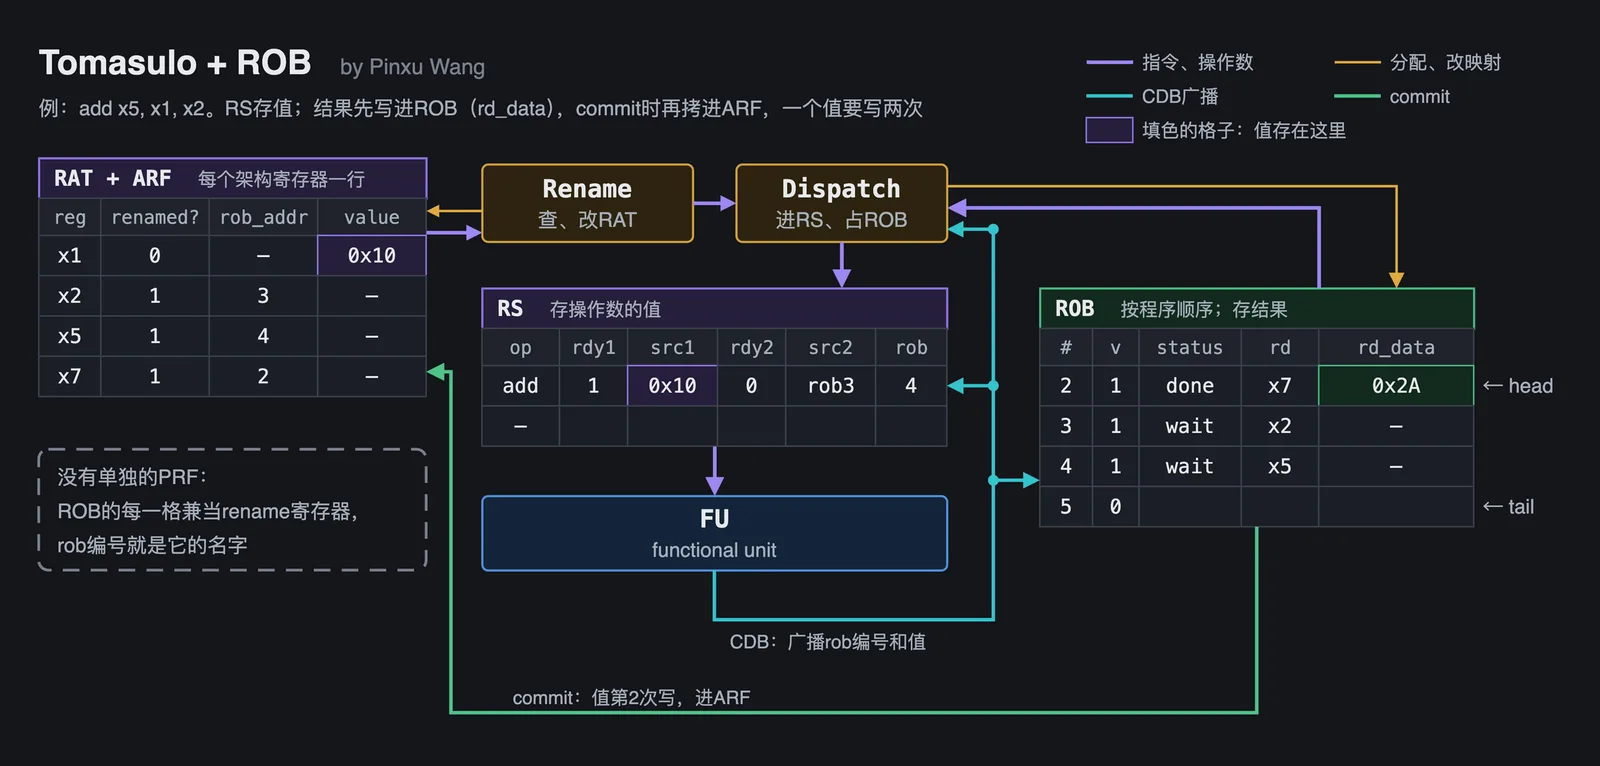
对着图看这个例子:
- x1没换过名:RAT + ARF里renamed? = 0,Rename直接拿到值0x10,Dispatch把它放进RS的src1
- x2换过名:rob_addr = 3,ROB第3格还没算完,RS的src2只能先记下rob3,等CDB广播
- add自己分到ROB第4格:RAT里x5改成指向4;算完后结果先写进ROB第4格的rd_data(值第1次写)
- commit:ROB第2格的x7已经done,值0x2A存在rd_data里,commit时再拷进ARF(第2次写)
图左边那句:ROB的每一格兼当rename寄存器,所以能存值的寄存器一共是32个架构寄存器加ROB的格数。
- 好处:
- 分配简单:Dispatch时分一格ROB,就等于分好了rename寄存器
- commit简单:ROB那一格本来就存着结果,直接拷进ARF
- 整体好做:课件说这种设计一般更容易实现
- 代价:
- 值写两次:先写ROB,commit时再写ARF,多耗能
- 操作数要从三处找:Dispatch时ARF、ROB、CDB同时读,逻辑复杂,加宽(superscalar)以后频率上不去
- ROB端口多、体积大:读操作数、写结果、commit都要访问ROB;每一格都要留放结果的位置,可不是每条指令都写寄存器(store、branch不写)
2. Explicit register renaming(ERR)
E是explicit(显式):重命名用的名字是单独、真实存在的物理寄存器,有专门的分配和回收;Tomasulo借ROB编号当名字,重命名是分配ROB格时顺带完成的,可以叫隐式(implicit)。MIPS R10000用的就是ERR。
ERR的结构:
- PRF:所有值只放在这里,已经commit的、还没commit的都在
- RAT:每个架构寄存器对应哪个物理寄存器,外加一位valid(PRF里的值算出来没有)
- free list:空闲物理寄存器的编号排成队列,Rename从head拿
- RRF(retirement RAT):只在commit时更新的映射,记着已经commit的状态。ERR没有单独的ARF:RRF指向的那些物理寄存器,合起来就相当于ARF
- RS只存编号:issue之后才去PRF读值(read after issue)
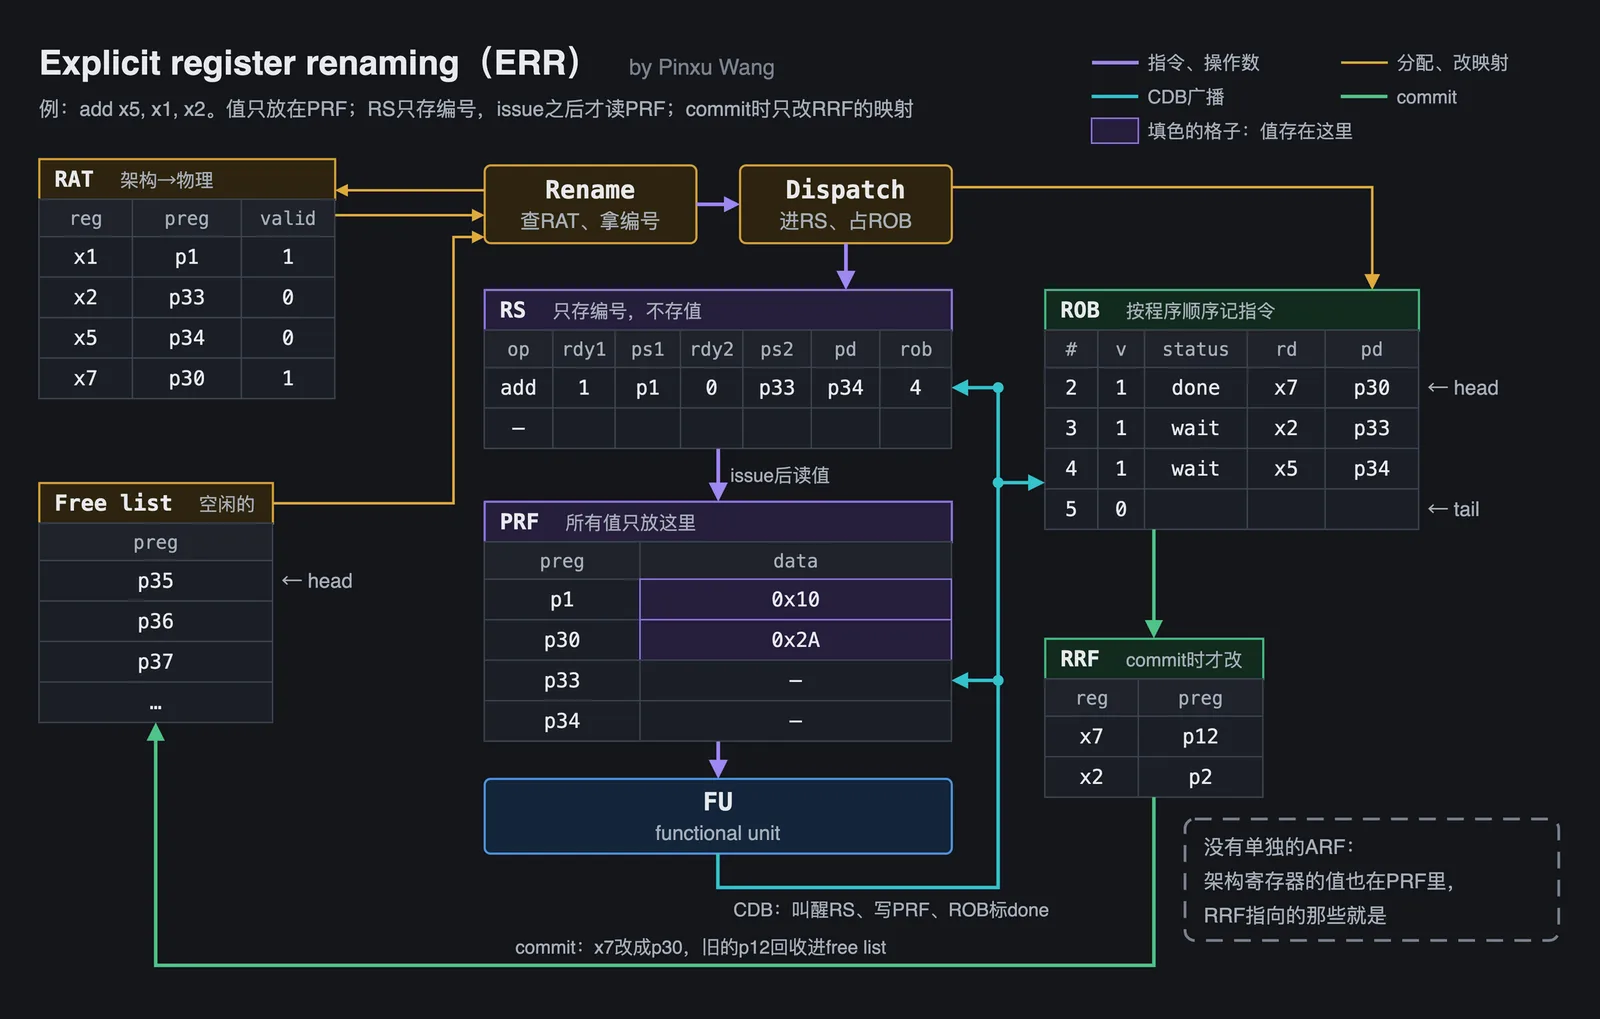
对着图看同一个例子:
- Rename:x1查到p1(valid = 1,值已经在PRF里),x2查到p33(valid = 0,还在等);x5从free list的head拿到p34,RAT里x5改成p34
- Dispatch:RS只记编号,ps1 = p1、ps2 = p33、pd = p34;ROB第4格记下x5和p34
- Issue:等p33 ready以后,从PRF读出p1、p33的值,送进FU
- Writeback:结果写进PRF的p34,CDB叫醒等p34的指令,ROB第4格标done;RAT里x5如果还指着p34,就把valid置1
- commit:ROB第2格的x7已经done,值0x2A早就在PRF的p30里,不用拷;只把RRF里x7从旧的p12改成p30(x7的架构值从此就是p30里的0x2A,相当于写了ARF,但一个值也没拷),p12回收进free list
旧的物理寄存器要等commit才回收:比这条老的指令都commit了,不会再有人读p12;比它新的读的都是p30。分支预测错了,在commit时把RRF整张拷回RAT,就回到了正确的状态。
ERR的三个关键点:
- 值在哪:所有值只放在PRF里,不会拷来拷去。
- 名字从哪来:Rename时从free list拿一个空闲的物理寄存器。
- 什么时候还回去:commit时,把这个架构寄存器上一次用的那个物理寄存器(RRF里记的旧映射)还给free list。
3. 两种方案对比
| Tomasulo + ROB | ERR | |
|---|---|---|
| 重命名用的名字 | ROB编号(隐式) | 物理寄存器编号(显式) |
| 没commit的结果放在 | ROB的rd_data | PRF |
| RS里存什么 | 操作数的值,没到就存ROB编号 | 只存物理寄存器编号 |
| 什么时候读操作数 | Dispatch时,从ARF、ROB、CDB三处找 | Issue之后,只读PRF |
| 一个值写几次 | 两次:ROB、ARF | 一次:PRF |
| commit时做什么 | 值从ROB拷进ARF | 改RRF的映射,回收旧的物理寄存器 |
| 多出来的结构 | — | free list、RRF |
| 例子 | Intel P6 | MIPS R10000 |
两种设计各少一样东西,正好相反:
| 没有单独的 | 原因 | |
|---|---|---|
| Tomasulo | PRF | ROB的每一格兼当rename寄存器 |
| ERR | ARF | 值都在PRF里,RRF指向的那些就是ARF |
课件的主线(单独的PRF + ARF)介于两者之间:像ERR一样有单独的物理寄存器,又像Tomasulo一样commit时把值拷进ARF。
现在的高性能乱序核大多用ERR,比如Intel从Sandy Bridge开始、RISC-V的BOOM:ERR的值只写一次,commit只改映射、不搬数据。寄存器越宽,搬数据越费电;Intel在Sandy Bridge放弃P6的做法、改用PRF,主要就是因为AVX把寄存器加宽到了256位。
参考
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed.
- Wikipedia, Re-order buffer
- Wikipedia, Speculative execution
- Wikipedia, Branch predictor
- Wikipedia, Content-addressable memory
- Wikipedia, Tomasulo’s algorithm
- Real World Tech, Intel’s Sandy Bridge Microarchitecture
- RISCV-BOOM documentation, The Rename Stage
Discussion
Loading comments…
Checking sign-in…