大模型已经能写Verilog了,但它写出来的代码是真能用,还是只是看起来像那么回事?用AI做芯片设计,第一道门槛就是回答这个问题。
NVIDIA从2023年到2026年沿着这个问题发表了一系列论文:先立起能自动判对错的评测,再让模型接上编译器、仿真器和形式工具的反馈,最后让agent(能自己调用工具、分几步完成任务的大模型程序)从失败里积累经验。本文按时间顺序整理其中14篇,集中在前端的RTL设计和验证。
一、研究总览
这条路线按时间可以分成五个阶段:
- 2019—2022:优化算法。大模型出现之前,强化学习、图神经网络和GPU加速先用在placement这类物理设计问题上,如Google的AlphaChip、UT Austin的DREAMPlace。它们说明EDA里靠专家反复调参的环节,可以交给搜索和加速计算
- 2023:评测与领域模型。VerilogEval立起用仿真判对错的评测,ChipNeMo把通用大模型改造成懂芯片的模型,RTLFixer用编译日志自动修语法错误
- 2024:工具与验证。从单一的代码生成,扩展到多种硬件语言(PyHDL-Eval)、功能调试(VerilogCoder)、形式验证(FVEval)和训练数据(CraftRTL);评测本身也在升级(VerilogEval v2),领域模型找回了按指令回答的能力(ChipAlign)
- 2025:多agent与工程任务。多个专用agent接进同一个闭环,如生成断言的AssertionForge、组织任务图的Marco、把验证写成程序的PRO-V-R1;模型本身也开始学长推理(ScaleRTL)
- 2026:上下文演化。agent把每一轮调试的经验记进上下文,带进下一轮(ACE-RTL)
从2023年起,大部分工作都靠可执行的反馈:编译器、仿真器、形式工具给出的结果,既用来评测模型,也用来指导模型改代码。
二、评测与领域基础
2023到2024年的六篇论文给后面的工作打好了基础:
评测(VerilogEval)→ 领域模型(ChipNeMo)→ 语法修复(RTLFixer)→ 多语言评测(PyHDL-Eval)→ 评测升级(VerilogEval v2)→ 训练数据(CraftRTL)
1. VerilogEval
VerilogEval(2023)是这一系列最早的一篇,做了一个Verilog代码生成的评测集。
为什么不比文本相似度:之前评测代码常用BLEU,按生成代码和参考答案字面上有多像来打分。论文统计了两道题,对的代码和错的代码BLEU分数混在一起,分不开:
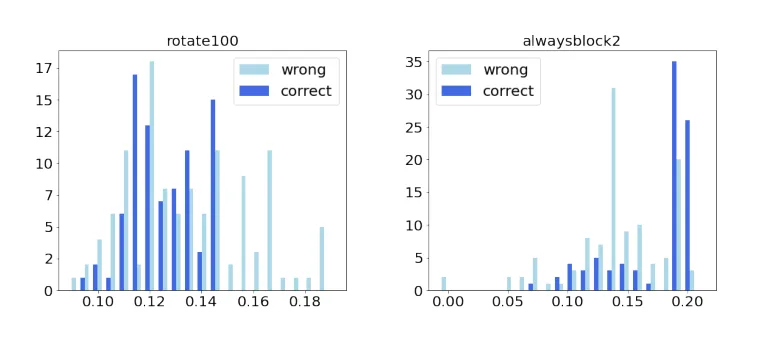
深蓝是对的代码,浅蓝是错的,两种颜色落在同一段分数里。硬件代码尤其如此:写法差很多的两段代码可能功能一样,posedge写成negedge却只差一个词。所以VerilogEval用仿真判对错:评测看的是行为等价,不是文本相似。
题目:156道题,来自Verilog练习网站HDLBits,从组合逻辑到状态机都有。每道题给出描述和端口声明(端口给定,免得位宽有歧义),模型补全module内部:
- 描述:Given an 8-bit input vector [7:0], reverse its bit ordering.
- 端口:module top_module (input [7:0] in, output [7:0] out);
- 参考答案:assign {out[0], out[1], …, out[7]} = in;
HDLBits很多题靠图描述(状态转移图、卡诺图、波形),论文把图改写成文字,有两个版本:
- VerilogEval-machine(143题):GPT-3.5看着答案写的描述,常常逐行复述代码
- VerilogEval-human(156题):人工改写,讲的是功能,更接近真实的spec,也更难
怎么判对错:生成的代码和参考答案放进同一个testbench,用开源仿真器Icarus Verilog跑,比较输出。激励一部分是人工写的关键pattern,一部分是随机的。
pass@k:每道题让模型生成n份代码,看其中有几份能通过。
- 随机挑1份:挑中通过的概率是5/20,pass@1 = 25%
- 随机挑5份:5份全不通过的概率约19%,pass@5 = 81%
说明k越大越容易过;pass@1衡量的是一次就写对的能力。
pass@k就是随机挑k份、至少有一份通过的概率,对所有题取平均。
结论:
- 合成数据微调有用:给GitHub上8,502个Verilog module各配一段GPT-3.5写的描述,做SFT(supervised fine-tuning,有监督微调:拿成对的输入和标准答案继续训练模型)。微调后的16B开源代码模型,在VerilogEval-human上pass@1是28.8%,和GPT-3.5(26.7%)相当
- 数据质量比数量要紧:把描述和代码随机打乱配对再训练,效果掉回和没训练时差不多
- 软件代码帮不了多少:在C、Java等代码上预训练过的模型,比只学过自然语言的模型只高约3%
局限:题目都是不例化子模块的小module;只查功能,不查可综合性和PPA。
- AI写的RTL交给仿真判对错:先备好testbench和参考结果,用仿真结果说话,不靠读代码判断像不像。过了testbench也只说明它测到的地方是对的,还要看覆盖率
- 给AI的描述写明容易有歧义的地方:位宽、上升沿还是下降沿触发、复位高有效还是低有效、同步还是异步
2. ChipNeMo
VerilogEval解决了怎么评测,ChipNeMo(2023)解决的是另一个问题:通用大模型不懂芯片公司内部的东西。内部的设计文档、RTL、EDA脚本、bug记录和大量缩写,通用模型训练时都没见过,直接用就会误解术语、编出工具里不存在的API。
做法:从头训练一个芯片模型要上百万GPU小时。ChipNeMo以Meta开源的LLaMA2为底座,组合了四种方法:
- 改tokenizer(分词器:把文字切成模型处理的最小单位token):加入约9千个芯片领域的token,同样的芯片资料切出的token少了1.6%~3.3%
- 继续预训练(DAPT,domain-adaptive pretraining):用约240亿token的芯片资料接着训练,算力不到从头训练的1.5%
- 对齐(alignment:再训练一遍,让模型按指令回答,而不只是续写):用公开的对话数据,加约1,400条芯片领域的指令
- 检索增强(RAG,retrieval-augmented generation:回答前先从文档库找出相关段落,和问题一起交给模型)
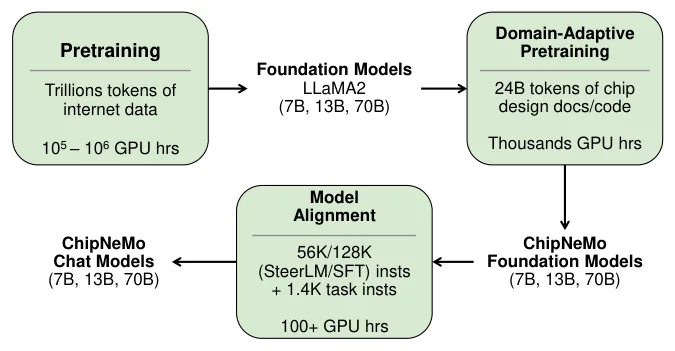
图里是训练顺序:LLaMA2的预训练 → 继续预训练 → 对齐,每一步的GPU小时都比上一步少得多。
结果:在问答助手、EDA脚本生成、bug摘要三个内部应用上评测:
- 70B的ChipNeMo在问答助手和EDA脚本生成上超过GPT-4,bug摘要上仍不如GPT-4
- 内部的一个Python工具,GPT-4写的脚本几乎全错,因为没见过它的API
- 四种方法里,贡献最大的是继续预训练
副作用:继续预训练会削弱模型按指令回答的能力。在已经对齐好的LLaMA2-Chat上继续预训练,模型基本没法用,所以只能先继续预训练、再重新对齐。这个问题后来由第三章的ChipAlign解决。
- 问内部问题,把相关文档一起给AI:通用模型没见过公司内部的设计和工具,直接问容易编;把相关的spec、文档段落一起贴进去,就是手动做了一次RAG
- 常见问题的答案写在文档的一段里:ChipNeMo的检索在spec类问题上效果好,在testbench、build类问题上差,因为后者的答案分散在好几处。写验证环境、回归流程的文档时,把常见问题直接写成问答
3. RTLFixer
RTLFixer(2023)关注一个更基础的问题:大模型写的Verilog,很多连编译都过不了。GPT-3.5在VerilogEval-human上写错的代码里,约55%是语法错误,比仿真出错的还多,如在always块里给wire赋值、用了没声明的信号。
做法:让模型自己调用编译器,按编译日志一轮轮改,直到编译通过:
生成代码 → 编译 → 拿到错误日志 → 查修复建议 → 修改代码 → 再编译
- ReAct(一种提示方法:让模型交替写出思考、行动、观察,行动可以是调用工具):每一轮先分析错误,再决定调用编译器、查修复建议,还是提交代码
- 修复指导库:人工整理的「错误类型 → 解释和修法」,用Intel的FPGA工具Quartus时一共45条
- 观察:编译报错「out is not a valid l-value」
- 思考:out声明成了wire,却在always块里赋值
- 行动:拿这条报错去指导库里查,修法是「能用assign就不用always块」
说明每一步的依据都来自工具:错误来自编译器,修法来自指导库。
结果(212段有语法错误的代码,GPT-3.5):
- 修复率:给一次日志、改一次,修好58.7%;用ReAct多轮修,79.9%;再加上指导库,98.5%
- 日志越清楚,修得越好:同样的方法换成Icarus Verilog的日志,只修好82.0%,它的日志有时只有一句「I give up.」
- 修完语法,功能还差得远:VerilogEval-human的pass@1只从26.7%升到36.8%
RTLFixer改变了编译器的角色:原来编译器只在最后验收,现在它进入生成过程,成了模型每一步的反馈来源。后面的工作把同样的思路用到了仿真和形式验证上。
- 把常见编译错误的修法整理成表:45条的指导库,就把修复率从79.9%提到98.5%。团队里反复出现的编译、lint报错,值得写成「报错 → 原因 → 修法」的对照表,人和AI都能用
- 编译通过只是第一步:语法修好以后,功能上的通过率只提高了10个百分点
4. PyHDL-Eval
前三篇只看Verilog。PyHDL-Eval(2024,NVIDIA和Cornell合作)把评测扩展到Python嵌入式DSL(domain-specific language):用Python库描述硬件,可以直接仿真,也能转成Verilog。论文测了PyMTL3、PyRTL、MyHDL、Migen和Amaranth五种,共168道题。
电路:输入先进一级上升沿触发的寄存器(带使能、高有效的同步复位),输出是寄存器的值加一。
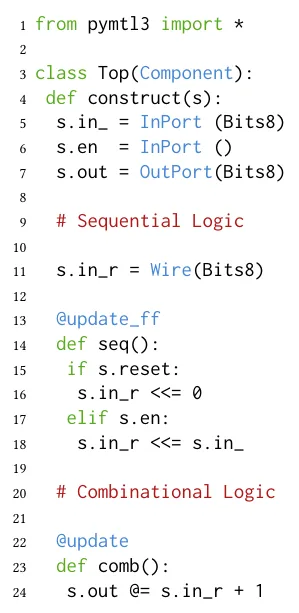
说明DSL虽然是Python,写法却是这个库自己的一套:时序逻辑在@update_ff里用<<=赋值,组合逻辑在@update里用@=赋值。模型没见过这套写法,就容易写错。
结果:
- 写Python DSL远不如写Verilog:GPT-4 Turbo写Verilog的通过率是72.2%,写5种DSL只有29.8%~62.0%
- 不给示例几乎写不出来:不给示例时,GPT-4以外的模型写PyMTL3都不超过2%。模型懂概念,但总在基础的地方出错,如import一个不存在的库、用已经废弃的语法
- 给一个示例就大幅改善:在提示词里先放一个写好的示例(in-context learning,上下文学习),Llama3 70B写PyMTL3的通过率从0.6%升到27.3%
- 难的题型一样:不管哪种语言,时序运算、仲裁器、卡诺图、波形题和复杂状态机都难
局限:只用各DSL自带的Python仿真来测,转不成Verilog的模块也可能通过。
- 用小众语言或内部的库,先给AI一个能跑的示例:没见过的库,AI会编出不存在的import和API;贴一个现成的例子,比反复描述需求有效。用组里自己的UVM基类、VIP接口写代码时也一样
5. VerilogEval v2
Revisiting VerilogEval(2024,下文称VerilogEval v2)一年后回头升级了VerilogEval,保留VerilogEval-human的156道题,改了三处:
- 增加spec-to-RTL任务:v1只让模型续写模块,v2给出规格,让模型写出包括端口在内的整个模块,更接近工程师的实际工作
- 支持上下文学习:提示词里可以放0~3个示例
- 自动给失败分类:在Icarus Verilog的输出里匹配关键词,看出模型错在哪
评分仍然靠仿真判对错。
结果:
- 新模型进步明显:GPT-4o在spec-to-RTL上的通过率是63%,开源的Llama3.1 405B是58%
- 示例不是越多越好:多数模型加了示例会变好,Llama3 70B却变差了。提示词的效果因模型、因任务差别很大
- 失败分类能找到可以针对性修的问题:如Llama3 70B做代码补全时经常漏写endmodule
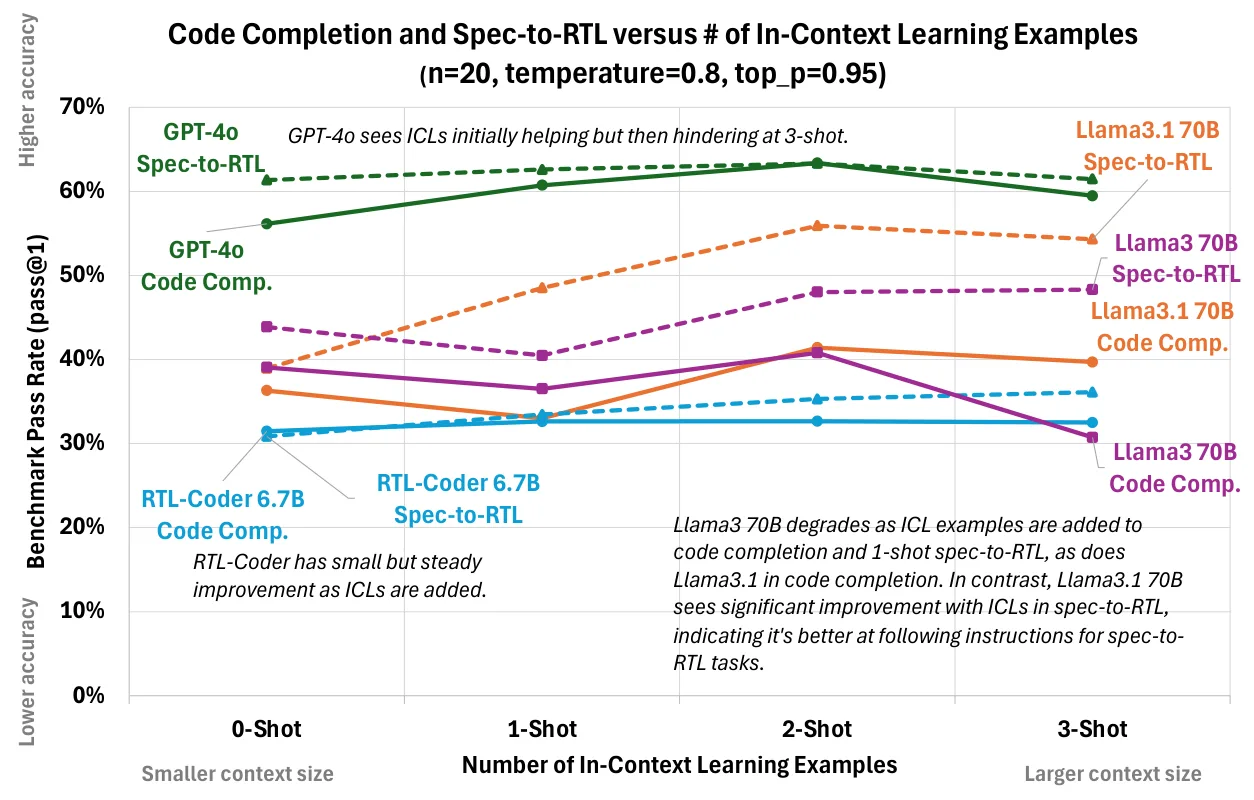
横轴是示例个数,实线是代码补全,虚线是spec-to-RTL。Llama3 70B(紫色)的代码补全,示例从0个加到3个,通过率从约40%降到30%出头。
- 选AI工具,用自己的题实测:同样的提示词,换一个模型效果可能差很多,加了示例也可能变差。选模型、定提示词模板,应该拿组里真实的模块和测试跑一遍
- 把AI反复犯的错写进提示词或检查脚本:像总漏写endmodule这类错,加一条检查就能拦住
6. CraftRTL
VerilogEval的训练数据,是让GPT-3.5给GitHub上的代码写描述得来的。CraftRTL(2024)发现,用这类数据微调出的模型有两个问题:
- 看不懂非文字的规格:卡诺图、状态转移图、波形,即使写成了文字表格,GPT-4o的pass@1也只有27.0%,全部人工描述题是55.4%
- 随机犯小错:同一道题,这个checkpoint(训练中途保存的模型版本)做对,下一个又做错,错的多是向量拼接顺序写反这类小地方
CraftRTL针对这两点改造训练数据:
- 构造即正确(correct-by-construction):用程序同时生成题目和答案,两者出自同一份随机配置,答案一定正确,一共2.85万道卡诺图、状态机和波形题
- 针对性的修复题:让大模型总结各个checkpoint常犯的错,再把这些错注入开源的正确代码,做成「题目 + 有错的代码 + 修改提示」
- 随机选变量个数,再随机选哪些输入组合输出1、哪些是无关项(don’t care)
- 由选出的组合写出积之和(SOP)表达式,转成Verilog,作为答案
- 用同一组输入组合画出真值表和卡诺图(行列按Gray码排列),作为题目
说明题目和答案出自同一组随机数,不用额外验证就知道答案是对的。
结果:微调后的15B开源模型(StarCoder2),在VerilogEval-human上的pass@1比之前最好的结果高10.9%。
这说明硬件的训练数据不能像软件那样靠爬公开代码来凑:公开的Verilog本来就少,又要求功能严格正确,造数据本身就是一项验证工作。
- AI写卡诺图、状态机、波形这类模块,要逐项核对:对着真值表、状态转移逐条检查,小的组合逻辑可以写testbench把输入全部遍历一遍
这六篇解决的是三件事:
- 用什么判对错:VerilogEval、VerilogEval v2、PyHDL-Eval用仿真结果说话,并跟着模型和语言更新
- 模型懂不懂芯片:ChipNeMo补领域知识,CraftRTL补训练数据
- 错了怎么改:RTLFixer让编译日志进入修改循环
后面的验证、工具闭环和agent,都建立在这三件事上。
三、验证与工具闭环
第二章解决了语法和评测,这一章往验证走:先让模型能调试功能错误,再评测和生成断言,然后把分散的agent组织起来,最后补上ChipNeMo留下的指令遵循问题。
功能调试(VerilogCoder)→ 断言评测(FVEval)→ 断言生成(AssertionForge)→ 多agent框架(Marco)→ 指令对齐(ChipAlign)
1. VerilogCoder
RTLFixer只修语法,修完后功能错误还在。VerilogCoder(2024)要解决的是:仿真不通过时,模型怎么找到是哪段逻辑错了。思路来自人怎么debug:输出和期望不符,就顺着驱动它的信号一级级往回查,边看代码边看波形。
做法:多个agent分工:
- 规划:先把模块描述拆成子任务,每个子任务关联到相关的信号和状态转移,再逐个写代码
- 仿真:用Icarus Verilog检查语法、跑testbench
- 波形追踪:从不匹配的输出出发,在代码的AST(abstract syntax tree,语法树)里找出驱动它的信号,再找驱动这些信号的信号;最后把相关代码和这些信号的波形一起交给模型
代码里有两条assign:and1 = a_in | b_in,q = c_in | and1。仿真报告输出q有12处和期望不一致。
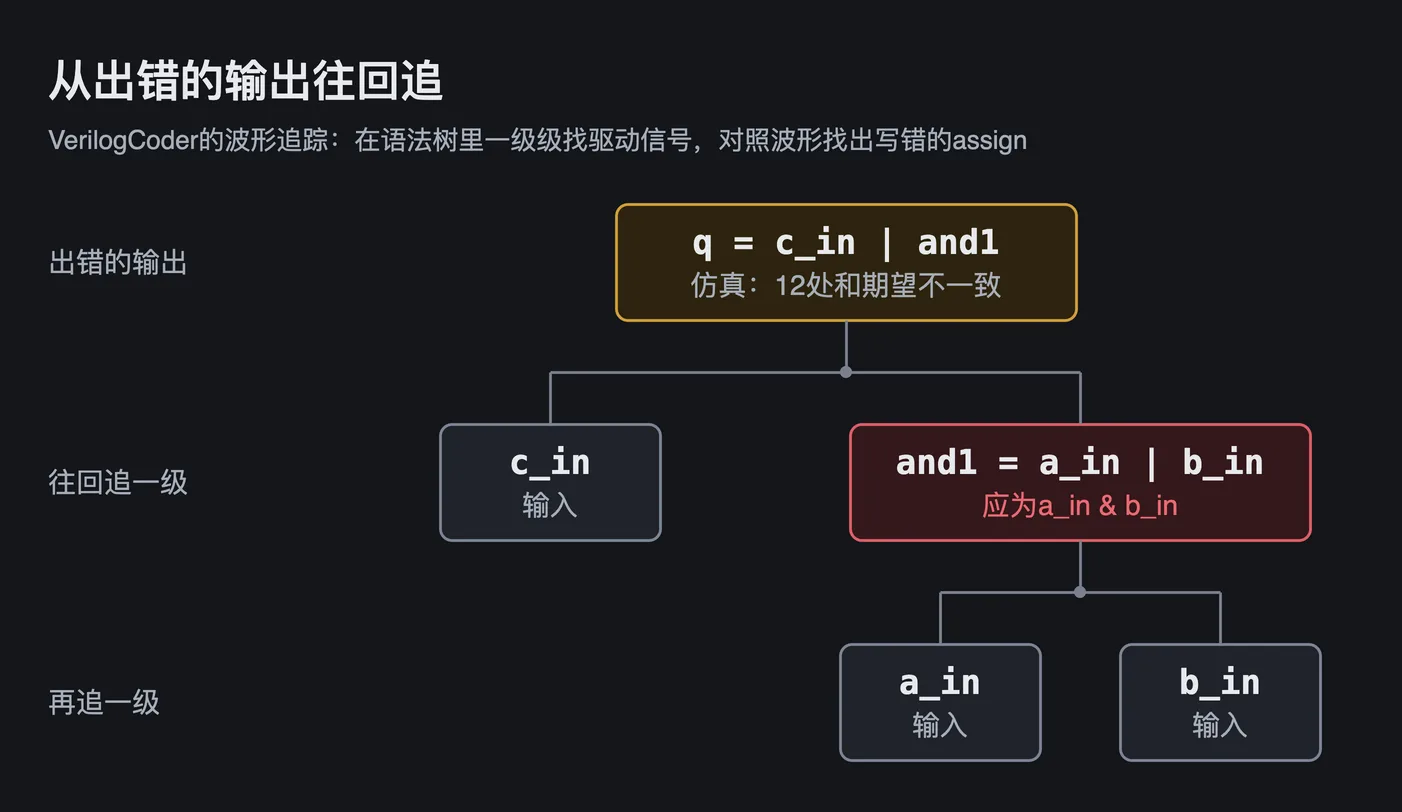
- 往回追一级:把c_in、and1的波形和q的期望值、实际值放在一起看
- 再追一级:对照a_in、b_in的波形,看出and1把&写成了|
说明定位靠的是电路里的驱动关系,和人顺着波形往回查是同一个思路。
结果(VerilogEval v2的spec-to-RTL题,GPT-4 Turbo):
- 提升很大:直接生成是60.3%,VerilogCoder是94.2%。拆开看,普通规划是66.7%,规划关联上电路信息是74.4%,再加上波形追踪才到94.2%
- 代价是更多的token:用量约为直接生成的13倍
- 让AI debug功能错误,给它出错的信号和波形,不只给代码:最大的一步提升来自波形追踪。可以把仿真log里不匹配的信号、出错时刻附近的波形和相关代码一起贴给AI
- 先拆任务再写:把需求拆成子任务、每步对应具体的信号,比一次让AI写完整个模块准确
2. FVEval
VerilogCoder判断对错靠仿真。形式验证要的是证明性质成立,判断AI写的断言对不对更难。FVEval(2024)是第一个系统评测大模型做形式验证的benchmark。
为什么要新的评测:语法正确、看起来像专家写的SVA,不代表它检查的就是规格要求的那个性质。所以FVEval用Cadence的形式验证工具Jasper,证明生成的断言和专家写的参考断言是否逻辑等价;不完全等价、但一个能推出另一个的,算部分正确。
三类任务:
- NL2SVA-Human:按自然语言描述写SVA,79条断言来自专家写的formal testbench(FIFO、仲裁器、状态机等)
- NL2SVA-Machine:断言由程序随机生成,再配上描述,用来大量压测
- Design2SVA:只给RTL,让模型自己找出值得验证的性质
结果:NL2SVA-Human上每题生成5次,统计5次里至少有一次通过的题占多少(pass@5),GPT-4o的结果如下:
| 指标 | GPT-4o(pass@5) |
|---|---|
| 语法正确 | 98.7% |
| 和参考断言等价 | 46.8% |
| 部分正确 | 65.1% |
- 语法几乎都对,功能上不到一半
- 会编出不合法的写法:描述里出现什么词,模型可能就直接拿来当运算符用(见下例),GPT-4o这些最强的模型也一样
- BLEU和断言是否等价几乎不相关:和VerilogEval的结论一样,判对错还是得靠工具
- 描述:FIFO写入(wr_push)之后,数据eventually会被读出(rd_pop)
- 参考断言:
wr_push |-> strong(##[0:$] rd_pop) - Llama-3.1-70B写的:wr_push |-> eventually(rd_pop),语法检查没过
说明模型把描述里的词直接当成了运算符。SVA里的eventually必须带有界的范围,如eventually [1:5] rd_pop。
- AI写的断言,要用工具确认它查的就是想要的性质:有参考断言就做等价检查;没有参考,至少在故意注入bug的设计上跑一遍,确认它会报错
- 给AI描述性质时,把时间关系写具体:描述里写了eventually,模型就可能写出SVA不支持的用法;写成「在n个周期内」更稳
3. AssertionForge
AssertionForge(2025)用来生成断言。之前的方法(如AssertLLM)只读spec,看不到RTL里的实现细节,写出的断言看着合理、实际不对;只读RTL又不知道设计意图,断言只是在复述实现。
做法:
- 建知识图谱(knowledge graph:把实体和它们之间的关系存成一张图):用大模型从spec里抽出模块、信号、状态这类实体和关系,再用Verilog解析器从RTL里抽结构,合成一张图
- 分三层给上下文,不把spec和RTL全文塞进提示词:
- 全局摘要:设计整体做什么
- 针对信号的检索:和当前信号相关的spec段落、RTL片段
- 在图上沿关系走:从当前信号出发,找到和它相关的信号、模块
- 筛选、生成、证明:筛掉多余的上下文,先写测试计划、再写SVA,最后交给Jasper证明
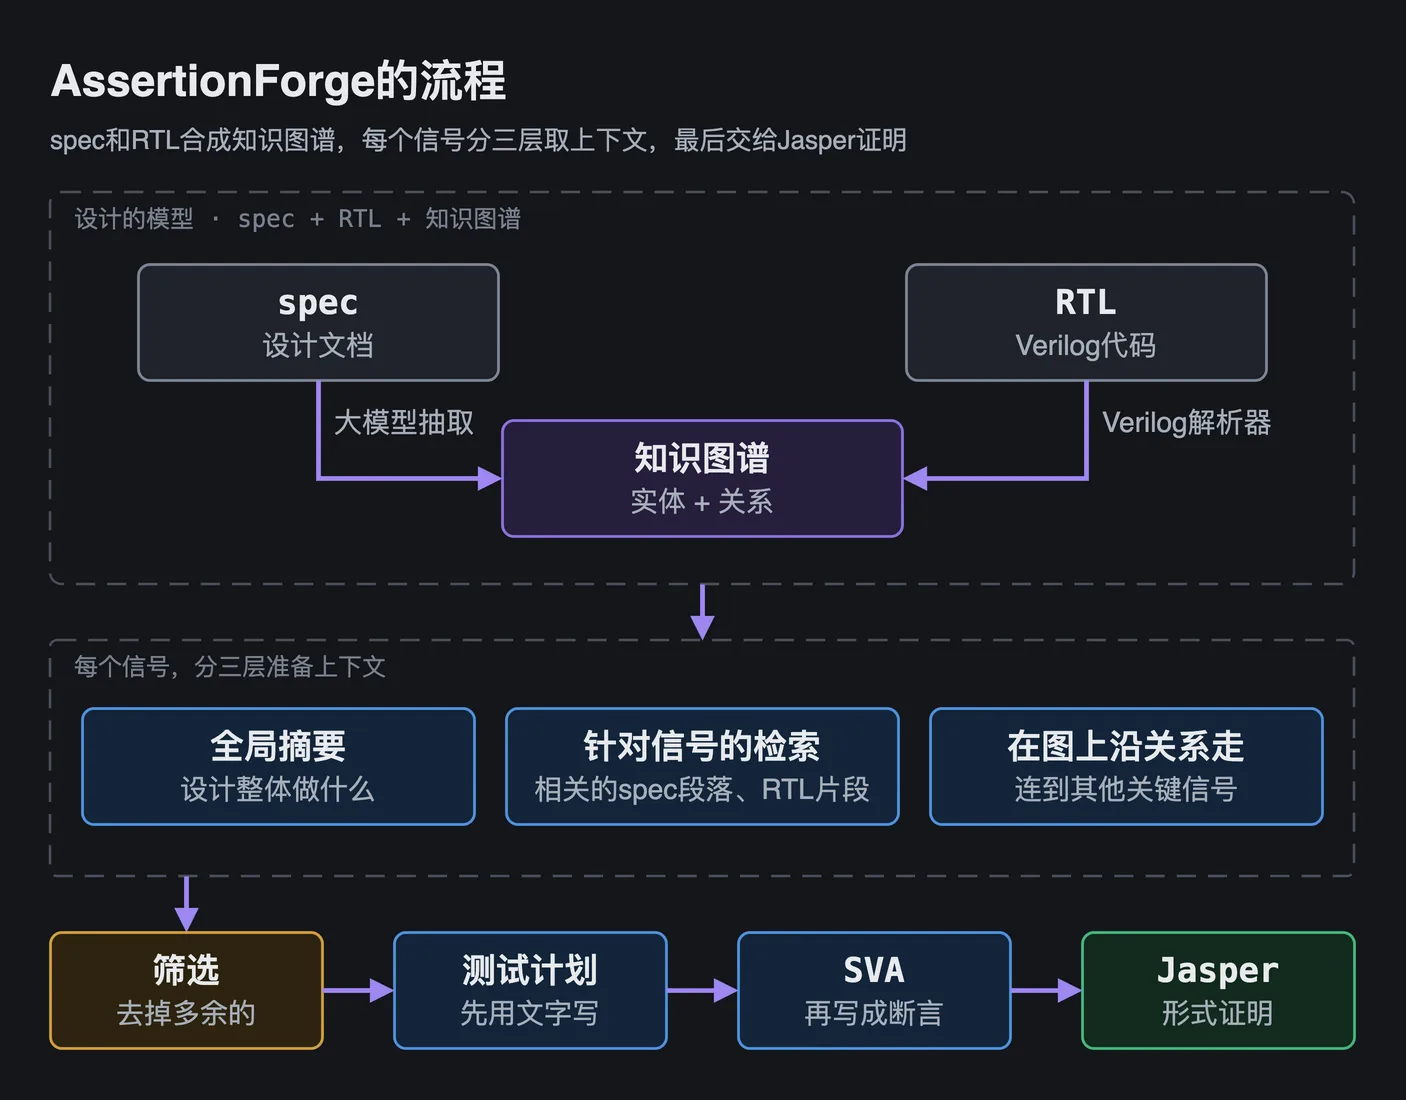
结果:在5个开源设计上用GPT-4o测试。以以太网MAC控制器ETHMAC为例,被证明成立的断言从15条(AssertLLM)增加到208条,COI功能覆盖率(cone of influence:会影响断言结果的那部分逻辑里,被覆盖的功能占多少)从49.0%提高到99.1%。
其他条件都相同,比较两种方式生成的断言:
| 给上下文的方式 | 被证明的断言 | COI功能覆盖率 |
|---|---|---|
| spec和RTL全文直接拼进提示词 | 9条 | 70.4% |
| AssertionForge的三层上下文加筛选 | 27条 | 88.8% |
说明信息不是给得越多越好,全文直接塞进提示词的效果最差。
局限:论文默认RTL是对的,证明失败时没有分析是RTL错了还是断言错了。
- 让AI写断言,spec和RTL都要给,但要挑着给:先给设计的整体说明,再给和目标信号相关的spec段落和RTL片段
- 从RTL推出来的断言要回头确认:AI可能把RTL的bug当成设计意图写进断言,这类断言要和spec、设计人员核对后再用
4. Marco
前面的RTLFixer、VerilogCoder都只解决一个任务,彼此不能协同。Marco(2025)提出一个统一的框架,把这些agent组织起来。
做法:
- 任务图:把一个硬件任务拆成子任务,节点是子任务,边是执行顺序或知识上的依赖。图有两种:
- 静态:事先定好,agent照着图做
- 动态:agent边做边按当前的想法加子任务
- 每个子任务配一套:用AutoGen(微软开源的多agent框架)配置单个或多个agent,再接上知识库、工具和记忆。VerilogCoder就是在这个框架上实现的
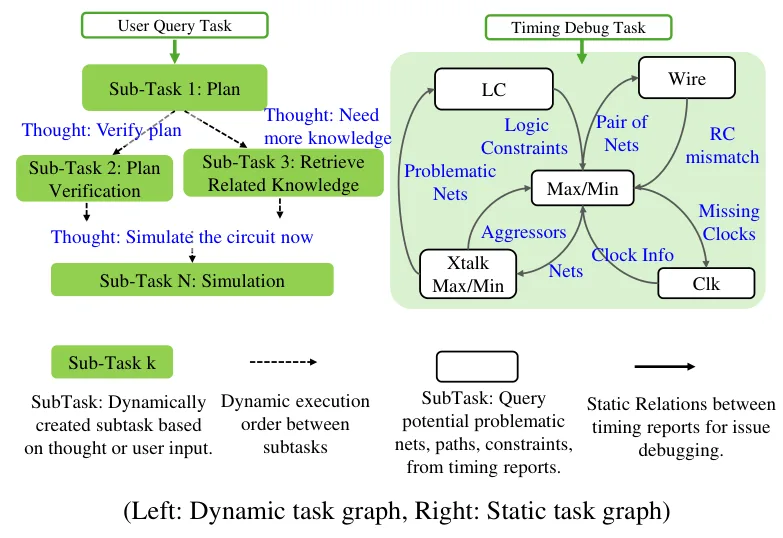
左边是动态任务图:比如agent觉得知识不够(蓝字的Thought),就加一个检索子任务。右边是时序debug用的静态任务图:每个节点查一类时序报告,节点之间的关系事先定好。
结果:论文是一篇3页的短文,展示的agent多在后端。直接对比了用不用任务图的是时序路径debug:7个任务,按静态任务图做解决了6个,不用任务图一个都没解决。论文没有讨论可靠性:检查不准时,一个agent的错会传给下一个。
- 让AI做多步的工作,先由人把步骤和每步的检查方法定下来:回归失败分析、覆盖率收集这类多步工作,先把流程固定下来,再让AI在每一步里干活,每步的结果用工具检查
5. ChipAlign
ChipNeMo留下了一个问题:继续预训练后,模型按指令回答的能力变差了,比如工程师要求「只根据给出的资料回答」,它常常做不到。要补回来,直接的办法是把芯片数据和指令数据放在一起训练,但高质量的指令数据大多不公开。
ChipAlign(2024)换了个思路,用模型融合(model merging):不再训练,直接把两个模型的权重合成一个。
- 两个输入:懂芯片的LLaMA2-70B-ChipNeMo,会听指令的LLaMA2-70B-Chat,两者结构相同
- 怎么合:每一层的权重分三步处理:
- 各自除以自己的大小(Frobenius范数),变成单位球面上的两个点
- 沿两点之间的弧(测地线)取一点,λ = 0是通用模型、λ = 1是芯片模型,论文取0.6
- 再缩放回原来的大小
- 代价小:不用GPU训练,合成一个70B模型在CPU上只要43分钟
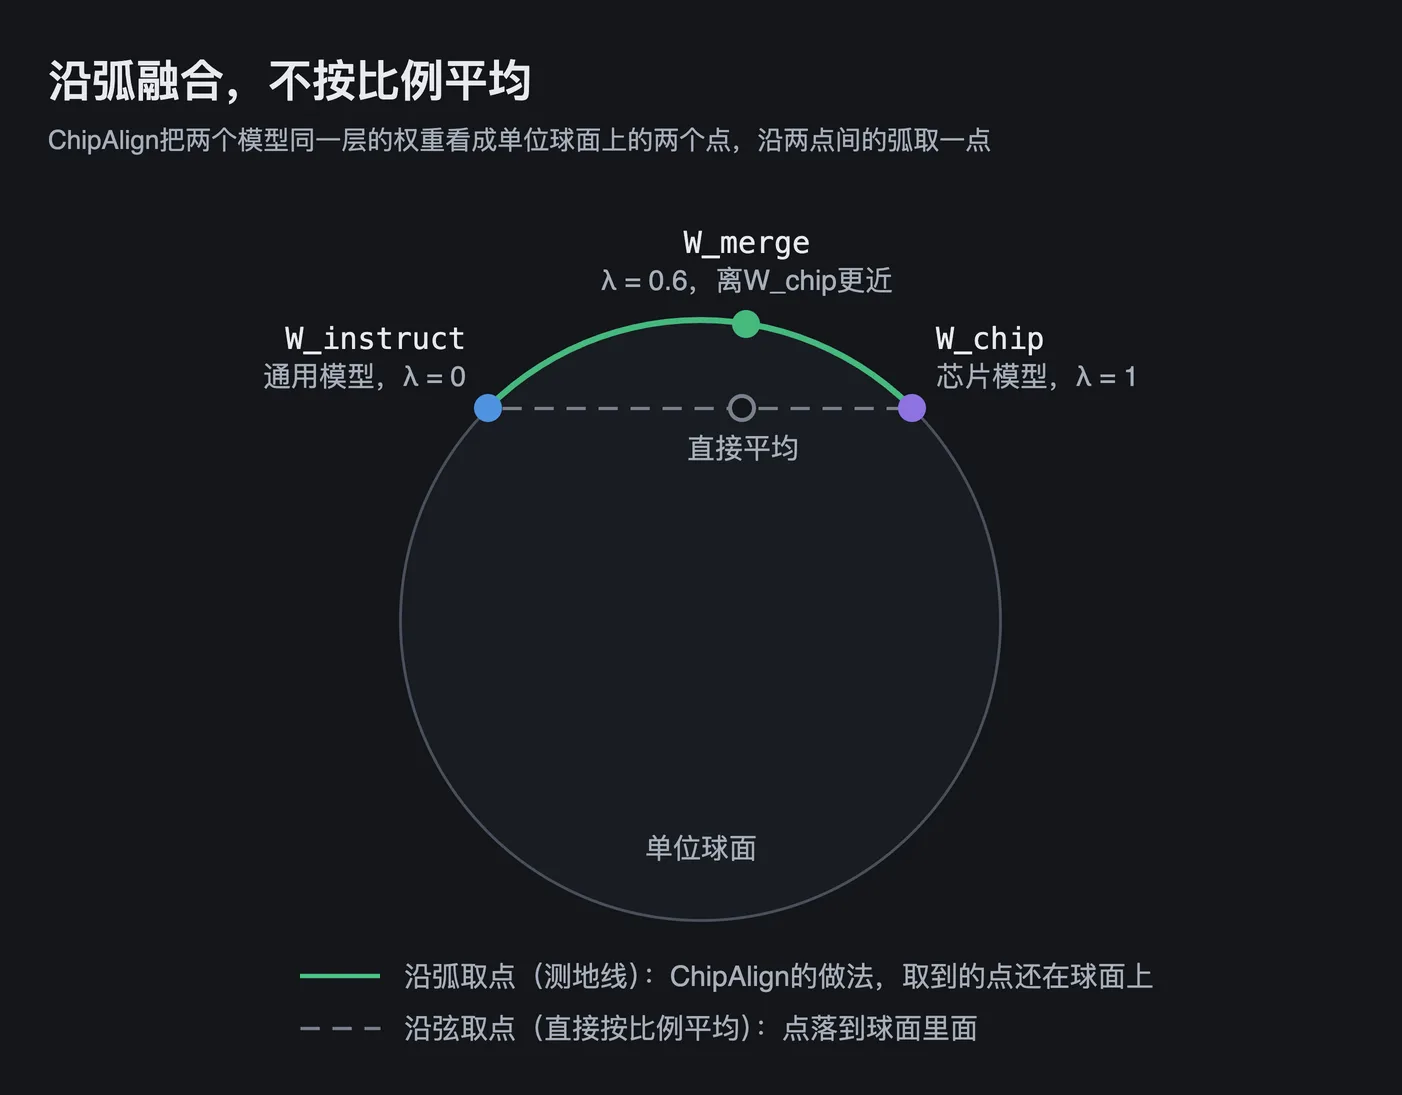
结果:
- 听指令明显变好:IFEval(测模型能否照指令要求输出,如字数、格式)上,比ChipNeMo平均高26.6个百分点,还超过了原来的Chat模型
- 芯片知识基本保持:芯片选择题的准确率和ChipNeMo相当(68.7%对69.4%)
- 带指令的芯片问答变好:NVIDIA内部的芯片问答,比两个原模型最多高8.25%
- 指令:只用给出的资料回答;问题:怎样用构建工具编出某个sandbox target
- LLaMA2-70B-Chat:答案和资料对不上,25分
- LLaMA2-70B-ChipNeMo:答案和资料对不上,50分
- LLaMA2-70B-ChipAlign:按资料回答,100分
说明两个原模型都没照「只用资料」这条指令做,融合后的模型做到了。
融合解决的是听不听指令,不保证回答本身正确;编出不存在的API这类错误,仍要靠实际编译、运行来发现。
加上第二章的RTLFixer,三类错误都有了对应的工具反馈:
- 语法错误:编译器(RTLFixer)
- 功能错误:仿真器和波形(VerilogCoder)
- 断言查得对不对:形式工具(FVEval、AssertionForge)
Marco用任务图把这些agent组织起来,ChipAlign用模型融合让领域模型重新能按指令回答。
还没完全解决的是工程环境:
- 设计规模:RTL生成的评测仍以单个模块为主,多文件、层次化的设计还没覆盖
- 工具链:工具的版本、权限和成本还没考虑进来
- 数据:工业界的形式验证资料大多不公开,结果难以复现
四、推理与上下文演化
第三章靠外部工具给反馈,这一章转向模型和agent自己:先让模型学会长推理,再把验证agent训练出来,最后让agent从失败里积累经验。
推理扩展(ScaleRTL)→ 可训练的验证agent(PRO-V-R1)→ 上下文演化(ACE-RTL)
1. ScaleRTL
第二章的CraftRTL改进的是训练数据,模型还是读完题直接写代码。推理模型(reasoning model:先写出一长段思考过程、再给答案的模型,如DeepSeek-R1)在数学和软件代码上已经说明,想得更久更容易做对。ScaleRTL(2025)把这条路用到了RTL上。
做法:
- 造长推理数据:从公开代码里筛出6.2万段RTL,让DeepSeek-R1给每段出一道题,再照题写出思维链(chain-of-thought,CoT:一步步的推理过程)和代码。每条平均5.6万token,一共约35亿token,是之前最大的RTL数据集的约20倍
- 微调:用这些数据微调一个32B的开源推理模型
- 测试时扩展(test-time scaling:推理时多花算力,让模型想得更久):代码没通过testbench时,在模型想完的地方接上一句纠错提示,大意是「推理可能错了,对照这些RTL规则再查一遍」,让它接着想,最多两轮。只加一个「Wait」不管用,模型会顺着前面的结论交出同样的代码
结果:
- 超过所有RTL专用模型:VerilogEval-human上的pass@1是80.4%,之前最好的CraftRTL-70B是69.7%,GPT-4o是57.1%
- 通用推理模型不够:微调前的模型只有45.5%,微调后是76.3%。会推理不等于会推理硬件
- 没丢掉听指令的能力:RTL专用模型在IFEval上普遍很低(CraftRTL是39.8%),ScaleRTL是73.2%
- 测试时扩展的收益越来越小:
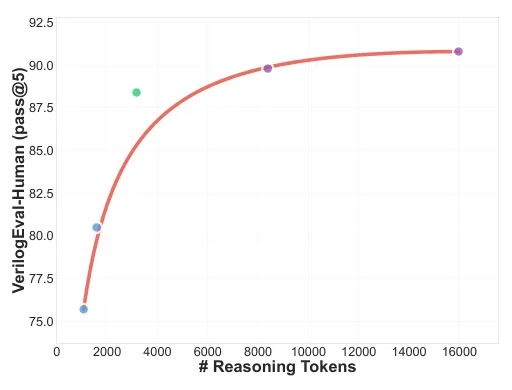
横轴是推理用的token数,纵轴是pass@5。推理从约3千token加到约1.6万,pass@5只从88.4%涨到90.8%,越往后,多花的算力换来的提升越少。
论文没有讨论成本:每轮纠错都要多花上万token。纠错的触发条件是代码没通过testbench,实际用时得先有testbench。
- AI写的RTL没过仿真,把检查清单一起交回去:ScaleRTL只加了一句「对照规则再查一遍」,pass@1就从76.3%升到80.4%。团队常犯的错误可以整理成清单(时序要求、复位方式、位宽),连同失败结果一起交给AI重想
- 重试有上限:重试两三轮还不对,就该换办法,比如给它看出错信号的波形,或者把模块拆小
2. PRO-V-R1
前面大多数论文在让AI写RTL,验证的工作量其实更大。PRO-V-R1(2025,UCSD和NVIDIA合作)让开源小模型自动写testbench,并且能针对验证来训练。
问题:
- 写testbench比写RTL难:同一批模型,写RTL的通过率都高于写testbench(testbench算写对:正确的RTL能通过它),见下图
- 现有做法靠闭源大模型:让GPT-4o这类模型用Python写参考模型(FRM,functional reference model),算出期望输出,再和RTL的仿真结果比。成本高,IP有泄露风险,也没法针对验证微调
- Python和Verilog的语义有差别:照Python的习惯写,参考模型本身就错了(见下例)
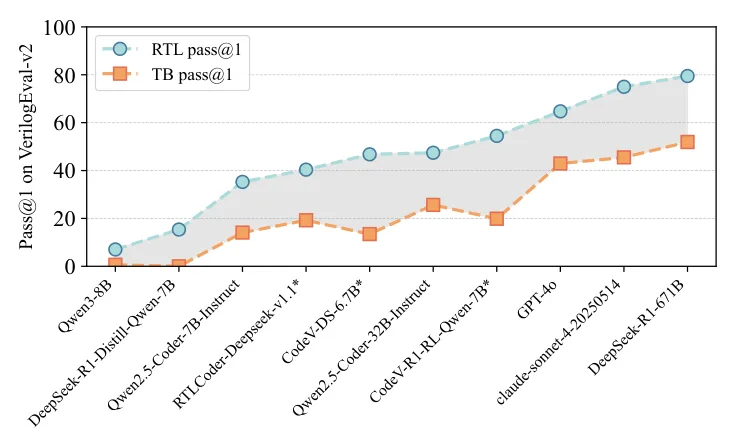
青色是写RTL的通过率,橙色是写testbench的,每个模型的橙色都在青色下面。
信号q的值是1000:
- Verilog(reg [3:0] q):q[3] = 1,q[0] = 0,q[3]是最高位
- Python字符串”1000”:q[0] = ‘1’,q[3] = ‘0’,q[0]是最左边的字符
说明参考模型照Python的习惯取位,算出的期望值就是错的,testbench会拿错的期望值去判RTL。
做法:
- agent系统:三个agent都只写Python,再调用工具执行:
- 测试用例生成:写Python脚本生成激励,不直接写一长串二进制
- 参考模型生成:一次写5个参考模型,各自算出期望输出
- 裁判:5份结果多数表决,改掉个别错的期望值;最后用开源仿真器Verilator跑RTL,和期望输出比对
- 训练:底座是阿里开源的Qwen3-8B。先做SFT:让更强的模型写测试用例和参考模型,只留下参考模型和正确RTL仿真结果完全一致的拿来训练;再做强化学习(RL,reinforcement learning:让模型自己试,按结果给奖励),奖励直接来自仿真
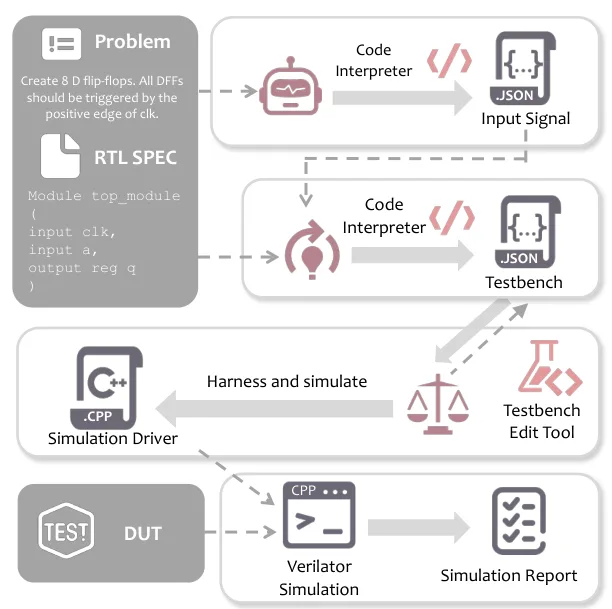
机器人图标是测试用例生成,灯泡是参考模型生成,天平是裁判。
怎么评测:
- Eval1:生成的testbench跑正确的RTL,判为通过
- Eval2-100:每道题生成10个变异体(mutant:在正确RTL里故意改出bug的版本),testbench对10个变异体的判断都和参考testbench一样
结果:VerilogEval v2上,8B的PRO-V-R1的Eval1是57.7%,Eval2-100是34.0%,都超过GPT-4o(43.0%、27.6%)。一步步加上去:
| 做法 | Eval1 | Eval2-100 |
|---|---|---|
| Qwen3-8B直接写 | 0.6% | 0.0% |
| 套用之前的agent系统CorrectBench | 25.6% | 21.8% |
| 换成PRO-V的agent系统 | 39.1% | 28.2% |
| 再加SFT | 50.6% | 27.6% |
| 再加RL | 57.7% | 34.0% |
说明三步都有贡献;只加SFT时Eval2-100没涨,加了RL才涨上去。
换到RTLLM v2.0就难得多:GPT-4o的Eval1是42%,Eval2-100只有6%,所有模型的Eval2-100都不超过6%。论文认为GPT-4o生成的激励又短又单一,能让正确的RTL通过,却很少能暴露变异体。
局限:论文用变异体衡量testbench抓bug的能力,没有涉及覆盖率;验证计划和sign-off标准还得由人来定。
- AI写的testbench,用变异体检查它能不能抓bug:先在RTL里手动改几处(翻一位、改一个条件),看它能不能报错
- 用Python写参考模型,盯住位序和切片:除了下标方向相反,Verilog的q[3:2]含两端,Python的切片不含右端;让AI先把信号转成整数,再用移位取位
- 长位宽、多周期的激励交给程序生成:让AI写脚本生成激励,比让它直接写出一长串二进制可靠
3. ACE-RTL
到2025年,让AI写RTL分成了两条路:一条训练RTL专用模型(CraftRTL、ScaleRTL),一条用通用大模型搭agent、靠仿真反馈修改(VerilogCoder)。
ACE-RTL(2026)把两条路合了起来,名字里的ACE是Agentic Context Evolution(agent的上下文演化)。RTL专用模型懂硬件,但长推理、多步规划和听指令都弱;通用模型会推理、会规划,却缺硬件知识。评测也换成了更难的CVDP(Comprehensive Verilog Design Problems,更接近真实设计的RTL评测集),题目和代码比VerilogEval长几个数量级。
做法:三个角色轮流工作,直到通过测试:
- Generator(写代码):自己训练的32B RTL专用模型。训练数据170万条,除了spec-to-RTL题,还有补功能、修bug的题:让大模型删掉一部分功能、注入真实的bug(状态机转移错、握手时序违例、计数器差一),再配上需求或故障描述
- Reflector(看结果):每轮跑测试,没通过就把错误信息、期望值和实际值整理成报告,交给Claude4-Sonnet分析原因、给出修改方向
- Coordinator(记经验):维护一份每轮都更新的上下文,记下每一轮遇到的错误、给的建议、怎么改的、结果如何,Generator下一轮带着它改。同一个错误连续几轮没有进展,就丢掉当前代码,带着总结出的教训从spec重写
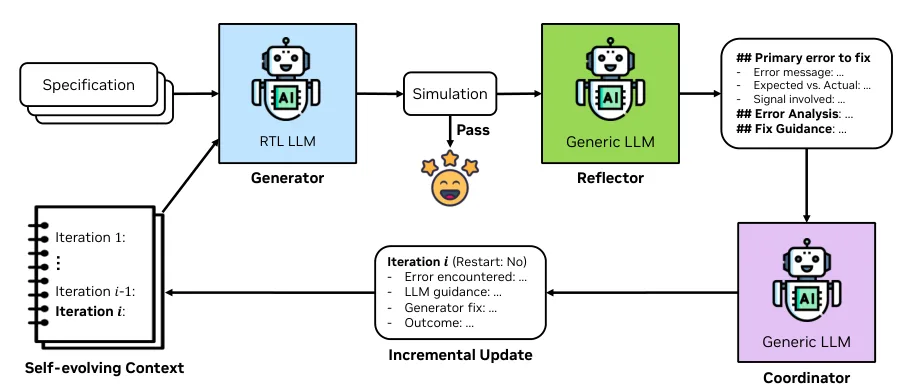
没通过测试时,Reflector写出错误分析,Coordinator把这一轮的记录追加到左下的上下文里,再交给Generator。
模块比较相邻时钟沿的间隔和阈值,判断时钟是否稳定,一共6个测试:
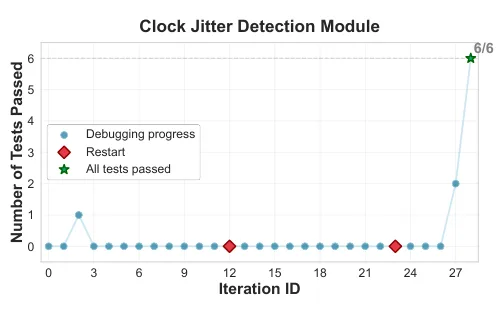
- 二十多轮一个测试都没过:每一版都在第一个完整间隔测出来之前就开始判抖动
- Coordinator发现连续很多轮报的是同一种assertion失败,两次触发重启,并总结出:先确认第一个测量间隔有效,再做检测
- 第二次重启后,Generator加了一个valid标志,6个测试全部通过
说明局部修改走不出来时,把失败的共同原因总结出来、带着它从头重写,比继续打补丁有效。
结果(CVDP):
- 之前的RTL专用模型不够用:ScaleRTL在四类题上的pass@1只有25%~31%,通用的Claude4-Sonnet、GPT-5是36%~54%
- 自己训练的Generator单独用:代码修改题的pass@1有65%,比GPT-5高21个百分点
- 整套ACE-RTL:四类题的解出率(APR,Agentic Pass Rate:多次运行里至少解出过一次的题占比)在81%~96%
四类题平均的APR,一步步加上去:
| 做法 | 平均APR |
|---|---|
| Generator单独用 | 54.35% |
| 加上Reflector,按仿真反馈逐轮改 | 62.17% |
| 再加Coordinator记录每轮的经验 | 83.47% |
| 再加重启 | 89.84% |
| 框架不变,Generator换成Claude4 | 83.92% |
说明提升最大的一步,是把每一轮的调试经验记下来带进下一轮。把RTL专用模型换成通用的Claude4会降到83.92%,RTL专用模型和这套框架是互补的。
局限:
- 只靠文字日志:有的bug要细看时序才能定位。论文有意没给波形,怕agent只照着测试改、不看spec
- spec有歧义:spec和测试强调的行为对不上时,照测试改不出真正的设计意图
- 和AI来回改代码时,把每轮的尝试记下来交给它:维护一张「试过什么、结果如何」的表,每轮贴回去,免得它重复犯同一个错
- 同一个错连续出现,就重开:把失败的共同原因总结成一两句话,开一个新对话,带着它从spec重写
ACE-RTL记下的经验只在同一道题里用,换一道题又从零开始。把经验沉淀成跨任务的技能,目前在通用agent上有人在做,如阿里Qwen团队的Trace2Skill(2026):从很多道题的成功和失败轨迹里归纳出一份技能文档(skill:一个SKILL.md加辅助脚本,写给agent的操作手册),换题、换模型都能用。它还没有用到芯片设计。
五、总结
14篇论文串起来看,有三条线一直在往前走:
- 判对错的标准越来越严:从比文本(VerilogEval发现BLEU分不开对错),到看仿真结果,再到用形式工具证明等价(FVEval),再到用变异体检查testbench能不能抓bug(PRO-V-R1)
- 反馈越来越具体:从编译日志(RTLFixer),到出错信号的波形(VerilogCoder),再到每一轮调试的记录(ACE-RTL)。每多给一层,通过率都有明显的提升
- 模型越来越懂硬件:靠领域语料(ChipNeMo)、构造出来的正确数据(CraftRTL)、长推理数据(ScaleRTL)和修bug的题(ACE-RTL)。代价是听指令的能力容易变差,要另外补回来(ChipAlign)
按论文里的数字,各类任务现在大致到了这一步:
| 任务 | 现在的水平 | 出处 |
|---|---|---|
| 修编译错误 | 修复率98.5% | RTLFixer |
| 写单个模块 | agent约95% | VerilogCoder |
| 写复杂设计 | 单个模型pass@1最高65%,agent的APR为81%~96% | ACE-RTL |
| 写断言 | 和参考等价的不到一半 | FVEval |
| 写testbench | 10个变异体全判对的不超过6% | PRO-V-R1(RTLLM v2.0) |
越往下越接近验证,也越难。上面这些数字都建立在现成的testbench或参考断言上,评测题也多是单个模块。AI已经能帮着写代码、修错误,判断对不对还得靠工具和人;testbench写不好,验证就仍是这条路线上最大的瓶颈。
对前端的日常工作,最值得带走的是几个习惯:
- 先准备好判对错的手段,再让AI写:testbench、参考断言,以及用来检查testbench的变异体
- 给AI的反馈要具体:完整的编译日志、出错信号的波形、每一轮试过什么,比只说「不对」有用得多
- 上下文挑着给:相关的spec段落、代码片段,再加一个能跑的示例,比整份文档塞进去效果好
- 流程由人定:多步任务先定好步骤和每步怎么检查;同一个错反复出现,就带着总结出的原因重开
参考
- M. Liu, N. Pinckney, B. Khailany, H. Ren, “VerilogEval: Evaluating Large Language Models for Verilog Code Generation,” ICCAD, 2023.
- M. Liu et al., “ChipNeMo: Domain-Adapted LLMs for Chip Design,” arXiv:2311.00176, 2023.
- Y. Tsai, M. Liu, H. Ren, “RTLFixer: Automatically Fixing RTL Syntax Errors with Large Language Models,” DAC, 2024.
- C. Batten, N. Pinckney, M. Liu, H. Ren, B. Khailany, “PyHDL-Eval: An LLM Evaluation Framework for Hardware Design Using Python-Embedded DSLs,” MLCAD, 2024.
- N. Pinckney, C. Batten, M. Liu, H. Ren, B. Khailany, “Revisiting VerilogEval: A Year of Improvements in Large-Language Models for Hardware Code Generation,” arXiv:2408.11053, 2024.
- M. Liu et al., “CraftRTL: High-quality Synthetic Data Generation for Verilog Code Models with Correct-by-Construction Non-Textual Representations and Targeted Code Repair,” ICLR, 2025.
- C.-T. Ho, H. Ren, B. Khailany, “VerilogCoder: Autonomous Verilog Coding Agents with Graph-based Planning and Abstract Syntax Tree (AST)-based Waveform Tracing Tool,” AAAI, 2025.
- M. Kang et al., “FVEval: Understanding Language Model Capabilities in Formal Verification of Digital Hardware,” arXiv:2410.23299, 2024.
- Y. Bai, G. B. Hamad, S. Suhaib, H. Ren, “AssertionForge: Enhancing Formal Verification Assertion Generation with Structured Representation of Specifications and RTL,” arXiv:2503.19174, 2025.
- C.-T. Ho et al., “Marco: Configurable Graph-Based Task Solving and Multi-AI Agents Framework for Hardware Design,” arXiv:2504.01962, 2025.
- C. Deng, Y. Bai, H. Ren, “ChipAlign: Instruction Alignment in Large Language Models for Chip Design via Geodesic Interpolation,” arXiv:2412.19819, 2024.
- C. Deng, Y.-D. Tsai, G.-T. Liu, Z. Yu, H. Ren, “ScaleRTL: Scaling LLMs with Reasoning Data and Test-Time Compute for Accurate RTL Code Generation,” MLCAD, 2025.
- Y. Zhao et al., “PRO-V-R1: Reasoning Enhanced Programming Agent for RTL Verification,” arXiv:2506.12200, 2025.
- C. Deng, Z. Yu, G.-T. Liu, N. Pinckney, B. Khailany, H. Ren, “ACE-RTL: When Agentic Context Evolution Meets RTL-Specialized LLMs,” arXiv:2602.10218, 2026.
- J. Ni et al., “Trace2Skill: Distill Trajectory-Local Lessons into Transferable Agent Skills,” arXiv:2603.25158, 2026.
Discussion
Loading comments…
Checking sign-in…