基础概念
IPC:
If frequency is fixed: execute as many instructions per cycle (IPC) as possible.
1. 存储层次与局部性
Memory Hierarchy: SRAM → DRAM → Flash memory → Disk。层次越往上越快、越贵、容量越小。 时间局部性 Temporal Locality: 若某个数据项被访问,那么在不久的将来将会被再次访问。 空间局部性 Spatial Locality: 若某个数据项被访问,那么临近数据项可能很快也将会被访问。
2. SRAM / DRAM
存储原理:
- SRAM:每 bit 用 6 个晶体管组成两个首尾相接的反相器,形成双稳态触发器。只要通电,信号靠电源直接驱动瞬间满电压,不需要刷新。
- DRAM:每 bit 用 1 个晶体管 + 1 个电容(1T1C)存一个电荷,需要定时刷新。
为什么 SRAM 比 DRAM 快?
- DRAM 读数据要给电容充放电,等电荷流动、再用放大器把微弱信号放大,物理上慢。
- SRAM 触发器不需要等充放电,电流直接由电源驱动,通电即满电压。
为什么 SRAM 只做 Cache、DRAM 做主存(成本与功耗):
- 面积:DRAM 1T1C < SRAM 6T,同样面积 DRAM 存得更多,密度更高。
- 功耗:SRAM 功耗更高;DRAM 更省电、更便宜。
- 结论:SRAM 快但贵、功耗大、面积大 → 只做小容量高速 Cache;DRAM 慢但便宜、密度高 → 做大容量主存。
硬件材质对照表:
| 层次 | 典型硬件位置 | 主要材质 | 特点 | 速度 |
|---|---|---|---|---|
| L1/L2/L3 Cache | CPU 内部 | SRAM (静态随机存取存储器) | 速度极快,不需要刷新,电路复杂(6个晶体管存1bit),极贵,容量小。 | 最快 (ns级) |
| TLB | MMU 内部 | SRAM (或 CAM) | 专门用来存页表的”Cache”,材质同上。 | 极快 |
| 主内存 (Main Memory) | 内存条 | DRAM (动态随机存取存储器) | 速度较快,需要定时刷新电容电荷,电路简单(1个晶体管+1个电容存1bit),便宜,容量大。 | 中等 (几十ns) |
| Disk (存储) | 硬盘 | SSD / HDD | 永久存储。SSD用闪存(Flash),HDD用磁碟。 | 最慢 (us/ms级) |
3. MMU
(Memory Management Unit,内存管理单元):实现虚拟地址(Virtual Address, VA)到物理地址(Physical Address, PA)的映射。
MMU 内部实现地址映射的几个关键组成部分:
- TLB (Translation Lookaside Buffer,旁路转换缓冲/快表)
- 功能: 它是一个专用的、极高速的硬件缓存 (Cache)。它存储了近期使用过的”虚拟页号”到”物理页号”的映射结果。
- 工作机制: 当 CPU 发出一个虚拟地址时,硬件首先去查 TLB。
- TLB Hit (命中): 直接从 TLB 得到物理地址,无需访问内存,速度极快(通常 0 或 1 个时钟周期)。
- TLB Miss (缺失): TLB 中没有这个映射,需要触发”页表遍历”。
MMU 让每个程序都以为自己拥有 连续、完整的内存空间(虚拟内存),实际上它们的数据散落在物理内存的不同角落。
MMU 不仅存地址,还存权限位(R/W/X)。
- 例如:防止程序修改操作系统的内核代码(因其是只读的)。
- 例如:防止程序执行数据段的代码(防止缓冲区溢出攻击)。
4. Cache
Hit / Miss 查找流程
- CPU 发出请求:发出虚拟地址 (VA)。MMU/TLB 介入,迅速将虚拟地址翻译成物理地址 (PA)。
- 注:为了快,L1 Cache 往往在翻译完成前,先用虚拟地址的一部分去”定位”数据,等翻译好物理地址后再”核对”,这叫 VIPT 技术。
- 查找 L1 Cache:用物理地址标签 (Physical Tag) 确认数据是否匹配。
- 未命中查找 L2 和 L3,最后还是未命中则查找 DRAM。
- 注:L2、L3一般是PIPT(Physically-Indexed Physically-Tagged:index和tag都取自物理地址),所以未命中后发给DRAM的也是物理地址。
- DRAM 也没有的话查找 Disk,硬件触发”缺页异常” (Page Fault),操作系统 (OS) 接管,把数据从硬盘搬运到 DRAM 中,更新页表,然后重试上述步骤。
映射方式 (Mapping Policies)
核心描述 Cache 与主存(Memory)之间的映射规则。
| 特性 | DM (直接映射) | SA (组相联) | FA (全相联) |
|---|---|---|---|
| 映射灵活性 | 低 (固定位置) | 中 (固定组,组内任意) | 高 (任意位置) |
| 硬件成本 / 比较器数量 | 低 / 1 个 | 中 / N 个(N=路数) | 高 / 所有行数(成本爆炸) |
| 查找速度 | 最快 | 中 | 较慢 |
| 适用场景 | 对成本敏感或大容量 L2/L3 | 主流选择 (L1/L2/L3) | 小容量关键缓存 (如 TLB) |
为什么需要比较器: CPU 发出的地址里没有 bit 位直接对应具体哪个 cache line(数据是哪有空位就填哪,位置动态随机),所以命中判定要靠比较器:
- 硬件并行读取:把选中 Set 里每个 way 存的 Tag 全部读出来。
- 硬件并行比较:N 个独立比较器,逐路检查
CPU请求的Tag == 该way存的Tag。 - DM 每 Set 只有 1 行,位置锁死,只需 1 个比较器;FA 无 Set 概念,可能要比对全部行,成本随容量爆炸。
SA Cache 地址拆分与算例:
物理地址拆分三部分:[ Tag | Set Number | Offset ]
- Tag:标记。
- Set Number:定位去哪个组。
- Offset:块内偏移地址。
优势:查找时不用搜整个 Cache,只需在特定 Set 内部(仅 K 行)比较,K=2 时只要 2 个比较器。
例:主存 128 Bytes,Block/Line 4 Bytes,Cache 32 Bytes,2-way Set Associative。
- 物理地址位数:128 = 2⁷ → 7 bits。
- Block Offset:4 = 2² → 2 bits。
- 主存块数:128/4 = 32 = 2⁵ → Block Number 需 5 bits。
- Cache 行数:32/4 = 8 行。
- Set 数:2-way,每 Set 2 行 → 8/2 = 4 个 Set = 2² → Set Number 需 2 bits。
- Tag:7 − 2(Set) − 2(Offset) = 3 bits。
最终地址结构:[ Tag (3 bit) | Set (2 bit) | Offset (2 bit) ]
- 这就是 CPU 发出的”主存物理地址”本身,Cache 控制器(比较器、译码器)只是各自盯着其中几根固定引脚看,并不是一种新数据格式。
Cache 存什么
Cache 既存数据,也存指令——冯·诺依曼架构”存储程序”:指令(代码)本质上也是一种数据。
I-Cache / D-Cache: 现代处理器(哈佛架构或改进型哈佛架构)为防止指令和数据抢带宽,通常把 L1 Cache 拆成 I-Cache(专存指令)和 D-Cache(专存数据)。
5. DRAM 内部结构
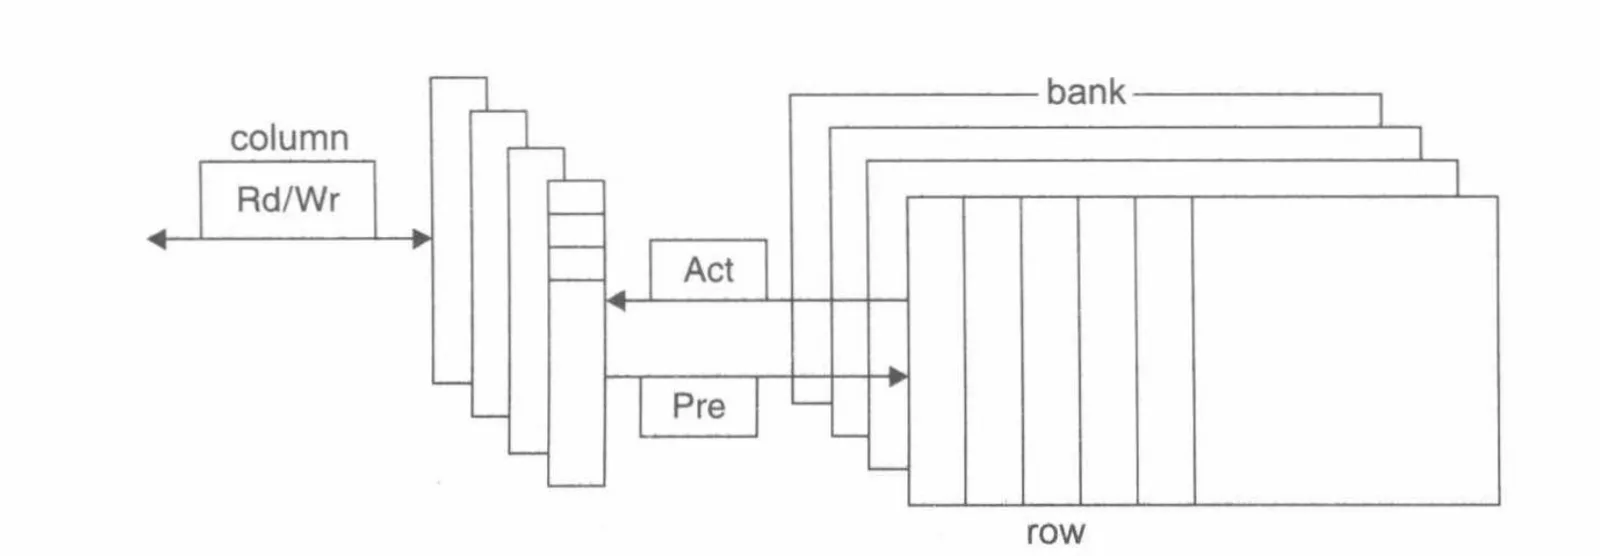
DRAM 芯片内部像多个 Excel 表格(二维矩阵):
- Bank(库):一个 DRAM 芯片含多个 Bank(如 8/16 个),每个 Bank 是一张独立表格。
- Row(行):Bank 内水平方向一整排存储单元。
- Column(列):垂直方向。
Row 的特点:
- 大小:一个 Row 的数据量 (Page size) 通常很大(2KB/4KB/8KB),远大于 Cache Block(一般 64 Bytes)。
- 读写机制:DRAM 不能直接读某一 bit,必须先把整行”激活”(Activate),复制到高速缓冲区 Row Buffer(也叫 Sense Amplifiers);数据到 Row Buffer 后才能按 Column 地址选出需要的部分读出去。
Cache 和 DRAM —— Block 和 Row 的联动:
- DRAM 控制器找到地址 A 所在的 Row(假设 Row 5,4KB)。
- DRAM 芯片把整行 4KB 激活并读入 Row Buffer。
- 从这 4KB 里按 Column 地址切出 CPU 需要的 64 Bytes(Block),经数据总线发给 CPU。
局部性原理的硬件红利:
- 下次要读的数据还在同一个 Block:Cache 直接命中,最快。
- 不在同一 Block,但在同一 Row(Row Hit):不用重新激活,直接从 Row Buffer 拿,也很快。
- 在不同 Row(Row Miss):必须先关闭旧 Row(Precharge),再激活新 Row,非常慢。
6. DMA
(Direct Memory Access,直接存储器访问)
核心作用:在不需要 CPU 干预的情况下,实现数据在内存与外设之间(或内存与内存之间)的高速传输。
勘误: 把数据从 Memory 搬到 Cache 是 Cache Controller 的工作,全自动完成,软件(程序员)和 DMA 都无法直接控制。
- Cache Controller 会自动向总线发起请求,把包含地址 A 的一整行数据(Cache Line)从主内存搬进 Cache。
DMA发出的地址:主存只认物理地址,而程序用的是虚拟地址。DMA有两种做法:
- 直接用物理地址:OS设置DMA时直接给物理地址,并分配连续的物理页,或者按页把一次传输拆成几次
- 用虚拟地址:设备前面放一个小TLB,由OS配好虚拟到物理的映射,DMA发出的地址先经它翻译。这个部件叫IOMMU(Input–Output MMU,ARM叫SMMU)
7. 单位换算
1 KiB = 2^{10} Bytes = 1,024 Bytes
频率 HZ 和 ns 的转换
500MHz = 2ns,换算过程:
- 500 MHz = 500,000,000 Hz = 每秒跳动 5 亿次(MHz 是百万赫兹)
- 公式:时钟周期 = 1 / 频率
- 周期 = 1 / 500,000,000 秒 = 0.000000002 秒 = 2ns
- 时钟周期: 两次时钟上升沿的间隔时间
- 1000 MHz = 1 GHz(1ns)
8. fabric
行业用法: 在许多芯片和系统架构设计中,类似 “control fabric” 和 “data fabric” 的说法常见于描述集成互连网络,强调系统内部的”织构”结构,而不是简单的”流”(flow)。
- data fabric:跑大块数据,比如计算要读写的数据
- control fabric:跑控制类的小流量,比如读写寄存器。上面跑的仍是带地址的读写事务,control指流量的种类,不是valid、ready这类控制信号
9. RISC-V 与五级流水线
什么是 RISC-V? RISC-V 是一种开源指令集架构(ISA),旨在简化计算机处理器设计并允许高度的定制化。
五级流水线构成:
- Fetch - decode - execute - memory - wb
- memory:如果需要,从内存取数据或写数据
- WB:把计算结果存回寄存器(相当于”记录成果”)
流水线设计 = 高频 + 每周期做一点点 → 总体吞吐更高。
1ns 的时钟频率确实更快,但更难设计、功耗高,可能反而不如 2ns 稳定省电。更高频率是性能手段,但不是唯一目标。
10. 竞争 / 冒险 Hazard
Data Hazards
RAW(Read After Write,真数据依赖)
问题:后一条指令需要前一条指令的结果。
例子:
add x1, x2, x3 # x1 = x2 + x3
sub x4, x1, x5 # x4 = x1 - x5 (需要等待x1的结果)
处理方式:
- 使用寄存器别名表(RAT)和保留站(RVS):
- 在 dec.sv 中,解码阶段检查源寄存器是否就绪
- 如果数据未就绪,记录一个标签(tag)而不是实际值
- 在 rvs.sv 中,保留站等待数据就绪
- 当数据通过 CDB(公共数据总线)广播时,匹配标签的指令获得数据
WAR/WAW
问题:乱序执行可能改变写回顺序。
处理方式:
- 使用 ROB(重排序缓冲区)按程序顺序提交:
else if( rob_entries[i].valid && rob_entries[i].ready && rptr == i[PTR_W-1:0] ) begin rob_entries[i].valid <= '0 ; rob_entries[i].ready <= '0 ; end - 只有 ROB 头部的指令(rptr 指向)可以提交,保证顺序。
Control Hazard
遇到分支/跳转指令时,处理器无法立即确定下一条指令的地址,导致流水线停顿或执行错误路径。
例子:
beq x1, x2, label # 如果x1==x2,跳转到label
add x3, x4, x5    # 下一条指令(可能执行,也可能不执行)
sub x6, x7, x8    # 再下一条指令
问题:在 beq 执行完成前,不知道应该执行 add 还是跳转到 label,流水线可能执行了错误路径的指令。
该项目使用动态分支预测 + 预测错误恢复来处理控制冒险。
- 在取指阶段进行预测,避免停顿。
- BTB(Branch Target Buffer)存储分支指令的目标地址
- PHT + GHR(Pattern History Table + Global History Register)使用 2 位饱和计数器预测分支方向
Structural Hazards
CDB(公共数据总线)竞争
问题:多个执行单元同时完成,但 CDB 一次只能广播一个结果。
处理方式:
- 在 cdb.sv 中使用优先级仲裁:
assign jmp2cdb_itf.rdy = 1'H1 ; assign lsu2cdb_itf.rdy = ~jmp2cdb_itf.req ; assign mdu2cdb_itf.rdy = ~( jmp2cdb_itf.req | lsu2cdb_itf.req ) ; assign alu2cdb_itf.rdy = ~( jmp2cdb_itf.req | mdu2cdb_itf.req | lsu2cdb_itf.req ) - 优先级:JMP > LSU > MDU(乘除法单元) > ALU。未获得总线的单元等待下一周期。
设计原因:为了最大化流水线效率,按照”阻塞代价”从高到低排序:跳转(JMP)决定指令流向(代价最大),访存(LSU)决定数据依赖(代价次之),而普通计算(ALU)晚一拍通常影响最小。
还有另一种 Structural Hazards 是指令和数据抢占 cache 通道。
11. 分支预测 (Branch Predictor)
分支预测(Branch Prediction)是现代处理器用来提高 CPU 执行速度的一种手段,其对程序的分支流程进行预测,然后预先读取其中一个分支的指令并解码来减少等待译码器的时间。
Pipeline 假设程序运行时有一连串指令要被运行,将程序运行划分成几个阶段,按照一定的顺序处理。
如果没有分支预测器,处理器会等待分支指令通过了 pipeline 的执行阶段(execute stage)才能把下一条指令送入 pipeline 的 fetch stage,这会造成流水线停顿/冒泡。
加入分支预测器后,为避免流水线停顿,其会猜测两路分支哪一路最有可能执行,然后投机执行;如果猜错,则流水线中投机执行的中间结果全部抛弃,重新获取正确分支路线上的指令执行。所以,错误的预测也会导致程序执行的延迟。
预测策略:
1. Static branch prediction
- 编译时进行
- 任选一条分支:
- 认为 Branch 一定会 taken
- 认为 Branch 一定不会 taken
- 平均命中率:50%
2. Dynamic branch prediction
- 运行时进行
- 根据同一条转移指令过去的转移情况来预测未来的转移情况
- 分支预测缓冲区 - Branch Prediction Buffer
- 分支历史表 - Branch History Table
动态预测的方法
三种递进:① 2-bit 饱和计数器(bimodal,只看自己)→ ② 两级相关(correlating,加全局历史)→ ③ 锦标赛(tournament,两器择优)。
① 2-bit 饱和计数器(Bimodal)— FSM of simplest predictor
- 强不选择 - Strongly not taken
- 弱不选择 - Weakly not taken
- 弱选择 - Weakly taken
- 强选择 - Strongly taken
当一个分支命令被求值,对应的状态机被修改。分支不采纳,则向”强不选择”方向降低状态值;如果分支被采纳,则向”强选择”方向提高状态值。这种方法的优点是,该条件分支指令必须连续选择某条分支两次,才能从强状态翻转,从而改变预测的分支。
局限:只看同一条分支自己的历史,忽略分支之间的相关性。
② 两级相关预测器(Correlating / Two-level)
- 动机:分支间有相关性,单看自己历史不够。例:
if(a==2)…if(b==2)…if(a!=b),后一分支由前两者决定。 - 两级结构:
- 第一级 - 全局历史寄存器(GHR, Global History Register):移位寄存器,记最近 m 条分支的 taken / not-taken。
- 第二级 - 模式历史表(PHT, Pattern History Table):每种历史模式配一个 2-bit 饱和计数器。
- 用 GHR 索引 PHT 取计数器做预测(gshare 变种:GHR 与 PC 异或后再索引,减少冲突)。
- 记作 (m, n) predictor:m 位全局历史,n 位饱和计数器。
- 这就是本笔记项目节(控制冒险)里 PHT + GHR 那套机制。
③ 锦标赛预测器(Tournament)
- 同时跑两个预测器:一个 local(看自己历史)、一个 global(即②的相关预测)。
- 加一个选择器(selector / chooser,本身也是一张 2-bit 计数器表)动态判断当前哪个预测器更准,信它。
- 谁最近预测对就用谁 → 不同分支挑最适合的预测器,取长补短。
- 代表:Alpha 21264。
BTB
BTB(Branch Target Buffer)存储”分支目标地址”,第一次执行分支时计算并存入,之后遇到同一分支就直接用,避免等到 EX 才计算,减少流水线停顿。
12. Gem5 性能建模项目
项目名称: 基于 Gem5 的微架构性能建模与设计空间探索
项目描述: 基于 Gem5 架构仿真器构建并优化的微架构性能建模平台,用于高效的设计空间探索。主要内容包括:
- 环境搭建与基准测试集成: 在 Linux 环境下配置 Gem5,编译并运行 SPEC 2006 基准测试(429.mcf 与 433.milc),确保仿真环境的正确性与兼容性。
- 参数化仿真配置: 利用 Python 配置文件对仿真脚本进行修改,针对 X86O3CPU 乱序执行模型,设置模拟参数(如仿真时钟周期限制)和多组 L1D Cache 配置(如 32KB/64KB/128KB、不同关联度及响应延迟),以评估不同缓存层次结构对系统性能的影响。
- 性能指标采集与数据分析: 通过对仿真输出的统计数据进行整理,重点分析 IPC、缓存命中率与失效率等关键指标,进而评估微架构设计的优化空间。
- 报告撰写与优化建议: 整合实验数据,撰写详细的性能对比报告,提出基于仿真结果的优化策略,为后续硬件设计和架构优化提供理论与实践依据。
参考
- J. L. Hennessy, D. A. Patterson, Computer Architecture: A Quantitative Approach, 6th ed.
- gem5
- SPEC CPU2006
Discussion
Loading comments…
Checking sign-in…