概述
一颗多时钟域的 LeNet-5 CNN 推理 NPU,以 FP16 计算:像素以数据流形式输入,寄存器和权重通过 SPI 写入。本项目是这颗芯片的功能验证。
芯片架构
交互版见 NPU Explorer:点模块看说明,按时间轴逐层回放一帧推理。
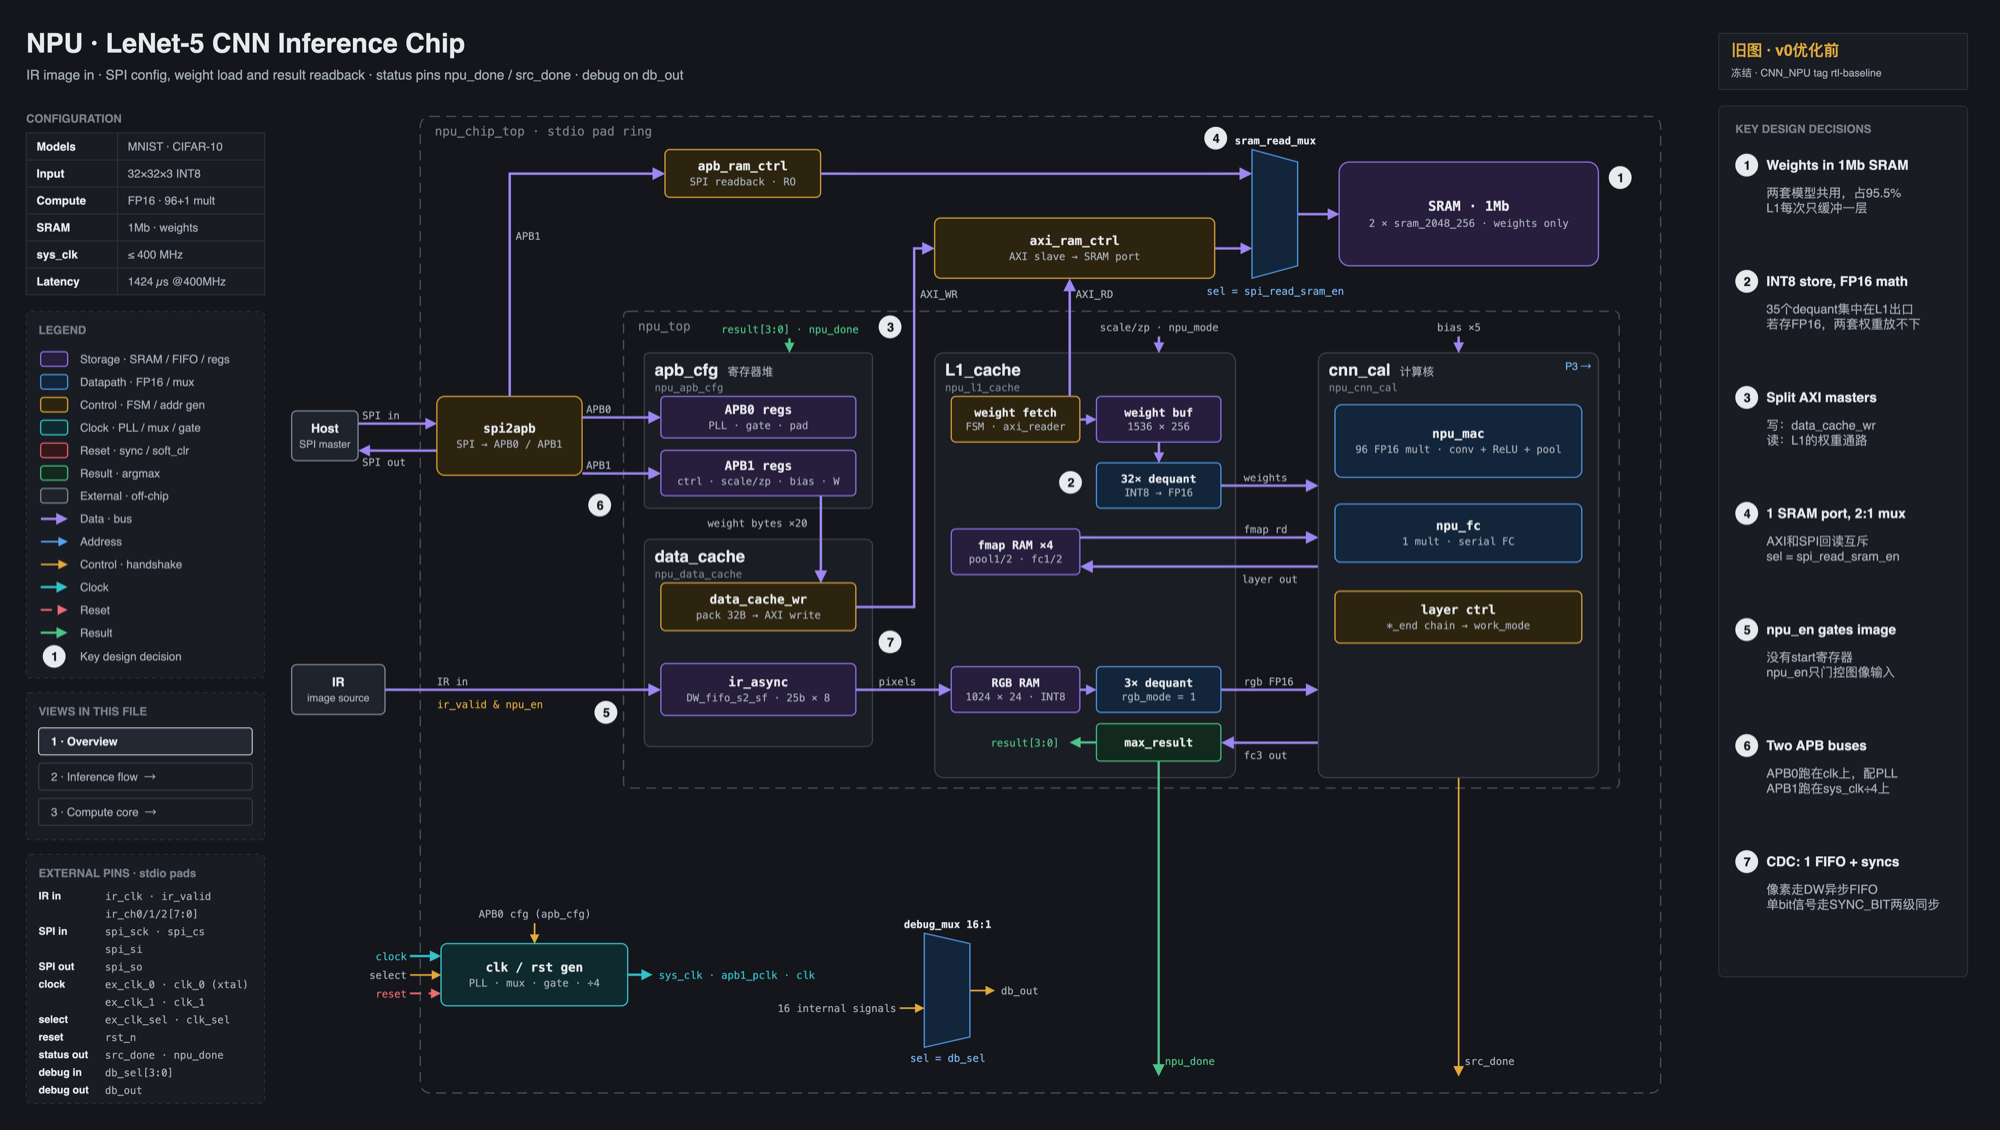
- 配置。Host 经 SPI 访问芯片,
spi2apb把 SPI 帧转成两条 APB。APB0 跑在clk上,管 PLL、时钟门控和 pad,PLL 起来之前就能配置;APB1 跑在sys_clk÷ 4 上,管 NPU 的控制寄存器、scale/zp、bias 和权重。 - 权重。MNIST 和 CIFAR-10 两套模型的权重以 INT8 存在片上 1 Mb SRAM 里,占 95.5%。配置时 Host 经 SPI 逐字节写入,
data_cache_wr攒满 32 字节后经 AXI 写进 SRAM;推理时每层先经 AXI 读进 L1 的权重缓冲,再由 32 路 dequant 转成 FP16。 - 图像。32×32×3 的 INT8 图像从 IR 接口逐像素流入,经全芯片唯一的异步 FIFO 进入
sys_clk域,存进 RGB RAM。 - 计算。
npu_mac有 96 个 FP16 乘法器,conv1 和 conv2 共用,完成卷积、ReLU 和池化;npu_fc只用 1 个乘法器,串行算三层全连接。层与层之间没有中央状态机,靠*_end标志逐层接力。最后 argmax 给出 4 bit 分类号,npu_done拉高后经 SPI 读回。
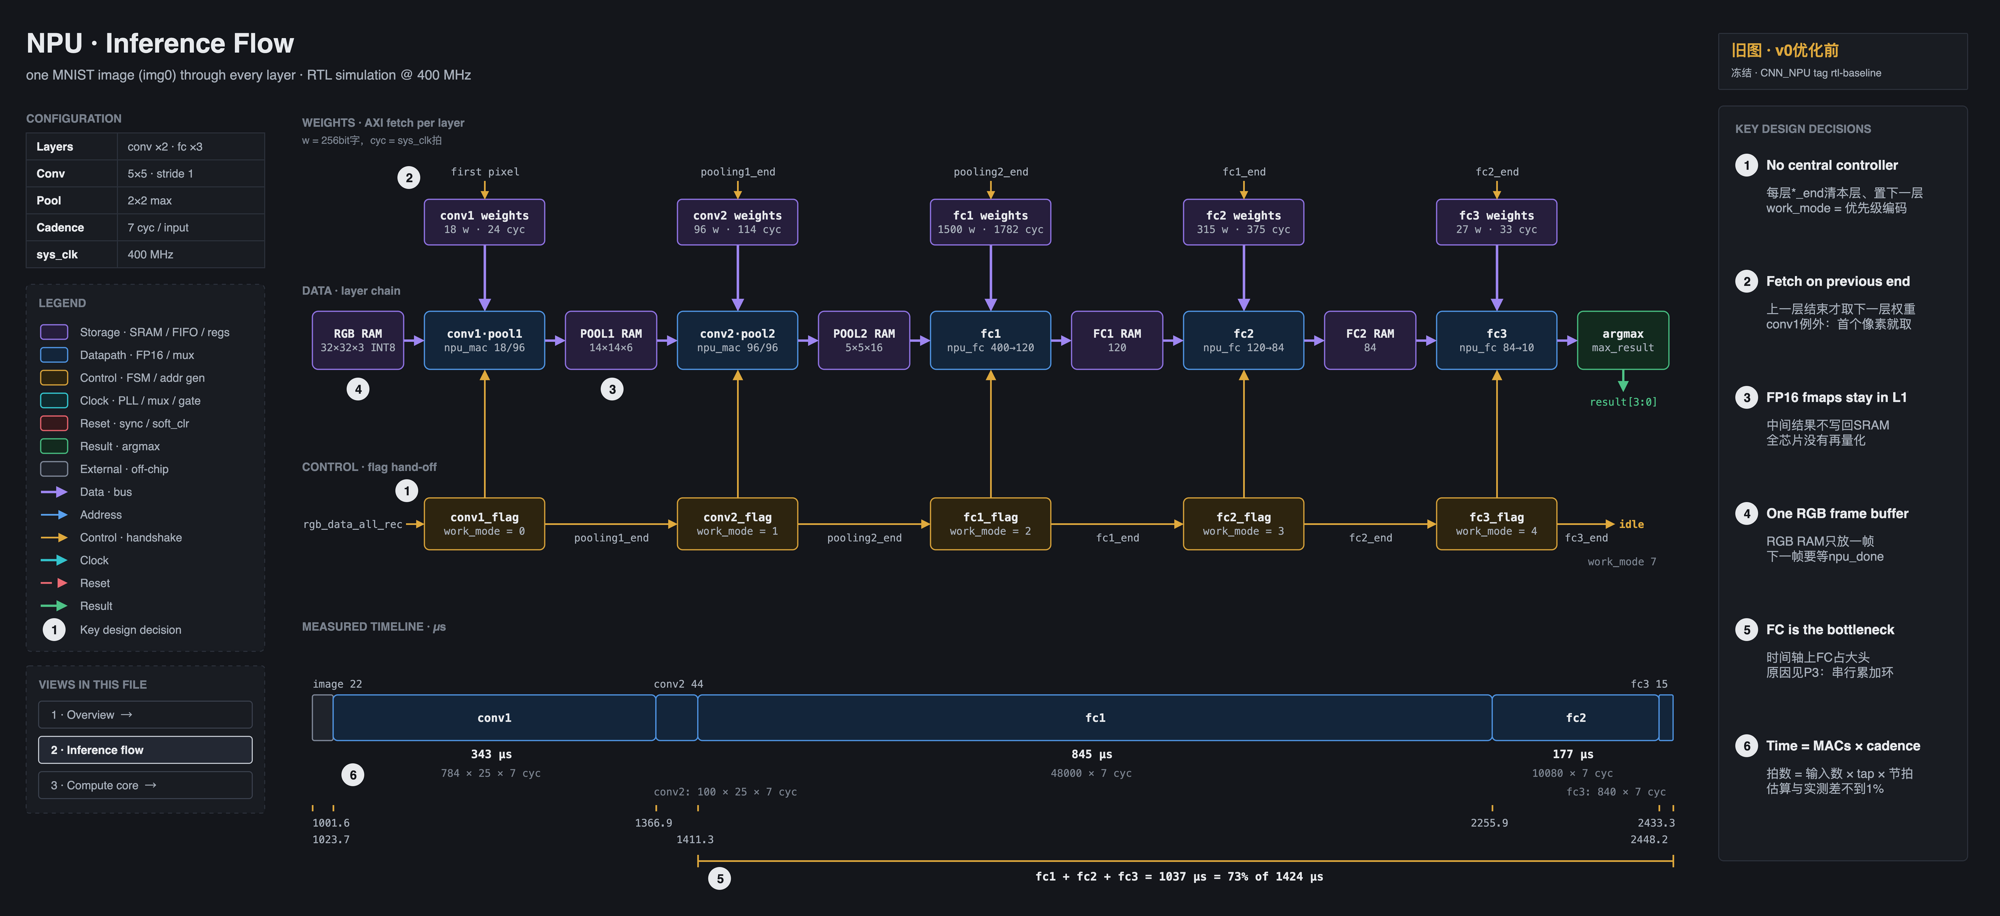
在 400 MHz 下实测,一张图从像素收齐到出结果用 1424.5 µs,三层全连接占其中 73%。npu_fc 的累加环每 7 拍才能加一次,是性能瓶颈。
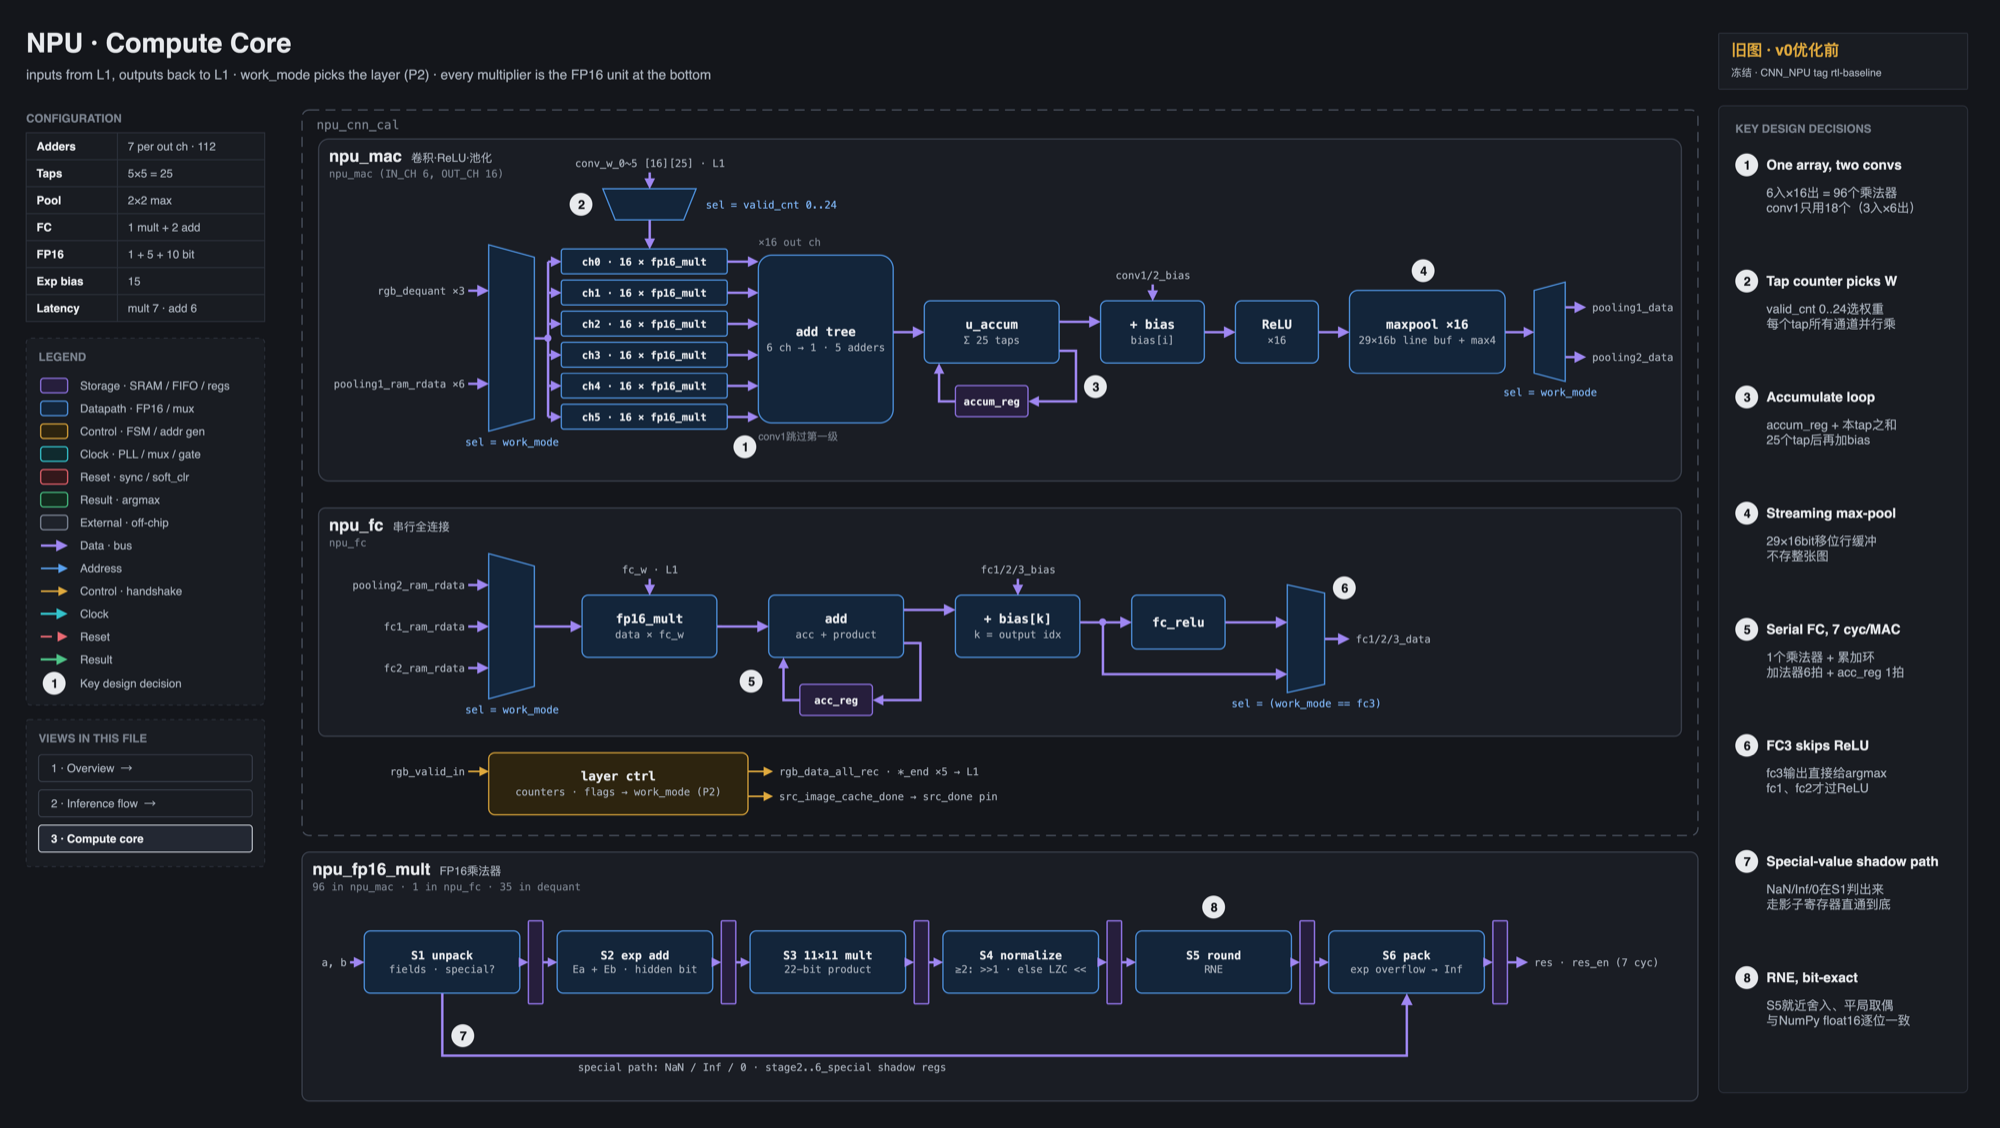
FP16 乘法器是 6 级流水加一级输出寄存器。NaN、Inf 和 0 走一条影子通道直通到底,舍入用 RNE,结果与 NumPy float16 逐位一致。
验证内容
- Testbench。UVM 环境基于 Synopsys SPI VIP 搭建,virtual sequencer 协调两个异步接口:寄存器配置和像素流。
- 回归与覆盖率。17 个芯片级测试加 5 个算子级单元测试,达到 line coverage 97.5%、branch coverage 96.6%、范围内 functional coverage 100%。
- 寄存器模型。UVM RAL 模型覆盖 522 个寄存器,配合自定义的 SPI adapter;内置 sequence 检查复位值、访问类型以及 frontdoor/backdoor 的一致性。11 个会影响时钟、复位或数据通路的寄存器排除在通用 sequence 之外,由定向测试覆盖。
- FP16 reference model。NumPy 实现的 FP16 模型按 RTL 的累加顺序计算,为芯片级 scoreboard 提供 golden 结果。Bit-exact 的算子测试中,318 个加法器输出有 136 个偏差最多 2 ULP,其中 122 个来自最多只移 10 位的对齐移位;评审后做了 waive,并固定进回归基线。
- CDC 发现。图像 CDC FIFO 没有满标志反压,溢出时会静默丢数据。该行为已与设计方确认并记录 waiver,回归中加入三条 SVA 检查。
技术栈
SystemVerilog · UVM · Synopsys SPI VIP · UVM RAL · SVA · NumPy · VCS · Verdi
Discussion
Loading comments…
Checking sign-in…